ARTICLE · 1104353
不止降温!英伟达用机柜架构,重新定义 AI 液冷产业
AI 算力狂飙之下,芯片功耗持续走高,传统风冷已经很难承载高密度 GPU 集群的散热压力。以前,液冷只是给高功耗芯片降温的配套方案而已,但从GB200到GB300的产品更新就能看得很清楚,英伟达正靠着机柜级系统架构,从引导需求到输出标准,一步步推动液冷从原来一个独立的散热配件升级成了AI算力架构的核心组成。
液冷登上AI产业舞台,最直接的动因来自算力硬件功耗的爆发。H100SXM的最大TDP达到700W,GB200NVL72的规格还要更高,现在算力单元已经从单颗GPU,升级成了整个机柜统一的NVLink计算域,热管理的设计逻辑也跟着完全变了,现在不再是只解决单颗芯片的散热问题,而是要对整台机柜系统做热平衡、流体分配还有结构协同设计。
在GB200NVL72机柜方案中,液冷与第五代NVLink做了原生协同设计,72颗GPU在同一机柜内构建起统一计算域。这套设计的用处不只是控温而已,液冷方案能让机柜放下更高密度的计算设备,还能缩小数据中心占的地方,与此同时能保证GPU之间的通信保持高带宽和低延迟。简单来说,液冷不再是事后加装的散热补丁,而是和GPU互联、机柜结构、供电系统绑定在一起,在系统设计阶段就要同步规划。
到GB300NVL72平台,行业路线继续向前,升级为全液冷机柜,进一步扩大液冷覆盖范围,提升硬件集成度。而面向更大规模业务的AIFactory多机柜集群,则提出液冷、网络、基础设施一体化协同思路,把液冷的设计边界,从单机柜延伸到整个算力集群基础设施。
这个变化其实非常关键,冷板,歧管,液路接口,这些都属于液冷零部件,它们不再是可以单独采购,装好就能用的外部配件,现在,它们变成嵌在计算托盘和机柜本体里的结构性组件,液冷管路还有快速盲插接头,要和服务器结构,供电链路,NVLink高速互联一起同步开发。
要知道,英伟达自己不生产液冷设备,它在整个液冷产业链里,做的就是需求牵引加上架构定义这两件事,它靠着GPU功耗和机柜平台的顶层设计,直接给下游液冷产品定好技术指标,带动整个供应链更新升级,每更新一代算力平台,液冷厂商就得跟着调整冷板、歧管、CDU这些配套产品的规格,好适配新的机柜布局和热负载。
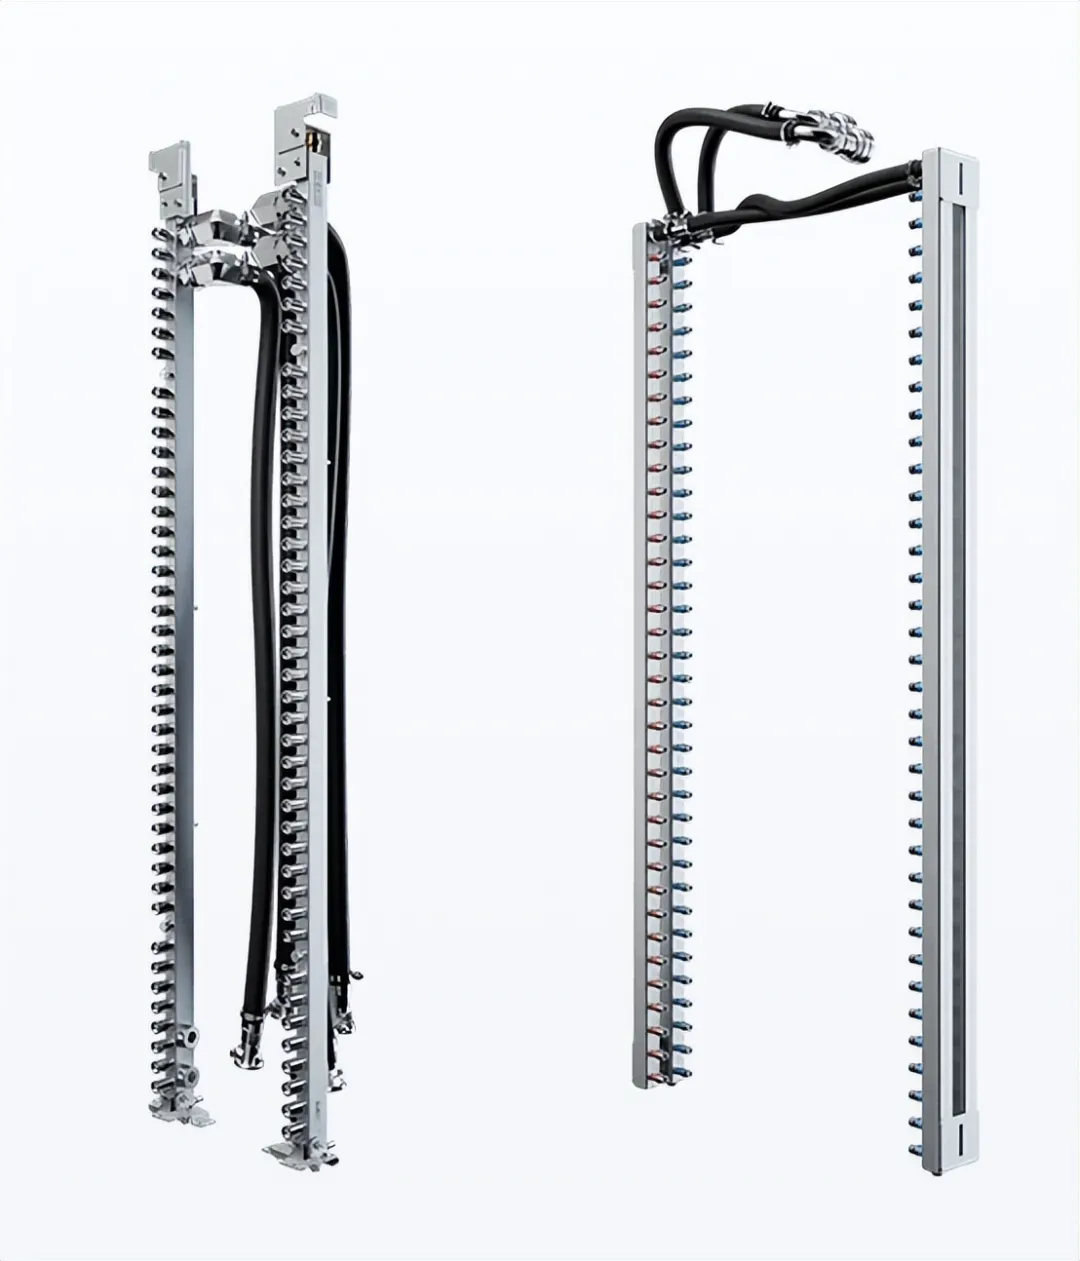
更深远的影响,来自英伟达向行业开放硬件设计,把机柜与液冷方案向外扩散。2024年,英伟达向OCP开放GB200NVL72相关硬件设计。OCP发布的《OpenSystemsforAI》白皮书里面,已经包含了NVLink线缆组件、盲插歧管、浮动盲插结构这些关键的液冷和机架部件设计。其中BlindMateManifold盲插歧管冷却能力可达130kW,液冷流量规格5Lmin。
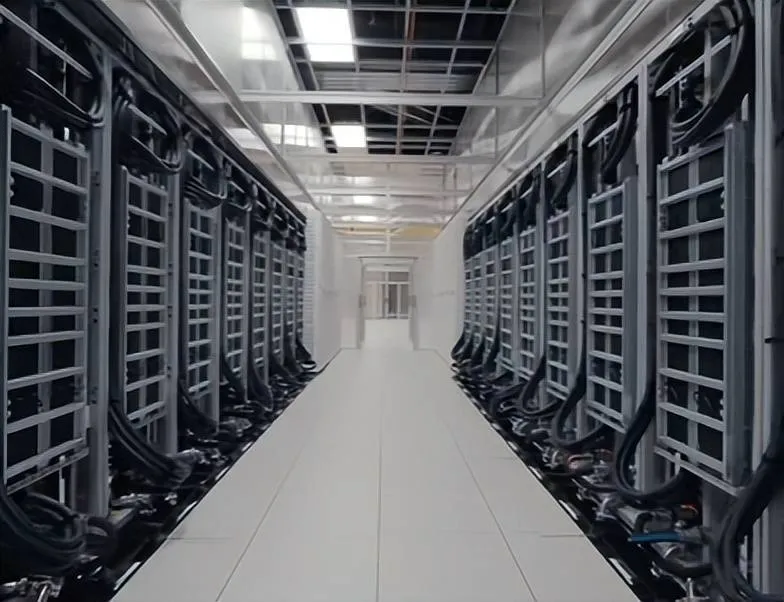
液冷 AI 算力机房集群
这套开放方案的意义重大,靠着这份开放设计,全球所有供应链厂商都能照着统一规格,搭建出基于MGX架构的AI优化系统,这个做法相当于把英伟达已经验证好的机柜级液冷方案,改成了全行业都能直接用的标准化参考设计,能帮整机厂商还有液冷供应商降低研发试错的成本,还能加快全行业高密度液冷AI服务器的落地速度。
在此之前,液冷方案大多由散热厂商、服务器厂商各自定义,不同厂商接口、管路、歧管标准不一,跨品牌集群部署难度高,兼容性问题多。而英伟达通过MGX机柜架构+OCP开源设计,把液冷的接口、承载能力、安装形式做了标准化锚定,推动产业链走向统一。
站在产业角度观察,AI算力的竞争,说到底,就是基础设施能力的竞争,单机柜算力不断提升,风冷方案的功耗瓶颈,已经日益凸显,液冷技术从原先的可选配置,正逐步演变为高密度AI机柜的标准配置,此前,液冷产业链多数处于被动响应阶段,开发工作围绕客户具体需求开展,全部为定制化开发,进入机柜级AI时代后,芯片设计与整机架构,率先明确了液冷性能指标,液冷厂商需要提前介入,深度参与系统级协同设计。
从GB200单机柜液冷,到GB300全液冷,再到AIFactory集群级液冷基础设施,这条技术发展的路线很清楚地指明了未来方向,液冷已经不是一个单独的散热领域,而是AI算力基础设施里不能分开的一部分了,英伟达靠着顶层平台设计,带动了整个液冷产业链的技术更新,也推动了标准化落地。
现在算力密度的比拼还在继续,功耗更高,规模更大的GPU集群还会不断投入使用,对液冷整个产业链来说,现在的机遇已经不只是造出冷板和CDU这么简单了,得深度融入到整机的架构设计里,跟上AI平台架构更新的节奏,未来,只有能适配机柜原生协同设计,满足标准化集群部署要求的液冷方案,才能占到产业的核心位置。
点“阅读原文”了解更多