ARTICLE · 1106838
如果AI能判断任何数学命题的真假,数学家还剩下什么?
那么,一个自然的问题就出现了:如果 AI 已经能够解决几乎所有精确定义的数学命题,人类还需要做数学研究吗?
我的判断是:数学不会消失,但“什么叫做数学研究”很可能会被重新定义。今天数学研究的核心之一是解决问题,未来它的核心可能越来越转向提出问题、发明概念、组织知识,以及解释为什么某些数学值得研究。如果“得到答案”变得廉价,那么最稀缺的东西可能不再是答案,而是问题、结构和理解。
一、首先被改变的,是“证明或反驳”这种研究模式
今天大量数学研究,本质上都遵循类似的路径:提出猜想,尝试证明,证明失败,寻找反例,修改猜想,然后重新证明。一个问题可能需要几个月、几年,甚至几十年,我们才知道它究竟是真是假。
但如果未来的 AI 可以直接告诉你:“这个命题成立。”或者:“这个命题不成立,最小反例出现在 11 维。”甚至:“这个命题在 ZFC 中不可判定。”那么今天许多需要耗费巨大智力的研究过程都会被大幅压缩。
例如,你提出一个新的矩阵不等式。今天可能需要花几个月做估计、研究特殊情形、寻找证明、运行计算实验。未来的对话可能变成这样:“这个不等式成立吗?”“不成立。”“最小反例是多少维?”“11 维。”“10 维以下是不是都成立?”“是。”“能否刻画所有 11 维极小反例?”“可以。”
原本可能是一篇论文甚至一个长期研究项目的问题,很快就进入了下一层。这意味着,“一个命题是真是假”本身,可能不再是数学研究中最稀缺的资源。
二、但知道“真”,不等于知道“为什么真”
这里有一个非常重要的区别。假设你问 AI 一个命题 P,AI 回答:“P 为真。”这其实并没有结束数学,因为你仍然可以继续问:为什么?有没有一个三页以内的证明?有没有一个几何证明?有没有一个初等证明?哪些假设其实是多余的?结论能不能推广?能不能定量化?这个定理和另外几个定理是不是同一个更深层结构的不同表现?
所以,数学其实至少包含三个不同层次:真值、证明和理解。
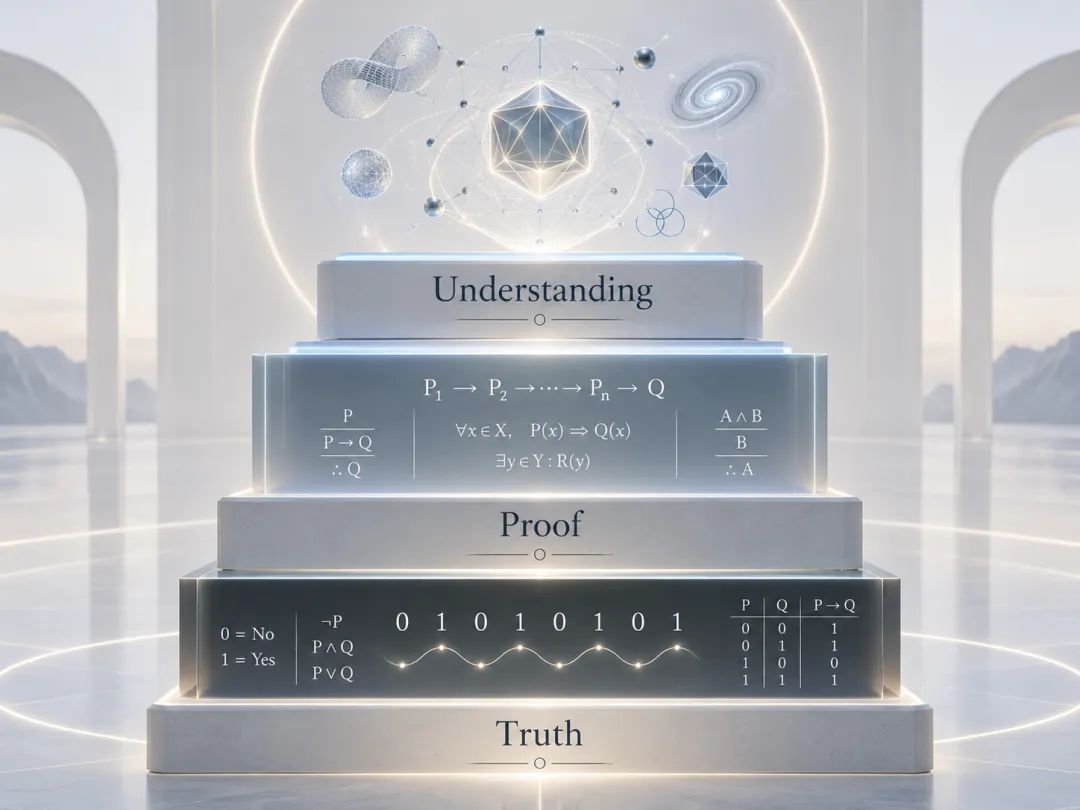
今天这三件事情经常纠缠在一起。我们为了知道一个命题究竟是不是真的,不得不寻找证明;而在寻找证明的过程中,我们逐渐获得理解。
强 AI 出现以后,这三个层次可能第一次被真正分开。“这个命题真不真”可能会变得非常便宜,“给出一个形式上正确的证明”也可能越来越便宜,但“为什么它是真的”“有没有一个人类真正能够理解并迁移到其他问题上的结构性解释”,反而可能更加珍贵。
换句话说,未来最稀缺的,也许不是 Truth,而是 Understanding。
三、数学家的角色,会从“解决问题”转向“设计问题”
今天数学家最典型的成果是:“我证明了某个定理。”但在一个 AI 极强的未来,更有价值的成果可能变成:“我发现了一个新的数学结构。”或者:“我找到了描述这一整类现象的正确语言。”
这意味着数学研究可能发生一个非常深刻的转变:从 solve problems,逐渐转向 design problems。
今天我们会问:“这个矩阵不等式成立吗?”未来更重要的问题可能是:“究竟是什么结构决定了这一整类矩阵不等式成立?”然后让 AI 自动生成几十万甚至几百万个相关命题,快速判断真假并寻找边界。
此时人的任务不再只是证明其中某一个命题,而是观察这些真假结果背后有没有共同模式,有没有某个隐藏的不变量,有没有一个新的定义,可以让这些结果突然统一起来,有没有一个理论,可以把一百万个零散事实压缩成几个核心原理。
数学家的核心能力因此可能逐渐从“会证明”,转向“会发现什么值得定义”。
四、提出好问题,可能比解决问题更重要
今天我们通常认为,提出一个好问题很重要,但解决一个重大问题往往更加困难。未来这个关系可能发生逆转。
如果 AI 可以迅速解决任何一个已经精确定义的问题,那么真正困难的事情就会变成:什么问题值得问?
这是一种完全不同层次的能力。机器完全可以生成十亿条正确的数学命题,但这十亿条命题里,可能绝大多数都没有真正的数学价值。它们当然是对的,但它们不解释任何现象,不连接其他理论,也不产生新的方法。
就像一个数据库里存放着十亿个正确数字,并不意味着我们拥有一个理论。真正有价值的是:为什么这个命题重要?它揭示了什么?它与哪些已有理论发生联系?它是否改变了我们看待一个领域的方式?
所以未来最稀缺的东西,可能不是“答案”,而是高质量的问题。
五、数学论文也可能完全变样
今天一篇标准数学论文通常是:定义、引理、命题、主定理、证明、推论,再证明。未来这种结构可能发生明显变化。
一篇未来的数学论文也许会这样写:我们发现了一个新现象;我们利用 AI 探索了数百万个例子;这些例子显示出某种稳定结构;因此我们提出一个新定义;AI 给出了完整的、可形式验证的证明;论文正文则重点解释这个定义为什么自然,这个定理为什么重要,它和已有理论之间有什么关系。
这时候,完整证明本身可能变成一种 machine-verifiable certificate。它可能非常长,甚至根本没有人会逐行阅读。就像今天很多科学论文不会把所有原始实验数据放在正文中一样,未来完整的形式化证明可能被放进专门的证明数据库或验证系统。
人类真正阅读的正文,则越来越承担另一种任务:解释。为什么这个结论值得关心?为什么选择这个定义?关键结构是什么?最有启发性的例子是什么?它和已有数学之间有什么联系?
未来数学论文的重点,可能逐渐从“证明正确性”转向“解释意义”。
六、数学会真正进入“实验科学”时代
今天已经存在所谓的实验数学,但规模仍然非常有限。一个数学家可能计算几十个、几百个、几万个例子,然后根据这些结果猜测一个规律。
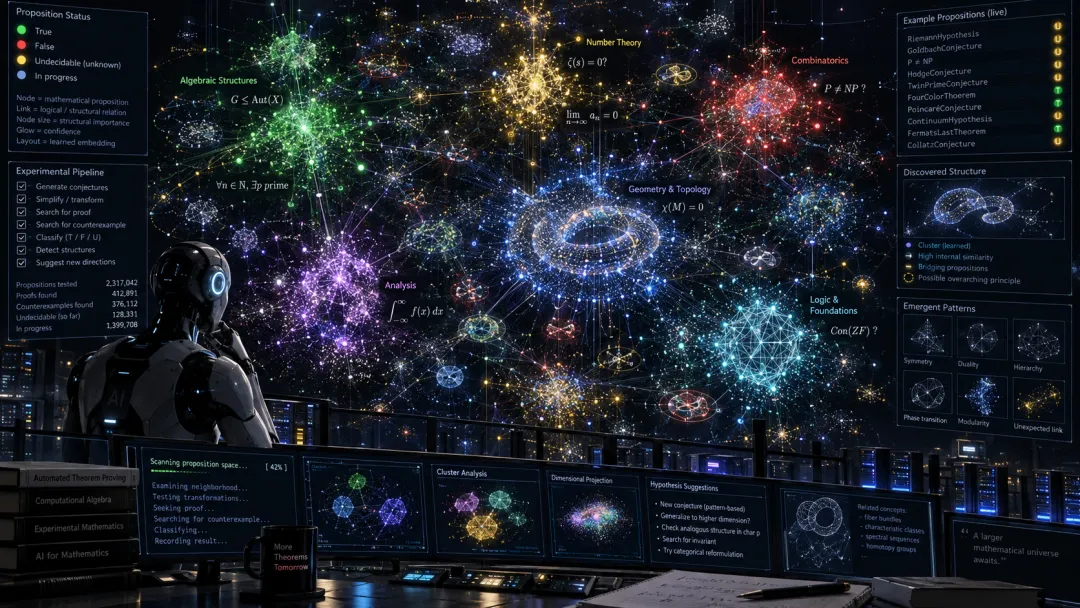
未来,如果 AI 同时具备自动生成猜想、自动验证猜想、自动寻找反例、自动寻找最小反例、自动寻找推广和自动识别临界参数的能力,数学实验的规模可能发生几个数量级的变化。
假设你研究一类数学对象 C。AI 可以自动生成 P1、P2、一直到 P1000000 这样的大量候选命题,然后逐一给出“真、真、假、真、假、假……”这样的标签。接下来它还可以分析:哪些参数决定真假?临界维数是多少?最小 obstruction 是什么?是否存在 forbidden configuration?有没有一个统一的分类定理?
这时数学研究的工作流会越来越像实验科学:提出假设,大规模测试,发现模式,最后建立理论。不同之处在于,这里的“实验结果”甚至不是近似值,而可以是严格的数学真值。
这可能催生一种今天尚未真正存在的大规模研究范式:实验性定理科学。
七、反例会从“终点”变成“数据”
今天,一个猜想被找到反例以后,我们经常认为这个猜想已经结束了。未来很可能不是这样。
AI 告诉你:“这个猜想是假的。”下一问会立刻变成:最小反例是什么?所有最小反例有什么共同结构?为什么它们恰好在这里出现?是什么 obstruction 导致原命题失败?增加什么条件以后,命题可以恢复?是否存在一个 if and only if 的完整刻画?
于是,“P 为假”不再意味着研究结束,它只是数据采集的第一步。
反例会越来越像实验物理中的观测数据。真正重要的不只是找到反例,而是解释反例为什么存在,并从反例中提炼新的结构。
八、“不可判定”也会变成一种常规数学属性
还有一个更有意思的情形。假设未来 AI 不仅能判断真假,还能可靠告诉你:“这个命题在 ZFC 中不可判定。”那么数学知识会多出一个新的坐标:公理强度。
今天 independence result 往往极其困难。一个命题是否能够从某套公理体系中证明,本身就是一个很深的逻辑问题。未来我们也许可以系统性地问:这个结论在 ZFC 中能否证明?是否需要某种大基数假设?是否等价于某个组合原理?是否依赖连续统假设?
这样一来,一个数学命题将不再只有“真”和“假”的属性,它还会带有另一个标签:它究竟需要多强的公理体系才能证明。
Proof theory、reverse mathematics 和 independence phenomena 也许不再只是数理逻辑中的专门问题,而会成为整个数学研究的常规基础设施。未来甚至可能出现一张巨大的“数学公理地图”,标明不同定理之间的逻辑强度关系。
九、最先贬值的能力,可能是“技术性证明能力”
今天,一个非常优秀的数学家通常需要很强的 technical proving power。例如能够完成极长的估计,能够发现巧妙的代数技巧,能够处理复杂的 case analysis,能够在长距离推理中保持高度准确。
如果 AI 在这些方面全面超过人类,那么这些能力不会完全失去价值,但它们的稀缺性会明显下降。
相反,一些今天已经非常重要、但很难量化的能力会迅速升值:问题选择、概念形成、抽象、理论构造、定义设计、跨领域连接和数学解释。
尤其值得注意的是“发明正确的定义”。
数学史上很多真正深刻的进展,并不是某一条孤立定理,而是一种新语言的诞生:群、流形、测度、Hilbert 空间、scheme、category、distribution、operator algebra。这些概念真正强大的地方,在于它们能够把数量巨大的事实压缩进一个统一结构。
因此,即使 AI 已经给出了一亿条正确命题,人类仍然可以追问:有没有一个新的概念,使这一亿条命题突然都变得自然?
如果有,那么发现这个概念,仍然可能是最高层次的数学创造。
十、未来最大的问题,也许不是“知识不够”,而是“知识太多”
今天数学研究仍然受到一个非常现实的瓶颈限制:人写论文的速度有限,人审稿的速度有限,人读论文的速度有限,整个数学共同体能够消化的新知识有限。
但如果未来 AI 每天可以产生几百万条甚至更多的新定理,局面就会完全反转。我们可能第一次面对这样一种情况:已知数学远远多于任何一个人类能够阅读和理解的数学。
比如,数据库里已经有一万亿条被证明为真的定理,但没有任何一个数学家能够理解其中哪怕万分之一。
这时问题不再是:“我们还不知道什么?”而是:“这么多已经知道的东西里,什么值得知道?”
因此,未来真正重要的 AI 可能不仅是 theorem prover,而是 theorem filter、theorem compressor 和 theory synthesizer。它需要把一百万个定理压缩成一千个现象,把一千个现象压缩成十个结构,再把十个结构压缩成一个理论。
这才是真正意义上的数学理解。
十一、未来可能出现三种完全不同的“数学家”
如果这种未来真的到来,“数学家”这个职业可能发生明显分化。
第一类可以叫 Theorem Explorer。他们利用 AI 大规模探索问题、反例、边界和参数空间,有点像未来的实验数学家。
第二类可以叫 Theory Architect。他们不关注某一条孤立定理,而关注什么定义最自然、什么概念最有效、怎样把大量结果组织成一个理论、怎样找到真正的统一结构。
第三类可以叫 Mathematical Explainer。他们寻找人类能够理解的证明、更短的证明、更漂亮的证明,以及更适合教学和传播的理论结构。
即使机器已经知道答案,人类仍然需要建立自己的认知模型。
十二、真正的分水岭,可能不是“AI会不会证明”
所以,真正值得关注的问题,也许并不是:“AI 什么时候能解决所有数学问题?”而是:“AI 什么时候能够提出人类没有想到、但事后看来极其自然的新概念?”
如果 AI 只是会证明定理,那么数学家的角色当然会改变,但不会消失。因为人仍然可以负责提出问题、发明概念、设计理论、判断意义和寻找解释。
真正发生质变的时刻,是 AI 同时能够完成问题生成、定义发明、猜想发现、定理证明、理论构建、重要性判断和概念压缩。
到了那一步,AI 就不再只是一个数学工具。它开始参与决定:什么数学值得做。
十三、最后还剩下一个问题
即使 AI 可以解决所有数学命题,即使它可以创造比人类更复杂、更漂亮的理论,即使它可以自动发现新的概念,可能仍然会剩下一个问题:我们想理解什么?
在无限多数学对象中,为什么研究这个,而不是另一个?在无穷多正确理论中,为什么这个理论值得人类学习?哪些概念让我们觉得自然?哪些理论能够解释现实世界?哪些数学能够改变人类理解世界的方式?
这些问题不只是逻辑问题。它们还涉及人的目标、审美、认知结构和应用需求。
因此,如果未来真的出现一个可以判断任何数学命题真假的超级 AI,数学大概率不会结束。真正发生的,是一次研究范式的转变:数学从“主要作为解题活动”,逐渐转向“作为探索、压缩和理论设计的活动”。
过去,一个数学家的代表性成就是:“我解决了一个没人解决的问题。”
未来,也许最高级的数学工作会变成:“我提出了一个此前没有人意识到值得提出的问题。”或者:“我创造了一种新的语言,让机器发现的一百万条定理突然变得可以理解。”
AI 负责告诉我们:哪里有真理。
而人类越来越需要回答:哪些真理值得看?它们之间有什么关系?以及最重要的——我们为什么在乎?
如果有一天 AI 真能解决任何数学问题,你认为数学家最核心的工作会变成什么?是提出问题,建立理论,还是单纯为了“理解”而继续做数学?
欢迎留言讨论。