ARTICLE · 1114564
你的AI助手每次聊天都失忆,43000星项目说:该给它装个脑子了
你的AI助手每次聊天都失忆,43000星项目说:该给它装个脑子了
昨天深夜两点,我第三次跟一个AI客服解释我的订单号。
它礼貌地说:"请您提供一下订单号。"我发了。它回复:"感谢您的耐心等待,请问您的订单号是?"
那一刻我真想把键盘摔了。
这不是段子。你用的那些AI助手、编程Agent、自动化工作流——绝大多数都是"金鱼记忆"。对话一关,什么都忘了。你上周跟它说"我喜欢用TypeScript"、"我们数据库是PostgreSQL"、"别用any类型"——全没了。下周重来。
我做开发十几年,最怕的不是需求变更,是每次开会都要跟新来的AI重新解释一遍项目背景。我带的一个团队,同时跑着五个Agent——一个管代码审查,一个管运维告警,一个管文档生成,还有两个做数据分析。它们彼此之间完全隔离,每个都是从零开始理解业务。更扯的是,同一个Agent,你关了窗口再开,它就失忆了。
2025年之前,行业里居然没有一个像样的开源解决方案。大家要么把历史对话塞进上下文窗口(贵,GPT-4的上下文窗口一次调用就要几十美分,跑一天能烧掉一个程序员的日薪),要么搞个简单向量检索丢进去(只会按字面相似度捞结果,根本不懂"学习"和"总结")。
直到一个叫 Hindsight 的项目出现。11个月,43000颗星。今年GitHub上长得最凶的记忆基础设施项目,没有之一。
主推:Hindsight——给你的AI装一个会学习的记忆
先说结论:这个项目不是"又一个RAG封装"。
Hindsight做的事情,用一句话概括——让AI不只是记住,还能学会。
怎么理解?传统RAG就像把一本参考书扔给AI,让它自己翻。Hindsight不一样,它做了三层仿生记忆结构:
· 世界事实(World Facts):客观知识。"用户的项目是Next.js 14,数据库用PostgreSQL,部署在AWS上"
· 经历(Experiences):Agent自己的交互经验。"上次这个用户不喜欢太长的回答"、"他改了三版才满意,偏好简洁风格"
· 观察(Observations):从大量记忆中自动提炼的信念和规律。"这个团队倾向用函数式编程"、"每次部署前都会忘记跑迁移脚本"
这三层不是拍脑袋设计的。你仔细想,人类记忆就是这么运作的——我记得事实、记得经历、还会从经历中总结规律。Hindsight把这套东西做成了可调用的API,而且是MIT协议,完全免费。
实际怎么用
两行代码就能接入:
from hindsight_client import HindsightClientclient = HindsightClient(api_key="your-key")client.retain(bank_id="my-agent", content="用户偏好TypeScript,不喜欢any")
之后你的Agent每次对话前调一次recall,它就能想起之前所有交互中提炼出的关键信息。不是原文搬运,是理解过的、去重过的、带时间线的记忆。
有个特别打动我的细节:每个记忆库(Bank)可以配"性格"(Disposition)。你可以让它更保守、更冒险、更简洁——就像一个真实的助手有自己的人格。你的运维Agent可以配成"宁可误报也不漏报"的性格,你的客服Agent可以配成"温和但坚定"的性格。
Hindsight还有一个"心理模型"(Mental Models)的概念——Agent可以主动维护一份关于用户、关于项目的持续更新的认知。不是被动地等人来问,而是自己定期梳理、刷新。这就像你带的新人,从一开始什么都要教,到三个月后能独立判断——区别就在于有没有心理模型。
它在LongMemEval基准测试上拿了业界第一——这个基准是专门评估AI长期记忆能力的,覆盖了知识更新、时间推理、偏好记忆等多个维度。而且支持25+个LLM提供商——从OpenAI、Anthropic、Gemini到本地Ollama、LM Studio全通吃。Python、Node.js、Go、CLI四种客户端随便选,不管你用什么技术栈都能接。
开源 vs 闭源:省了多少钱
这是真正让人肉疼的部分。
Hindsight出来之前,给Agent加长期记忆基本只有两条路:
· 用闭源SaaS:Letta(前身MemGPT)收$20/月/Agent起步;Cognee按token计费,$2.50/百万token;HydraDB的免费版只有2GB存储,商用$399/月起。一个中等规模团队,跑10个Agent,一年光记忆层就得花$2,400到$48,000。
· 自己用向量数据库搭:Pinecone、Weaviate都不便宜,还得自己写归一化、去重、时间衰减、跨会话合并这些逻辑。一个资深工程师两周的工时,算下来至少$4,000。
Hindsight是MIT协议,自托管完全免费。存储用PostgreSQL + pgvector(也是免费的)。你要付出的只有LLM API调用费用——而你的Agent本来就在调LLM做推理,记忆提炼的边际成本几乎为零。
有开发者算过一笔账:一个10人团队用Letta跑Agent记忆,一年$2,880起步。换Hindsight自托管,软件费用为零,只有API调用费(用Groq免费层甚至可以降到接近零)。一年省下将近两万块。
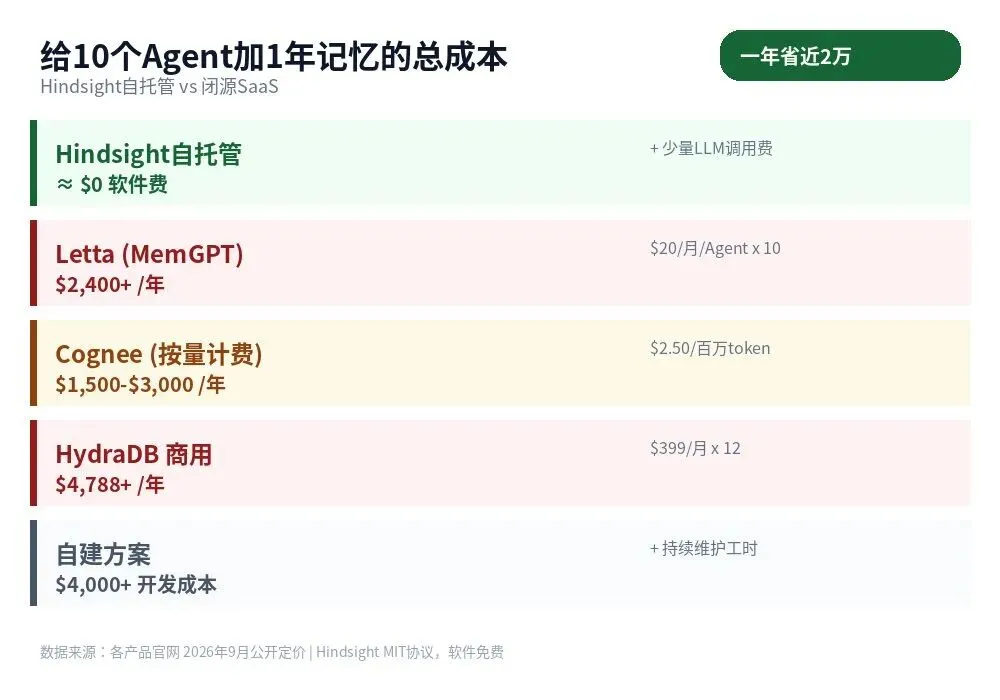
给10个Agent加1年记忆的总成本对比(数据基于各产品官网2026年9月公开定价)
它的边界在哪
说几个真实踩坑,不藏着:
1. 记忆不是原文。Hindsight会对你的输入做语义提炼和重组。如果你用正则去匹配原始格式,会全部miss。必须按日期、实体名这些不变量去索引,别依赖原文措辞。
2. 需要PostgreSQL。嵌入式模式适合开发调试和单机原型,生产环境必须接正经的PG实例。这意味着你得多维护一个数据库,运维成本不能忽略。
3. LLM成本不免费。每次retain都会调LLM做记忆提炼和归一化。如果你一天写入几千条记忆,OpenAI的账单不会好看。社区建议用小模型(如Groq免费层),但要注意限流。
4. 数据隐私要自己把关。记忆提炼过程经过LLM,如果你的Agent处理敏感数据(医疗、金融、法律),得想清楚用本地模型还是云端API。Hindsight支持Ollama全本地部署,但性能比云端慢3-5倍。
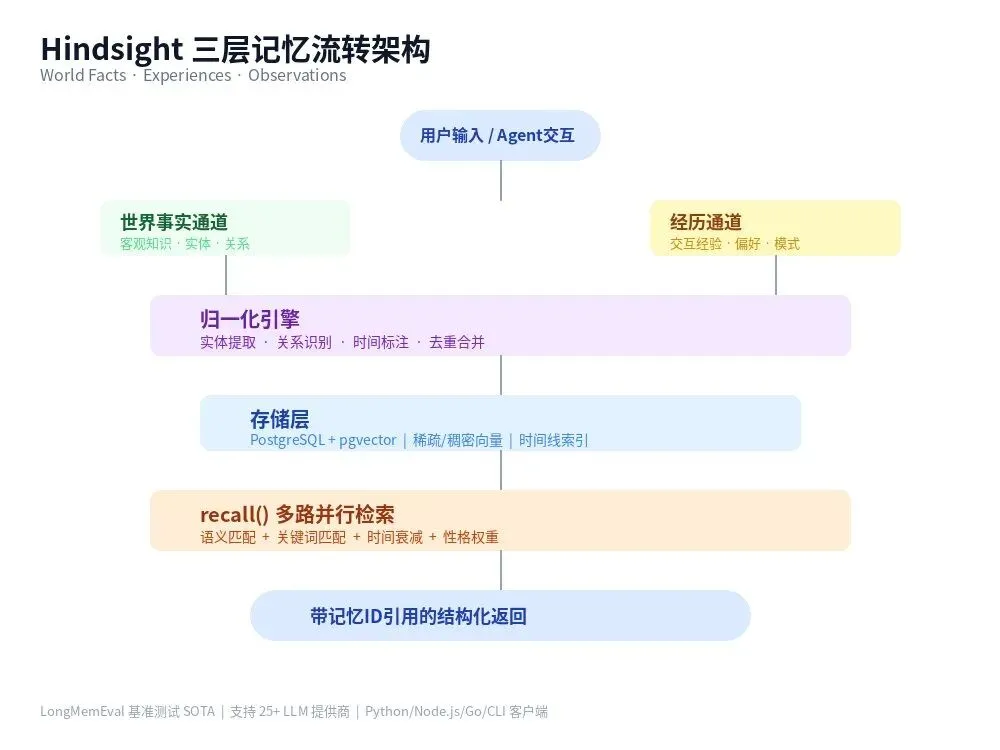
Hindsight三层记忆流转架构:输入 → 双通道 → 归一化 → 存储 → 多路检索 → 带引用返回
副推:DBX——25MB干掉Navicat的数据库客户端
聊完AI记忆,聊个更接地气的。
你平时用什么工具连数据库?DBeaver?得装Java运行时,动不动吃1GB内存,打开三个窗口电脑就开始喘。Navicat?$1,999一个license,5个人团队就是$10,000,每年续费再割一刀。DataGrip?JetBrains全家桶用户无所谓,单独买$199/年。TablePlus?Mac独占,Windows用户只能干瞪眼。
DBX是今年4月才建的仓库,半年冲到2万星,日增一度超过1000颗。它的思路非常直接:把100多种数据库的支持,塞进一个25MB的二进制文件里。
没有Java、没有Python、没有Electron、没有Chromium。一个Rust编译出来的小东西,下载,双击,直接连。比你的浏览器标签页占的内存都少。
为什么值得关注
· 支持100+数据库:MySQL、PostgreSQL、SQLite、Redis、MongoDB、DuckDB、ClickHouse、SQL Server、Oracle、Elasticsearch、达梦、TiDB、OceanBase、openGauss、GaussDB、KingBase……国产数据库的支持列表比DBeaver还长。甚至包括Pulsar、Kafka、RocketMQ的消息队列管理。
· 内置AI SQL助手:直接用自然语言描述你要查什么,它生成SQL,还能自动做安全检查(防注入、防误删、危险操作拦截)。支持Claude、OpenAI、Ollama本地模型。写SQL不用背语法了。
· MCP协议原生支持:Claude Code、Cursor、Windsurf这些AI编程工具可以直接通过DBX的连接配置查询你的数据库。一行配置搞定。
· 桌面端 + Docker + Web:本地用桌面版,团队用Docker部署Web版。同一套连接配置,同一个界面。出差的时候浏览器打开就能用。
省了多少钱
这个对比太直观了:
5个人用Navicat Premium,一年$5,000。用DBeaver Enterprise,一年$1,275。用DBX?零。而且DBX支持的数据库种类反而最多——Navicat只能连9种,DBeaver社区版不支持NoSQL(要$113/人/年起),DBX全都有。
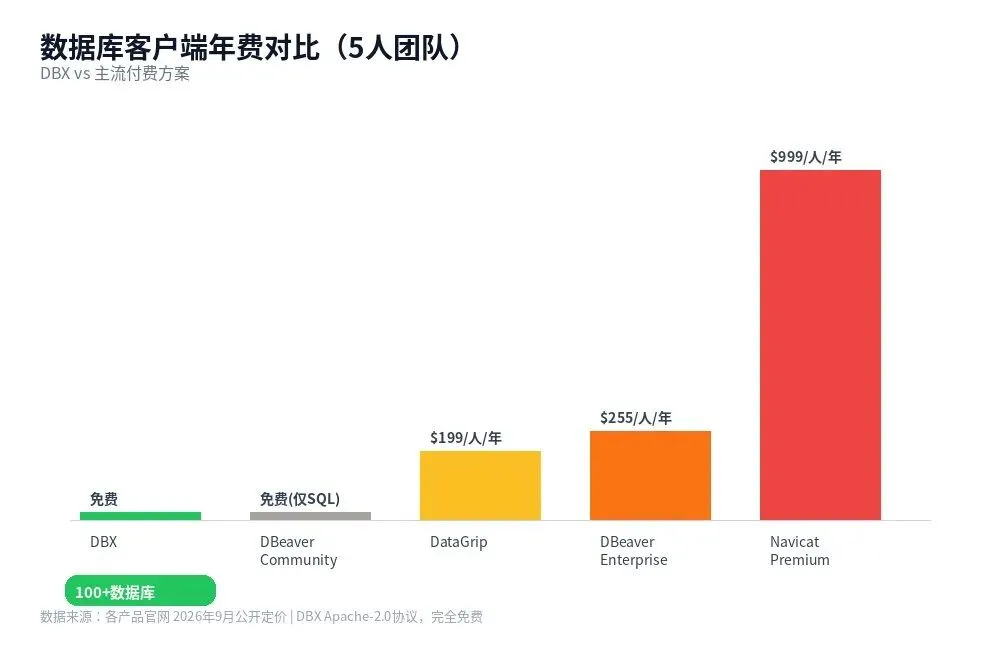
数据库客户端年费对比(5人团队)——DBX免费且支持100+数据库
它的边界在哪
说清楚,别被2万星冲昏头:
1. 还年轻。2026年4月才创建,满打满算半年。生态和稳定性比不上DBeaver十年老牌。8月份爆过一个严重漏洞CVE-2026-55642——Web版在没设密码时所有API完全裸奔,默认绑0.0.0.0:4224,谁都能连。虽然v0.5.51已修复,但说明安全审计还在追赶功能迭代的速度。
2. 社区深度不够。290个贡献者看着不少,但核心活跃维护者很少。Issue区有1600+未关闭。遇到冷门数据库的bug,修复周期可能很长。
3. 企业功能缺失。SSO、审计日志、角色权限、数据脱敏这些企业级功能一个都没有。大团队、合规场景暂时别上。
4. 桌面端打磨不足。Rust + Tauri的UI跟原生Electron比还是差一点细腻度,Mac上有用户反馈字体渲染发虚。Windows端偶现高DPI适配问题。
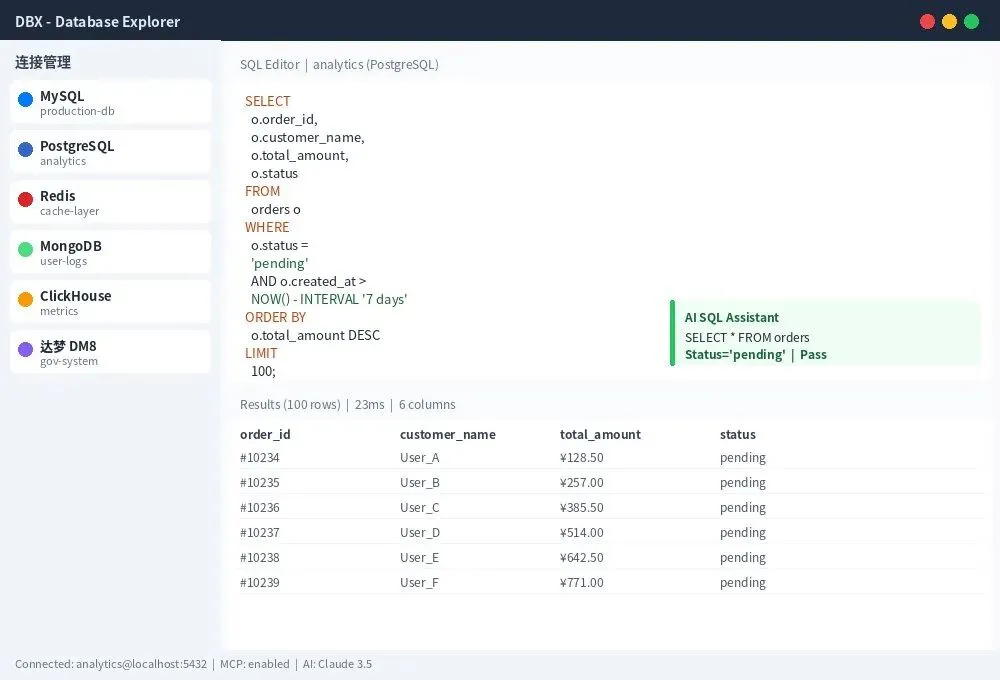
DBX界面示意:一个窗口连6种数据库,内置AI SQL助手+MCP协议
快速上手
安装方式:
# macOSbrew install t8y2/dbx/dbx# Windows / Linux:去 https://dbxio.com 下载对应安装包# Docker部署Web版(团队共享)docker run -d -p 4224:4224 -e DBX_PASSWORD=your-password dbxio/dbx-web
给AI编程工具接MCP只需:
{ "mcpServers": { "dbx": { "command": "npx", "args": ["-y", "@dbx-app/mcp-server"] } }}
Hindsight 3步接入
# 1. 安装(嵌入式模式,自带SQLite)pip install hindsight-all -U
# 2. 初始化 & 存入记忆from hindsight import Hindsighths = Hindsight()hs.retain(bank_id="demo", content="用户的项目用Next.js 14")hs.retain(bank_id="demo", content="上次部署忘了跑prisma migrate")# 3. 召回记忆memories = hs.recall(bank_id="demo", query="部署时注意什么?")
生产环境接PostgreSQL + pgvector,Docker一键部署:
docker compose up -d写在最后
Hindsight和DBX看起来八竿子打不着,但其实解决的是同一个问题:工具不应该每次都从零开始。
DBX说:你不应该每次连新数据库都装一个800MB的客户端,更不应该为这件事每年掏$5,000。
Hindsight说:你的AI不应该每次对话都从零认识你。你教过它的事情,它应该记住。
好的开源工具不是做了多炫酷的功能,而是让你意识到"原来这件事可以不用这么累"。
国庆假期有闲工夫折腾的话,这两个都值得一试。
仓库地址
Hindsight:github.com/vectorize-io/hindsight
DBX:github.com/t8y2/dbx
你怎么看?
你的AI助手有没有"失忆"过让你抓狂的时刻?你日常用的数据库客户端是哪款?评论区聊聊。