ARTICLE · 1119795
零代码文档驱动大模型开发---AI办公助手系列-多知识库管理-一个进多个库
三、功能优化背后的思考
决策一:为什么不"改老表",而是"加关联表"?
缺点:老的知识库表里,一个文档是唯一的一行。要做"一个文档进多个库",最直接的想法是"把这行的唯一约束去掉"。但这一改,数据库里外键约束会崩,而且已经算好的那一堆向量要么丢、要么重算,成本巨大。
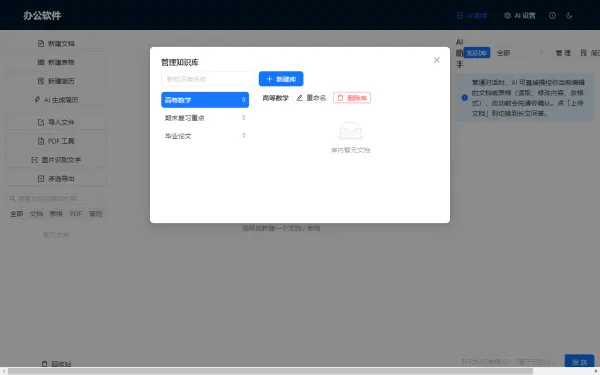
优化方案:不动老表,新增两张表——一张存"库",一张存"文档和库的对应关系"。老数据一行不动,多库靠新表"多打几个对勾"来实现。
思维沉淀:能"加"就别"改"。增量改动,保住了已经算好的资产;动老结构,等于把之前的成果推倒重来。升级一个系统,最省事也最安全的姿势,是"在边上加一张表",而不是"把现有的表翻个底朝天"。
决策二:一个文档进多个库,chunks 为什么不复制?
缺点:一个文档进了两个库,直觉上"两个库各存一份内容"。但这份内容里最贵的是那串向量——同一个文档,在两个库里向量是完全一样的,存两份就是纯浪费,还得算两遍。
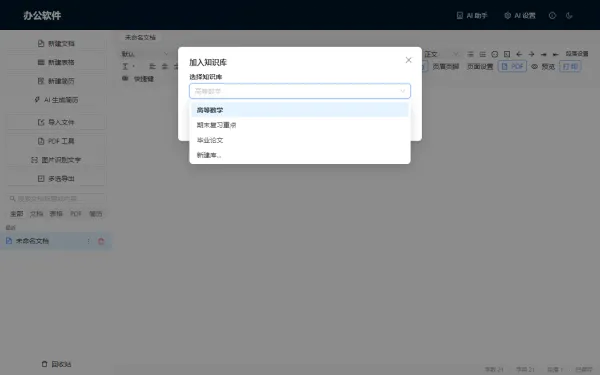
优化方案:把文档的内容(chunks + 向量)只存一份,挂在"文档"身上;"它属于哪个库"只靠关联表多记几行。这样进十个库,内容也还是那一份。
思维沉淀:内容和"它属于哪",是两件正交的事。别把不该绑死的绑在一起。内容变了是内容的事,归属变了是归属的事,分开存,两边都能独立演化。
决策三:迁移旧数据,为什么 tag 回填要先"去重"?
缺点:我手里已经有一批"标签"数据,升级时要把标签变成库。可老数据里可能有"数学"和" 数学 "这种看着一样、实际带个空格的重名标签。如果直接建库,建到第二个"数学"时就会撞上"库名唯一"的约束,升级直接卡死,连软件都打不开。
优化方案:回填之前,先做一步"规范化 + 去重"——把空格、空标签先规整,重名的合成一个库,再往下建。
思维沉淀:迁移最怕的不是丢数据,是"卡死在半路"。老数据是脏的,什么怪值都可能有。升级前先想清楚这些边角情况,别让一个带空格的重名,把整个升级流程堵死。
决策四:删库、删文档,孤儿数据怎么清?
缺点:一个文档同时属于 A、B 两个库。删 A,不能把文档也删了——B 还在用它。可要是 A、B 都删了,这个文档就成"没人要的孤儿",留在库里就是垃圾数据。
解法:删库只删"库和文档的对应关系",删完之后再查一句——"还有没有别的库要这个文档?"没有,才把文档连同它的向量一起清掉。同理,把文档从某个库里移出去,也要先看它是不是"最后一个归属",是才真删。
思维沉淀:删除的难点,不在"删"这个动作,在"什么时候才真的该删"。数据库里最脏的数据,就是那些"表面删了、其实还赖着"的孤儿。删之前多问一句"还有没有人要它",才不会留一堆没人要的垃圾。