ARTICLE · 1120622
AI+开源共建:中国科学计算软件换道超车新范式
AI+开源共建:中国科学计算软件换道超车新范式
AI+开源共建:中国科学计算软件换道超车新范式摘要长期以来,国内工程仿真与通用科学计算高度依赖国外闭源商业CAE体系,产业发展长期处于尾随复刻的追赶状态,难以实现根本性突破。随着通用大模型能力持续成熟,自然语言工程理解、代码自动化生成、模板检索重组、多模态建模等能力,正在重塑工业软件研发范式。本文认为:传统CAE的核心壁垒早已不是物理原理,而是海量人工编码工作量与长期沉淀的工程生态;当前AI技术恰好抹平了底层编码的人力门槛。我们提出一套全新方案:构建大模型人机交互调度层 + 国产开源CAE求解底座 + 全国高校分布式共建的分层架构,绕开国外软件几十年积累的技术路径依赖,遵循先跑通智能仿真全链路、后迭代工业精度的渐进路线,走出契合我国人才体量、适配AI时代的换道超车路径。 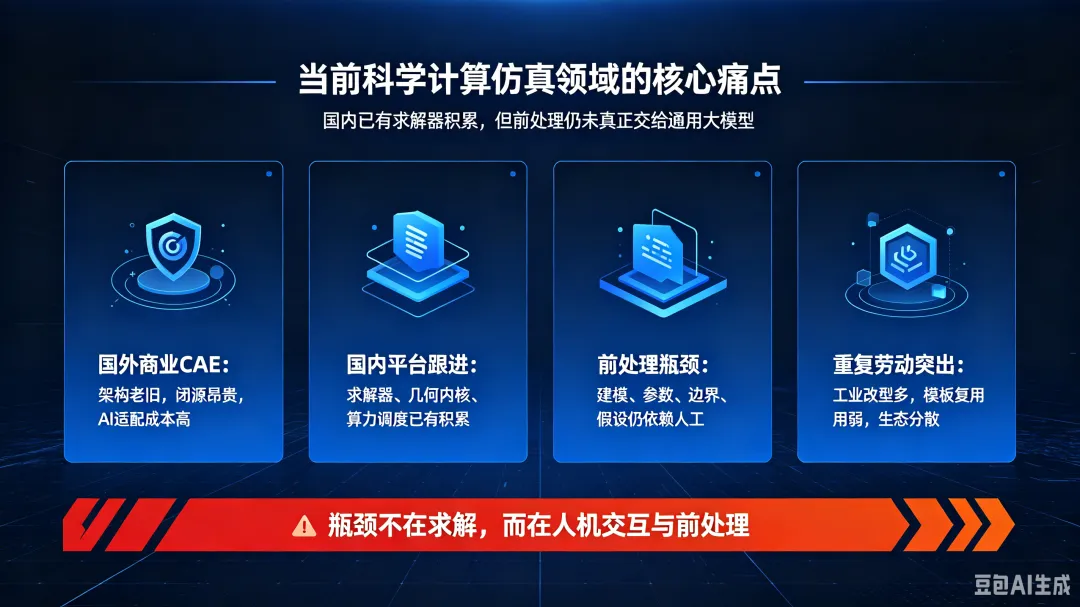
一、当前行业现存核心问题1. 国外传统CAE体系路径固化、架构老化以ANSYS、Abaqus为代表的商业软件,依靠数十年人工逐行堆叠代码、逐工况调试容错逻辑,形成庞大体系。其优势是成熟稳定,但短板突出:底层架构历史包袱沉重,并非AI原生设计,想要改造为支持自然语言交互、结构化数据读写的框架,改动成本极高;软件闭源、授权昂贵,存在产业安全隐患。2. 国内现有科研团队探索,各有成果但存在共性短板国内不少团队早已布局自主科学计算与CAE平台,取得阶段性成果,但大多延续传统思路,没有把前处理的人机交互、问题梳理交给通用大模型,这是最核心的痛点:1. FastCAE(哈工程):国内最成熟的开源CAE集成底座,模块化架构,面向高校开放,支持师生开发插件、贡献算例。但它的交互入口仍是传统CAE界面,需要用户掌握建模、网格操作,没有接入通用大模型作为统一自然语言入口,前处理门槛依然高。2. 中科院过程所 CF/MDriver:流体、分子动力学专用仿真智能体,实现了自然语言到求解计算的链路。局限在于只聚焦单一学科,不是通用力学仿真底座,无法扩展为固体、热、耦合多物理场通用平台。3. 异算方舟(中科院网络中心、力学所、中科曙光):主打代码迁移、国产算力适配,支持仿真Agent。重心放在代码移植与算力调度,前端工程问题梳理、草图解析、模型简化假设等前处理环节,仍需要专业人员手动操作。4. 磐石系列(中科院):自研通用数值仿真平台,多物理场求解能力较强,面向科研场景。短板同样集中在前端:依旧沿用传统CAE操作范式,缺少统一的通用大模型交互层。用户必须手动完成几何建模、参数录入、边界定义,前处理繁重,普通学生、科研人员上手难度大。5. 其他配套项目(九韶几何内核、DeepFlame、PaddleScience等):大多聚焦几何内核、单一求解算法或者AI加速计算,各自独立开发,相互接口不统一,缺少统一的通用大模型作为唯一交互入口。总结国内现状:求解器、几何内核、算法模块都已有不错积累;瓶颈集中在前处理环节,问题定义、模型简化、草图建模、参数调试依然高度依赖人工,没有用通用大模型承接这部分工作。各个系统相互独立,用户需要学习多个平台操作,无法做到只靠自然语言描述问题就能完成仿真迭代。3. 传统仿真流程门槛高,重复劳动巨大绝大多数工业仿真不是全新构型设计,而是成熟构件的局部改型。但传统流程里,几何建模、尺寸修改、网格调试这类重复性前处理工作占用大量时间。各类零件模板、算例分散在各个实验室,缺少统一入口来检索、复用。4. 多模态能力尚有短板,但属于可快速补齐模块当前大模型读懂简单工程草图、提取曲线数据仍会出现拓扑误读。但这是专业多模态识别问题,并非底层原理障碍,迭代速度快;并且在整套框架设计中,可以通过「AI列出识别清单,由用户确认」的机制兜底,不会造成仿真结果失真。 二、独一无二的时代窗口期:AI带来换道机会1. 大模型擅长模糊问题梳理通用大模型可以读懂描述不完整的工程需求,自动识别缺失条件,给出合理假设,并且逐条列明假设内容交由用户确认,承担工程问题规范化的工作。2. AI核心优势:检索、重组、局部修改,而非凭空创造工业绝大多数研发是存量结构改型。大模型依托构件模板库,检索匹配相近结构,推荐参考尺寸,做局部参数调整。这套能力稳定性高、幻觉风险低,完美匹配科研与工业改型场景。3. 底层编码人力壁垒被AI抹平有限元、有限体积等基础数值原理公开,不存在技术秘密。过去开发软件最大消耗是海量代码编写、模块组装。AI可以承担大量编码、调试工作,科研人员得以聚焦物理模型本身。 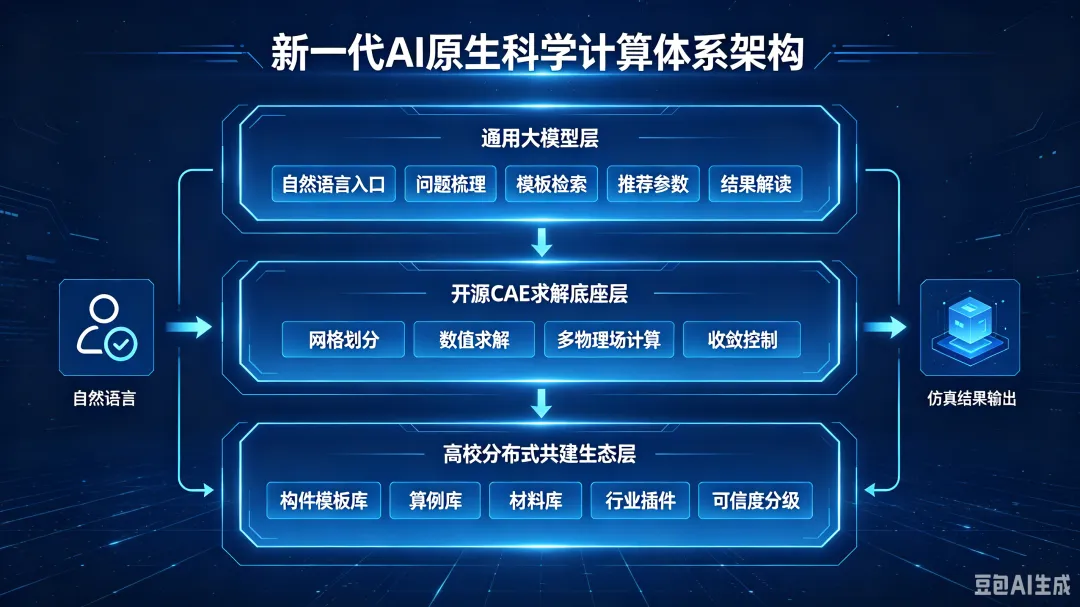
三、本文提出的全新整体解决方案放弃复刻传统CAE软件的老路,打造AI原生、分层解耦、开源共建、渐进迭代的新一代科学计算体系,核心设计:把全部前处理的人机交互、问题梳理、模板检索交给通用大模型。三层架构各司其职,互相解耦,隔离AI幻觉风险。第一层:通用大模型层(唯一人机交互入口)定位:不做数值求解,专注工程问题翻译、模板检索、任务调度、结果解读与人机迭代1. 接收用户自然语言描述,允许参数、结构描述模糊不全;AI识别信息缺口,给出合理简化假设,全部假设显性列出,等待用户确认或修改。2. 检索共建模板库,匹配对应构件拓扑,自动推荐参考尺寸,生成概念三维模型与参数清单。支持上传手绘草图,利用多模态能力解析几何信息。3. 用户确认模型定义后,通过标准化接口向下层开源CAE底座下发仿真任务。4. 获取仿真平台返回的原始场数据,提炼核心结论,过滤冗余信息,反馈给用户,开启新一轮参数修改与迭代。第二层:国产开源CAE专用求解底座层定位:负责稳定、可靠的硬核数值计算。基础框架完全开源,模块化插件设计,预留标准化接口,接收大模型下发的结构化模型任务;完成网格划分、非线性迭代、多物理场求解,返回原始计算数据。不要求底座一开始就具备工业认证级精度,优先保证链路跑通,工程验证后置。第三层:全国高校分布式共建生态层由核心团队维护底层主干框架,保证接口、数据格式稳定。全国高校师生、课题组贡献各类构件模板、算例库、材料参数库、专用算法插件。建立可信度分级标签,区分教学Demo可用、科研参考可用、工业试用,管控模块质量参差不齐的风险。四、整套体系运行闭环1. 用户自然语言描述工程问题(条件可以不完整)2. 大模型梳理问题,检索模板库,给出推荐尺寸与简化假设,生成概念模型,交由用户核对修改3. 用户确认模型信息,大模型调用开源CAE底座,自动网格、求解计算4. 求解平台返回原始数据,大模型提炼关键结果,反馈给用户5. 用户调整结构、参数,重复迭代直到满足需求用户全程不需要操作CAE软件界面,繁重的前处理工作全部交由通用大模型处理。五、分阶段落地迭代策略(先通后精)1. 第一阶段:打通Demo全链路搭建标准化接口、基础构件模板库,实现「自然语言描述—AI建模调度—CAE求解—结果解读」完整闭环。暂不开展复杂工程标定、行业资质认证,优先验证整套体系架构可行性。2. 第二阶段:生态规模化扩张全面向高校开源开放,持续积累算例、材料库、插件;补齐多模态草图识别能力,丰富各类物理场模块。3. 第三阶段:工业能力升级逐步开展工程对标、精度优化、行业认证,向压力容器、能源、航空等高要求工业场景延伸。 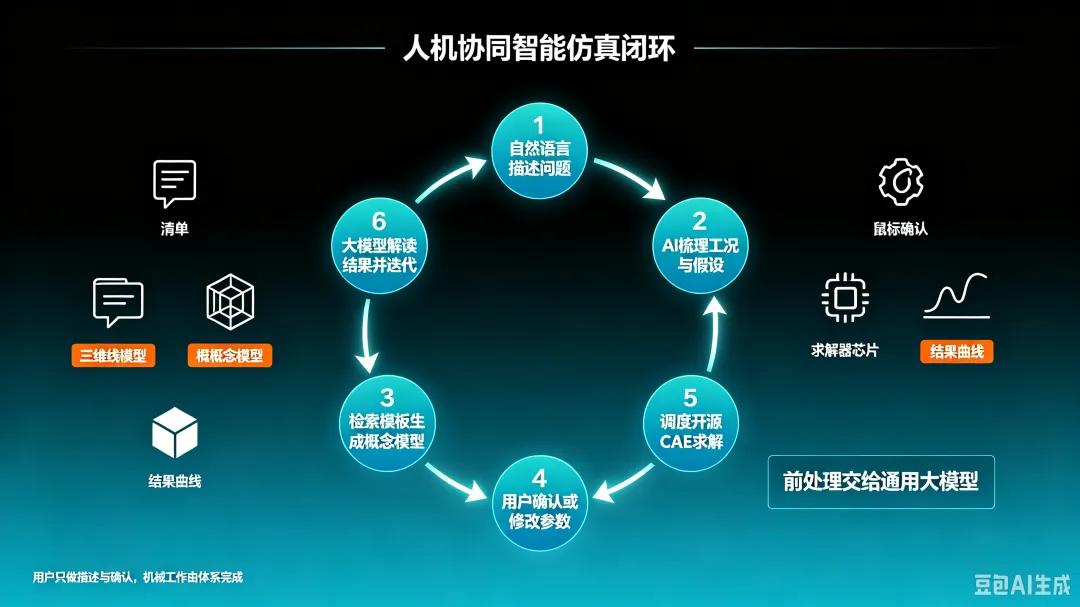
六、方案核心优势1. 换道而非对标:不重复国外商业软件几十年的开发路径,直接打造AI原生仿真体系,旧商业软件沉重的历史架构包袱成为他们的短板。2. 充分发挥我国海量理工科人才基数优势:依靠高校社区分布式共建模板、算例与插件,分担开发成本。3. 边界清晰规避AI风险:AI负责人机交互前处理,数值求解交给专用CAE平台;AI所有假设全部显性化,由人校验把关,杜绝隐性幻觉带来的计算错误。 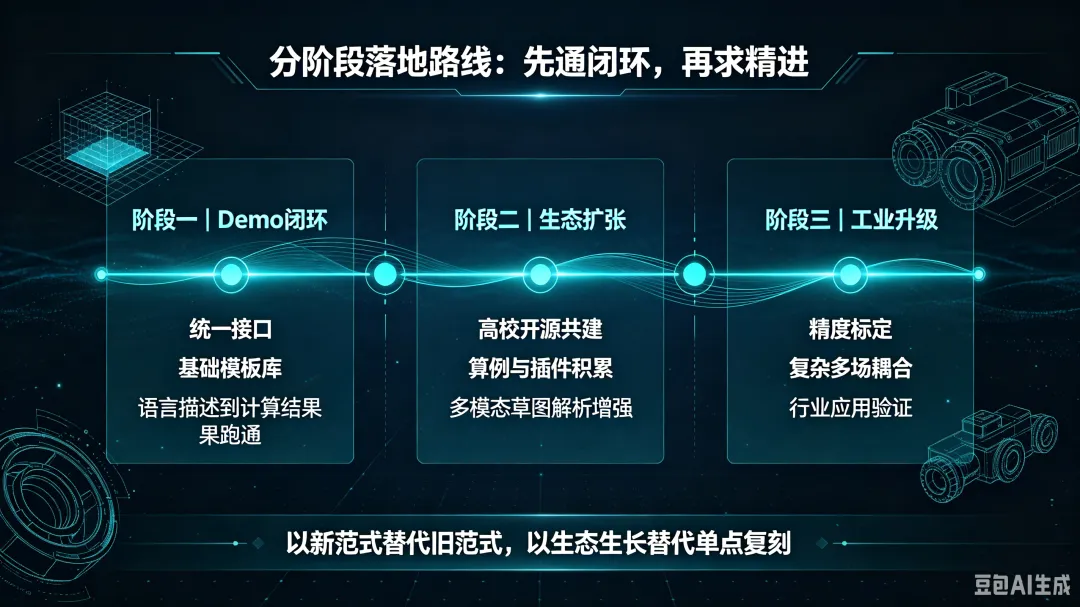
结语国内在科学计算求解器、几何内核方向已经积累了不少成果,但普遍卡在传统前处理模式。我们提出的方案,核心创新点就是将前处理的人机交互、问题定义、模板建模工作交给通用大模型。依托大模型调度+开源求解底座+高校共建生态,抓住当前AI发展的宝贵时间窗口,先跑通完整智能仿真Demo链路,持续生长迭代,有望实现国产科学计算软件领域的换道超车。