ARTICLE · 1124756
AI开始让转录组模型“少样本也能学会”
转录组研究一直有一个很现实的矛盾:一份RNA-seq数据可以测上万个基因,但很多真实研究只有十几个甚至几十个样本。尤其是罕见病、药物响应和特定干预研究,经常处于典型的“small-n, large-p”状态——特征很多、样本很少,传统机器学习容易不稳定,深度学习更容易过拟合。最新bioRxiv预印本提出 GGE(General Gene Expression),尝试换一种思路:与其每遇到一个新队列都重新训练模型,不如先让AI从大量公共转录组任务中学会“如何快速学习一个新的分类问题”。
GGE的核心是 MAML + TabNet。作者从GEO整理了2,079个人bulk RNA-seq数据集,总共构建6,101个二分类任务,并严格按“数据集”而不是单个样本划分训练、验证和测试。真正参与meta-training和meta-validation的共有 1,779个数据集、5,220个source tasks;另外300个完全独立的数据集、881个任务留作meta-testing,避免同一个研究的数据同时出现在训练和测试中。
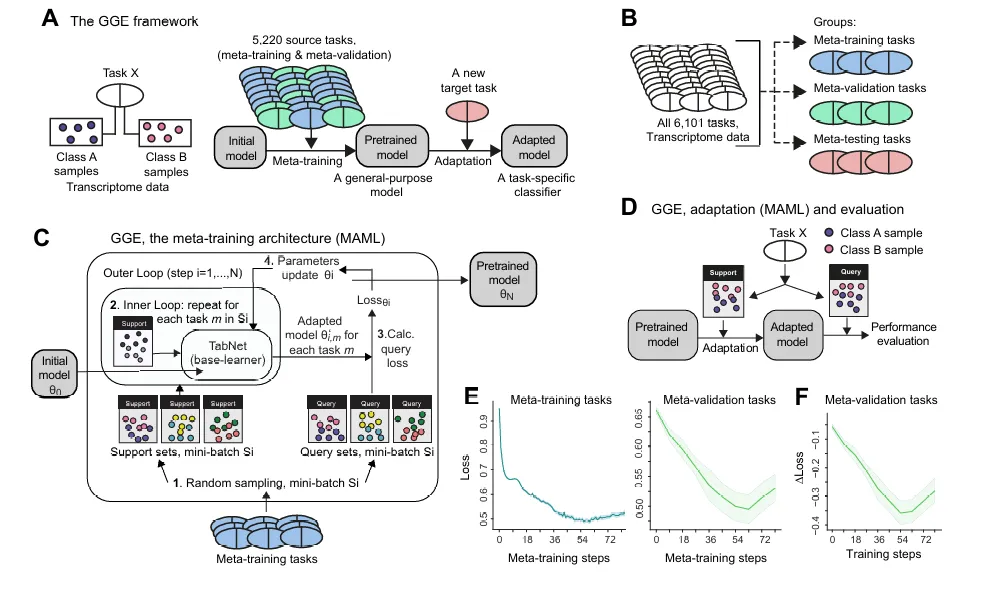
这是整篇文章最重要的方法图:5,220个source tasks先进行meta-training,得到一个通用pretrained model;面对新的target task,只需要少量support samples进行adaptation,就能得到task-specific classifier。下半部分还直接画出了MAML的inner loop和outer loop。
它和普通transfer learning最大的区别,是不要求提前找到“和目标疾病很像”的训练数据。MAML的inner loop先让TabNet在当前任务的support set上快速适配,outer loop再根据query set的表现更新共享初始化。长期训练后,模型学到的不是“某一种癌症的特征”,而是一个能够被少量新样本迅速调整的参数起点。作者将主要实验设定为two-way 5-shot,也就是新的二分类任务只用很少的标注样本完成适配。
结果比较直接。在完全独立的meta-testing任务中,GGE平均F1达到 0.612,而TabNet为0.524、Random Forest为0.509、MLP约0.47、ProtoNet为0.455、SVM为0.392。由于GGE和普通TabNet使用的是同一套base learner和适配流程,两者主要区别在于初始化方式,因此GGE优于TabNet也说明:真正带来提升的不只是模型结构,而是跨大量任务学到的meta-initialization。
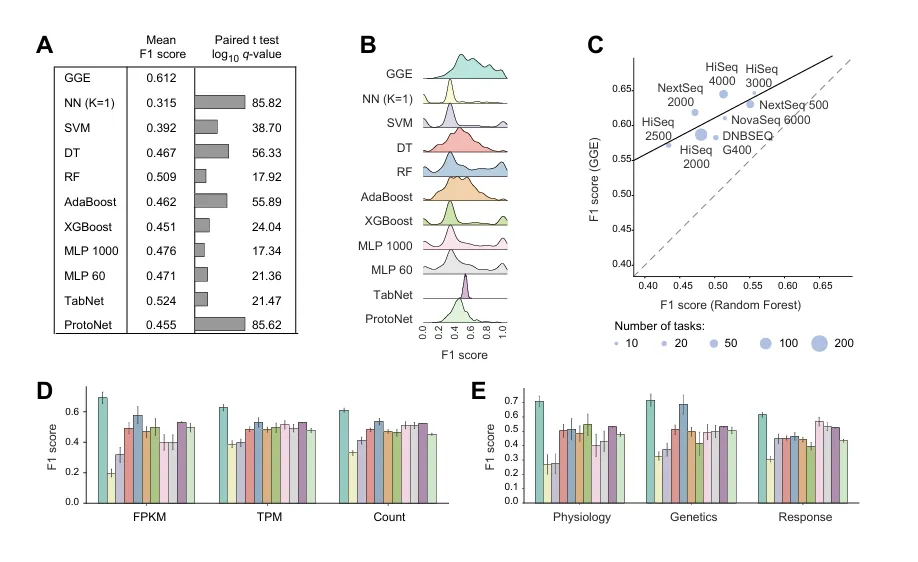
建议放这里。这张图适合直接展示核心性能:A/B是GGE和RF、XGBoost、TabNet、ProtoNet等方法的F1比较;C/D展示不同RNA-seq平台以及FPKM、TPM、raw count条件下的表现;E则比较physiology、genetics和response三类任务。
更重要的是,这种优势并没有局限在某一种数据处理方式。作者的数据来自多个RNA-seq平台,预处理方式也包括FPKM、TPM和raw counts,而且没有进行统一的跨数据集batch correction,只做per-dataset scaling,GGE仍然保持较稳定表现。在physiology、response和genetics三类完全不同的研究目标中,GGE平均F1分别达到 0.70、0.61和0.71,均高于比较方法。
作者进一步问:这个模型是不是只在少数疾病里有效?他们按照ICD-10对meta-testing任务进行分类。在6类有足够数据的疾病类别中,GGE在 5/6类取得最高平均F1;进一步细化到57个具体ICD-10诊断代码,其中 47个,也就是82%,平均F1超过0.5,全部诊断代码的整体平均F1约0.65。按照不同诊断里的模型排名统计,GGE平均rank为 2.9,优于其他分类器。 GGE_ General-purpose deep meta-…
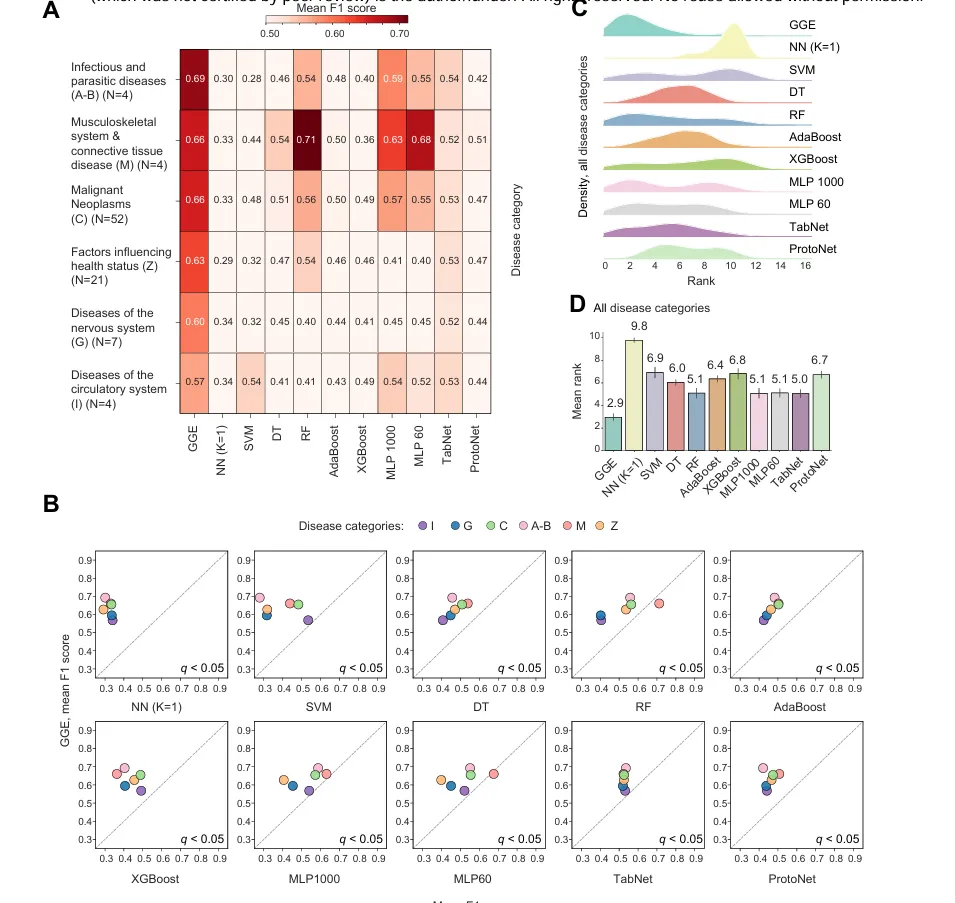
这张图最适合支撑“跨疾病泛化”:A展示6类ICD-10疾病中各算法表现,C/D则展示57个具体诊断代码里的模型排名分布。
模型在不同细胞背景中也保持了较好的适应性。在19种cell line中,18/19的平均F1超过0.5,整体平均F1约0.70;在adaptive和innate immune cell相关任务中,GGE平均F1分别达到0.67和0.57,同样高于大多数比较模型。这个结果提示,模型学到的不完全只是“样本中细胞组成不同”这样的粗粒度信号,而可能包含一定的cell-intrinsic transcriptional pattern。
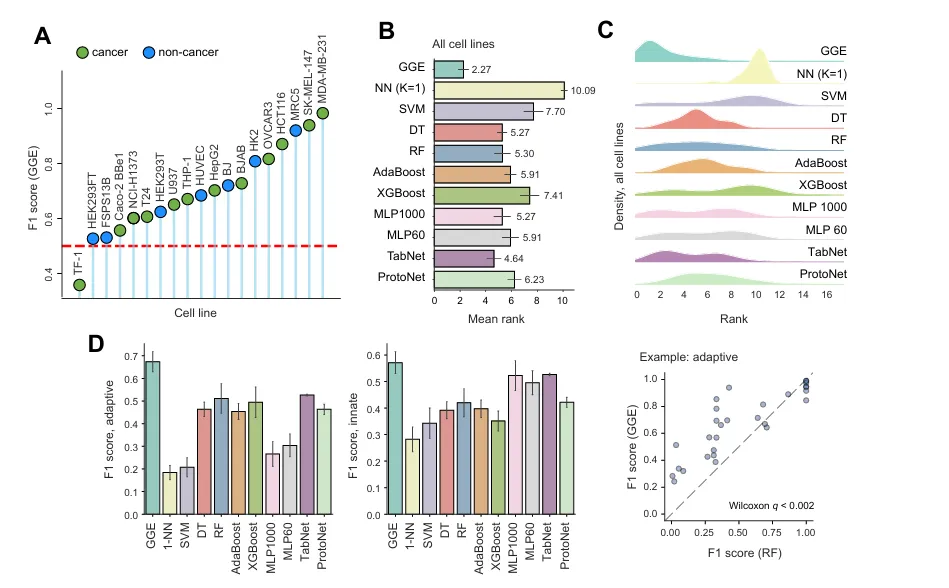
A展示19种cell line的F1,B/C比较不同模型的平均排名,D则展示adaptive和innate immune相关任务。
因为base learner使用TabNet,作者还能利用attention mask反过来看模型到底依赖哪些基因。跨meta-testing任务统计后,Top 100重要基因富集到膜转运、脂质代谢、囊泡运输、葡萄糖输入、电子传递链等基础细胞过程。进一步得到41个显著GO biological processes,其中 37个在至少5/6种疾病类别中重复富集。这提示模型可能不是记住某一种疾病,而是在不同任务中反复调用一组更基础的细胞状态信息。 GGE_ General-purpose deep meta-…
这篇真正值得关注的,不只是“又做了一个转录组分类器”,而是改变了小样本分析的思路。
过去通常是:
来一个新队列 → 从头训练一个模型。
GGE想做的是:
先从大量公共转录组任务里学会“怎么学”,再用少量新样本快速适配。
这和传统foundation model又不完全一样。它不是重点学习一个固定的通用embedding,而是重点学习一个:
meta-learned initialization → few-shot adaptation → task-specific classifier的过程。
所以它更像一个“通用转录组分类器的起点”。
当然,这篇目前仍有明显边界:主要针对 human bulk RNA-seq、二分类、5-shot场景,输入也被压缩为Top 1000 variable genes;此外,所有meta-training任务来自GEO,而GEO本身在疾病种类、研究热点和实验系统上可能存在representation bias。作者也明确指出,更合理地构建meta-learning任务分布仍然是后续需要解决的问题。 GGE_ General-purpose deep meta-…
📄 GGE: General-purpose deep meta-learning for classification of human transcriptomes with limited databioRxiv,2026年10月2日