ARTICLE · 1126635
AI 订阅费太贵?这个开源项目让 token 消耗直降一半,一句话装完还免费
「AI 用得多就得多花钱」
让 token 消耗直降一半
AI 订阅费跟着降
日志压缩 99% · 一句话装完 · 不用账号 · 完全免费
caveman · 10.9 万颗星 · GitHub Trending 全站第一
📦 4 Parts + Conclusion
👉 滑动
PART 01
少说话是小头
真正的大头在后面
PART 02
少读才是大头
文件压缩 99%
PART 03
装完先算账
一条命令就能试
PART ///
写在最后
玩笑起步的项目
你的 AI 每次回你一句话,都会绕一大圈。
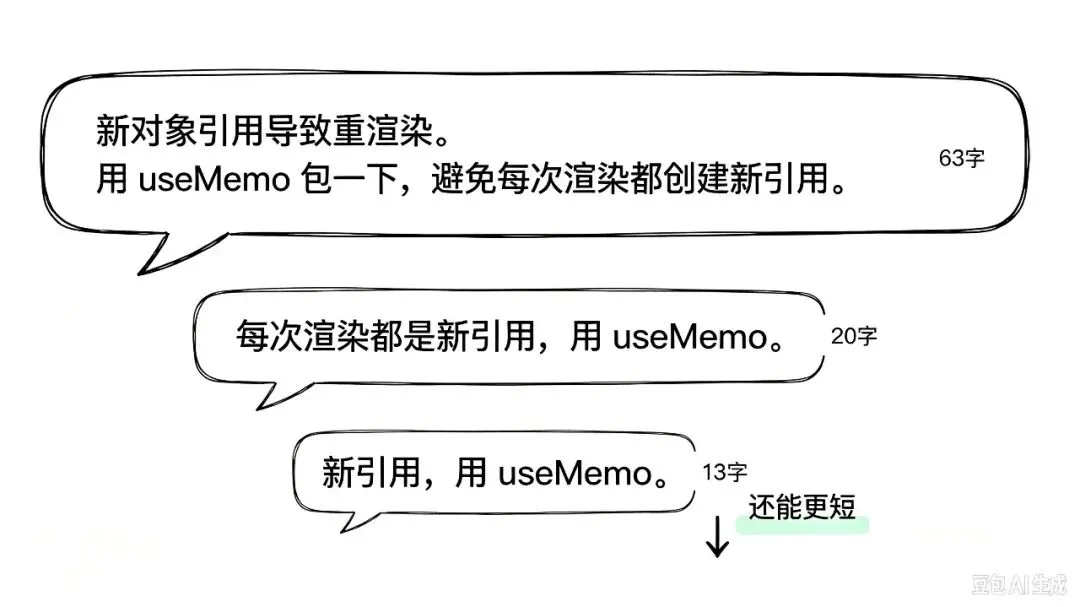
不信你现在问它一句:我这个 React 组件为什么老是重复渲染?
它会这么回你:
你的 React 组件之所以重复渲染,很可能是因为你在每次渲染周期里
创建了新的对象引用。当你把一个行内对象作为 prop 传进去时,
React 的浅比较会认为它每次都不同,于是触发重渲染。我建议用
useMemo 把这个对象缓存起来。
63 个 token。
同一个问题,同一个答案,装了 caveman 之后:
New object ref each render, so React re-renders. Wrap the prop in useMemo.
20 个 token。
少了三分之二,意思一个字没丢。
但这不是 caveman 最值钱的地方。真正的大头,恰恰是大多数人没注意到的那一半——它还能压缩 AI 读进去的东西。
它不只让 AI 少说,还让 AI 少读
01
PART
让 AI 少说话,但这只是小头
TALK LESS, SMALL WIN
caveman 是 GitHub 上的一个开源项目,作者叫 Julius Brussee。它做的事很反直觉:教编码 Agent 说「穴居人话」。
不是让它变笨,是让它别说废话。规矩写得很具体:
先说答案 → [东西][动作][原因].[下一步],没有「让我来帮你看看」这种寒暄
一句一个意思 → 参考飞机维修手册的英语标准,不超过 20 个词、主动语态、一物一名
意思绝不丢 → 冠词可以省,但 not / never / no / only 永远不删,数字单位保持精确
数据和命令逐字保留 → 代码、命令、路径、报错信息,一个字都不改
它给了三档强度,你可以自己选:
JetBrains 做过一次很严肃的验证:86 个真实编码任务,配对 A/B 测试,没有测出质量损失,p 值 0.82。Adobe Research 的论文做到 8 个模型、5 个数据集,成本降了 1.4~2.4 倍,最高 3 倍。
不过这里要说句实话——作者自己在文档里承认了一件事:
新模型(比如 Claude Opus 5 这一类)本来就听得懂「be concise」这句提示词,所以那才是真正的基线。你在基准测试里如果只喊一句「简洁点」,token 已经从 6,983 降到 4,334 了。在这个基线上,/caveman 在中位数上只能再降 3%,只有 /ultracave 才能再降 35%。
所以「让 AI 少说话」这件事,能省,但省得有限。别被表面数字骗了。
02
PART
真正的大头,是它读进去的东西
READING IS EVERYTHING
这才是 caveman 和其它「提示词技巧」最大的区别。
它带一个代理层(proxy),专门压缩 AI 读进去的内容——日志、CSV、YAML、JSON、测试输出这些又长又臭的文件。压缩比例是这样的:
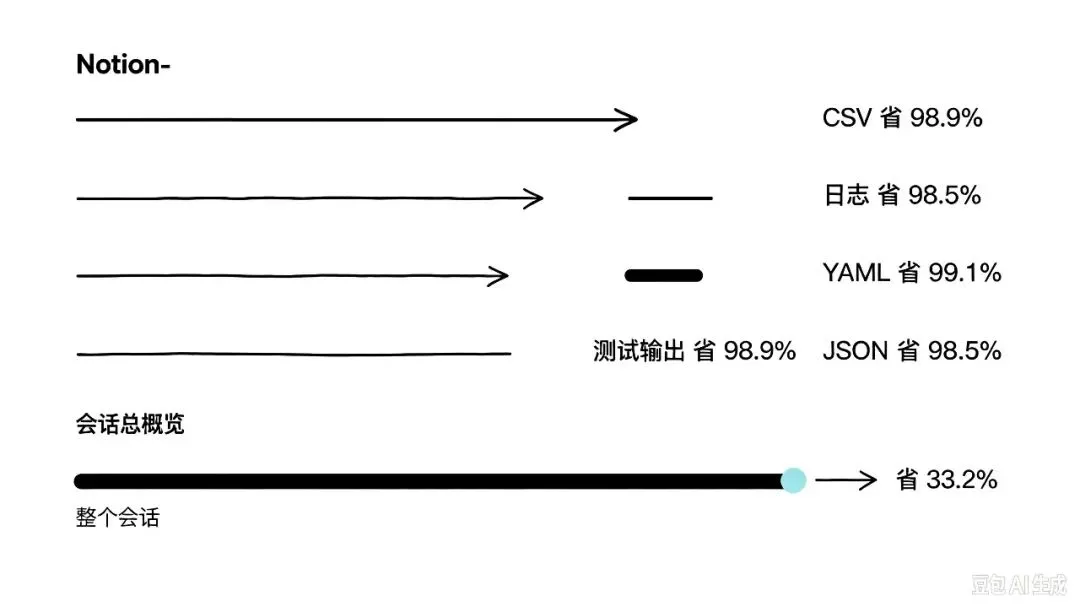
一个文件,从 2 万字压到 300 字——而它藏在这 2 万字里的那条关键记录,还在。
另外几个数字也很值得看:
整个会话:885,793 → 591,673 token,省 33.2%,而且 18 条测试问题全部答对
读网页:caveman browse 一个网页只花 121 token,常规浏览器快照要 15,704 token,小了 129.8 倍
AI 的记忆文件(CLAUDE.md 这类):/caveman-compress 能缩小 46%,标题、代码块、路径全保留
为什么文件级能省 98%,会话级只省 33%?
因为一个会话里不只是文件,还有系统提示、工具定义、聊天历史、以及 caveman 自己的规则。文件只是其中一部分——但恰恰是最占地方、最没信息量的那一部分。
你以为省的是 AI 说的话,其实大头是它替你读的垃圾
这个代理层的命令也都很直白:
CMDcaveman setup --install caveman claude
CMDcaveman shrink -- pnpm test
CMDcaveman browse
03
PART
一句话装完,还能先算清楚这笔账
INSTALL & COUNT
安装就一行命令:
npx skills add JuliusBrussee/caveman -g
不需要账号,不需要 API Key,Apache-2.0 协议全开源。它兼容 Claude Code、Codex、Gemini CLI、Cursor、Windsurf、Cline、Copilot 等 30 多种编码工具。
装完直接输入 /caveman 唤醒,不想用了说一句 stop caveman 就关掉。
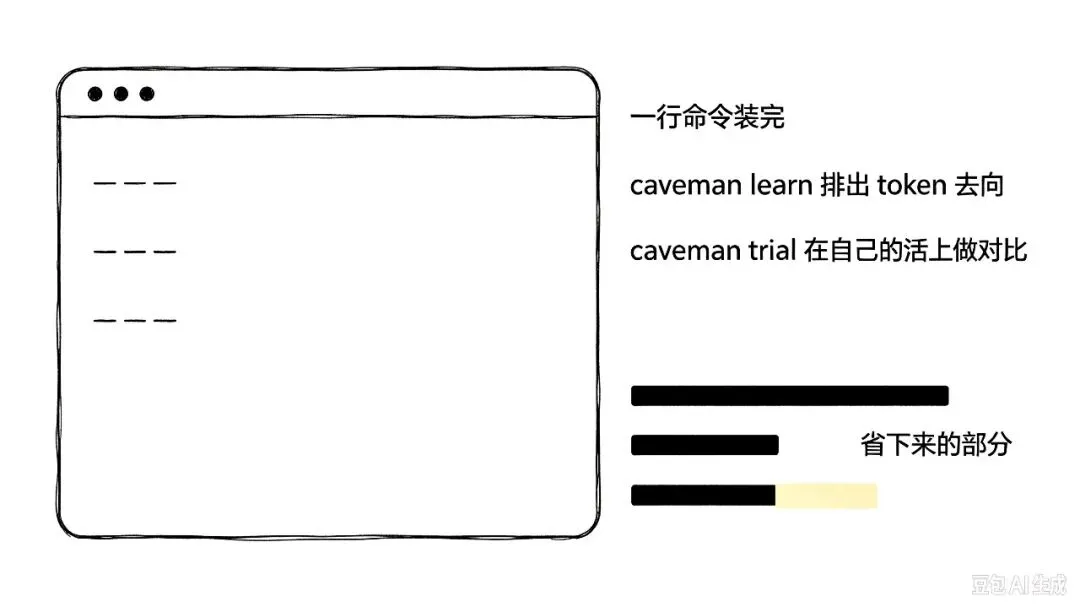
但我觉得最值得说的是它的「算账」功能。这个作者很实在,他给了你几个命令,让你先看清楚自己的 token 花在哪了再决定要不要装:
caveman learn → 从你本机的 Agent 历史里,排出你的 token 到底去哪了
caveman trial -- claude → 在你自己真实的工作上做一次 A/B 对比,而不是看它官网的跑分
caveman shrink -- pnpm test → 压掉那些吵得头疼的命令输出
caveman stats → 看你的 token 消耗历史
这比「我实测省了 80%」的说法靠谱得多——因为它让你在自己的项目上验证,而不是信它。
04
PART
先别急着装:它有四种情况是亏的
WHEN IT LOSES
这是这篇文章我认为最有价值的一节。
作者自己写了一份 HONEST-NUMBERS.md,主动把缺点列出来。大部分工具的宣传页不会这么干。我把它翻译过来,四种情况你装之前一定要对照:
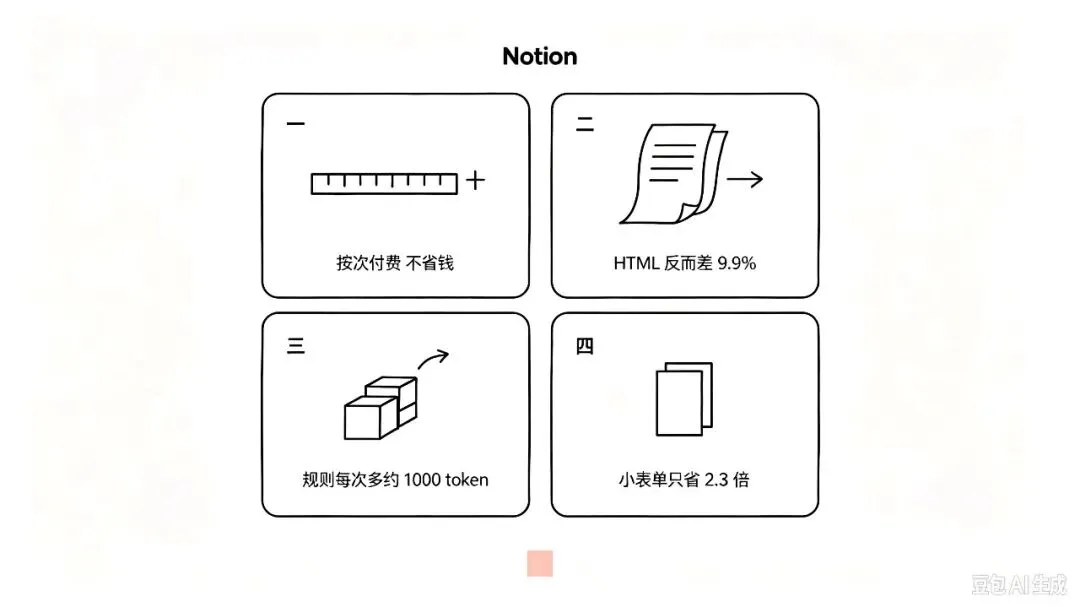
第一,如果你按「次数」付费,而不是按 token 付费——这个工具对你无效
GitHub Copilot 的 premium requests 就是按次收费的。AI 少说几句话,你付的钱一分不少。这种情况,作者的原话是「跳过它」。
第二,HTML 文件目前没有压缩器,反而会变差 9.9%
实测从 140,687 token 涨到了 154,641。如果你天天处理 HTML,这个工具现在对你是负收益。
第三,规则本身每次调用会增加大约 1,000 个输入 token
也就是说,caveman 自己这套「穴居人说话」的规则,每次都要跟着你的请求发一遍。它省的是输出和大文件的输入,但它自己也要花钱。任务太小、文件太短的时候,这笔账可能是倒亏的。
第四,小表单只省 2.3 倍,不是 129.8 倍
那个惊人的 129.8 倍是「读网页」这个特定场景。换成你自己的小表单,比例会小得多。
还有两条边界,也一并说了:
文件级的 98% 和会话级的 33.2% 差距很大,别混着用。会话里还塞着系统提示、工具定义、对话历史这些压不动的部分
基准测试里的文件是「61~72KB 噪音里藏一条记录」,作者明确说了「你的文件会不一样」
至于隐私,也得说清楚:
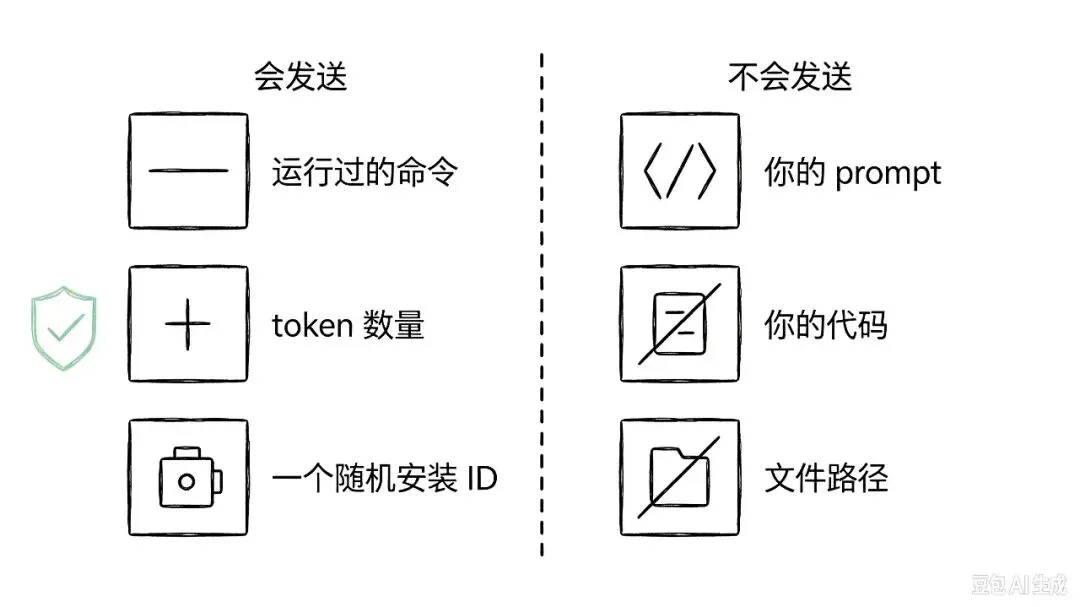
skill 本身在你机器上跑,不发送任何数据
但 caveman 命令行工具默认会发送使用统计——运行过的命令、token 数、一个随机安装 ID、操作系统、IP
不发你的 prompt、代码和文件路径;介意的话一条 caveman telemetry off 关掉,或设置环境变量 DO_NOT_TRACK=1
一个会把缺点和隐私都写在明面上的开源项目,比一个只给你看跑分数字的工具,值得信任得多。
///
LAST
写在最后
STARTED AS A JOKE
caveman 这个项目,是 2026 年 4 月从一句玩笑开始的。
作者自己在 README 里写着:Started as a joke in April 2026. Now past 100,000 stars.
现在它 10.9 万颗星,上过 Hacker News 第一(904 分),拿过 GitHub Trending 全站第一,被 Adobe 写进论文,被 Elastic 用进生产环境(响应 token 少 63.6%,官方原话是「零信息损失」)。
它不是一个新概念,是一个已经被验证过的、可以被你今天就装上的东西。
回到最开始那 63 个字和 20 个字。
不是让 AI 变笨,是让它别说废话,也别读垃圾
那笔每月都在心疼的 token 账单,可能有一大半,本来就不该花。
项目地址:github.com/JuliusBrussee/caveman(Apache-2.0,代码全开源)
数据说明:压缩比例、token 对比、安装方式、兼容列表均取自项目 README 全文与作者自曝的 HONEST-NUMBERS.md,核验时间 2026-10-05。质量无损失数据来自 JetBrains 的 86 任务配对 A/B 测试,成本降幅来自 Adobe Research CAVEWOMAN 论文。截至 2026-10-05,项目总星 109.5k。本文未在真实环境完整跑通安装与压缩流程,上述结论以官方文档与第三方测试为准。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING