ARTICLE · 1126821
multica 源码 09:AI 同事平时根本「不存在」
multica 源码拆解:agent 装配、skill 分发、squad 协作、队列与上下文(加长版)
我的工作区里有几个 AI 同事,各管一摊:写代码、画图、做内容。活儿来了它们自己接,交付完自己把状态改成"待验收",我只管验收。
有个问题我琢磨了一阵:在平台眼里,这些 agent 到底是什么?
是一个 7×24 挂着的进程,还是一个常开的聊天窗口?
拆完 multica 的源码,答案比这两种想象都冷:数据库里的一行。任务认领那一刻,这一行才被读出来、拼成运行时的 agent;任务结束,它又变回一行。
学习项目里有个子任务,专门拆 agent 定义、skill 系统和 squad 协作这三块。拆完之后又补了两轮:一轮多智能体协作,一轮提示词、上下文和调度。
这篇是把它们并在一起的加长版笔记,配图也从三张加到了七张。
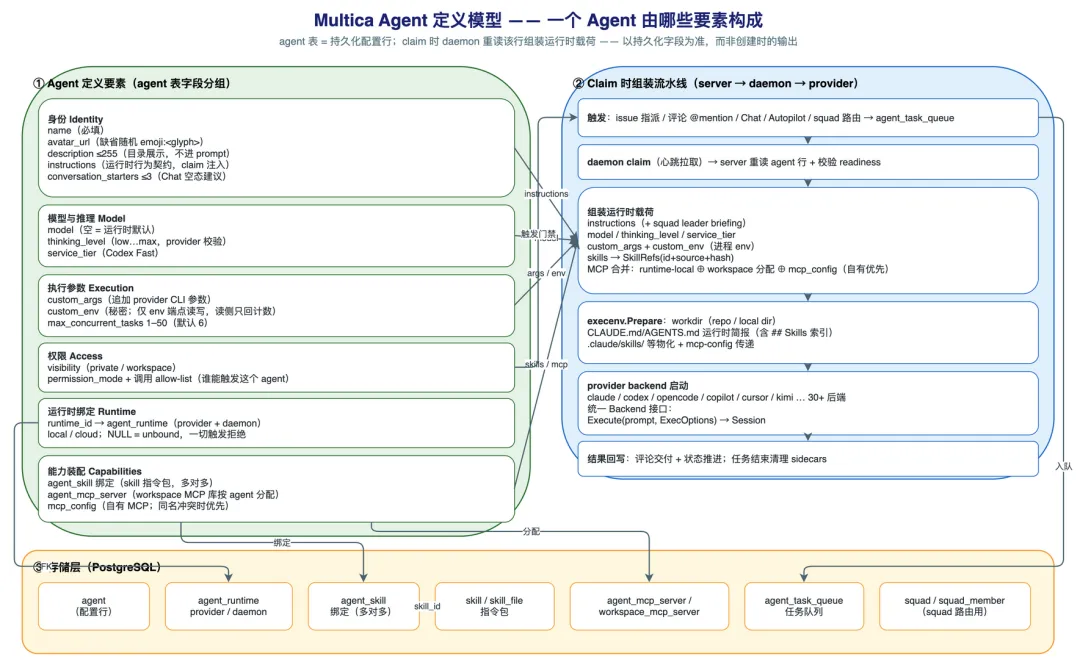
agent 是一张表的六组字段
先看定义模型。一个 agent 落在存储层,就是 agent 表的一行,字段分成六组:身份、模型、执行参数、权限、运行时绑定、能力装配。
两个长文本字段分工明确:instructions 进运行时 prompt,是 agent 的行为准则。
description 只在目录里展示,上限 255 个码点,写不了长篇。
密钥类变量 custom_env 的待遇最特殊。通用的更新接口碰到它直接返回 400 拒写,读写必须走专用端点;查询时只回"有没有、有几个",值本身永远不外露。
组装时机在 claim(任务认领)那一刻:daemon 重新读这一行,现场拼出运行载荷。创建时输出过什么不算数,落库的字段才算数。
我原来想象中"AI 员工住在某个常驻容器里"的画面,就是这么被擦掉的:平时只有档案,活来了,档案才被读成一个人。
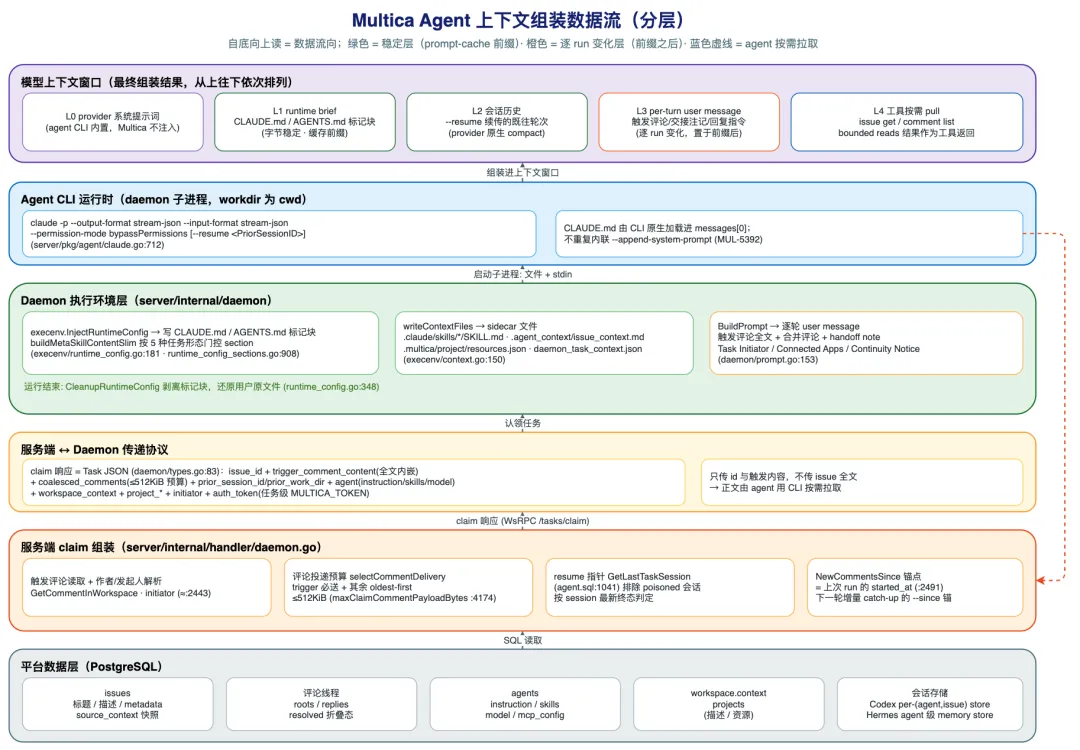
活来了,一次 run 被装配成什么样
补拆的提示词研究刷新了我对「组装」的理解。系统提示不是一份大而全的文档,而是四层:运行时简报、逐轮任务提示、产品功能型提示,外加一批独立的小模型调用。
最底下那层叫运行时简报,每次开工前写进工作目录的 CLAUDE.md,用一对标记块包裹。你在界面上给 agent 起的名字、写的指令,原文就嵌在这里。
简报的字节数刻意保持稳定。道理很实际:大模型按前缀缓存计费,这段一个字节不变,缓存就一直命中,省钱还提速。
每次都变的东西,像触发评论全文、发起人、回复目标,全挪进逐轮消息,放在缓存前缀之后。稳定与易变,切得干干净净。
上下文的注入薄得出乎意料。认领响应里只有 issue id 和触发评论,预算 512KiB;issue 正文和历史评论一概不预注入,由 agent 拿 CLI 按需去读。
读多少、读哪段,成了 agent 自己的判断。平台教方法,不塞材料。顺手一提,CLI 和网页客户端里一条提示词都没有,它们只是纯 API 客户端。
那上下文撑爆了呢?任务直接判失败,会话退休,不重试。下次触发换新会话,注入一段连续性通知,从 issue 和评论里把工作记忆重建出来。
这背后有句设计哲学,值得原样抄下:平台记录是权威版本,任何上下文都永远可重建。agent 可以失忆,账本不能丢。
skill 是教材,MCP 是工具
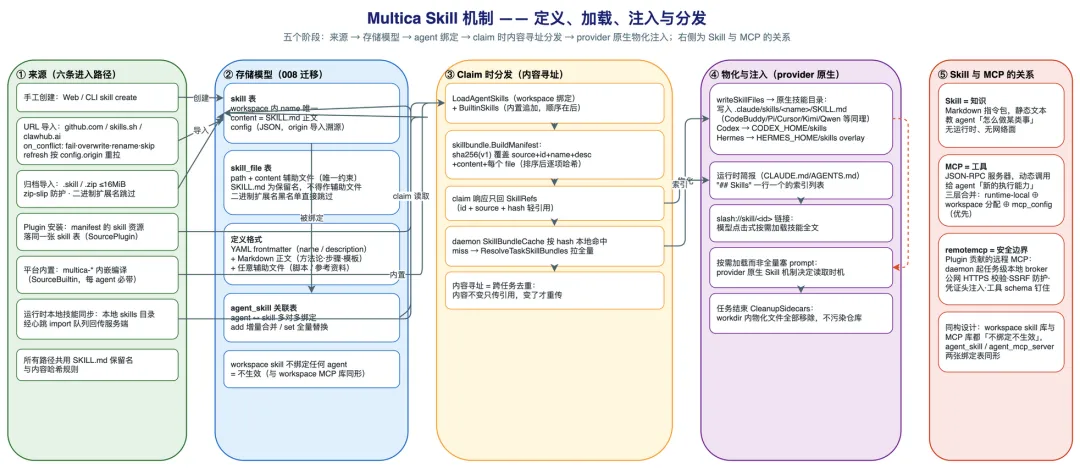
agent 的"知识"和"能力",走两条完全不同的管道。
skill 是静态的 Markdown 指令包,frontmatter 加正文,教 agent"怎么做某类事",本身没有运行时。
MCP 是一个个 JSON-RPC 服务器,agent 动态调用它们,拿到新的执行能力。
我的理解是:skill 像入职培训手册,MCP 像开系统权限。一个教方法,一个给手艺。
两者在绑定层倒是同构的。agent_skill 和 agent_mcp_server 都是多对多的显式绑定表。
库里的 skill 和 MCP 服务器再多,不绑到具体 agent 身上就不生效。
MCP 配置还有三层合并:运行时自带、workspace 分配、agent 私有的 mcp_config;同名冲突时,私有的优先。
远程 MCP 另有一道安全边界。daemon 会为任务起一个本地 broker,去代理公网 HTTPS 端点。
防护全做在 broker 这一层:内网地址直接拒,凭证头在这里注入,管理员还能按"工具名加 schema 摘要"把工具清单钉死。
schema 漂移了怎么办?调用直接拒。
教材按内容寻址分发
skill 的分发方式,是这次我最想抄走的设计。
打包时,BuildManifest 会对 skill 的来源、id、名称、描述、正文和全部文件算一个 sha256。这个 hash 就是这份教材的指纹。
下发更省:任务认领的响应里只回轻引用,id、来源、hash 三样。daemon 本地按 hash 查缓存,查不到才去拉全量;内容没变,就永远只传一次引用。
这套办法和 Docker 镜像同源,都叫内容寻址。基础设施领域的老主意,搬进大模型的上下文管理,刚好撞上"上下文要省着用"这条硬约束。
物化交给 provider 的原生机制:文件写进 Claude 的 .claude/skills/<name>/SKILL.md 目录。
Codex 走 CODEX_HOME,Hermes 用 HERMES_HOME overlay。
运行时简报里的技能一节,只列一行一条的索引;全文什么时候加载,由 provider 原生的 Skill 机制按需决定。
任务结束,CleanupSidecars 把物化的文件全删。教材用完即走,不占工位。
squad:平台只路由到 leader
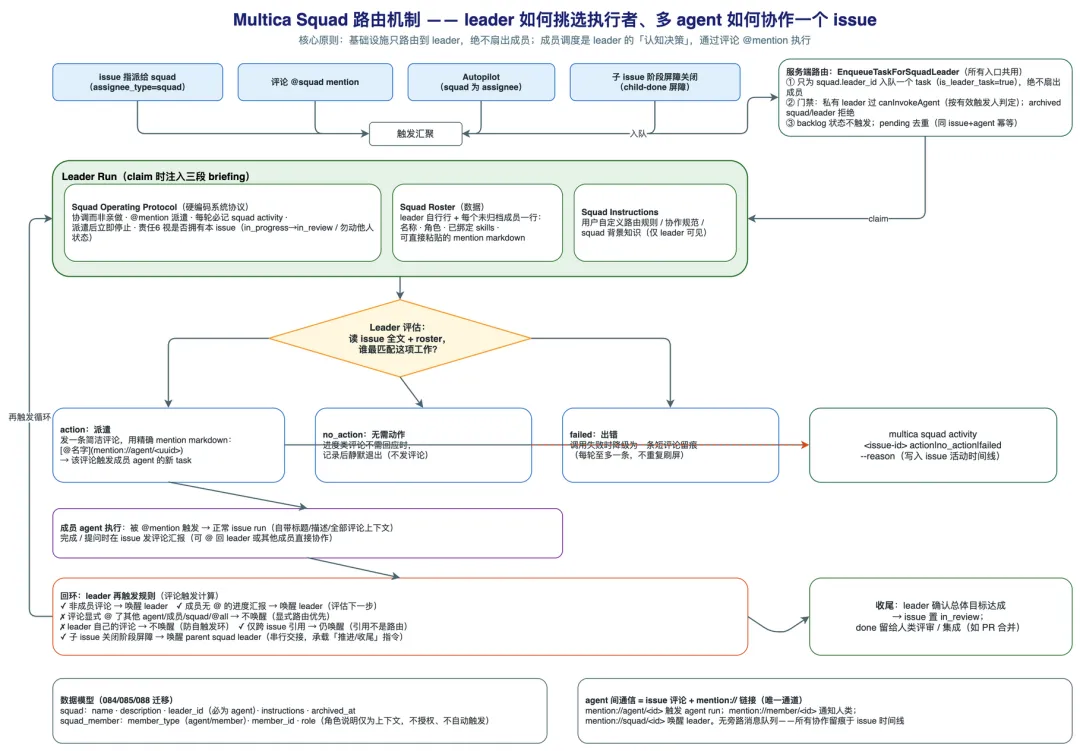
多个 agent 组队干活,活怎么分?multica 的答案里有一条严格的不对称:基础设施只把任务路由到 leader,绝不替它把活扇出给成员。
四类入口,直接指派、评论 @squad、Autopilot 定时触发、子任务阶段屏障关闭,最后都汇到同一个函数 EnqueueTaskForSquadLeader,单点入队。
给成员派活是 leader 的认知决策,载体是一条评论。评论里嵌一个指向具体 agent 的 mention 链接,正是这个链接触发了那个 agent 的新任务。
leader 自己也有纪律:每轮用 multica squad activity 记录评估,action、no_action、failed 三选一。
派完活立即停笔,等成员交付的回环把自己唤醒。
我最欣赏的切分在这里。消息必达、触发必执行这类确定性的事,平台包了;"这活该谁干"这种认知判断,留给模型,基础设施不越权。
leader 的三页简报
协作研究补齐了 squad 在存储层的样子:两张表。一张记 leader 和队规,leader 必须是 agent;另一张记成员,成员既可以是 agent,也可以是人。
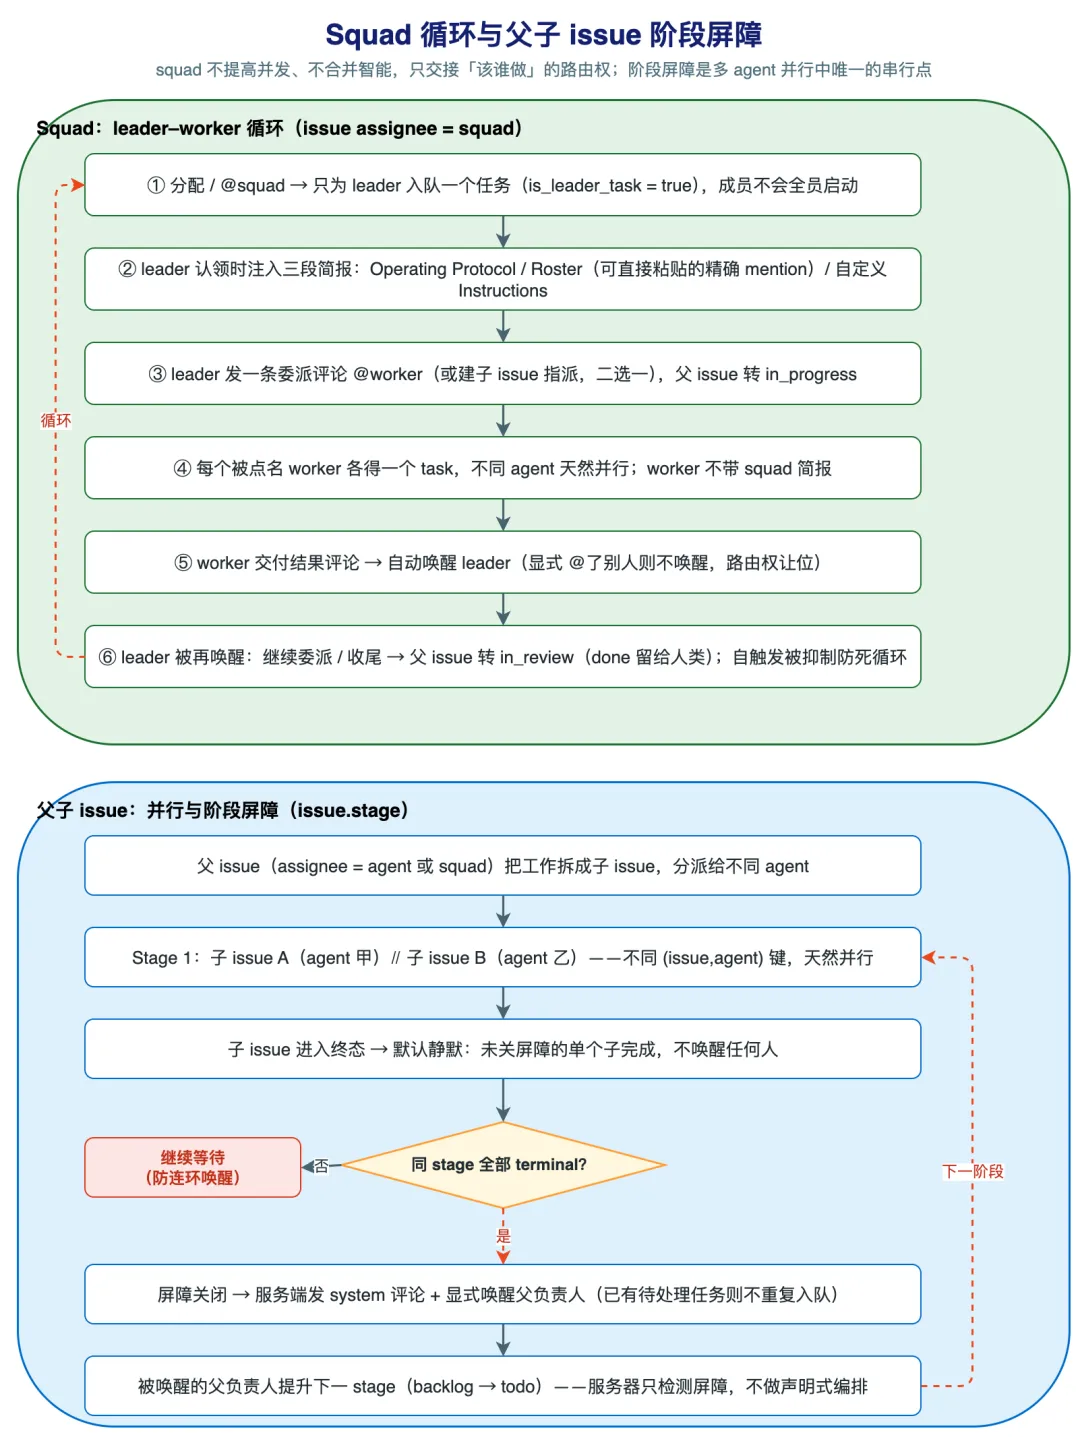
issue 的指派对象因此有三种:人、agent、squad。但服务端没有「squad 执行器」这种东西,所有路径都把 squad 解析成 leader,插一个普通任务,打上领队标记。
标记在认领那一刻兑现。daemon 察觉这是领队任务,往系统提示里追加三段简报:操作协议、花名册、建队时写的自定义指令。
操作协议是硬规则:只协调不动手,派完活立即停笔。花名册每个成员一行,附的是可以整段粘贴的 mention 链接,不是名字。
给链接不给名字,是有原因的:手打 @名字 不触发任何人,必须是编辑器选出的链接才作数。上一轮研究里就有真实翻车,用户打了行纯文本 @,那个 agent 压根没醒。
排队到认领之间若换了 leader 或队伍解散,简报注入会自动降级成普通 run,旧信息不会发给新人。
我还喜欢一刀:worker 的任务里不带简报。领队是任务级的角色,不是 agent 的属性,这次你带队,下次你干活。
通信只有一条通道
squad 内部没有旁路消息队列。agent 之间唯一的通信方式,就是 issue 评论加 mention 链接,所有协作天然留痕在时间线上,人随时能回看全链路。
mention 分三种,效果不同:指向 agent 的触发一次运行,指向人的发一条通知,指向 squad 的唤醒 leader。
什么时候唤醒 leader?规则比想象中精细:
成员汇报进度,没 @ 任何人:唤醒 leader
评论里显式 @ 了别人:不唤醒,显式路由优先
leader 自己写的自评:不唤醒,防自环
子 issue 阶段屏障关闭:唤醒父任务的 leader,串行交接
初看简陋,细想是刻意的。一条时间线就是整本协作台账,审计成本压到了最低。
一条评论的完整旅程
「评论即总线」这句话,协作研究拆到了函数级。有几条细节,值得补给上一篇没讲透的地方。
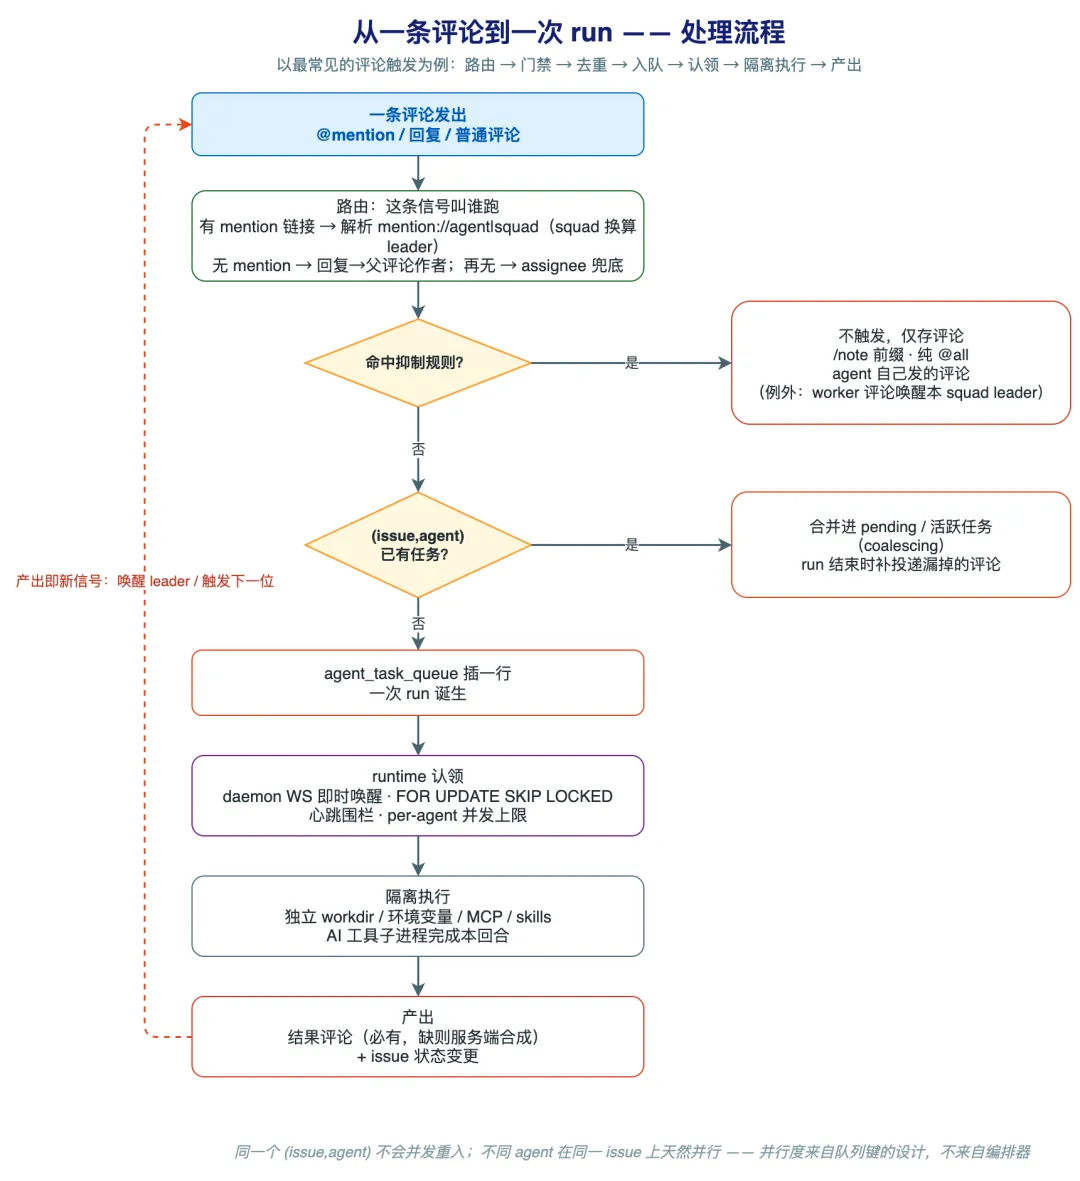
评论里没有 @ 的时候,路由走一条回退链:先找被回复那条评论的作者,再看会话延续,最后落到 issue 负责人兜底。
不触发的也有清单:/note 开头的笔记、纯 @all、agent 自己发的评论、成员互回复。唯一例外是 worker 汇报会唤醒本队 leader,协作闭环的专用车道。
还有条反直觉的:回复一条已标记解决的线程,不但照常触发,线程还会自动重开。想悄悄补一句话,没门。
inbox 完全不参与这些。那是纯给人类看的通知面,文档写得直白:agents don't use the inbox。agent 被 @ 到,得到的是一个 run,不是一条通知。
防重复靠数据库:每个 (issue, agent) 只允许一个待处理任务,部分唯一索引兜底。同一 agent 的连续评论,合并进那个还挂着或正在跑的任务。
run 结束还有一道对账,把期间漏投递的评论补发给刚干完活的 agent。评论必达,只是不保证挤进上一趟车。
工位、锁与并发上限
多个 agent 同时干活怎么不打架?答案是队列加锁,不是编排器。
认领用一条 SQL:FOR UPDATE SKIP LOCKED,抢不到就跳过,优先级加先进先出。想认领的 runtime 还得靠心跳证明自己活着。
同一个 issue 上的同一个 agent,任何时刻只有一个活跃任务,入队前有检查挡着。不同 agent 在同一个 issue 上,天然并行。
并发天花板由三个数取最小:单 agent 并发上限,默认 6;本机空闲槽位;(issue, agent) 唯一槽。没有中央大脑,规则本身就是天花板。
文件层面每个任务一个独立工位,路径带 issue 号和任务键,初始为空,要代码再去 checkout。绑本地目录的任务同路径互斥,想并行就给每任务开一个 git worktree。
入队之后也不用苦等轮询:服务端经 daemon 的长连接推一句「有活」,断连了才退回轮询。
阶段屏障:唯一的串行点
子任务并行还有一层结构:stage。同一个父 issue 下,子 issue 按阶段分组,阶段是有序的屏障组。
规则一条:同阶段全部进入终态,才算关闩。关闩那一刻,服务端发一条系统评论,唤醒父任务负责人。
没关闩时,单个子任务完成保持静默。这是防连环唤醒,十个子任务做完九个,个个都喊一声,父负责人会被打断九次。
关闩之后,下一个阶段谁来提升?被唤醒的那个 agent 自己。服务器只检测屏障,不指挥下一步,又是那条切分:确定性归平台,判断归模型。
定时任务也长在这套逻辑上。调度记录全在一张数据库表里,多实例靠唯一键加租约抢锁,三层去重;错过的班次只补最近一趟,再早的放弃。
wakeup 是同一思路的另一种表达:它不是睡着的进程,是存在 issue 上的一条配置,「未来的信号」。到点或等到事件,仍走同一条入队路径。
它们记得住什么
身份的建模出乎意料地薄:name 必填,avatar_url 缺省时随机给一个 emoji 头像。
没有 pronouns 列,代词规范只写在运行时简报的 prompt 层,不落库。
memory 没有第一类字段,持久上下文实际分四层。
前两层好理解:issue 的描述、评论、metadata,用户可见可改;PriorSessionID 让 agent 续接上一次会话。
后两层:运行时简报每轮重注入,agent 每次开工都重读一遍"员工手册";provider 原生记忆由 daemon 管控。
原生记忆各有打法。Hermes 给每个 agent 建隔离的 memories 目录,90 天回收一次。
Codex 的 auto-memory 有跨任务、跨 workspace 泄漏的风险,默认禁用,要用得手动开。
Codex 这个默认关闭,我觉得很清醒:宁可让 agent 健忘,也不冒泄漏的险。长期方向源码分析里也写了,做 Multica 自有的、用户可见的 memory 存储。
一条管线串起全部
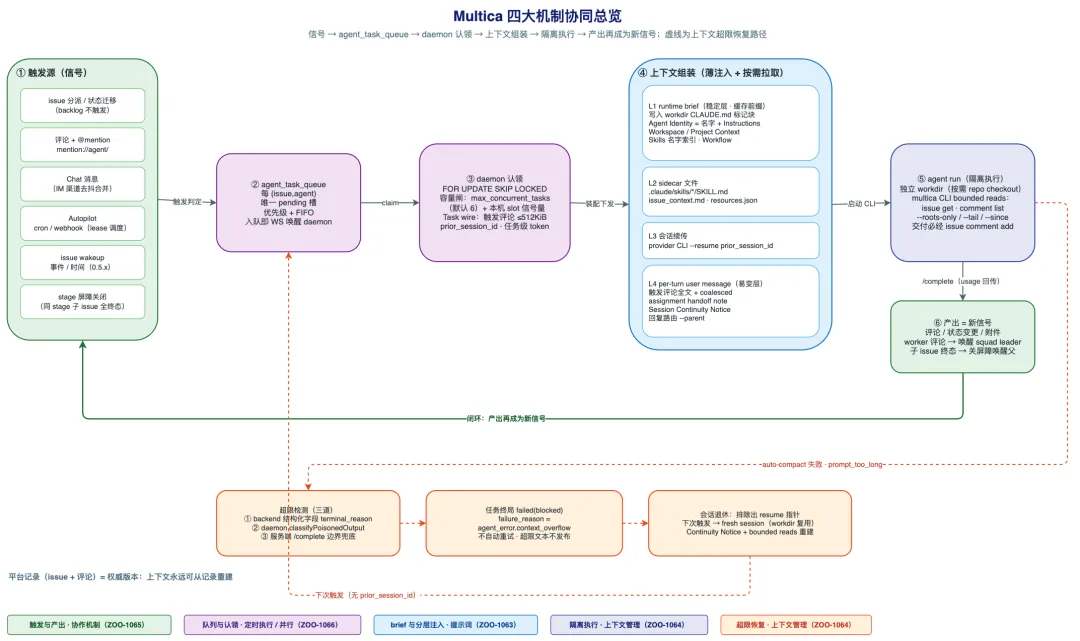
两轮研究合起来看,所有机制收束成一个循环:信号,入队,认领,装配,隔离执行,产出,产出又成为下一个信号。
分派、评论、chat、autopilot、wakeup、屏障关闭,起点五花八门,归一化的结果都一样:任务队列表里插一行。一次 run 就是一行。
提示词回答「这次 run 被装配成什么样」,协作与调度回答「谁在何时被装配」。一个管材料,一个管工序。
失败也不出循环:上下文撑爆的 run 退休,「下一次触发」又是普通的一行。平台记录永远在,重建随时可以发生。
这套机制的边界
读下来佩服归佩服,几处保留意见得说在前面。
评论即总线,延迟以分钟计,信息密度也不高。粗粒度、异步的任务流没问题;高频细粒度的协作,时间线会被灌爆。规模问题我在分析报告里没找到讨论,这是我自己的疑问。
leader 是单点。一个 squad 的上限就是 leader 的判断力,它停了,整组跟着停。
内容寻址省的是传输,不省 token:skill 全文加载进上下文时,该吃的字数一个不少。
新研究也添了两条保留。队列键是 (issue, agent),同一个 agent 在同一个 issue 上永远单线程,想让他真并行干两件事,只能拆 issue。
stage 屏障只有「全完成」一种触发,表达不了「这三个好了就先开工」的部分依赖。粗流水线够用,精细依赖图就捉襟见肘。
所以这套设计成立的前提是:任务粒度粗、协作可异步、人类全程可审计。三条都占,它是好答案;不占,别硬抄。
拆完之后
拆完这几块,我对"AI 同事"的想象变了。费劲的不光是让它变聪明,还有给它建档案、发教材、定调度、留痕迹这一整套组织系统,活来了再把它读成一个人。
如果你也在搭 agent 团队,留言聊聊:你给第一个 agent 写的 skill,打算教它做什么?