ARTICLE · 1133453
让AI像人一样读文档,800 页 PDF 根本塞不进 AI,GitHub 上 3.8 万星的这个项目换了条路.
让AI像人一样读文档,800 页 PDF 根本塞不进 AI,GitHub 上 3.8 万星的这个项目换了条路.你肯定干过这事。 把一份一百多页的 PDF 拖进对话框,问它里面的一个数。 它要么说文件太大。 要么回给你一段看着挺像回事、但你不敢引用的话。 为了让 AI 读懂长文档,行业后来搞出一套标准动作。 切块、转向量、存进向量数据库、按相似度往回捞。 这套流程有个根上的毛病。 相似,不等于相关。 最近 GitHub 上有个项目已经 38,700 多星了。 它走的是另一条路。 
01 开源项目简介 这个项目叫 PageIndex。 VectifyAI 出品,MIT 协议,Python 写的。 一句话:不用向量数据库的 RAG 引擎,靠推理来找内容。 它的做法只有两步。 第一步,给文档建一棵树。 第二步,让大模型顺着这棵树推理着往下找。 像人一样先翻目录,再翻到具体那一节。 作者说这个思路是从 AlphaGo 那儿来的。 它的目标场景很明确。 财报、法律文件、监管报送、技术手册、医学文献、几百页的教材。 就是那些让你头疼的长文档。 项目地址: 02 向量检索到底差在哪 先说老办法的问题。 你把文档切成一堆小块,每块算个向量。 提问的时候,把问题也变成向量,捞回挨得较近的几块。 听起来合理。 但它找的是长得像的,不是真相关的。 举个例子。 你问「2023 年的营业利润率是多少」。 相似度检索会把所有带"利润率"字眼的段落都捞出来。 包括 2021 年的、2022 年的、还有隔壁公司对比那一段。 它不看年份,不看主谓关系,不理解上下文。 数字就在里面,答案就是错的。 PageIndex 换了个思路。 先把整份文档整理成一棵带层级的树。 一级一级往下,跟你翻书的目录没区别。 你要查什么,模型先看目录判断该往哪走,再一层层落到具体节点。 这个过程是推理,不是比距离。 好处有两个。 一是答案能追溯,它会告诉你是从哪一节哪一段找出来的,不是凭感觉捞的。 二是它能带着上下文判断。 你的追问历史、这个领域的常识,都能参与进去。 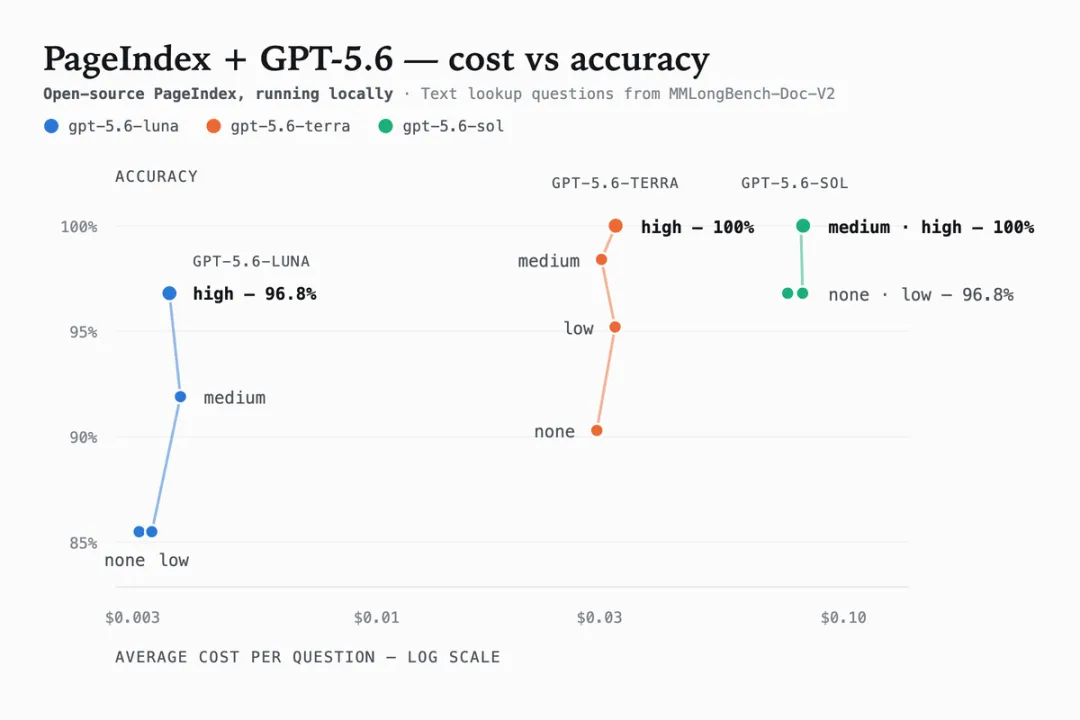
03 钱和时间,作者给了实测数字 这点我觉得挺难得,很多项目只会说快,不给数。 建一次索引的成本。 大约一页 0.001 美元。 一本一千页的书,一美元多一点。 关键是这个索引建一次就完事了,后面问多少次都不用重来。 耗时会随页数增长,但很规律。 9 页到 1098 页的文档,实测下来是 13 秒到 4 分半。 再说说它省了多少钱。 很多人现在图省事,直接把整份 PDF 塞给模型。 那份后果随页数暴涨。 作者测出来,同样能答对的前提下: 52 页的时候,整份塞进去要贵 2.1 倍。 198 页,贵 7.8 倍。 420 页,贵 16.6 倍。 到 805 页,直接超出模型的上下文窗口,塞都塞不进去。 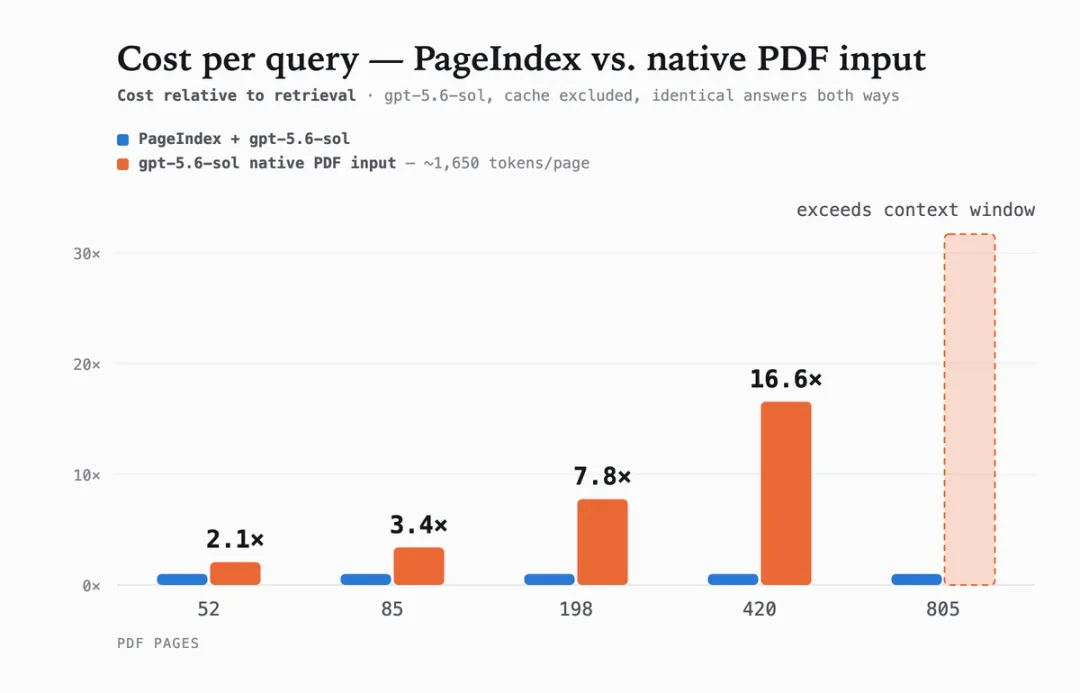
这些数不是拍脑袋的。 作者还放了一个开源评测仓库,62 道查证题、34 份文档、1945 页,代码和数据全公开。 题目设计得也很实在。 答案都是正文里明写着的数字。 答错就是检索或者阅读没做对,跟推理能力无关。 04 怎么用 用起来不复杂,先装个包。 然后几行 Python: 它可以跑在本地,用你自己的模型 key。 也可以接它的云服务,或者挂到 MCP 上给别的助手调用。 模型选择上有个省钱小技巧。 建索引用便宜模型就够了,因为树的结构本来就是从文档排版里抽出来的,模型只负责归纳整理。 查的时候用好模型,这一步才是真在推理。 不想写代码的话,官网有个网页版,直接传文档开问。 05 这事背后的逻辑 我为什么觉得这个值得写。 这两年大家说到 RAG,脑子里就是那套流程。 切块、嵌入、向量库、相似度。 好像不这么做就不叫 RAG。 但它的地基其实有个口子。 相似度是数学上的距离,相关性是理解上的事。 这两样东西,从来就不是一回事。 以前我们绕着这个口子补,加召回规则、加 rerank、加混合检索。 现在有人直接问:为什么非得比距离? 给文档做一张目录,让模型像人一样顺着翻下去,不就行了。 这个转向挺有意思。 以前我们让文档适应机器——切成机器好比对的碎片。 现在我们让机器适应文档——照着我们读书的方式读。 顺着这个想下去,很多"标准做法"其实都还只是过渡方案。 哪个标准动作先被换掉,不好说。 但 38,700 个 Star 至少说明一件事。 大家早就受够了那个"看起来很像,其实答非所问"的答案。
https://github.com/VectifyAI/PageIndexpip install -U pageindexfrom pageindex import PageIndexClientclient = PageIndexClient()doc_id = client.submit_document("report.pdf")["doc_id"]answer = client.chat("2023 年的营业利润率是多少?", doc_id=doc_id)print(answer)