ARTICLE · 1135251
AI 编程助手天天失忆?我给它装了个开源「海马体」
它答不上来。上一次会话里我们明明掰扯了半小时,决策理由、踩过的坑,全随着会话关闭蒸发了。
这不是 Claude 一家的问题。所有 AI 编程工具都欠着一笔记忆债:会话一关,记忆清零。
后来我装了一个开源项目,这问题基本消失了。它叫 Claude-Mem,作者是 Alex Newman,Apache-2.0 协议,我把它 README 和文档翻了一遍,越看越觉得这东西做得聪明。
图:Claude-Mem 官方 Logo(来源:项目仓库 docs/public 目录,WebP 转 PNG)
一、它是什么,解决什么问题
官方定位一句话:为 Claude Code 构建的持久化内存压缩系统。
它干的事说起来不复杂:自动捕获你每次会话里 AI 的工具调用和操作,压缩成结构化的「观察记录」,存进本地数据库;下次开会话,自动把相关上下文注回去。
关键是全自动。跟你手动维护 CLAUDE.md 那种项目笔记完全是两回事,装完之后你该干嘛干嘛,它在后台自己记。
写这篇文章时它的版本号已经跑到 13.34.2,迭代非常勤。
为什么这事值得做?我自己的体感是,现在 AI 编程最大的浪费不是 token 费用,是每次会话都在「重新入职」。
项目越大,重复交底的成本越高。你反复解释架构、反复强调约定,模型转头就忘。
市面上的替代方案要么累人,要么费钱。手动写笔记,维护成本高还容易过时;传统 RAG 检索,不问好坏先塞一大坨历史进上下文,token 哗哗地烧。
Claude-Mem 的答案是四个字:压缩,再渐进披露。
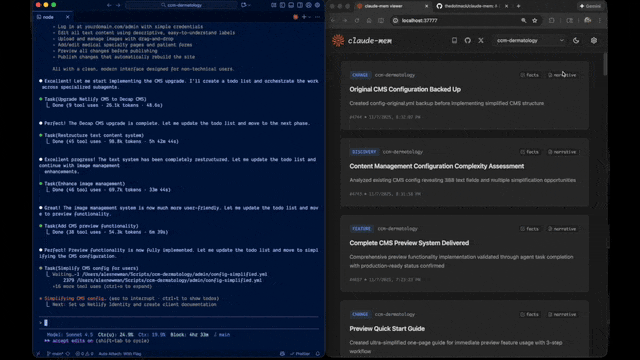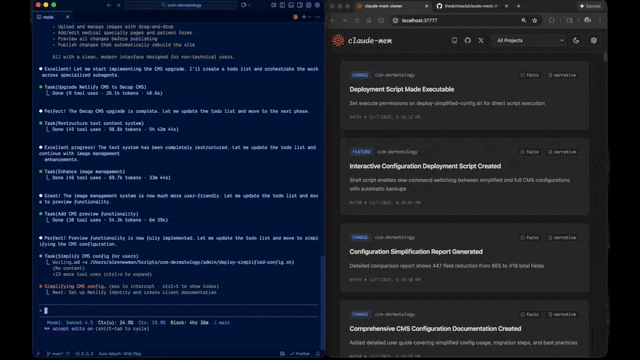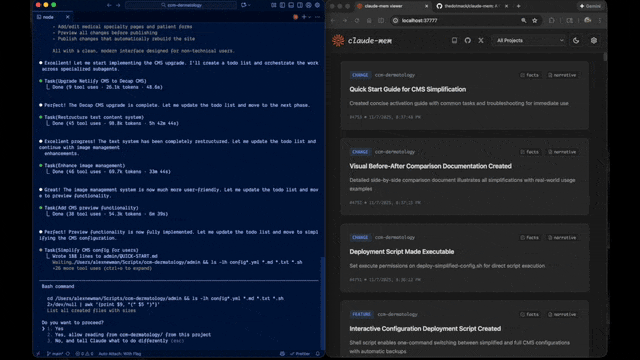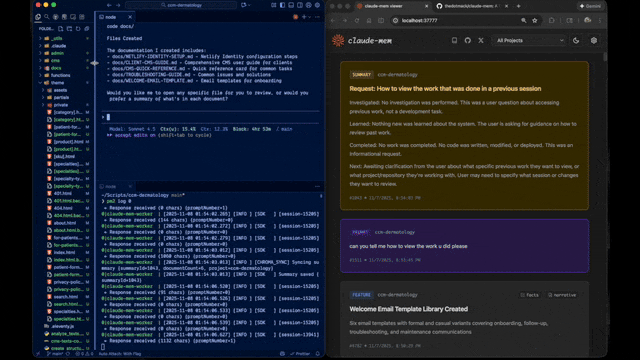
图:官方 README 演示动图,浏览器里的实时记忆流查看器(来源:项目仓库 docs/public/cm-preview.gif)
二、实现原理与架构
先报技术栈:TypeScript 全家桶。钩子跑在 Node.js 20+ 上,常驻服务用 Bun 管理,HTTP 层是 Express 5,存储用 SQLite + FTS5 全文索引,可选 Chroma 向量库做语义搜索,配套查看器是 React 写的。
它以 Claude Code 插件的形式存在,往会话生命周期里注册了钩子,这是全部魔法的起点。
SessionStart 钩子负责拉起后台服务,把历史会话的上下文注回来;UserPromptSubmit 记录你的原始提问;PostToolUse 是最忙的一个,每次工具调用都会被抓一条「观察」,一个会话能抓上百次;Stop 钩子在结束时生成总结,外加 SessionEnd 清理现场。
完整流水线长这样:钩子抓原始数据 → 存入 SQLite → 后台 Worker 调 Claude Agent SDK 做 AI 压缩 → 结构化摘要写回数据库 → 下个会话读出来注入。
Worker 是个本地 HTTP 服务,默认端口在 37700 附近(按用户偏移,可用环境变量 CLAUDE_MEM_WORKER_PORT 改),上面还挂了一个 React 写的 Web 查看器,浏览器打开就能看到实时滚动的记忆流,观感很像刷弹幕。
AI 压缩这层默认走 Claude Agent SDK,也可以换成你自己的 Gemini 或 OpenRouter key。
每条观察都带结构化元数据:类型标签(bugfix、feature、decision、discovery、refactor、change)、涉及的文件、概念、叙事经过和关键事实。
搜索这块是我认为最值钱的设计。它把检索拆成三层:
第一层 search,只拿紧凑索引,每条结果 50-100 token;第二层 timeline,看某条记录前后的时间线脉络;第三层 get_observations,对筛出来的 ID 才拉全文,每条 500-1000 token。
官方口径是相比「一次全捞」的传统 RAG,省约 10 倍 token。
数据全在本地,就一个 SQLite 文件,~/.claude-mem/claude-mem.db。担心丢可以开 Cloud Sync 同步到官方的 cmem.ai,不放心云就把这功能关着。
三、五分钟装好
前置条件只有两个:Node.js 20 以上,最新版 Claude Code。Bun 和 uv 缺了安装器会自动补。
一条命令装:
npx claude-mem install
或者在 Claude Code 里直接走插件市场:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
装完重启 Claude Code,上一个会话的上下文就会自动出现在新会话里。
它还支持 OpenCode、Cursor、Windsurf、Codex CLI 等一串宿主,装法都是换参数:
npx claude-mem install --ide opencode
安装器会引导你在浏览器登录(邮箱魔法链接,不用绑卡),送 30 天托管记忆试用,到期自动回落到你自己的 Anthropic plan;不想登录,加 --provider 参数跳过,CI 环境下则完全无感。
一个坑提前说:npm install -g claude-mem 只装 SDK 库,不注册钩子也不起服务,别这么装,认准 npx claude-mem install。
四、怎么用,两个真实例子
例一:把记忆切成中文。
编辑 ~/.claude-mem/settings.json(首次运行自动生成):
{
"CLAUDE_MEM_MODE":"code--zh"
}
这个开关同时控制工作流行为和观察记录的语言,简体中文模式内置,改完重启 Claude Code 生效。想看全部模式列表:
ls ~/.claude/plugins/marketplaces/thedotmack/plugin/modes/
之后你正常干活就行。某天想翻旧账,浏览器打开 worker 地址(启动时打印),或者直接 API 查:
curl "http://127.0.0.1:37700/api/search?query=登录超时"
例二:三层搜索工作流。
平时你甚至不用记命令,会话里直接问:「搜一下我们上次是怎么修登录超时 bug 的」,mem-search 技能会自动触发。想精细控制,就让 Claude 调它的四个 MCP 工具:
// 第一步:搜索引,只拿 ID 和标题
search(query="authentication bug", type="bugfix", limit=10)

// 第二步:看 #123 前后发生了什么
timeline(anchor=123, depth_before=3, depth_after=3)

// 第三步:对筛出的 ID 拉全文
get_observations(ids=[123, 456])
成本账很好算:20 条全文直取要烧 1 万到 2 万 token;先搜索引再挑 3 条拉全文,3000 token 搞定,而且条条相关。
顺带一个隐私细节:对话里用 <private> 标签包起来的内容不会入库。
五、我的看法
小型新项目上,感知不强,记忆还没积累起来活就干完了。但老项目、长周期项目上,这东西价值是爆炸性的。
我翻了两周前那个项目的记忆库,当时为什么否掉某个方案的完整理由都在,像翻自己写的开发日记。
上下文窗口会溢出,但一个 SQLite 文件不会忘。
它适合谁?Claude Code 重度用户;多项目来回横跳、天天给 AI 交底的人;想给自建 Agent 网关配持久记忆的玩家(它有专门的 OpenClaw 集成,一条 curl 命令装)。
License 是 Apache-2.0,官方的理由写得很直白:持久化的代理记忆应该能被轻松嵌进开发者工具、本地代理、MCP 服务器和企业系统。
项目地址:github.com/thedotmack/claude-mem,文档 docs.claude-mem.ai,官网 claude-mem.ai,仓库里还有官方中文 README。
回到开头那个问题。AI 编程助手的记性差,不是模型不行,是没人给它修一条记忆的路。
有人修好了,还免费。