ARTICLE · 1138817
每周AI工具|BootLoops 怎么用:哈佛教授 3 个月产出 36 篇论文,但他说 AI 不是科学家
AI工具 AI科研专家 — 用AI做科研的效率工具
可验证交付 · 协议约束 · 跨学科迁移 · 许可颗粒度
点击文末「阅读原文」直接使用
关注「AI-For-Precision-Health」 — 每天一篇AI科研实操干货
食品 · 医药 · 器械 · AI工具 · 科研Skill — 让AI真正帮你做科研。
让 AI 做科研,最容易出事的一步不是它算错,是它算对了、却给你一个错的结论——而且它会在你动手检查之前先宣布「完成了」。
我被这类回答坑过。去年冬天我让它帮我推一段抑制动力学的常微分方程解析解,它三步写完,符号干干净净。我照着往下用了两周,直到把参数代进去画图才发现量纲对不上——它在中间悄悄加过一个近似假设,从头到尾没提。算式每一步都对,它只是不知道自己那一句「于是可以近似为」意味着什么。
这类失败有个很准确的名字。10 月 1 日,哈佛大学理论物理学家 Matthew Schwartz 在 Anthropic 官方博客发了一篇客座文章,随后开源了配套的 BootLoops 1.0:一套让大模型做定量科学的工具包与工作协议[1][2]。他把人类想做的和 AI 擅长的之间的错位叫作「阻抗失配」(impedance mismatch)——两个系统各自都运转良好,接在一起却互相别扭,一边发出去的信息大部分到不了另一边[1]。
他给这件事下的定义比很多鼓吹 AI 科研的文章都冷静:「Claude 和 GPT 擅长科学,但它们不是科学家。」[1] 所以这篇要回答两个问题:BootLoops 到底能让 AI 真的产出可复核的科研结果吗?以及它的开放程度,够不够撑起一个课题组的日常使用?
59 个 官网工具箱索引列出的工具条目(2026-10-07 实测),另有 33 份手稿 PDF[2] | 36 篇 3 个月、18 个学科、19 位合作者,从约 400 个候选问题里筛出[1] | 20 分钟 模型复现作者原本花数周才写完的代码结果[1] |
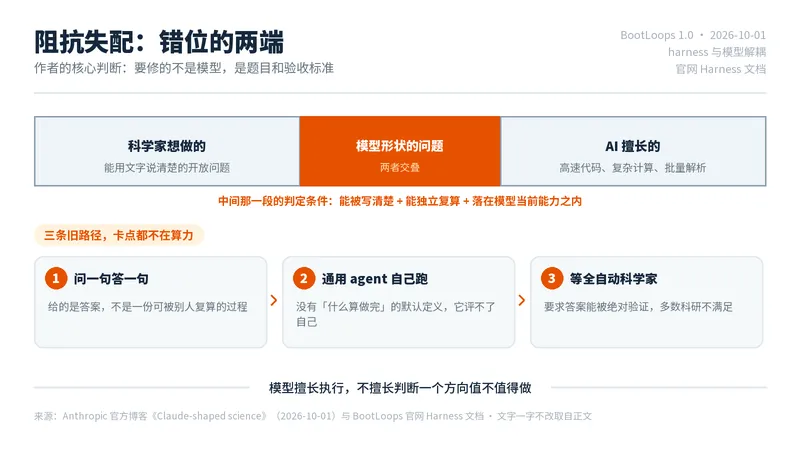
▲ 图1:「科学家想做的」与「AI 擅长的」之间的错位带 · 来源:依据 Anthropic 官方博文与 BootLoops 官网 Harness 文档绘制
本文核心要点
▸ 作者的核心判断是反常识的:瓶颈不在模型够不够强,在你给它的题目是不是「模型形状的」
▸ BootLoops 不是模型也不是编辑器,是 harness:一套工具目录 + 一套把「完成」定义死的验收协议
▸ 它的护城河是「可验证」:每个数值结果都能用独立脚本复算到任意精度,不靠你相信一个数字
▸ 许可要看颗粒度:代码 MIT、文档 CC BY 4.0,但版权归 Anthropic、非官方产品,内部还混着 GPL-3.0 与专有 freeware
▸ 最该抄的不是它的 59 个工具,是它那份失败清单——「done, with one asterisk」通常意味着根本没完成
创作来源说明:本文所有事实来自 BootLoops 官网(Harness 页、工具箱索引、手稿索引)、GitHub 仓库的 INSTALL.md / NOTICE / LICENSE 原文、Anthropic 官方博客的客座文章,以及 3 篇可解析的期刊与预印本文献(DOI 见文末)。⚠️ 我没有在 Linux 上完整跑通它的工具包自检,凡是未实机验证的步骤我都逐条标明了;工具名、命令与许可信息都可以在仓库和官网复查。
一、为什么本周值得打开它:AI 不是不会算,是它不知道什么算「做完」
本节结论:过去让 AI 做定量工作的三条路,卡点都不在算力也不在模型能力,而在「谁来判断这一步结束、结束得对不对」。BootLoops 真正的新东西不是工具数量,是它把判断标准写成了可以执行的协议。
先把这件事说透。过去几年让 AI 参与定量研究,主流是三条路,每一条都有一个绕不过去的断点。
路径一:把 AI 当计算器用,问一句答一句
这是最普遍的做法。你贴一个积分、一段推导、一份数据,它给你一个答案。问题在于它给的是「一个答案」,不是「一个可以被别人复算的过程」。我上面提到的量纲事故就出在这条路上——它当时的回答里没有任何一句话让你能发现那个隐藏假设。你信或不信,全靠运气。
路径二:给它通用 agent,让它自己写脚本自己跑
Claude Code、Codex 这一类工具确实能读写文件、跑命令、自己调试。能力没问题。卡点在别处:它没有「什么算做完」的默认定义。于是你会看到 Schwartz 记录下来的那种场面——它宣布「完成了,就差一个星号」,而那个星号往往是整件事本身[1]。它能算,但它自己评不了自己。
路径三:等一个「全自动科学家」
这条路的代表是「让 AI 端到端完成一项研究」的方案,学界已有专门的工作在推进[9]。方向有价值,但门槛也摆在那:它要求问题能被完整表述、答案能被绝对验证。数学满足,绝大多数科研不满足——你没法让模型替你判断一个生物学解释有没有意思。
Schwartz 的诊断很干脆:模型很聪明,但「像人类科学家那样工作」并不是它擅长的事。他在 2025 年 10 月那次实验里就感觉到,前一代模型「像一个很强的研究生,但快 20 倍」,代价是他要逐句纠正、把它从无关支线和死胡同里拽回来[1]。真正让他转向的,是不再指望把它改造成合作者,而是去找它本来就能做好的那类问题。
官方原文:「Physicists would call this an 'impedance mismatch': two systems that each work fine but are poorly matched, so most of what one puts in never gets through to the other. Here, the mismatch is between what scientists want and what AI does well.」[1]
翻译一下:物理学家管这叫「阻抗失配」——两个各自正常的系统匹配得很差,一边投入的东西大部分到不了另一边。这里失配的两端,是「科学家想做的」和「AI 做得好的」。这句话让我把整件事的位置重新摆了一遍:要修的不是模型,是题目和验收标准。
他给这类问题起了个名字,叫 「Claude-shaped problems」——能被写清楚、能被独立复算、且恰好落在模型能力里的任务。BootLoops 就是围着这个定义长出来的一套东西:一个把散落在不同语言、不同论文里的计算工具收进同一框架的 harness,加上一套规定「什么算做完」的工作协议[1][2]。
热点证据卡(都可自行复查)
▸ Anthropic 官方博文发布日 2026-10-01,作者为哈佛理论物理学家 Matthew Schwartz[1]。
▸ GitHub 仓库 BootLoops-ai/bootloops,创建时间 2026-10-01T15:29:28Z,最近推送 2026-10-05,许可 MIT,主语言 Python[3]。
▸ 官方 NOTICE 第一行写明:Copyright (c) 2026 Anthropic, PBC;紧接着一句「This is not an officially supported Anthropic product」[4]。
▸ 官网工具箱索引列出 59 个工具条目(另有 33 份手稿 PDF 可下载)[2][5]。
▸ 与它并列的还有协议仓库 BootLoops-ai/skills,同样创建于 2026-10-01,许可 MIT[6]。
科研人为什么该关注它?因为它的输出形态正好是科研最看重的那一种:不是一段好看的文字,是一个能被别人独立复算到 30 位小数的数[2]。它的验收标准写得很硬——一个积分只有在你知道它的完整函数形式、并且能用一段脚本在笔记本上把它算到任意精度的时候,才算被解决[2][1]。
二、它到底替你做哪类科研任务:把「一次回答」变成「一条可复算的流水线」
本节结论:BootLoops 卖的不是工具数量,而是「同一套工具 + 同一套验收标准,换一个模型也照样能跑」。它最值钱的部分是协议层,工具只是让协议有东西可管。
一句话定位:它是一套为定量科学准备的 LLM harness——由工具包和一组纯 markdown 写的工作协议组成,协议与模型解耦,官方原话是「design independent of the language model driving it」,Claude、Gemini、ChatGPT 都能驱动[2][1]。
它由三块拼起来,这三块的分工比工具名单重要得多。
| 层 | 它管什么 |
| 工具包 | tools/(移植或新写的计算包)、upgrades/(自研引擎源码)、toolkit/external/(外部引擎清单,逐项标注许可与获取方式)。官方说没有安装器——克隆就是安装[7]。 |
| 协议层 | skills,是可读的 markdown 指令文件,走 Agent Skills 开放标准,Claude Code / Codex / Copilot / Cursor 都能读。七个基础协议加五个重型协议,在所有安装路径上默认都是不激活的[2][6][8]。 |
| 验证基底 |
协议层里最值得单独拿出来说的是 acceptance-gate(验收门):它把「完成」定义成三件事——独立路径复现、双精度下稳定、有阳性对照[2]。这三句话如果你在实验室待过,会发现它其实是一份很标准的实验规范,只是被搬到了代码上。另外六个基础协议分别是常数识别纪律、植入真值、独立性记账、时间纪律、阅读契约和工具托管[2]。
我想请你留意其中两个,因为它们对科研场景特别对症。「植入真值」要求每条流水线先把一个已知答案跑通,并且故意喂坏输入看它能不能抓住——这就是阴性对照。「时间纪律」要求大计算之前先小规模测时,超过数小时就得找更聪明的路——这正是 Schwartz 反复对模型说的那句「think smarter, not harder」[1][2]。
| 适合用它 | 不适合用它 |
它已经跑过的题目横跨的学科比你可能预期得宽。官网上除了高能物理和数学物理,还挂着卫生政策方向的两篇——联邦医保星级评级的统计问题、以及自适应临床试验设计;另有基因组学的单细胞 RNA 计数「转录爆发」、群体遗传学里自然选择作用于罕见突变的积分、以及人类基因组中基因转换的证据[2][5]。对做医药与器械方向的读者来说,后面这几项才是有参照价值的部分。
三、10 分钟跑出第一份结果:先把「两半」装齐
本节结论:BootLoops 分两半——工具包和协议技能。只装工具包,你得到一堆算得很快的脚本;只装协议,你得到一套没有工具可管的规矩。两半都装齐,才算真的装上。
四步全景(把两半装齐)
Step 1–2 装工具包:确认环境、克隆仓库、装核心依赖、跑一遍自带自检;Step 3 装协议:把 skills 挂进你的 agent;Step 4 让 agent 编目:先搞清楚手里有哪 59 件工具,再谈解决什么问题。
💻 先说清楚:下面 10 步全部是纯电脑操作——一台笔记本加上你已有的模型访问就够了,不需要任何实验室条件、不需要买任何设备[2]。真正卡人的不是硬件,是你愿不愿意按它的验收标准把结果复核一遍。
先说清一件事:下面 10 步是我按官方 INSTALL.md、Harness 文档、协议仓库结构与仓库元数据逐条核对整理的,不是我的实机运行日志——我的机器上没跑完整自检。每条命令都能在仓库里复查,涉及许可与平台的地方我都标了。
Step 1|先确认你的系统跑得动它
📥 输入:一台能开终端、能联网的机器(Linux 或 macOS 最省事);🤖 AI动作:让 agent 先跑 python3 --version 与 git --version,再确认 pip 可用;📤 输出:三行版本号,以及「够 / 不够」的判断;🔍 人审:自己看一眼——官方安装文档明确点出,macOS 自带的系统 Python 是 3.9 且什么都没装,直接用它每一条 import 都会失败[7];⚠️ 失败处理:不要用系统 Python 硬上,务必建虚拟环境(见 Step 2)。⚠️ 平台提示:仓库的操作包 ops/turnstile 在 macOS 上会明确报一个 SKIP,不是坏了,是设计如此[7]。
Step 2|克隆工具包并跑通自检
📥 输入:上一步的环境;🤖 AI动作:先 git clone https://github.com/BootLoops-ai/bootloops,再进目录建虚拟环境、装核心依赖,最后跑自检脚本——官方给的是 pip install mpmath sympy numpy python-flint pytest,随后 python3 run_selftests.py --par 8[7];📤 输出:一张自检表 + 一份 selftest_results.json;🔍 人审:重点看三类结果怎么读——PASS 是通过,FAIL 是真问题(退出码为 1),而 REFUSED (by design) 表示这个包需要你的数据或参考数据根目录,它拒绝跑是合同的一部分而不是坏掉[7];⚠️ 失败处理:缺哪个模块,自检日志会直接点名,用 pip 补装即可;Julia 组件包需要 Julia ≥ 1.11;abacus 额外要求 PARI/GP 的 gp 在 PATH 上[7]。别把 REFUSED 当成失败去硬修,那会把好好的 fail-closed 设计改成 fail-open。
Step 3|把协议挂进你的 agent(两半里的另一半)
📥 输入:已经在用的 agent(Claude Code / Codex / Cursor / Copilot 任一);🤖 AI动作:两条路选一条——① 克隆协议仓库后在其中打开 Claude Code,运行 /bootloops-setup 挑选要激活的技能;② 不克隆,直接在 Claude Code 里 /plugin marketplace add BootLoops-ai/skills,然后安装 bootloops-protocols(七项工作纪律)和(或)bootloops-research[2][7];📤 输出:agent 侧多出可调用的协议技能;🔍 人审:确认它真的被激活了——官方强调技能在所有路径上默认都是惰性的(inert),装完不等于生效[7];⚠️ 失败处理:Copilot 和 Cursor 不需要装包,会原生读取;网页版 Claude 与 ChatGPT 走 zip 上传自定义技能或工作区插件目录;其他 agent 可以直接把某个技能的 SKILL.md 指给它读,比如「读一下 acceptance-gate 这个技能,按它来验收我的结果」[2][7]。
Step 4|让 agent 先编目,再动手
📥 输入:克隆下来的 tools/ 目录;🤖 AI动作:不要上来就描述你的问题,先让它读一遍工具箱索引和各包的 GUIDE.md,列出一份「哪些工具与我的问题相关」的清单[2];📤 输出:一份带工具名的候选清单,而不是一段解题思路;🔍 人审:看它有没有把工具名和用途对上——这一步几乎零成本,因为工具跑起来很便宜,可以用免费模型先筛相关性[2];⚠️ 失败处理:如果它直接跳到「我用 numpy 手写一个」,把它拉回来。官方的工作方式里有一条叫工具托管(tool-stewardship):先查工具包,再考虑写代码;要改就打补丁,别急着 fork,并且为下一个 agent 留记录[2]。
四、核心功能照着用:让工具、协议和专家各就各位
本节结论:它的四个核心动作分别是——选工具、跑可复核样例、用协议压住常数识别、请真人当对抗性审稿人。四件事里,只有第一件是 AI 自己完成的。
Step 5|跑通一个自带的可复核样例
📥 输入:Step 2 装好的环境;🤖 AI动作:官方文档给的最小样例是跑一个 sunrise 积分的求值脚本,不带参数时它会重算结果并与随附的独立参考值比对;带参数时可以在指定动量点、指定精度下求值,例如 python3 files/sunrise/sunrise-evaluate.py --point=-3.5 --dps 40,意思是把该积分在 p²/m² = −3.5 处算到 40 位[2];📤 输出:一个高精度数值,以及它跟参考值的比对结果;🔍 人审:你要亲自看那个比对的差值,而不是看它说「吻合」——官方在博文里专门提醒过,要警惕「good agreement」这类定性说法[1];⚠️ 失败处理:两种可能——环境没装齐(回 Step 2 看日志),或者该包需要外部引擎(比如 Kira、AMFlow、FORM)而你没装。外部引擎清单在 toolkit/external/TOOLS.md 里逐项标了许可和获取方式[7]。
Step 6|用协议把「常数识别」压住
📥 输入:一个已经算到高精度但还没闭合形式的数值结果;🤖 AI动作:让 agent 按常数识别协议来——建候选环、给出高度上界、植入对照,并且明确规定「拒绝而不是发明」[2];📤 输出:要么一个被命名的常数组合,要么一句诚实的「不在我构建的这个环里」;🔍 人审:读懂那句否定的含义——官方明确说,常数识别给出零结果只意味着「不在所构建的环中」,不等于绝对排除[2],把它写成「不存在」是过度解读;⚠️ 失败处理:如果它直接给你一个漂亮的闭式解却没有候选环和对照,让它把过程摊开重做。这一步是这一整套方法里最容易被模型「美化」的地方。
Step 7|把结果拆成「独立可查」的几段
📥 输入:一份已经跑出来的中间结果;🤖 AI动作:按独立性记账协议,把每个参考值的来源逐条登记——不能自己认证自己;再按阅读契约,只断言记录支持的内容并附引用[2];📤 输出:一份带来源链的结果说明;🔍 人审:检查有没有「同一段代码既生产结果又验证结果」的循环;⚠️ 失败处理:这一步失败通常表现为链条断在某一环上——那就退回那一步单独复现,别在原地重跑整条流水线。
Step 8|请一个真人来当对抗性审稿人
📥 输入:Step 6–7 产出的结果与来源链;🤖 AI动作:BootLoops 提供了 referee-sim(对外发文前模拟评审)、lit-review(新颖性声明的文献审计)、ref-check(参考文献核验)、prose-lint(机器写作指纹检测)四个重型协议[2];📤 输出:一份模拟评审意见 + 一份文献审计结果;🔍 人审:这里必须换人。Schwartz 的判断是,在他自己领域里他能看出模型的结果「往往并不成立」,但到了别的领域他会不自觉地点头——几乎所有跨领域结果在专家介入之前都是「技术上正确、科学上不引人注目」[1];⚠️ 失败处理:如果只有你自己看,那就把「我不确定」明确写进结论。他自己的做法是永远要求看图,并且承认即便设了各种监控,自动检查依然不能信[1]。
五、完整实战:用它跑通一个可复核的科研小问题
本节结论:完整跑一次的价值不在于得到那个数,而在于你亲手走过一遍「定义完成 → 复算 → 拿给专家看 → 写成 SOP」的四段路,以后每一类问题都能套。
我挑一个跟你我专业都不远的例子:用公开的人类变异数据集,估一个群体遗传学里长期只能近似处理的量。选它的理由很实际——官方已经在这个方向上把路走通过一次:他们用工具包解出了一个关于自然选择如何作用于罕见突变的、三十年没人算出闭式的积分表达式,然后把它应用到 gnomAD 这个目前最大的公开人类遗传变异目录上[1][2]。gnomAD 的核心论文是公开可查的[10]。
Step 9|把他人的路走第二遍,而不是另开一条
📥 输入:官方手稿索引里那篇群体遗传学手稿、对应的结果文件,以及公开数据集(gnomAD 或千人基因组[10][11]);🤖 AI动作:让 agent 先读手稿与工具包,把它已经跑通的四级流水线复现到一个更小的子集上——小规模先跑通是时间纪律的要求,不是为了省钱[2];📤 输出:一条在本机跑得起来的小流水线 + 一份与手稿表格的比对记录;🔍 人审:对照手稿里公开发表过的数字逐个核。Schwartz 团队在经济学那一篇里做的就是这件事——他们把 5 家期刊 4452 个复现包从 MATLAB、Stata 移植到开源代码(约 30000 个例程),并核对了几乎每一个能核对的数字,最终发现的差异比想象中多[1][12];⚠️ 失败处理:跑不出手稿的数,先分三类——数据版本不同(gnomAD 有多个版本,别串了)、参数约定不同、还是你的环境缺外部引擎。前两类是常事,第三类回 Step 2。⚠️ 我强调一句:这一步是「复现」,不是「发新结果」。小规模复现出来的数字离开你验证过的那一段范围,就什么都不是。
Step 10|把这套流程沉淀成课题组 SOP
📥 输入:Step 9 跑通的那组命令、提示词和判定阈值;🤖 AI动作:让 agent 把「数据版本锁定规则、复算容差、必须看图的清单、什么情况下停下来找人」写成一份固定说明,并在每次任务开始时先读它;📤 输出:一份可复用流程说明 + 一套固定命令;🔍 人审:让组里第一个人之外的另一个人按这份 SOP 独立跑一遍,结果不一致就说明 SOP 里还有隐含假设没写下来;⚠️ 失败处理:每次升级工具包之后都要重新加载协议技能——工具和协议的版本要对着走,否则命令与判定标准可能对不上。这一点官方在 INSTALL.md 里写得很清楚,技能在所有路径上都要显式激活[7]。
六、结果能不能直接用:验收清单与四条边界
本节结论:它的验收标准能保证「这个数可以被别人独立算出来」,保证不了「这个结论值得写进论文」。而后一条边界,官方自己写在 NOTICE 里,写得比大多数商业软件都直白。
| 判定 | 怎么算 |
下面是四条我建议你在动手前就记住的边界,前两条来自官方原文,后两条是我从它的许可结构里拆出来的。
边界一:它是一种研究仪器,不是产品。NOTICE 里那句「These are research instruments」后面紧跟着一句要求你自行验证输出[4]。同一个文件还写着「不是 Anthropic 官方支持的产品,由 Schwartz 维护」——这句话决定了你遇到问题时的求助对象是谁。
边界二:它承认自己写的东西不好。Harness 文档里有一句我很少在官方文档里看到的话:这里的论文几乎全部由 Claude 写成,而且写得不好。官方给的建议是让模型读了再讲给你听,别直接硬啃原文[2]。这份坦诚我给很高的评价,但它也意味着你不能把它们当综述引用。
边界三:许可要看到单个目录的颗粒度。仓库根是 MIT、文档与图是 CC BY 4.0,看起来非常干净。但 NOTICE 紧接着列了一长串例外:驱动它的三个引擎 fork 分别是 Kira(GPL-3.0-or-later)、Blade(MIT)、AMFlow.cpp(MIT),而 Kira 的构建链条里还会带出一个专有自由软件 Fermat;工具包里另有若干第三方组件各自带着 BSD-2-Clause、GPL-3.0-or-later、CC BY 4.0 等不同许可[4][7]。「仓库是 MIT」不等于「你能拿整棵树做任何事」——这句提醒在 10-01 那篇讲 Univer 的稿子里我说过一次,这次换了个方向又撞上了。
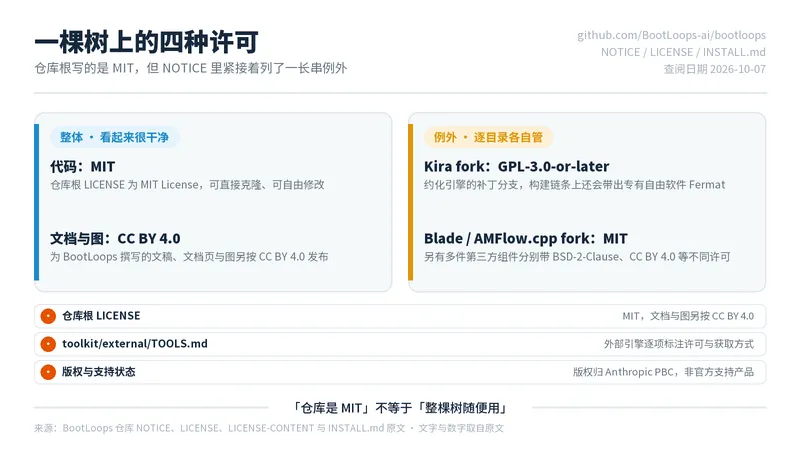
▲ 图2:BootLoops 一棵树上的四种许可 · 来源:依据仓库 NOTICE、LICENSE、LICENSE-CONTENT 与 INSTALL.md 原文绘制
边界四:它的成果归谁,比许可更值得想一层。NOTICE 第一行是 Anthropic 的版权声明,但同一份文件说明这是 Schwartz 创建、由 Claude 在其监督下编写、非官方产品。博文的作者自己在结尾处也把问题摊开了:他希望为「Claude-shaped science」里的人类争取应得的认可,并且提醒 AI 有可能把通常的商业逻辑反过来——过去是顶层拿走功劳、亲手做的人什么也没有;「假装人类的贡献只是打字」解决不了这个问题[1]。这句话对做课题的你比任何技术细节都重要。
七、到底值不值得长期用:优缺点、替代方案和最佳工作流
本节结论:值得投入时间学的不是它的工具,是它的方法;但现阶段它是一个「需要你自己扛着走」的项目,不是一个装完就能用的产品。
| 它的真优点 | 它的真麻烦 |
那如果你现在就需要一个能用的方案,替代路线其实很清楚,而且不冲突。
| 替代方案 | 它解决什么 | 它不解决什么 |
| 通用 agent 直接开跑 | ||
| 只抄协议,不装工具包 | ||
| 全自动科研框架 |
我建议的最佳工作流(也是成本最低的一条):只装协议 + 按需克隆工具包。先把 skills 仓库挂进你已经在用的 agent,让它在给你任何数值结果时都必须过一遍验收门;工具包先别全克隆,等你手上真的出现一个需要高精度求值的问题,再按 Step 2 装那一次。这样你今天就能拿到它 80% 的价值,却不用先啃完 59 个工具的文档。等它长到社区能互相对话的时候,再考虑把整棵树拉下来。
核心结论
▸ 结论1:这件事真正被重估的不是模型能力,是任务选择。作者给出的诊断是「阻抗失配」——模型擅长执行,不擅长判断一个方向值不值得做;所以正确的动作是去找「模型形状的」问题,而不是等模型变成科学家[1]。
▸ 结论2:BootLoops 的核心资产是协议层而不是工具层。七个基础协议加五个重型协议把「完成」定义成独立路径复现 + 双精度稳定 + 阳性对照;工具只是让这套规矩有东西可管[2]。
▸ 结论3:它最有价值的产出形态是「可被独立复算的数」。官方定的验收标准是一个积分必须函数形式完整、常数全部固定、并且能在从未参与拟合的点上以 30 位复现独立数值[2]——这个标准本身就值得抄进任何一份 AI 辅助计算的 SOP。
▸ 结论4:「开源 MIT 就能随便用」这个推论在这里不成立。代码 MIT、文档 CC BY 4.0,但驱动它的 Kira fork 是 GPL-3.0-or-later、构建链上带专有 freeware Fermat,工具包内还混着 BSD-2-Clause 与不同版本的 CC 许可;版权归 Anthropic PBC,却是「非官方支持产品」,且 NOTICE 明写不适用于临床与监管决策[3][4][7]。
▸ 行动:这周做三件事——① 把它那份失败清单抄进你自己的提示词(「done, with one asterisk 就是没完成」「警惕 good agreement 这类定性说法」「永远要求看图」),这三条我今天就能用上[1];② 挑一个你手上已有标准答案的小计算,按验收门的三条要求跑一遍,感受一次「被要求复算」和「被要求相信」的区别;③ 如果你在医药或器械方向,先去官网手稿索引看那两篇卫生政策与基因组学的手稿,判断它的方法能不能迁移到你的问题上[2][5],再决定要不要把工具包拉下来。
「过去我们争论 AI 能不能做科研,现在该换个问法了:它算完之后,谁能把它判成完成?如果答案还是你,那它省下的是计算,不是判断。」
综合评分(捞仔主观打分,10分制)
问题定位精准度:9.5(「阻抗失配」这个诊断比绝大多数 AI 科研文章都更接近真问题,而且它给出的解法是可执行的)| 方法完整度:9.0(工具包 + 协议层 + 验证基底三层分明,验收门与失败清单的颗粒度很少见)| 上手门槛:5.5(项目 2026-10-01 才创建,文档自陈写得不好,装齐要跨仓库、跨语言、还要按需接外部引擎)| 许可清晰度:8.5(NOTICE 逐目录列了例外,非常诚实;但正因如此,粗看容易误判成「整棵树 MIT」)| 科研场景匹配度:8.0(对可高精度校验的定量问题几乎量身定做,对湿实验驱动的课题帮助有限)
综合评分:8.1 / 10 —— 方法比工具更值得学;今天先抄协议,别急着搬工具包。
参考文献
[1] Schwartz M D. Claude-shaped science. Anthropic 官方博客客座文章,2026-10-01(含「impedance mismatch」「good at science, but they are not scientists」「done, with one asterisk」、36 篇 / 18 学科 / 19 位合作者 / 3 个月、失败模式与缓解措施等原文). https://www.anthropic.com/research/claude-shaped-science (访问日期 2026-10-07)
[2] BootLoops 官方网站. Harness 页(含「独立于驱动模型」「九个工具类别」「七个基础协议 + 五个重型协议」「验收门五步法」「30 位复现」「Install BootLoops」「论文几乎全部由 Claude 撰写且写得不好」等原文). https://bootloops.ai/harness.html (访问日期 2026-10-07)
[3] GitHub 仓库 BootLoops-ai/bootloops(元数据:创建 2026-10-01T15:29:28Z、最近推送 2026-10-05、许可 MIT、主语言 Python、描述含「certified computational tools and house engines」). https://github.com/BootLoops-ai/bootloops (访问日期 2026-10-07)
[4] BootLoops 仓库 NOTICE 文件原文(Copyright (c) 2026 Anthropic, PBC;Created by Matthew D. Schwartz, code written by Claude under his supervision;This is not an officially supported Anthropic product;research instruments;not intended or fit for clinical, actuarial, payment, regulatory or public-safety decisions;MIT + CC BY 4.0;第三方组件许可清单). https://github.com/BootLoops-ai/bootloops/blob/main/NOTICE (访问日期 2026-10-07)
[5] BootLoops 官网工具箱索引与手稿索引(工具箱索引 59 个条目;手稿索引含 Medicare star ratings、Phase II trial designs、Transcriptional bursting、Gene conversion in humans 等,页面共 33 份 PDF). https://bootloops.ai/tools/index.html ;https://bootloops.ai/papers.html (访问日期 2026-10-07)
[6] GitHub 仓库 BootLoops-ai/skills(协议技能仓库:创建 2026-10-01、许可 MIT;含 LICENSE、LICENSE-CONTENT、NOTICE 与 plugins/bootloops-protocols、plugins/bootloops-research). https://github.com/BootLoops-ai/skills (访问日期 2026-10-07)
[7] BootLoops 仓库 INSTALL.md 原文(克隆即安装;pip install mpmath sympy numpy python-flint pytest;run_selftests.py --par 8;PASS / REFUSED (by design) / FAIL 三类结果判读;Julia ≥ 1.11;abacus 需要 PARI/GP 的 gp;Kira fork 为 GPL-3.0-or-later、Blade fork 与 AMFlow.cpp fork 为 MIT、Fermat 为专有自由软件;macOS 系统 Python 为 3.9 的提醒;ops/turnstile 在 macOS 报 SKIP;技能默认 inert 且需显式激活). https://github.com/BootLoops-ai/bootloops/blob/main/INSTALL.md (访问日期 2026-10-07)
[8] Agent Skills 开放标准(BootLoops 协议技能遵循的格式标准,Claude Code / Codex / Copilot / Cursor 等可读). https://agentskills.io (访问日期 2026-10-07)
[9] Lu C, Lu C, Lange R T, Foerster J, Clune J, Ha D. The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery. arXiv preprint, 2024. DOI: 10.48550/arXiv.2408.06292
[10] Karczewski K J, et al. The mutational constraint spectrum quantified from variation in 141,456 humans. Nature, 2020, 581(7809): 434-443. DOI: 10.1038/s41586-020-2308-7
[11] The 1000 Genomes Project Consortium. A global reference for human genetic variation. Nature, 2015, 526(7571): 68-74. DOI: 10.1038/nature15393
[12] 相关经济学复现研究已作为 NBER 工作论文发布:An LLM Workflow That Reproduces, Improves, and Extends Published Economics Research. NBER Working Paper 35782,2026. https://www.nber.org/papers/w35782 (访问日期 2026-10-07)
[13] Etienne R S. A new sampling formula for neutral biodiversity. Ecology Letters, 2005, 8(3): 253-260. DOI: 10.1111/j.1461-0248.2004.00717.x