ARTICLE · 1142444
UGUI源码学习笔记_第五篇_Text篇
Text 组件:为什么首屏文字会卡一下,字体又是怎么变成网格的
Legacy Text 的公开 C# 路径不长:准备 TextGenerationSettings,交给 UnityEngine.TextGenerator,再把返回顶点提交给 VertexHelper。真正的字形光栅化、动态字体图集管理、换行和 BestFit 字号选择在 Unity 引擎原生层。读 com.unity.ugui@1.0.0 时必须守住这条边界:C# 能证明调用关系和失效范围,不能反推出原生内部算法。
先认人:Text 组件到底涉及哪些类(大纲)
动手看源码前,先把"出场人物"认全。Text 组件不是一个类单打独斗,而是 UGUI 表现层 + 引擎原生层 两层协作的结果。下面这张图先给全局,后面每节再逐个拆。
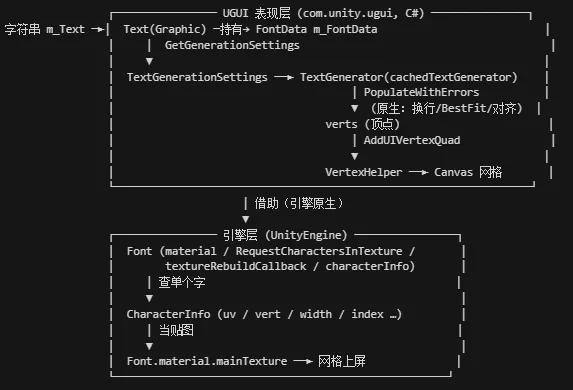
旁注:FontUpdateTracker 全局登记 Dictionary<Font, HashSet<Text>>, 监听 Font.textureRebuilt,图集一重建就拉"共用该 Font 的所有 Text"重来一遍。一、Text类大纲
1. UGUI 表现层(com.unity.ugui,C# 源码)
Text | Graphic,挂在 Canvas 下,负责"把文字变成网格"。持有 FontData m_FontData 和字符串 m_Text。 |
Graphic | TextSetVerticesDirty / SetLayoutDirty、color 等入口;Text 靠它进入重建流程。 |
FontData | font、fontSize、fontStyle、alignment、richText、horizontalOverflow、verticalOverflow、lineSpacing、resizeTextForBestFit / resizeTextMinSize / resizeTextMaxSize。 |
TextGenerator | Text 里叫 cachedTextGenerator)。吃 TextGenerationSettings,吐出 verts / lines / characters。换行、BestFit、对齐都在它(原生)里算。 |
TextGenerationSettings | Font、字号、样式、颜色、对齐、行距、Rich Text、BestFit、Overflow 等打包,传给生成器。 |
VertexHelper | AddUIVertexQuad 把每 4 个顶点塞进去,交给 Canvas 渲染。 |
FontUpdateTracker | Dictionary<Font, HashSet<Text>>,监听 Font.textureRebuilt,通知受影响的 Text 重建。 |
2. 引擎层
Font | material(纹理来源)、RequestCharactersInTexture(动态图集装字)、textureRebuildCallback(重建通知)、characterInfo / GetCharacterInfo / HasCharacter(字形查询)。 |
CharacterInfo | uv(图集位置)/ vert(网格矩形)/ width(步进)/ index / size / style / flipped。每个可见字符对应一份。 |
TextMeshGUIText | Text 共用同一套 Font / CharacterInfo / 图集。 |
3. 辅助枚举 / 数据类型
HorizontalWrapMode( Wrap/Overflow)、VerticalWrapMode(Truncate/Overflow):换行与溢出模式,原样传给生成器。FontStyle:Normal / Bold / Italic / BoldAndItalic。 TextAnchor/ TextAlignment:对齐方式。UIVertex:单个顶点(位置 + uv + 颜色 + 法线 + 切线),4 个组成一个 quad。 Rect: CharacterInfo.uv/vert用的矩形结构。
二、从改一个字到上屏的整条数据流向
先来速过一遍简要流程:
你改一个
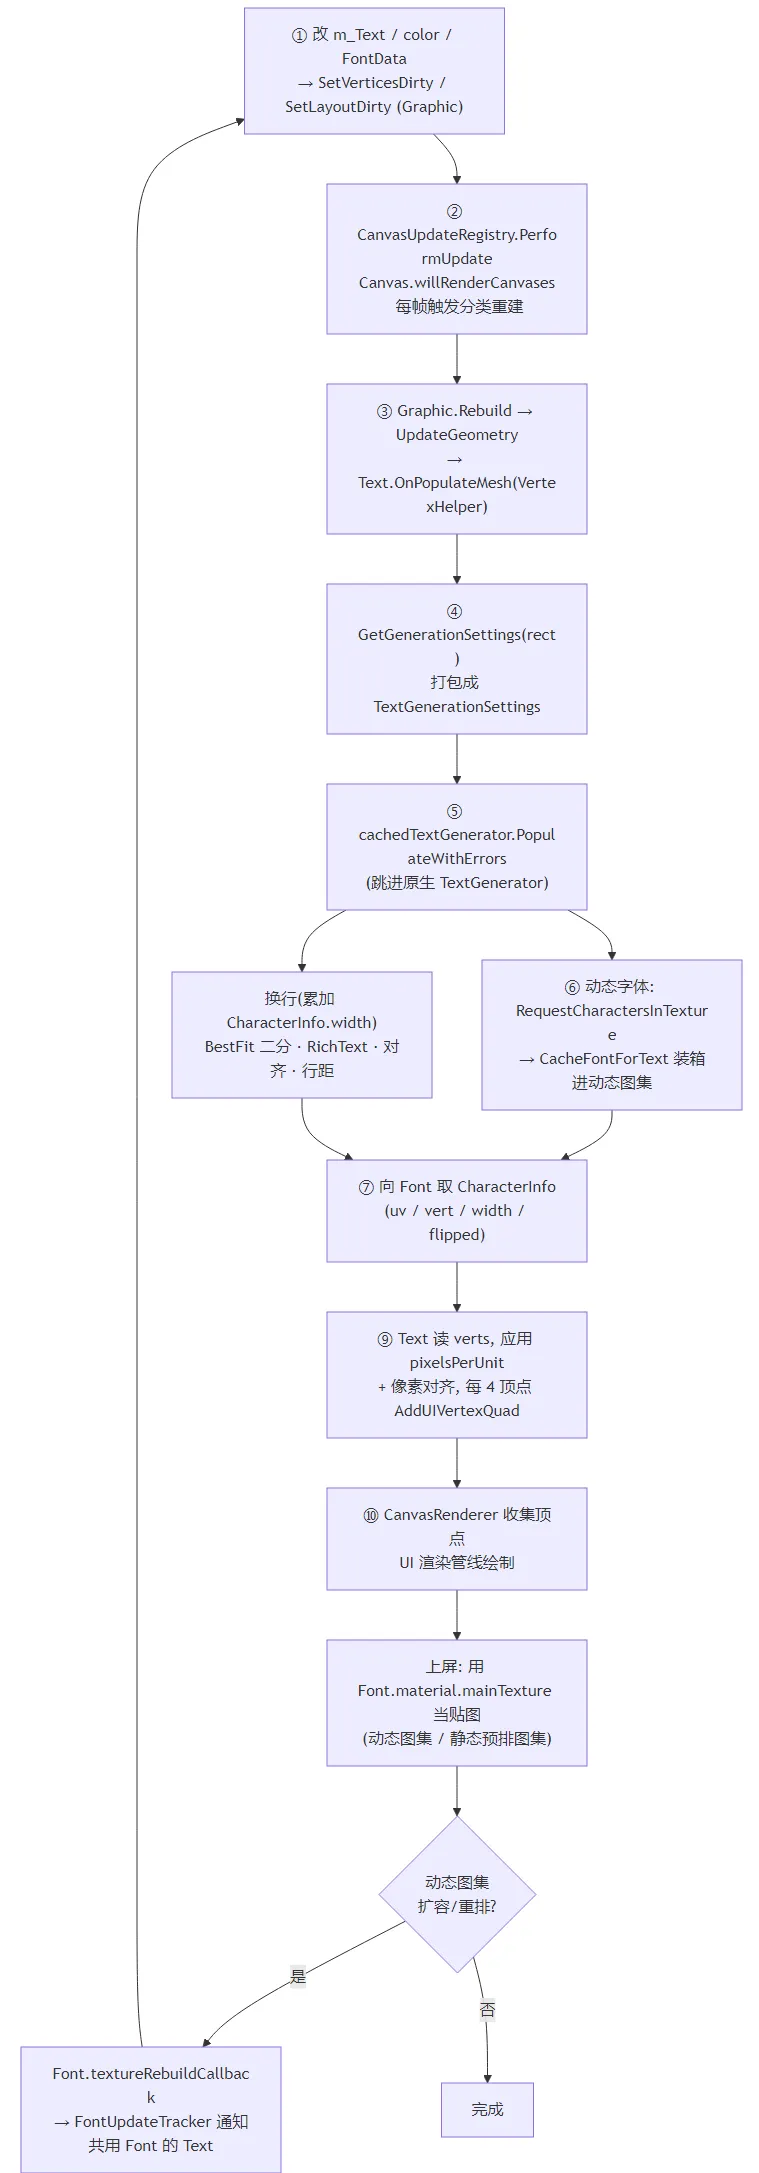
m_Text(或color、FontData任意一项)→Graphic打dirty标记→ 下一帧CanvasUpdateRegistry收网、触发Text.OnPopulateMesh→GetGenerationSettings把排版参数打包成TextGenerationSettings→TextGenerator.PopulateWithErrors跳进原生层,借助Font把字符光栅化进图集、按CharacterInfo.width断行、做 BestFit / 对齐 / 行距 → 返回verts→ Text 每 4 个顶点AddUIVertexQuad写进VertexHelper→CanvasRenderer收集→ UI 渲染管线用Font.material.mainTexture当贴图把 quad 画上屏。动态图集一旦重建,FontUpdateTracker还会拉所有共用该Font的Text重来一遍。
10 个阶段逐个拆
① 触发(Dirty)—— 纯 UGUI C# 层
Text 继承自Graphic。当你改了m_Text、color(没错,改颜色也会,因为Graphic.colorsetter 会调SetVerticesDirty)、或者FontData里任意一项,Text 会调用SetVerticesDirty()(几何变了)和/或SetLayoutDirty()(布局变了)。这两个方法只做一件事:把m_VertsDirty/m_LayoutDirty标记置true,并把当前Graphic登记进CanvasUpdateRegistry 的重建队列,等下一帧 Canvas 来收。
② 调度(Canvas 触发分类重建)—— 纯 UGUI C# 层
每帧 Canvas 在 willRenderCanvases 事件里调用 CanvasUpdateRegistry.PerformUpdate(),把"打过 dirty 标记"的 Graphic 分两批(m_LayoutRebuildQueue 布局重建、m_GraphicRebuildQueue 几何重建)取出来,依次跑 Rebuild(CanvasUpdate.PreRender)。Text 的重建就在这一步被真正触发。
③ 进 OnPopulateMesh(取框 + 入口)—— UGUI C# 层
Graphic.Rebuild → UpdateGeometry → 调用 Text 覆写的 OnPopulateMesh(VertexHelper toFill)。所有"文字变网格"的代码都在这里。
④ 打包 TextGenerationSettings —— UGUI C# 层
OnPopulateMesh 里先拿 rectTransform.rect.size 当可用文字框尺寸,再调 GetGenerationSettings(rect) 把 Font、字号、样式、对齐、行距、Rich Text、BestFit、Overflow 等全部打包成 TextGenerationSettings。同时设 m_DisableFontTextureRebuiltCallback = true,防止本轮生成里被字体纹理回调打断。
⑤ 交给 TextGenerator(真·生成,跳进原生层)—— 边界线
Text 调用 cachedTextGenerator.PopulateWithErrors(text, settings, gameObject)。到这里就跨过边界,进入原生 TextGenerator:
动态字体:先 RequestCharactersInTexture→CacheFontForText,把要用的字光栅化、装箱进动态图集;按 CharacterInfo.width累加判断断行(行宽来自设置);若开了 BestFit,二分搜索一个能塞进框的字号; 处理 Rich Text 标签、对齐、行距; 产出 verts(每字一组 quad 顶点)、lines、characters。
阶段 ⑤ 的"怎么断行、怎么二分、怎么装箱"是引擎原生行为,C# 参考源码证不了内部算法,只能证"Text 把请求交给了 TextGenerator"。
⑥ 装字进图集 —— 引擎原生层(动态字体专属)
对应上面 RequestCharactersInTexture。你告诉引擎"这几个字待会儿要用",引擎就把它们渲染进动态图集。静态字体不走这步,因为它导入时就预排好了。
⑦ 查字形 CharacterInfo —— 引擎原生层
TextGenerator 对每个需要显示的字符,向 Font 要一份 CharacterInfo:动态字体在阶段 ⑥ 装图集时一并拿到;静态字体查 characterInfo 数组 / GetCharacterInfo。这份说明书给三样东西:uv(图集里取哪块像素)、vert(网格里放在哪)、width(光标往右挪多远),外加 flipped 标记要不要翻转 UV。
⑧ 拼顶点回到 UGUI —— UGUI C# 层
PopulateWithErrors 返回后,Text 读 cachedTextGenerator.verts,应用 pixelsPerUnit 换算(动态/静态字体算法不同)和像素对齐偏移,然后每 4 个顶点调用一次 AddUIVertexQuad,把字符一个个写进 VertexHelper。随后复位 m_DisableFontTextureRebuiltCallback = false。
⑨ 收顶点进 Canvas 网格 —— UGUI C# 层
VertexHelper 里攒好的顶点数据,最终被 CanvasRenderer 收集,交给 UI 渲染管线。这一步 Graphic 的 vertexHelper 被填充、由 Canvas 合并成一批绘制调用。
⑩ 上屏(材质 + 图集)—— 引擎原生层提供贴图
渲染用的贴图就是 Font.material.mainTexture——动态字体是那张运行时动态图集,静态字体是导入时预排好的图集;材质本身(Font.material)没指定就回退内置 Font.mat。这样,字形像素被"贴"到阶段 ⑧ 围出的 quad 上,字就显形了。
联动 · 动态图集重建 —— UGUI C# 监听 + 引擎原生抛事件
如果阶段 ⑥ 把新字塞进动态图集导致图集扩容/重排,引擎抛 Font.textureRebuildCallback 事件;C# 层的 FontUpdateTracker 接住它,通知所有共用该 Font 的 Text 重新 FontTextureChanged → 打 dirty → 回到阶段 ①。静态字体不触发这条链。
一张图看完整流水线
阶段 ↔ 类 ↔ 层 对照表
Graphic | SetVerticesDirtySetLayoutDirty | ||
CanvasUpdateRegistry | willRenderCanvasesPerformUpdate | ||
Text | OnPopulateMesh(VertexHelper) | ||
Text | GetGenerationSettingsTextGenerationSettings | ||
TextGenerator | PopulateWithErrors | ||
Font | RequestCharactersInTextureCacheFontForText | ||
FontCharacterInfo | characterInfoGetCharacterInfo / width | ||
Text | verts → AddUIVertexQuad | ||
CanvasRenderer | |||
Font.material | mainTexture | ||
FontUpdateTracker | Font.textureRebuilt |
代码边界:
- C# 层(UGUI)能证
:类与类的调用关系、谁持有谁、哪个事件触发谁。 - 原生层(引擎)才做
:字形光栅化、动态图集装箱、换行策略、BestFit 字号搜索。
记住这条分水岭:①④、⑧⑨、联动 都是 UGUI 的 C# 调用关系,源码(
com.unity.ugui);⑤~⑦、⑩ 才真正落到引擎原生层——其中"怎么断行、怎么二分、怎么装箱"是原生内部算法,本系列参考源码证不了,只能证"调用了谁"。
三、读源码时萌生的疑问和解答
Text 持有什么,纹理从哪里来
Text 持有 FontData m_FontData 和字符串 m_Text。渲染纹理优先取 font.material.mainTexture;源码里没有名为 FontTexture 的字段或类型。
Legacy Text 既支持动态 Font,也保留非动态 Font 的处理。pixelsPerUnit 就明确区分了两者:动态字体按 Canvas scaleFactor 处理,非动态字体按 Font 自身字号与 Text 请求字号的比例换算。因此,“看到字符才塞进动态图集”只能用于动态 Font,不能概括全部 Legacy Text。
这一版 Text.OnPopulateMesh 也没有显式调用 Font.RequestCharactersInTexture。真实入口是:
// 逻辑示意:调用顺序对应 com.unity.ugui@1.0.0if (font == null)return;m_DisableFontTextureRebuiltCallback = true;var settings = GetGenerationSettings(rectTransform.rect.size);cachedTextGenerator.PopulateWithErrors(text, settings, gameObject);var verts = cachedTextGenerator.verts;// 每 4 个顶点通过 AddUIVertexQuad 写入 VertexHelperm_DisableFontTextureRebuiltCallback = false;动态字形请求、纹理装箱和必要的字体纹理更新发生在 TextGenerator/Font 的引擎实现中,不在这个 UGUI 包里。图集尺寸、何时扩容或重排、采用什么装箱策略,都不能只靠这里的 C# 源码下结论。
字体纹理重建为什么会牵连多个 Text
C# 层能确认的是重建通知链。FontUpdateTracker 维护 Dictionary<Font, HashSet<Text>>,统一监听全局 Font.textureRebuilt。收到某个 Font 的事件后,它只遍历使用该 Font 的 Text,调用 FontTextureChanged()。
FontTextureChanged() 会先让 cachedTextGenerator 失效。如果当前正在 Graphic 或 Layout rebuild 中,就直接 UpdateGeometry();否则调用 SetAllDirty(),等待后续重建。也就是说,一个字体纹理变化,确实可能让所有共享该 Font 的活动 Text 更新网格,但不会无差别重建其他字体的文本。
m_DisableFontTextureRebuiltCallback 的作用也很具体:当前 Text 正在 PopulateWithErrors 时,忽略它收到的字体纹理重建回调,避免在同一轮生成中重复进入更新;生成结束后再恢复。
首屏或列表滚动卡顿可以把动态字体更新列入排查项,但不能直接断言“必然是图集满,也不是顶点数”。TextGenerator、Layout、网格重建和 Canvas rebuild 都可能占用 CPU。工程上应在目标 Unity 版本中用 Profiler 确认热点;预热字符是否有效,也要结合字体、字符集和实际引擎行为验证。
TextGenerator 返回什么,Text 怎样提交网格
GetGenerationSettings 把框尺寸、Font、字号、样式、颜色、对齐、行距、Rich Text、BestFit、Horizontal/Vertical Overflow 等参数组装成 TextGenerationSettings。PopulateWithErrors 返回后,Text 读取 cachedTextGenerator.verts,应用 pixelsPerUnit、像素对齐偏移,再每 4 个顶点调用一次 AddUIVertexQuad。
所以源码能准确表述为:TextGenerator 返回按 quad 排列的顶点,Text 每 4 个顶点提交一个 quad。不能反过来断言“输入中的每个字符必然对应一个 quad”;富文本标签、换行符和其他不可见控制字符是否产出几何体,由 TextGenerator 决定。
cachedTextGenerator 会缓存生成结果,但是否复用由 TextGenerator 根据文本和设置判断。颜色也不是零成本属性:Graphic.color setter 会调用 SetVerticesDirty(),而颜色会写入 TextGenerationSettings.color,下一次 Graphic rebuild 仍会进入 OnPopulateMesh。颜色变化通常不要求重算 Layout,但会重建含新顶点色的文字网格。
Rich Text 同样在 TextGenerator 生成阶段处理。C# 层只负责把 m_FontData.richText 传入设置;它不是 Shader 阶段临时解释标签。具体支持哪些标签及标签如何影响字形,属于 TextGenerator 的版本行为。
Font 到底是什么,纹理为什么来自 font.material
1. Font.material 的来源:没指定就用内置 Font.mat
Font 类把 material 暴露成属性(Graphics.txt 的 AUTO_PTR_PROP Material material)。它的 getter 实现做了两件事:
Material* material = self->GetMaterial();if (material == NULL) material = GetBuiltinResource<Material>("Font.mat"); // 没指定就回退内置材质Material* instantiated = &Material::GetInstantiatedMaterial(material, *self, false); // 取一个实例副本if (material != instantiated) self->SetMaterial(instantiated);return Scripting::ScriptingWrapperFor(instantiated);简言之:你给 Font 挂了材质就用你的;没挂,引擎就掏出一套内置的 Font.mat 来画字,并且会自动给你生成一个"实例副本"(这样改一个 Font 的材质不会污染别处)。这正是 UGUI Text 里"纹理优先取 font.material.mainTexture"能成立的根。注意源码里没有叫 FontTexture 的字段——纹理是"材质上那张贴图",不是 Font 自己单独存的一张图。
2. 动态字体 vs 静态字体:这是两条完全不同的路
引擎层把这两种字体分得清清楚楚:
- 动态字体(dynamic)
:运行时从 TTF / 系统字体按需把字符"画"进一张图集。相关 API 都标注了"dynamic fonts only"。 - 静态字体(imported font asset)
:导入时就按你指定的字符集把字形预先排进图集,运行时只读不画。
这一点和 UGUI 那句"pixelsPerUnit 区分动态/非动态字体"完全对得上。"看到字符才塞进图集"只适用于动态字体,静态字体在导入时就全排好了。
3. 动态图集怎么"长"出来:RequestCharactersInTexture
引擎层有个专门给动态字体用的入口:
// Request characters to be added to the font texture (dynamic fonts only).CUSTOM voidRequestCharactersInTexture(string characters, int size = 0, FontStyle style = FontStyle.Normal){UTF16String str(characters.AsUTF8().c_str()); self->CacheFontForText(str.text, str.length, size, style); // 真正把字符光栅化、装进图集}白话:你告诉引擎"这几个字我待会儿要用",引擎就把它们渲染进动态图集。注意它有三个参数:characters(要哪些字)、size(字号,0=默认)、style(粗体/斜体)。这就是"首屏前预热字符"在引擎层的真实入口——只不过 UGUI 的 Text 不是在 C# 的 OnPopulateMesh 里直接调它,而是把请求交给 TextGenerator 的原生实现去驱动(所以 UGUI 那份 C# 里看不到显式调用,是合理的)。
4. 图集重建时谁会收到通知:textureRebuildCallback
动态图集扩容/重排后,引擎会通知监听者:
// Callback delegate for use with ::ref::textureRebuildCallback.CSRAW publicdelegatevoidFontTextureRebuildCallback();CSRAW privateevent FontTextureRebuildCallback m_FontTextureRebuildCallback = null;// A delegate which gets called when the font texture is rebuilt (dynamic fonts only).CSRAW public FontTextureRebuildCallback textureRebuildCallback { get { ... } set { ... } }简言之:动态字体的图集一旦重建,就会触发这个回调,而且同样标注"dynamic fonts only"。 这正好解释了 UGUI 第02节里 FontUpdateTracker 监听 Font.textureRebuilt、进而让所有共用该 Font 的 Text 一起 FontTextureChanged 的来龙去脉——FontUpdateTracker 不过是在 C# 层接住了引擎抛出的这个事件。静态字体不走这条路,因为它导入时就排好了,不会运行时重建。
5. 静态字体怎么查字形:characterInfo 数组 + GetCharacterInfo
静态字体的图集是预先排好的,引擎把每个字符的信息直接给你查:
characterInfo属性 :返回"图集里所有字符的 CharacterInfo数组"。导入时排好,运行时整包可读。GetCharacterInfo(char ch, out CharacterInfo info, int size=0, FontStyle style=Normal):查单个字符。它的内部逻辑是——先 HasCharacterInTexture确认图集里有这个字,再GetCharacterRenderInfo取出vert、uv、flipped,再用GetCharacterWidth取出width。
if (self->HasCharacterInTexture(ch, size, style)){ info.index = ch; info.size = size; info.style = style; self->GetCharacterRenderInfo(ch, size, style, info.vert, info.uv, info.flipped); info.width = self->GetCharacterWidth(ch, size, style);returntrue;}returnfalse; // 图集里没有这个字6. 缺字会变成"豆腐块":HasCharacter
Font.HasCharacter(char c)就是问"这个字体里到底有没有这个字符"。如果用了一个字体没有的字符(比如中文用了纯英文 Font,或生僻字不在子集里),图集里查不到,GetCharacterInfo 返回 false,画出来就是空框/方块(俗称 tofu □)。排字库时要确认字符集覆盖,根子就在这。
一个字符是怎么变成网格上的一个 quad 的
前面说"TextGenerator 返回顶点,Text 每 4 个顶点提交一个 quad"。那这 4 个顶点和贴图上的像素,到底是怎么对上的?引擎层的 CharacterInfo 把这件事讲透了。
CharacterInfo 全字段表
CharacterInfo 是引擎给"一个字符"准备的几何说明书:
index | ||
uv | 字符在字体图集贴图里的位置 | |
vert | 字符在生成出来的文字网格里的屏幕坐标矩形 | |
width | 从前一个字符开头到这一个字符开头要走多远 | |
size | ||
style | ||
flipped |
一张图看懂"字 → quad"
把"一个字符怎么变成屏幕上的方块"拆成三步:在图集里圈一块像素(uv)→ 在网格上围一个 quad(vert)→ 按 width 把光标挪到下一个字。
字体图集贴图 (atlas texture) ┌────────────────────────────┐ │ ┌──────────────────┐ │ │ │ A │ │ ← uv:这只字在图集里的矩形 │ └──────────────────┘ │ └─────────────────┬──────────┘ │ ① uv 采样这块像素 ▼ 文字网格上的 quad ┌────────────────────────────┐ │ ┌──────────────────┐ │ │ │ A │ │ ← vert:这只字在屏幕上的矩形 │ └────────┬─────────┘ │ └────────────┼───────────────┘ │ └──► ② width(advance):光标右移,放下一个字白话翻译:
- uv(取哪块像素)
:告诉你这只字在那张大图集贴图的哪个矩形角落,渲染时从这个矩形里采样字形像素。 - vert(画在哪)
:告诉你这只字在最终文字网格的哪个矩形位置、占多大,它决定 4 个顶点围出的 quad 画在屏幕哪儿。 - 采样 + 贴图
:引擎把 uv 矩形里的像素,贴到 vert 围出的 quad 上,一个字就"显形"了。 - width(往哪走)
:放完一个字,光标按 width 往右挪,再去放下一个字。
所以"每个字符对应一个 quad"这句话在引擎层是成立的:TextGenerator(原生)对每个需要显示的字符,都会产出一组 CharacterInfo,UGUI 的 Text 再按 vert 写 4 个顶点、按 uv 写贴图坐标。富文本标签、换行符这类"不可见字符"不会产出几何体,因为它们在生成阶段就被处理掉了,没有对应的可见 CharacterInfo。
width(advance)是换行与对齐的计量尺
width 的注释是"How far to advance between the beginning of this character and the next"——从本字符开头到下一个字符开头的距离。它是:
- 对齐
的基准:一行字总宽 = 各字符 width之和,居中/右对齐就是拿这个总和去算偏移。 - 换行
能够成立的根本原因:文本生成时累加每个字符的 width,一旦超过给定的行宽(HorizontalWrapMode.Wrap),就在当前位置断行。我们前面说"换行到底用贪心还是别的策略、CJK 标点禁则怎么处理"是原生行为——但"能用width累加计量从而判断该不该断行"这件事,引擎层用CharacterInfo.width给你坐实了。
小提醒:
width只是"步进距离",它不包含字距微调(kerning)这类更细的偏移。想做精致排版时,这部分细节要另外处理,不能只指望width。
flipped 这个字段为什么存在
有些平台/图集会把字形上下颠倒存放(贴图坐标系差异)。flipped = true 就是告诉渲染端:"这只字在图集里是倒着的,贴的时候把 UV 翻转一下"。平时你不用管它,但当你自己写自定义文字渲染、手动拼顶点时,漏掉 flipped 就会看到倒字——这是个很隐蔽的坑。
TextMesh / GUIText 也是这套机制的使用者
"Font / CharacterInfo / 动态图集这套,是不是只有 UGUI 的 Text 在用?" 不是。引擎层自带的 TextMesh(3D 文字)和 GUIText(老式屏幕文字)都共用同一套 Font 和 CharacterInfo。
TextMesh 暴露的属性就是最好的证据:text、font、fontSize、fontStyle、alignment、anchor、characterSize、lineSpacing、tabSize、richText、color…… 它和 UGUI Text 的 FontData 字段几乎一一对应。也就是说,无论是 3D 场景里的 TextMesh,还是 UGUI 的 Text,底层都是"Font 提供图集 + CharacterInfo 提供每字几何 + 一堆排版参数",区别只是谁去驱动 TextGenerator、最终网格交给哪个渲染管线。
换行与 Overflow:源码能确认到哪一步
HorizontalWrapMode 和 VerticalWrapMode 都被原样传给 TextGenerator:
Horizontal Wrap:要求生成器在给定宽度内换行;Horizontal Overflow:允许文本超过水平边界;Vertical Truncate:限制超出高度的可见内容;Vertical Overflow:允许文本超过垂直边界。
到这里为止是 UGUI C# 源码可证的范围。具体使用贪心还是其他策略、英文在空格或连字符处怎样回退、CJK 标点禁则、无空格长串如何断开,都位于 UnityEngine.TextGenerator 原生实现中。没有对应版本的引擎源码、官方说明或实测,不能把某套 Unicode 换行规则写成 com.unity.ugui@1.0.0 的源码事实。
同样,Vertical Truncate 的最终顶点裁减方式也由 TextGenerator 决定。布局尺寸则使用独立的 cachedTextGeneratorForLayout:preferredWidth 调 GetPreferredWidth,preferredHeight 调 GetPreferredHeight。因此遇到“布局高度和实际显示不一致”,应同时检查生成设置、Rect 宽度、Overflow 和布局生成器结果,不能统一归因成“Layout 拿理想值、渲染直接吞整行”。
BestFit:知道边界比猜算法更重要
开启 BestFit 后,Text 将 resizeTextForBestFit、resizeTextMinSize、resizeTextMaxSize 交给 TextGenerator。UGUI C# 每次网格生成只调用一次 PopulateWithErrors;字号搜索发生在原生层。
因此,这份源码不能证明内部一定使用二分搜索,也不能证明会调用若干次 Populate,更不能给出“高一个数量级”的固定倍率。实战上,BestFit 增加排版工作是合理的性能风险,尤其要谨慎用于高频更新的长文本和滚动列表,但是否构成瓶颈仍应由 Profiler 数据决定。
BestFit 里“塞进框”到底塞的是什么
回到阶段 ⑤ 那句“二分搜索一个能塞进框的字号”,字面上容易误会成“把字号塞进框”。其实字号是“被搜索的变量”,不是“被塞的对象”;“能塞进框的字号”准确说是“让文字能塞进框的那个字号”。真正被“塞”的,是按某个候选字号把整段文字排好版之后得到的几何结果——包括换行后的每一行宽度、总行数、以及堆叠出来的总高度。
约束来自文字框(rect)的两个方向:
- 水平方向
:当前字号下,文字按 CharacterInfo.width累加换行,每一行都不能超过框宽(HorizontalWrap时;Overflow则允许超出)。 - 垂直方向
:排完所有行后的总高度不能超过框高( VerticalTruncate时会裁掉超出部分;Overflow允许超出)。
只有当“排出来的结果两个方向都落在框内”,这个候选字号才算“塞得进框”。BestFit 要找的,就是满足这个约束的最大字号——字号越大越难塞进,所以才适合用“每次试中间值、排除一半范围”的方式快速逼近(即阶段 ⑤ 口中的“二分”,但这只是算法示例,见上一段边界说明)。
所以“塞进框”的作用可以一句话概括:BestFit 是在“框大小固定”的前提下,自动挑一个尽量大、又不撑破框的字号,用来避免文字太小难看、或太大被截断 / 溢出。它不是把框撑大,也不是删字,纯粹是调字号。
为什么要“搜索”字号,而不是直接算
“找出能塞进框的最大字号”,那为什么不直接用公式算出来,非得一个一个去试(搜索)?
核心原因是:“某个字号能不能塞进框”这件事,没有一个反解公式,只能真的排一遍才知道。
没有闭式解,只能试。 给定固定框和候选字号
s,判断“放得下吗”必须走一遍真实排版:按CharacterInfo.width逐字累加、在框宽处断行、数出行数、再乘行距累加出总高,两个方向都 ≤ 框才算过。这是逐字的离散过程,不是(框宽, 框高, 字数) → 字号的一行公式能反推出来的。换句话说,“最大能放下的字号”不存在现成解析式,只能去“试”一个值、看它过不过。我们要的是“最大的那个”,不是“随便一个”。 如果只要“放得下”,那直接取
Min Size就完事了——但那样字会小到难看。BestFit 的诉求是“在不撑破框的前提下,尽量大”。所以目标不是求一个存在性解,而是逼近约束的上边界:找到那个“再大一号就放不下”的临界字号。正因为“越大越难放下”,搜索才有捷径。 在固定文本和框的前提下,字号和“能否塞进”之间近似一个单调开关:小于某个临界值都放得下,大于它就放不下(前面的“塞进框”小节已经点过这个性质)。这种“最后一个满足条件的值”正是二分搜索的经典目标——每次试中间值,放得下就往大找、放不下就往小找,每轮把搜索范围砍掉一半,很快就能逼到边界。这就是阶段 ⑤ 那句“二分搜索”在概念上成立的原因(但再次提醒:原生层是否真的二分仍是黑盒,见下)。
因此:因为“能不能放下”没有反解公式、只能实际排版判定,而我们又要的是“能放下的最大字号”这个边界值,所以只能靠搜索去逼近——又因为它本质是单调的临界问题,二分才成为最顺手的搜索方式。
单字成行与标点禁则:项目侧支持与优化
换行是原生 TextGenerator 按 CharacterInfo.width 累加判断的,它只关心“这一行还能不能塞下下一个字”,不认识任何排版禁则。所以下面这类问题原生 Text 天然会出,必须靠项目侧补:
1. 为什么要解决“单字成行”
版署审核需要。
2. 什么是“单字成行”,为什么原生会出
“单字成行”泛指换行后某一行只剩一个(或极少)字符孤零零待着,最典型两种:
- 行首标点(行首禁字)
:一行开头是逗号、句号、右引号、右括号这类“不该在行首”的标点。中文排版里它们应跟在前一字后面,不能甩到下一行开头。 - 孤字 / 短行
:一段文字最后一行只落下一个字,或某行被挤得只剩一个字。视觉上很空,像排版漏了一块。
原生只会问“塞不塞得下”,不认“标点能不能在行首”“这一行至少要有几个字”。所以单字成行、行首标点是原生 Text 默认就会发生的,不是你哪里配错了。
3. 原生 Text 对单字成行的支持:几乎没有,得自己补
Legacy Text 的原生 TextGenerator对“单字成行”没有任何专门支持。它唯一的换行逻辑就是前面反复说的——按 CharacterInfo.width 累加,当前行放不下下一个字就在那儿断。至于“断点前一个字是不是标点”“这一行只剩一个字好不好看”,原生根本不关心。
具体说,原生层面没有这些东西:
- 行首禁则
:不会阻止逗号、句号、右引号、右括号落到行首。 - 孤字 / 短行控制(widow/orphan)
:不会保证“最后一行至少 N 个字”。 - CJK 标点避头尾 / 挤压
:标点是否避头尾、前后是否压缩,都是原生黑盒,不能指望它把标点推回上一行。 - 最小字数 / 均衡行
:没有“让每行字数更均衡”的概念。
所以看到单字成行、行首标点,不是你 FontData 或 Overflow 配错了,而是原生 Text 的默认行为。这要和“文本被截断”分开看(截断是框太小 / Truncate 裁掉,见第 392 行附近):截断是空间不够,单字成行是换行点没优化。
4. 如何应对:三条路线
路线 A:项目侧文本后处理(本文项目用的就是这条)代表实现就是下面的 TextPunctuationUtils:先让原生排一遍拿行信息,再在文本里插 \n 把违规换行点往前挪,反复修到合规。优点是不改 UGUI、对现有 Legacy Text 侵入小、规则可配置;代价是每次都要重排(见第 6 节优化点)。这是“不想换字体管线、又想修排版”时的性价比之选。
路线 B:迁移到 TextMeshProTMP 的换行 / 分词更完整,CJK 也有更细的换行配置,长期看更省心。但注意两点:一是本篇已多次强调不能把 TMP 的 SDF / 动态 Atlas / 换行实现套到 Legacy Text 上,两者是两套管线;二是 TMP 对中文避头尾、最小字数同样要你配置或写规则,不是开箱即“完美中文排版”。属于“长期大改”路线。
路线 C:内容 / 作者侧约束在内容生产阶段就规避:手动换行、插入零宽空格(\u200B)当可控断点、限制单条文本长度、用 ContentSizeFitter 让框跟着文字撑大而不是固定框挤文字。这条治标不治本——只适合少量、可控的静态文案,动态或多语言文本撑不住。
取舍:A 改造成本低、见效快,适合先把现有 Legacy 项目的排版救起来;B 是长远方案但要整体迁移;C 只能兜底少量静态文本。
5. 项目侧个人推荐怎么做:
思路不是改原生换行,而是 先用原生 TextGenerator 排一遍拿行信息,再扫描每行行首,发现违规就把换行点往前挪、插入 \n,然后重排,直到没有违规或到上限。
核心流程:
预处理替换(把特殊占位符换正式字符, textSettings.PreprocessReplacements)。genLines:调 txt.cachedTextGenerator.Populate(content, settings)拿UILineInfo,每行带startCharIdx(这一行从第几个字符开始)。checkRules:遍历每行,看行首是不是“行首禁字”;是就由 calculateShift算出要往前挪几个字符,在那个位置content.Insert(partitionIndex, NewLine),把违规字符推到下一行。插入 \n改了文本,所以再genLines+checkRules反复修,最多maxLineCount * 2轮(loopTimes,GetPunctuationFixedText第 60–64 行)。
它挂了四种规则(calculateShift):
- 不可见不断行
:富文本标签、零宽字符这类“看不见但占位”的,不能从这里断开。 - 可见不断行
:显式标记成“连在一起”的字符段,不能从中断开。 - 行首禁字
:行首遇到标点 / 右括号等“不能打头”的字符,继续往前挪,直到行首是正常字。 - 行最小字数
:要求每行至少 2 个可见字符,避免末行只剩孤字。
边界提醒:哪些是禁字、哪些是断字点,由
TextSettings的IsNoneLeadingCharacter/IsInvalidCharacter/IsBreakingCharacter决定,字符集在Assets/GameAssets/shared/font/text_settings.asset配置,不是这份代码单独说了算。
核心是几条可复用的设计:
- “先排后改再排”的两阶段思路
:Legacy Text 改不了原生换行算法,所以唯一可行路线是——先用原生 Populate拿UILineInfo(每行startCharIdx),再回到文本层插\n修正,然后重排验证。等于把“换行决策”从引擎内部搬到了文本预处理层。 - 用
UILineInfo.startCharIdx定位行首,而不是自己复刻换行:引擎已经算好了每行从哪开始,你只管检查那个位置的字符合不合规,省掉重写换行逻辑的坑。 - 规则数据驱动,不硬编码
:禁字、断字点都放 TextSettings(配置text_settings.asset),代码只跑规则引擎;换项目、换语言只改配置。 - 迭代修正 + 上限保护
:用 loopTimes(maxLineCount * 2)和“本轮没插\n就停”双保险,防止规则互相拉扯导致无限循环。 - 区分可见 / 不可见不断行
:富文本标签、零宽字符这类“看不见但占位”的,不能当断点误伤,否则 <color>标签会被插断。
总体的优化点:“排一遍、改一下、再排一遍”的循环,长文本或高频刷新时偏吃 CPU。按性价比排序:
(1)每轮都重排是最贵的一项:压 Populate 次数
checkRules 每次都走 genLines → txtGenerator.Populate(...),而 Populate 会进原生 TextGenerator 重算整段排版,最坏 maxLineCount * 2 次原生排版。可做的:
已做:某轮没插入 \n(checkRules返回 false)就立刻停(第 61–64 行while)。进一步:把 loopTimes上限从固定maxLineCount * 2改成更贴近实际的阈值,避免无违规时空转;确认punctuationContext.startLine(第 114 行= i + 1)和matches的startPartitionIndex(第 296 行)同步推进正确,否则会漏扫 / 重复扫。
(2)string.Insert 在循环里反复分配新串
content = content.Insert(partitionIndex, NewLine) 每次生成新 string(C# 字符串不可变),多轮叠加就是 O(文本长度 × 轮数) 的分配与拷贝。更划算:先收集所有要插 \n 的位置,最后用 StringBuilder / 一次拼接出结果,而不是每发现一个违规就 Insert 一次并重排。注意工具现在“插一个就重排”是因为插入会改变后续行 startCharIdx;若改成“先收集后统一插入”,必须自己维护字符索引偏移,不能照搬旧索引。
(3)每轮重跑正则全串扫描
checkRules 每轮调 punctuationContext.matches(content),对整段 content 重跑 VisibleNoneBreakingRegex / InvisibleNoneBreakingRegex。每次插入 \n 后全串重扫。优化:
已匹配的前缀若不再变化,只对新后缀做匹配或缓存已匹配区间; 若规则集合简单(固定字符 / 短模式),可用普通字符判定替代正则,省掉 Regex.Matches的分配与回溯。
(4)潜在越界 bug:顺手修
第 104–105 行:
if (partitionIndex < 0 || content[partitionIndex - 1].Equals(NewLineChar))当 partitionIndex == 0 时,partitionIndex < 0 为 false,会取 content[-1] → IndexOutOfRangeException。应改成 partitionIndex <= 0 || ...。同理 check_NoneLeadingCharacterRule(第 190 行 content[partitionIndex],随 partitionIndex-- 递减)也有越界风险,需加下界保护。
(5)calculateShift 递归可改循环
第 137 行 shift > 0 时递归调自身,逻辑是“挪完一段从新位置再判断”,可用 while 表达,避免递归栈与重复参数传递,更利于 JIT 内联判断。
(6)ContentSizeFitter 分支的副作用
GetPunctuationFixedText 开头若检测到 ContentSizeFitter,会直接 txt.text = content 并 SetLayoutHorizontal/Vertical(第 28–34 行),用的是还没修标点的原始 content,会让 Text 立刻进一次重建。若调用方随后还会再设文本,这遍重建等于白做。建议理清“算尺寸”与“改文本”职责,只在确实需要从 fitter 拿尺寸时才触发。
小结:这个工具补的是原生
TextGenerator不认的排版禁则,尤其行首标点与(未启用的)单行最少字数。优化优先级:先修越界 bug(4)→ 压Populate轮数(1)→ 减 string 分配(2)→ 减正则重扫(3)→ 递归改循环(5)。是否启用check_RowMinWordCountRule直接决定“单字成行”能否被根治,需产品 / 美术一起确认最小字数阈值。
排查顺序
先看 Text.OnPopulateMesh、Layout 和 Canvas rebuild 的耗时,不凭现象直接认定字体图集已满。字体纹理更新时,确认是否有大量 Text 共用同一 Font,因为它们会一起收到 FontTextureChanged。文本被截断时,检查 Rect、Horizontal/Vertical Overflow 和实际 TextGenerator 输出。 改颜色或其他生成设置后,按顶点重建看待,不要假设缓存一定复用。 BestFit 只在确实需要自动缩放时开启,并用目标设备数据评估。
TextMeshPro 使用另一套字体资产、图集和文本生成管线。两者都把文本转成网格,但不能把 TMP 的 SDF、动态 Atlas 或换行实现套到 Legacy Text 上。
实战性能优化:
1. 打字效果:别用 text += c
新手写打字机效果,最容易这么写:
textComponent.text = "";foreach (char c in fullText){ textComponent.text += c; // ⚠️ 危险操作yieldreturnnewWaitForSeconds(delay);}问题不在 WaitForSeconds,而在 text += c 每一帧都在干三件坏事(原文第 2.1 节):
C# 字符串不可变, +=等于每次new string(),产生一串临时对象(GC 压力);改 text触发SetVerticesDirty(),文字网格要重算;更隐蔽的是,它会强制 LayoutRebuilder.MarkLayoutForRebuild(),把同一个 Canvas 下所有 Text 的PreferredWidth都重新测一遍——哪怕别的 Text 内容根本没变。这是 UGUI Layout 的固有设计,不是 bug。
正解是"不让 Text 感知内容变化":用 StringBuilder 一次性把全文赋值好,再用 maxVisibleCharacters 控制"只渲染前 N 个字符"(原文第 2.2 节):
textComponent.text = _sb.ToString(); // 只触发 1 次 LayouttextComponent.maxVisibleCharacters = 0; // 初始全隐藏// 每帧只改这一个:textComponent.maxVisibleCharacters = _currentLength; // ✅ 不触发 Layout 重建maxVisibleCharacters 只告诉 Text"画前 N 个",底层 Mesh 顶点早就生成完了,GPU 侧做一次顶点裁剪(Vertex Clip)即可,完全不涉及 CPU 字符串拼接和 Layout 重算。文章实测:红米 Note 9(Helio G85)上 100 字符打字,旧方案平均 ~12ms,新方案稳定 <0.8ms。
坑(原文第 2.3 节):一旦文本里有
<color>、<b>这类富文本标签,maxVisibleCharacters会"数错"——标签字符占位数但不出字形。这时要用TextGenerator解析出每个字符在最终 Mesh 里的起始顶点索引,自建"字符 → 顶点"映射表来驱动可见长度。
这和我们前面"改颜色或生成设置后,按顶点重建看待,别假设缓存一定复用"是同一类提醒:任何让 Text 走 OnPopulateMesh 的操作都有成本,能不重排就不重排。
2. 阴影 / Outline:顶点和 DrawCall 的隐藏放大器
阴影依赖"额外的 Mesh 顶点生成 + 两次 DrawCall",一个带阴影的 Text 在低端安卓机上可能比一个 SpriteRenderer 还吃资源。
机理上,和我们前面讲的"顶点提交"对得上(这部分是 UGUI 通用事实,原文未展开逐字推导):Shadow / Outline 都是 BaseMeshEffect,在 Text 的 OnPopulateMesh 产出顶点之后,通过 ModifyMesh 把整份顶点列表复制一份并偏移(Shadow 复制一份、Outline 再往四个方向各复制一份)。结果是:
- 顶点数随效果层数线性放大
:Shadow 约等于翻倍,Outline 约等于翻数倍(原字 + 多个方向副本); - DrawCall 也可能随之增加
:叠加效果后批处理更容易被打断。
所以"排查顺序"里那句"不能断言卡顿必然是图集满、也不是顶点数"要反过来记一句:当你确实挂了 Shadow / Outline,顶点数暴涨就是预期内的——能不开就不开,尤其是列表里成百上千个 Text 同时带阴影时。要阴影又想省,常见做法是把阴影烘成一张静态图、用更轻的 Shadow 替代更重的 Outline,或干脆用 TMP 的 SDF 阴影(但那是另一套管线,见下)。
3. 渐变:靠顶点色 + 自定义 Shader,别和 TMP 混为一谈
渐变需要绕过 FontTexture 的限制,依赖顶点色(vertex color)与自定义 Shader 协作;项目里若同时用了 TextMeshPro,还会碰到"Unity 对 TMP 的隐式降级兼容逻辑"。
落到实践:UGUI 自带 Text 没有官方 Gradient 组件,常规做法是写一个 BaseMeshEffect,在 ModifyMesh 里按字符/行的屏幕位置改每个顶点的颜色,实现从一端到另一端的颜色过渡。它改的是顶点色,不碰 FontTexture,所以能和前面的字形网格和平共处。
但务必记住本篇反复强调的分水岭:Legacy Text 和 TMP 是两套管线。如果项目已经用 TMP,渐变就得走 TMP 自己的材质 / Shader(TMP 的 gradient 是另一套机制),不能把 Legacy 这套"改顶点色"的套路直接套过去——否则就是典型的"把 TMP 的 SDF / 动态 Atlas / 换行实现套到 Legacy Text 上"的反面教材。
小结:打字用
maxVisibleCharacters躲 Layout 重排;阴影 / Outline 是顶点和 DrawCall 放大器,能省则省;渐变走顶点色 + 自定义 Shader,且和 TMP 不互通。三条都指向同一句话——Text 的便宜是假象,每一次OnPopulateMesh和每一次叠加效果都在悄悄吃 CPU / GPU。
总结
这文主要帮你梳理了如下要点:
- 认边界
: Text→TextGenerationSettings→TextGenerator→VertexHelper→ Canvas,这条链路里 ①④、⑧⑨ 还有字体重建联动都是 UGUI 的 C#,能查到调用关系和失效范围;而 ⑤~⑦、⑩(字形光栅化、动态图集装箱、换行策略、BestFit 字号搜索)全在引擎原生层,是黑盒——源码能证"调了谁",证不出"内部怎么算"。 - 看清字形怎么上屏
:一个字符 = CharacterInfo给的三样东西(uv圈图集里哪块像素、vert围网格上哪个 quad、width当光标步进),每 4 个顶点拼成一个 quad。文字纹理就来自font.material.mainTexture,不是 Font 单独存的什么FontTexture。 - 动态字体是另一条路
:动态字体运行时按需求字、装箱进图集,图集一重建就靠 FontUpdateTracker把共用该 Font 的所有 Text 拉回来重排;静态字体导入时就排好,不触发这条链。首屏/滚动卡顿排查时,动态字体更新要列入嫌疑,但不能张口就断定"肯定是图集满或顶点多",得 Profiler 说了算。 - 换行是原生黑盒,原生不认排版禁则
:断行只按 CharacterInfo.width累加、放不下就断,不认识行首标点、不保证末行最少字数。所以单字成行、行首禁字是默认就会出的,不是你FontData配错了。想修,只能像文中项目那样"先排后改再排"——用UILineInfo.startCharIdx定位行首、在文本层插\n纠偏,规则数据驱动、迭代修正带上限保护。 - BestFit 和颜色都不是零成本
:BestFit 把字号搜索丢给原生层,是已知性能风险点,别随便给长文本/滚动列表开;改颜色也会走 SetVerticesDirty重建顶点色的网格,缓存复用不能想当然。
与君共勉~