ARTICLE · 1145038
NavGPT-3 源码精读:推理和动作拆成线程,如何让机器人跟上突发变化?
NavGPT-3 把语言模型的推理和低延迟动作策略放进同一个运行时。8B 策略单独在 R2R-CE 上是 74.51 SR,完整系统到 81.51。
NavGPT-3 源码精读:推理和动作拆成线程,如何让机器人跟上突发变化?
语言模型能把一段很长的任务拆开,动作策略负责每一步怎么动。NavGPT-3 把这两边放进同一个运行时,由运行时决定哪一条线程此刻控制机器人。
论文|NavGPT-3: Harnessing Context in a Hierarchical Navigation Runtime 作者 / 机构|Gengze Zhou 等,Adelaide、Metacognition、ANU、Roblox、北大、上交、UNC、UNSW 论文地址|https://arxiv.org/abs/2610.10787[1]代码地址|https://github.com/metacognitionai/NavGPT-3[2]代码日期|仓库创建于 2026-10-07,许可证 Apache-2.0
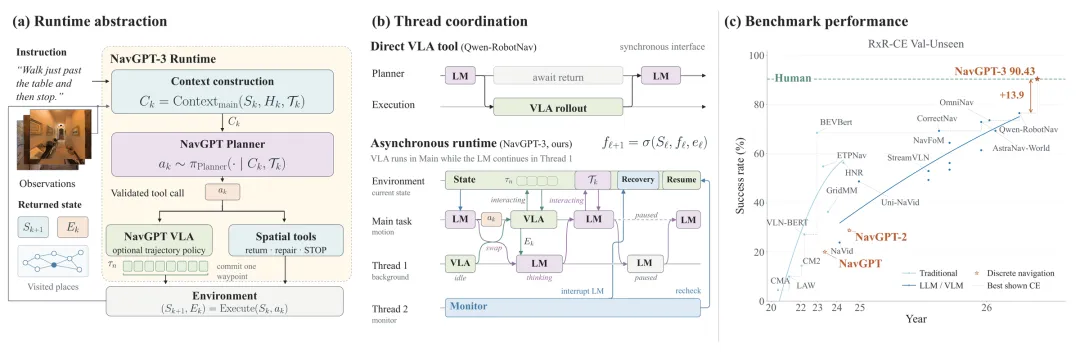
Figure 1. Overview of NavGPT-3.
01 / 先看结论
解决了什么: 语言模型一次决策要 3 到 19 秒。机器人碰到突然出现的障碍,等不了这么久。 改了什么: 推理、动作、监测分成各自有上下文、工具和权限的线程。运行时调度它们,并决定谁掌握运动权。 停在哪里: 这个仓库放出了 VLA 推理、harness 和仿真评测。Unitree 上基于 ZEOS 的部署还没放出来。
先看 README 的 Method 和 TODOs。动作策略叫 NavGPT VLA,训练样本 19.28M。8B 模型单独在 R2R-CE 上是 74.51 SR,在 RxR-CE 上是 78.19 SR。
02 / 问题背景
长程强化学习训出来的语言模型,能把目标拆成很多步。真正碰物体、拐弯、停下,还是动作策略的事。策略要的是密、快的控制。两边如果串成一条,语言模型每次重新想,机器人就停在那儿。
NavGPT-3 的做法是不让推理线程独占机器人。动作线程可以按自己的频率走,监测线程负责打断。运行时只在需要时把运动权交出去,再收回来。
能不能让语言模型继续做长程判断,同时把一次反应从几秒压到一次动作步?
03 / 方法拆解
仓库把系统写成三层:交互层是 NavGPT VLA,上面是 harness,再上面是部署运行时。运行时建在 ZEOS 上。
设计一是线程。规划器、VLA 和空间工具同时存在。Figure 1 把同步调用工具和异步线程协调分开。同步时,主流程要等工具返回。异步时,几条线程各跑各的,运行时挑选谁控制运动。
设计二是视觉 token 的分配。NavGPT VLA 用 codec allocation,按场景变化比例分配视觉 token。Figure 3 写的是变化、新近程度和视角一起决定四帧历史里每张图的分辨率。第一帧是 I 帧,后面是 P 帧。实验规模写在图注里:13 段记录历史、41,216 个图像与上下文配对,视觉预算 3072。
Figure 2 给了两种打断。一种是路线复查,主执行暂停、改正、再继续。一种是安全打断,运动权被收回,推理还可以继续。恢复时要新的状态,也要运行时重新授权。
04 / 源码对照
NavGPT VLA 推理服务 → harness(Claude Agent SDK / Codex SDK Planner) → R2R-CE 与 RxR-CE 仿真评测 → ZEOS 运行时(Unitree 部署尚未放出)README 的 TODOs 把已放出和未放出分开。已放出的是 4B 与 8B 权重、推理代码、harness、仿真评测,以及主结果和消融的配置。权重在 Hugging Face 的 Metacognition-AI。未放出的是 ZEOS 在 Unitree 上的线程管理和部署。
Planner 和 VLA 可以选 uv 或 conda,三个组件各有环境。仿真器徽章写的是 Habitat-Sim 0.1.7。我没有跑评测,SR 数字以 README 摘要为准。
8B 单独的 74.51 SR 和完整系统的 81.51 SR 不是同一个设置。前者是动作策略,后者加上了 harness。
05 / 实验配置
动作策略训练集 19.28M。模型有 4B 和 8B。 R2R-CE:8B 单独 74.51 SR,完整 NavGPT-3 81.51 SR。 RxR-CE:8B 单独 78.19 SR。完整系统 90.43 SR,人类跟随者 90.4 SR。路径贴合 78.47 nDTW,人类 77.7。 每集耗时 1 分 22 秒。人类大约 3 分钟。 反应时间:语言模型一次决策 3 到 19 秒。动作策略一步 0.5 到 1 秒,对应 1 到 2 Hz。 视觉预算图里写的是 3072。13 段历史,41,216 个配对。
这些对比最容易混的是「只跑 VLA」和「VLA 加 harness」。README 把两列都写了,不能拼成一个模型的成绩。
06 / 结果怎么看
R2R-CE 的 81.51 SR,README 写成当前最好。RxR-CE 的 90.43 对 90.4,是成功率和人类跟随者打平。78.47 对 77.7 是路径贴合,不是成功率。
1 分 22 秒对大约 3 分钟,是每集时间。0.5 到 1 秒是动作策略一步的反应,不是整集时间。
我没有跑 Habitat。消融配置仓库说已经放出来,我没有逐个打开核对。
人类水平这句话,README 限定在 RxR-CE 的成功率和路径贴合。不要挪到 R2R-CE 上。
07 / 论文与代码
论文链接是 arXiv:2610.10787。代码侧能对上的是三层结构、VLA、harness、两个 CE 数据集,以及 Figure 1 到 Figure 3 的文件名:assets/teaser.png、assets/runtime_sequence.png、assets/codec_measured.png。
仓库明确还没放的是 Unitree 部署。仿真结果不能直接当成实机结果。
Claude Agent SDK 和 Codex SDK 都列在 Planner 运行时里。README 没有写默认用哪一个,也没有写每个评测用了哪一个。
08 / 复现路线
先按 README 选 uv 或 conda,把 Planner 和 VLA 的环境分开装。权重从 Hugging Face 的 Metacognition-AI 拉 NavGPT3-4B 或 NavGPT3-8B。评测入口是 R2R-CE 和 RxR-CE 的仿真脚本,配置在主结果和消融目录里。
跑通的标志是评测日志里能找到 SR 和 nDTW,并且能分清只跑 VLA 还是完整 harness。
最容易看错的是把 Unitree 部署当成这个仓库已经包含的部分。TODOs 里那一项还是空的。
09 / 判断
值得留下的是运动权可以换线程。语言模型继续做长程判断,动作策略按 1 到 2 Hz 走,安全打断不必等一次 3 到 19 秒的推理结束。
限制也写在仓库里。实机部署还没放。人类水平只对应 RxR-CE 上的两个指标。我没有重跑这些数字。
这个仓库把「谁现在能动机器人」做成了运行时的一件事。实机上换不换得了线程,要等 ZEOS 那部分代码出来再看。
参考资料
[1] 论文 https://arxiv.org/abs/2610.10787[3]
[2] 代码 https://github.com/metacognitionai/NavGPT-3[4]
[3] 图 assets/teaser.png assets/runtime_sequence.png assets/codec_measured.png
[4] 运行时 https://github.com/metacognitionai/zeos[5]
引用链接
[1]https://arxiv.org/abs/2610.10787
[2]https://github.com/metacognitionai/NavGPT-3
[3]https://arxiv.org/abs/2610.10787
[4]https://github.com/metacognitionai/NavGPT-3
[5]https://github.com/metacognitionai/zeos