ARTICLE · 1147722
如何判断一个 AI 场景值不值得做?能力边界、容错成本、单位经济账
我一个朋友,在一家电商公司做 AI 产品。上季度的评审会上,运营 VP 把一张 Excel 投到幕布上——一万八千条客服工单:"能不能让 AI 自己派?" 他答得很干脆:"能做。" 三个月后上线,准确率 76%,三分之一的单子一线要手动改。最后团队自发用起了新流程:AI 先派一次,人再改一次——比原来还多一步。复盘会上,这个项目被归为"技术验证成功,业务价值未达预期"。翻译过来就是:做出来了,白做。
他后来复盘,发现问题不在模型——派错了,客服改一下就行,不赔钱也不被告,并不致命。问题是他从头到尾没算过一笔账:人工分派一单多少钱,AI 分派一单多少钱,差多少,多久回本。他回答的是"能不能做",老板问的其实是"值不值得做"。 真正难的从来不是"能不能做",是"该不该做"。而这两件事,99% 的团队分不清。
他把判断过程压成四个问题,每个半小时内能答完。下面四段,就用他这个案例——客服工单自动分派——从头走到尾。
第一问:能力边界——大模型擅长什么,不擅长什么
它是什么
大模型不是"更聪明的程序",它是概率化的模式匹配器。这句话听着像废话,但它有一个很实际的推论:大模型的能力由任务的模糊度和容错度决定,不由任务的难度决定。 难的它很行——写一段有分寸的催收提醒文案,人写得好的也就那样。简单的它可能崩——数一下这张 Excel 里有多少行,它能给你一个自信满满的错误答案。所以评估场景时别问"这个难不难",要问"这个任务模不模糊、允不允许不确定"。
怎么用:拆成原子任务,逐个打标签
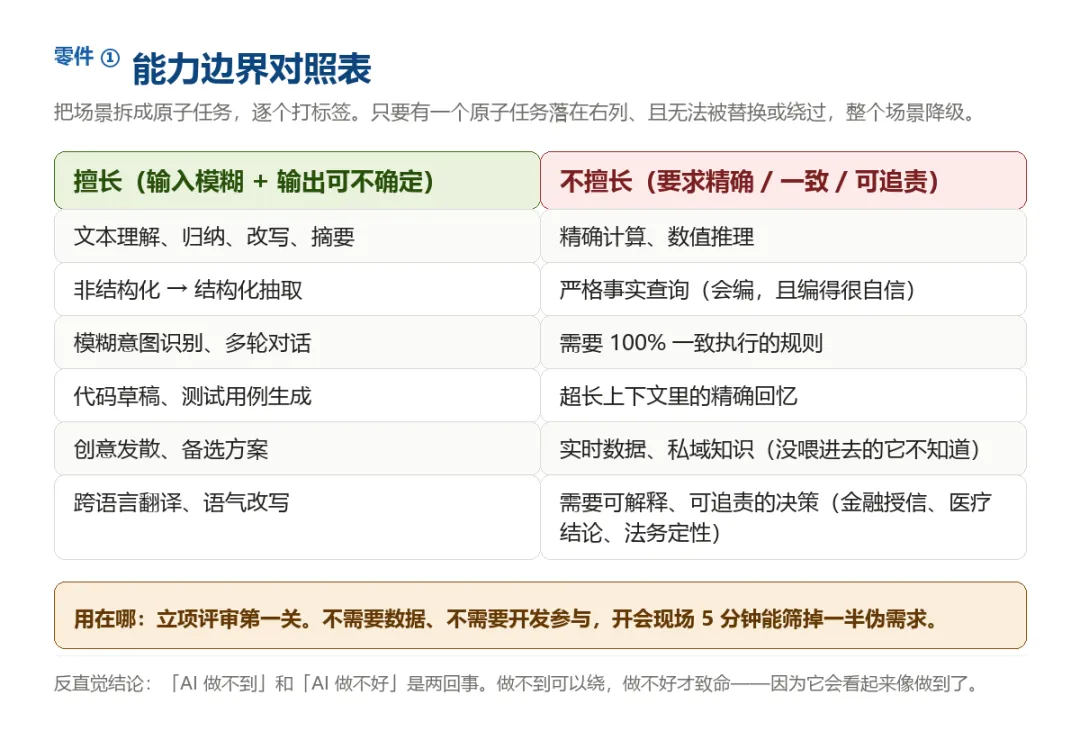
把场景拆到不能再拆,每个原子任务打上"擅长"或"不擅长"。以工单自动分派为例,他拆出来是这样:
- 读工单正文,理解用户在说什么
→ 擅长(模糊输入,容错高) - 判断这单属于哪个业务类型
→ 擅长(本质就是分类) - 匹配"当前值班且空闲"的处理人
→ 不擅长(实时数据,它不知道) - 把结果写回工单系统并改状态
→ 不擅长(规则执行,要 100% 一致)
后两个落在右列。但它们都可以被替换或绕过:值班表走接口查,写回走 API 调,AI 只负责中间那一步"判断类型"。所以这个场景不降级,但方案要重画——从"AI 自动分派"改成"AI 自动分类 + 规则路由"。判定一句话:只要有一个原子任务落在右列、且无法被替换或绕过,整个场景降级。
什么场景用
立项评审的第一关。这一关 5 分钟能筛掉一半伪需求,而且它不需要任何数据、不需要开发参与,开会现场就能过。
一个反直觉的结论
"AI 做不到"和"AI 做不好"是两回事。做不到可以绕,做不好才致命——因为它会看起来像做到了。 做不到,你立刻就知道,会去加规则、加接口、改方案。做不好,它会输出一个很像样的东西,一路通过 demo、通过验收、通过你的自信心,然后在某个你没测到的 case 上出事。
第二问:容错成本——错一次的代价有多大
它是什么
决定要不要加人工复核的,不是"准确率多少",是错一次赔多少。同样是 90% 的准确率,用在会议纪要上是"少记了一条待办",用在对客报价上是"报低了两万块,而且客户已经截图了"。前者可以直接上线,后者上线就是事故。
怎么用:容错三档
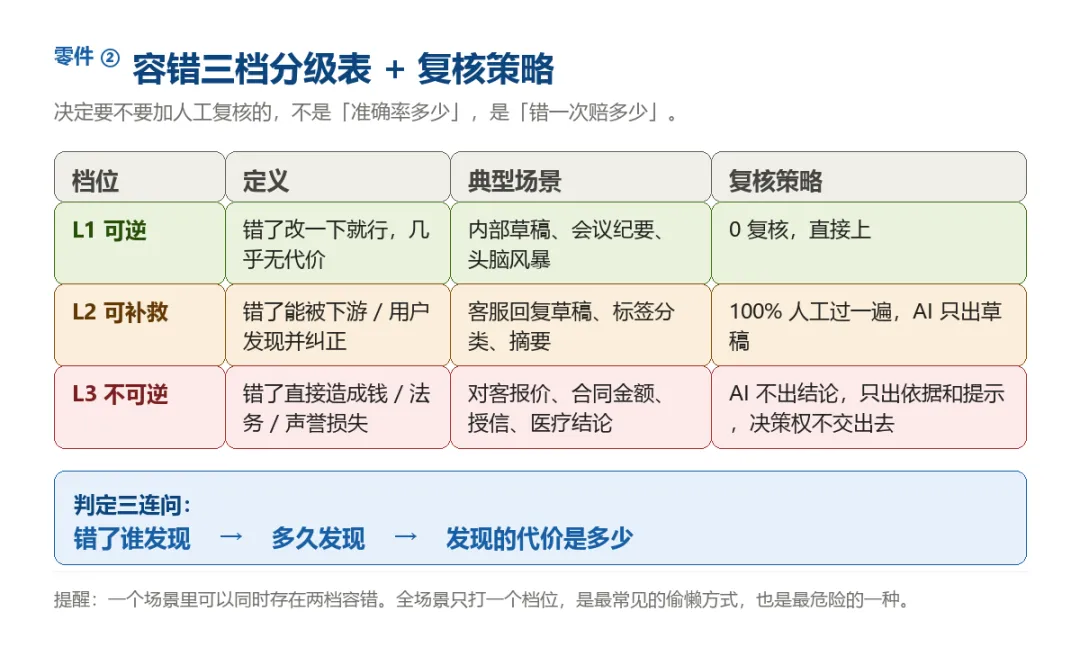
工单分派落在 L2:派错了,下游客服看一眼就知道不对,改一下,成本几秒钟。所以他们的方案是 AI 只出"建议处理组",状态不改,人工点确认。
但这个场景里还藏着一个边界:有一类工单是"对客承诺时效"的(比如"48 小时内回复")。这类单派错组会直接导致超时违约。它表面上是 L2,实际接近 L3。后来他们把这类单单独摘出来,走规则路由,不进 AI。一个场景里可以同时存在两档容错。 全场景只打一个档位,是最常见的偷懒方式,也是最危险的一种。
判定三连问
错了谁发现 → 多久发现 → 发现的代价是多少。
把准确率翻译成事故量
这是全篇我最想让你记住的一段,也是我在评审会上最常拿出来的一段。别问"能不能做到 99%"。要问:
"99% 意味着每天错 12 单,每单我们要赔 300 块,一天 3,600。这个数你认吗?"
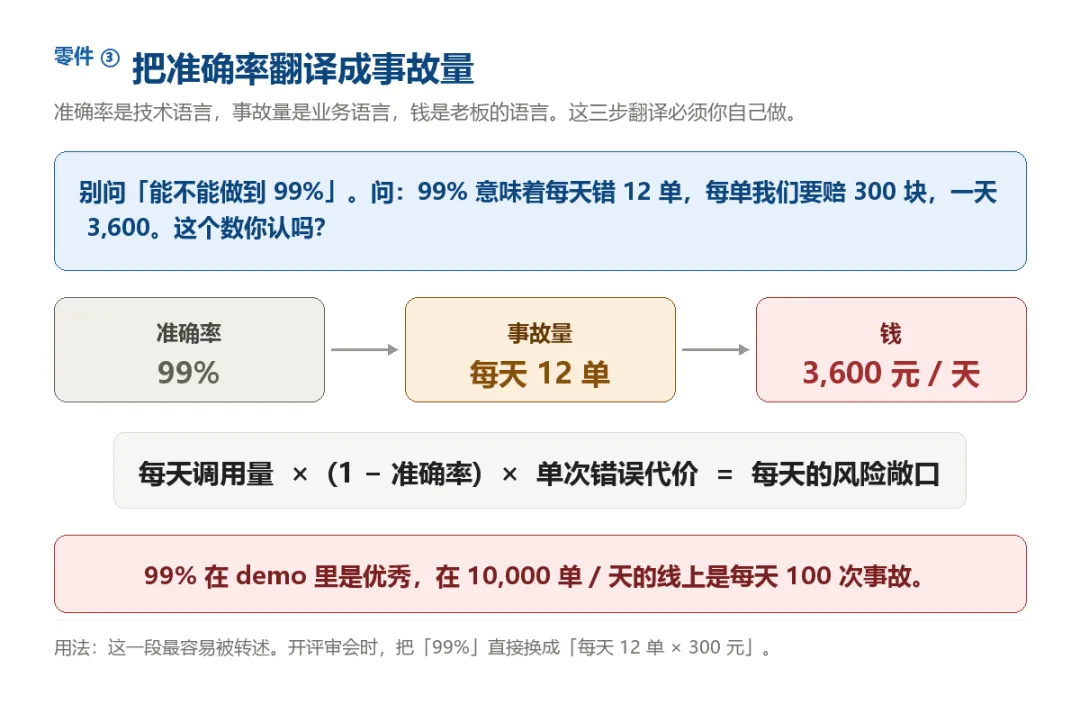
99% 在 demo 里是优秀,在 10,000 单/天的线上是每天 100 次事故。 准确率是技术语言,事故量是业务语言,钱是老板的语言。这三步翻译必须你在会上自己做——技术同事不会替你做,老板自己也算不出来。
第三问:数据——有没有、拿不拿得到、合不合规
三个问题,全绿才能往下走。
- 有没有
——这件事历史上被人做过吗?做过就有数据。如果从来没人做过,那你现在要解决的不是 AI 问题,是流程线上化问题。 - 拿不拿得到
——数据在哪个系统、什么格式、脏不脏、你有没有权限取。 - 合不合规
——有没有个人信息、能不能用于训练、客户授权范围到哪、能不能出域。
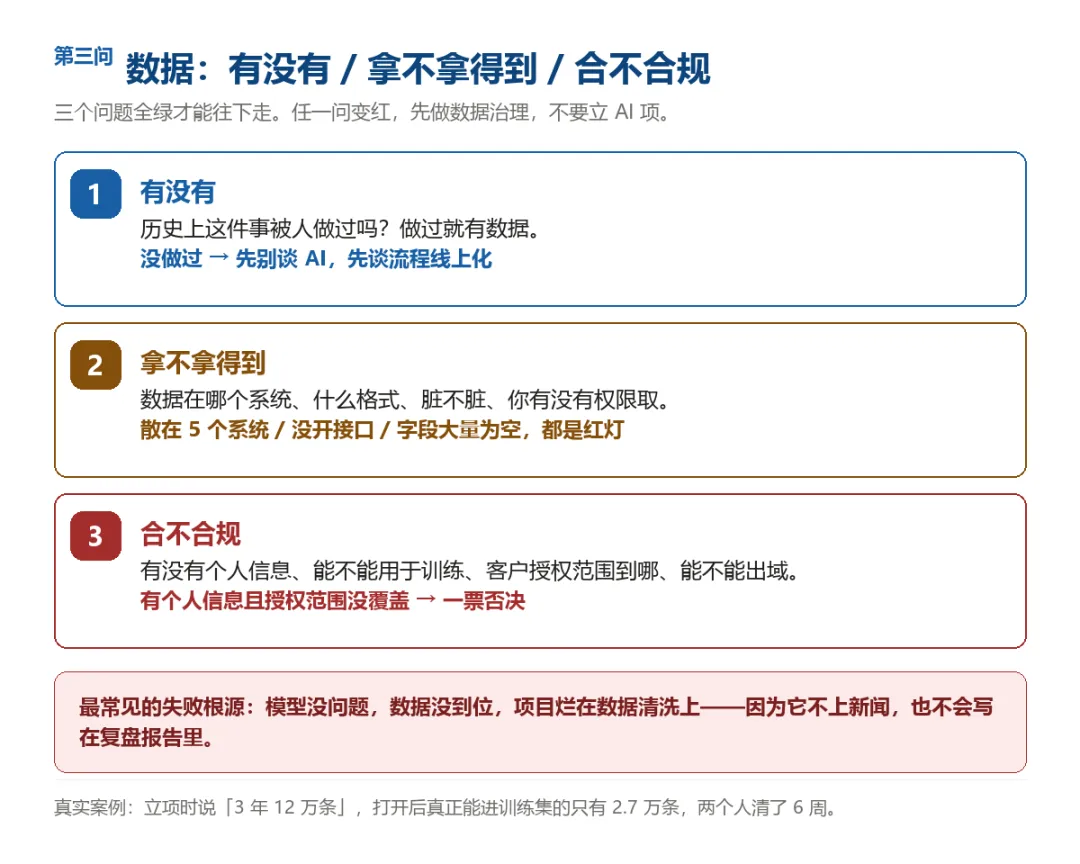
在这个项目上,他的第二问栽得很彻底。立项时他们说"有 3 年工单数据,12 万条,够了"。真打开一看:
2023 年 6 月之前,"处理组"字段 40% 是空的——因为那个字段是后来才强制填写的; 一级分类有 37 个取值,其中"退款""退货退款""退款申请""退钱"是同一个意思,还有 9 个组名在系统升级时改过名,新旧两套并存; 数据散在 5 个系统里(工单系统、IM、邮件、APP 反馈、企微),其中两个没开放接口,只能人工导 Excel; 还有 5,000 多条是测试账号和内部培训打的单。
最后真正能进训练集的,是 2024 年 3 月之后的 2.7 万条。两个人清了 6 周,其中 3 周花在求别的部门开接口权限上。模型从来不是瓶颈。项目烂在数据清洗上,是 AI 项目最常见的死法——因为它不上新闻,也不会写在复盘报告里。所以任一项变红,先做数据治理,不要立 AI 项。
第四问:单位经济账——一次调用多少钱 vs 一次人工多少钱
它是什么
把技术语言翻译成钱。这一问做完,你的结论就从"能做"变成"值 8 个月回收期"。
公式
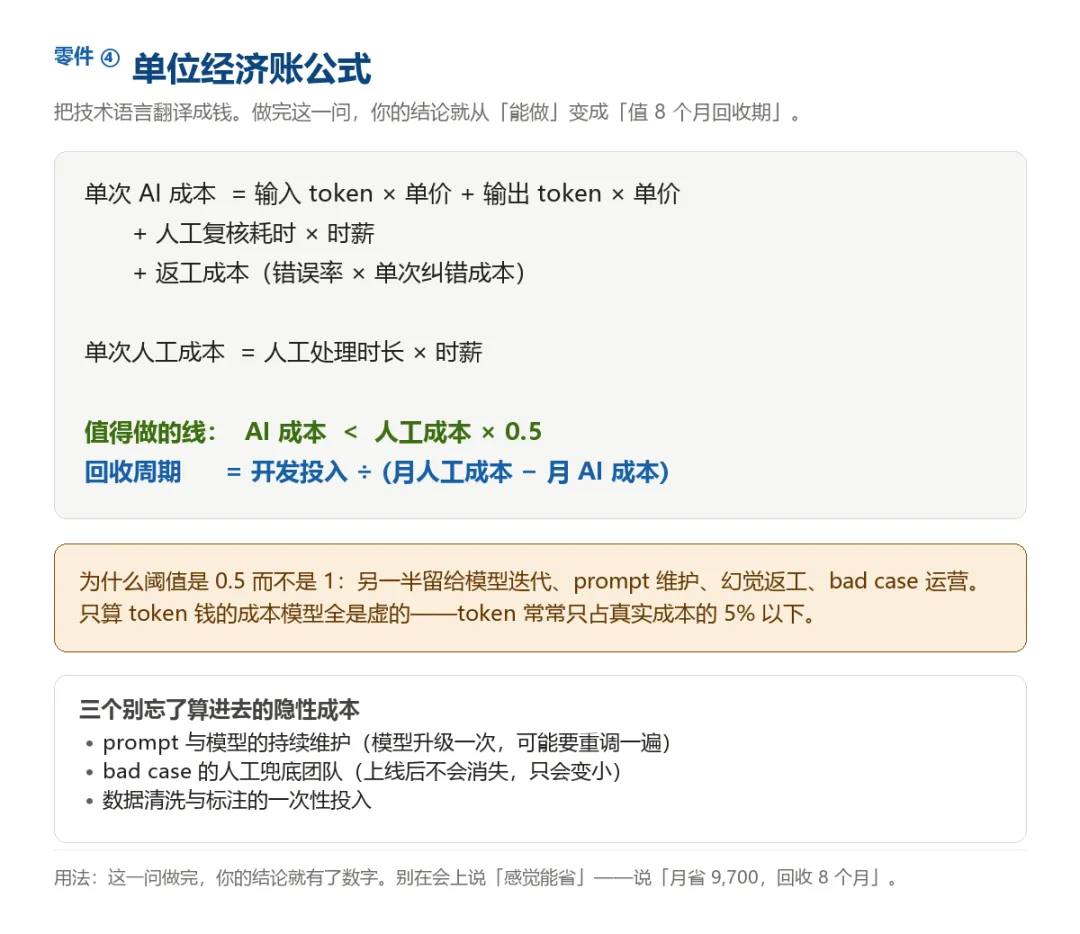
为什么阈值是 0.5 而不是 1? 另一半留给模型迭代、prompt 维护、幻觉返工、bad case 运营。只算 token 钱的成本模型全是虚的——token 常常只占真实成本的 5% 以下。
他在这个项目上算的那笔账
按实测数字:人工侧——分派一单平均 90 秒(读工单、判断类型、查值班表、找人),客服综合时薪 45 元 → 1.13 元/次
AI 侧:
token:输入约 1,200(工单正文 + 历史 3 轮 + 技能组清单 + 分类规则),输出约 80 → 0.01 元 复核:100% 人工过一遍,平均 18 秒 → 0.23 元 返工:首版准确率 76%,错派一次要退回、重派、用户多等 20 分钟,按 2 元/次算 → 0.24 × 2 = 0.48 元 合计 0.72 元
阈值线是 1.13 × 0.5 = 0.57 元。0.72 > 0.57,账不平。他要是先算了这笔账,就不会当场说"能做"。
后来他们做了第二版:缩小范围。只接管 14 个技能组里量最大、规则最清晰的 5 个(占总量 62%),这些组历史样本多,准确率提到 91%;复核从 100% 降到 30% 抽检;剩下 9 个组继续走规则路由。
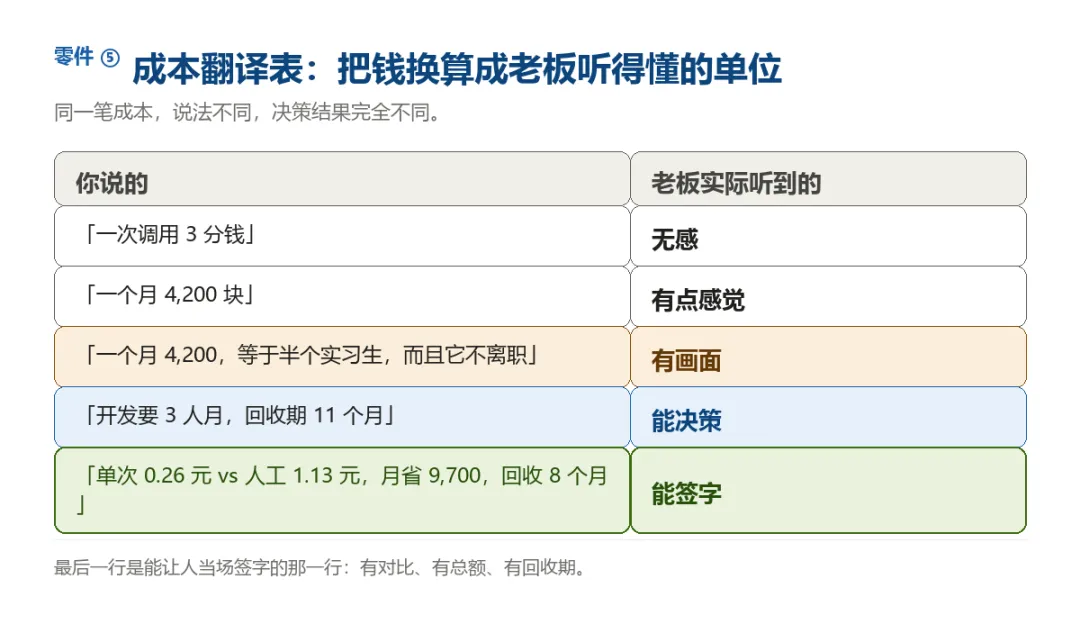
重算:0.01 + 0.3 × 0.23 + 0.09 × 2 = 0.26 元。0.26 < 0.57,过线。月节省:18,000 × 62% × (1.13 − 0.26) ≈ 9,700 元/月。开发投入 3 人月,回收期约 8 个月。同一个场景,全量做是亏损项目,缩小范围做是个好项目。 中间只差一个"缩小范围"的动作。
把钱翻译成老板听得懂的单位
三个别忘了算进去的隐性成本
- prompt 与模型的持续维护
:模型升级一次,你的 prompt 可能要重调一遍,这不是一次性工作; - bad case 的人工兜底团队
:上线后它不会消失,只会变小,但它永远不为零; - 数据清洗与标注的一次性投入
:上一问那 6 周,就是钱。
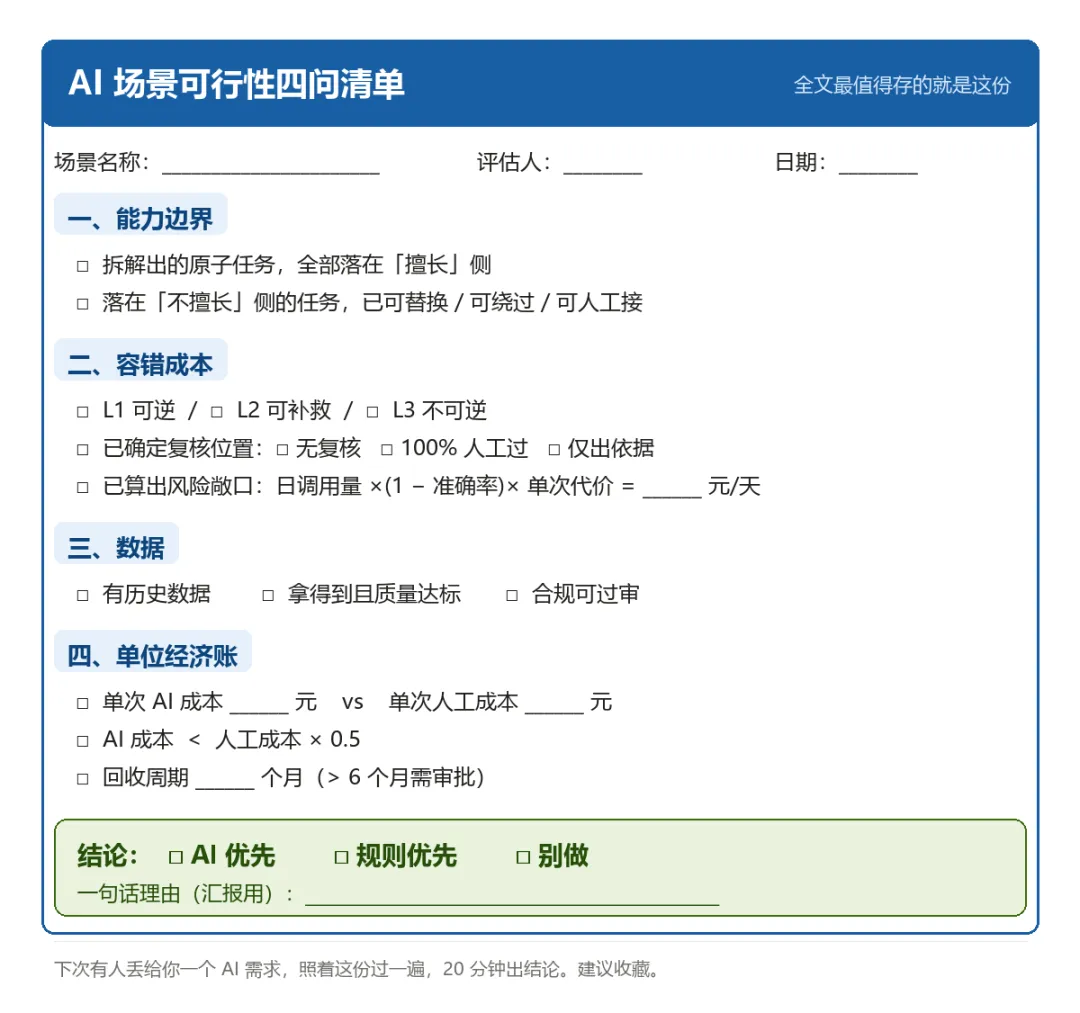
全文最值得存的:四问清单
前面四段是道理,这一张表是工具。全文最值得存的就是这份清单——下次有人丢给你一个 AI 需求,照着过一遍,20 分钟出结论。
决策树:四问过完,只有三种结论
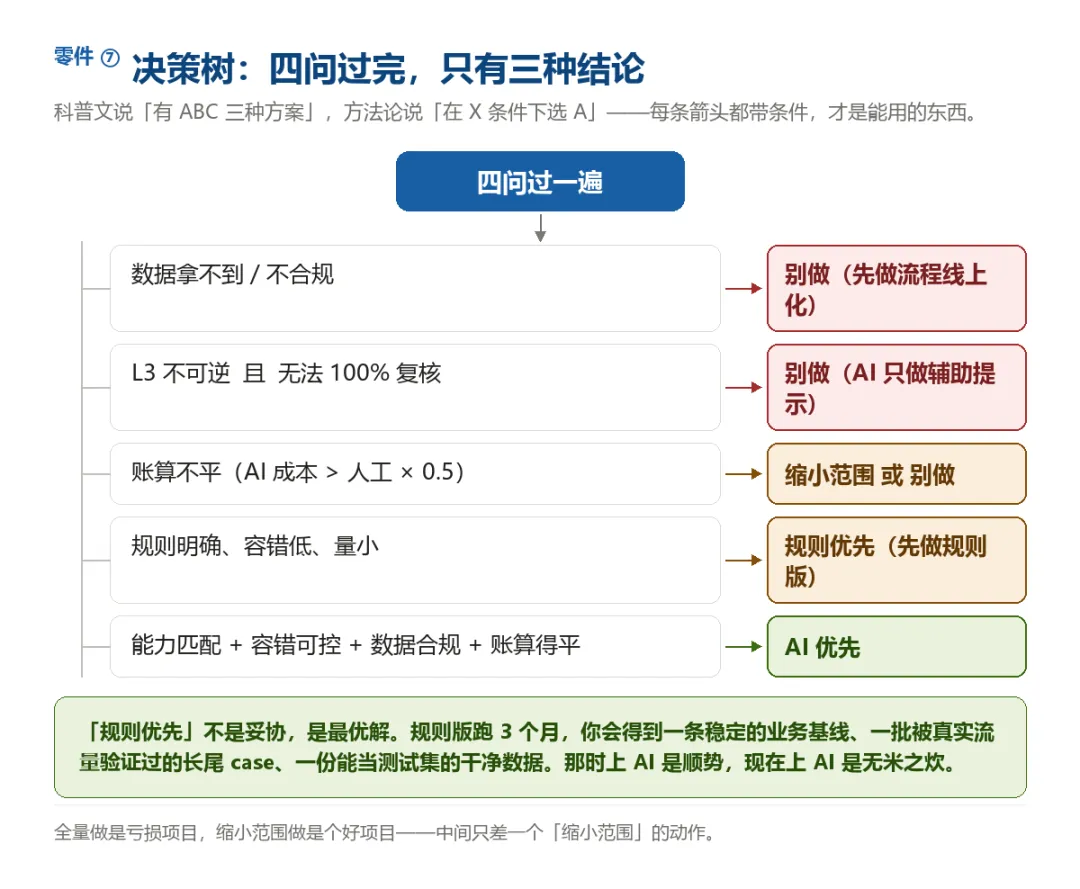
注意上面每条箭头都带条件。科普文说"有 ABC 三种方案",方法论说"在 X 条件下选 A"——带条件,才是能用的东西。
这里有一句要特别说:"规则优先"不是妥协,是最优解。 规则版跑 3 个月,你会得到三样东西:一条稳定的业务基线、一批被真实流量验证过的长尾 case、一份可以拿来当测试集的干净数据。那时候上 AI 是顺势;现在上 AI 是无米之炊。
汇报话术(可以直接抄)
"这个场景我们评估过:能力上能做,容错是 L2 可补救,数据合规 OK。但单位成本上,全量 AI 版一次 0.72 元 vs 人工 1.13 元,看着省 0.41,可按 76% 的准确率算,返工要吃掉 0.48,实际不省钱。
缩到 5 个高频技能组之后,单次 0.26 元,月省 9,700,回收期 8 个月。建议先做规则版跑 3 个月,把 62% 的标准化 case 吃掉,剩下的长尾攒够数据再上 AI。"
AI 项目的失败,90% 不是模型不行,是这个场景本来就不该用 AI。
明天就能做的事
下次再被问"这个能不能用 AI 做",别回答能,也别回答不能。把这份四问清单甩进群里,说一句:
"给我 20 分钟,我按这个过一遍,下午给你结论。"
就这一句,你的角色从"被问的人"变成"给结论的人"。
建议收藏:下次有人给你丢一个 AI 需求时,直接翻到「全文最值得存的:四问清单」这一节。
欢迎大家关注、点赞和转发,一起交流一起变得更强!!