ARTICLE · 1147877
前端、后端、数据库、网络:一篇讲透软件是怎么跑起来的
写给想入门开发(或想跟 AI 更好协作)的你。AI 能帮你写代码,但概念得自己懂——你懂的概念越多,需求讲得越准,AI 能帮你做成的事就越多。
写在前面
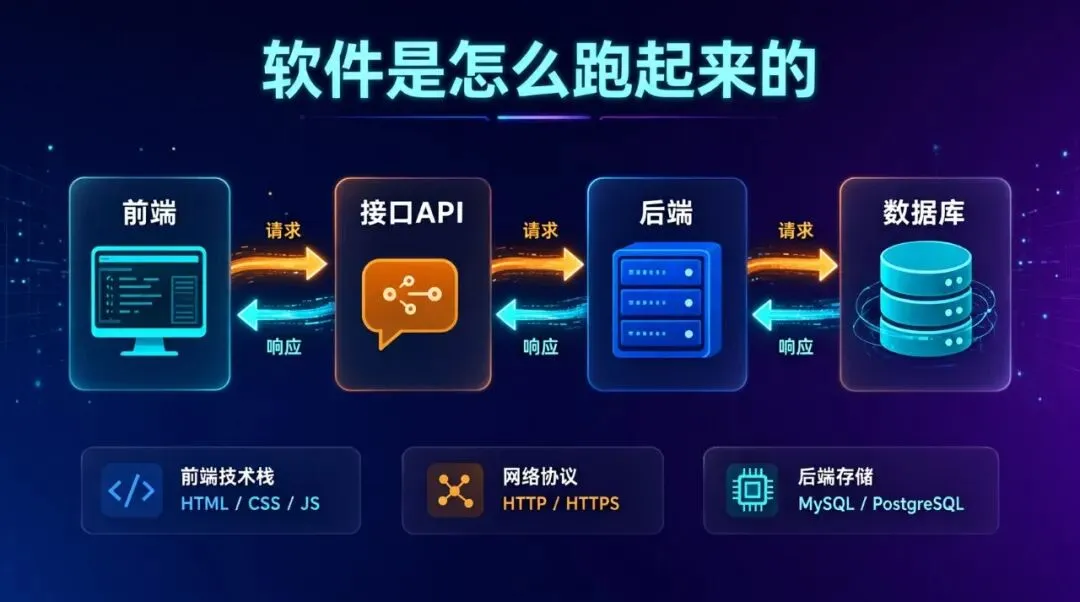
不管多复杂的软件,拆开看都是同一条链:
前端(给人看)→ 接口/API(传话)→ 后端(处理事)→ 增删查改(操作数据)→ 数据库(存数据)→ 返回展示
这篇文章把这条链上的每个角色讲清楚,再往下钻一层,把支撑这条链运转的网络知识也一并讲透。AI 时代这些知识并不难上手:你负责理解概念,写代码的事可以交给 AI。
一、前端:用户看得见的一切
定义:用户直接看到、直接操作的界面部分,负责「展示」与「交互」。
做什么:页面布局、按钮点击、表单填写、数据展示、动效反馈。
举例:网页里的按钮、表格、弹窗、日历,App 里的登录页,都是前端。
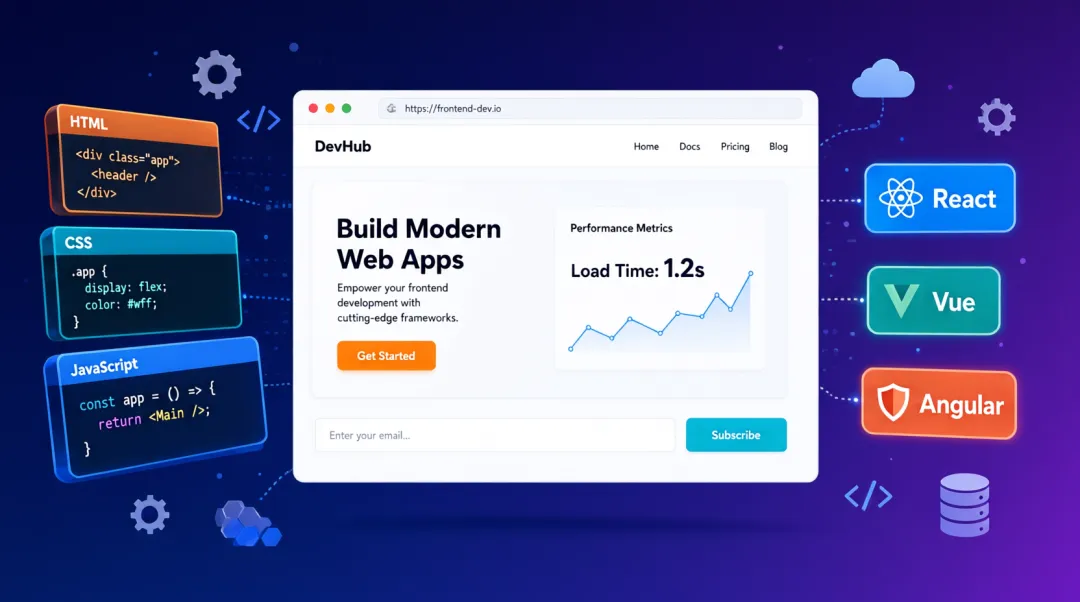
1.1 前端三件套
三件套是一切网页的地基,也是浏览器唯一认识的「母语」。
1.2 框架是什么,为什么需要框架
三件套写个小页面没问题,但页面一大——几十个弹窗、几百个组件——代码就会乱成一锅粥,改一处崩一片。
框架 = 组织代码的规矩 + 现成的零件库,核心解决三件事:
• 组件化:把页面拆成一个个可复用的「积木」,按钮、日历、弹窗,写一次到处用; • 数据驱动:数据一变,页面自动跟着变,不用手动去改页面元素; • 路由管理:页面之间的跳转、回退,统一管理。
类比理解:三件套是砖瓦水泥,框架是精装修整套方案。
前端的主流语言是 JavaScript(66% 的开发者在用)和它的强化版 TypeScript(43.6%,加了类型标注,大项目更稳,新项目基本都用它)。
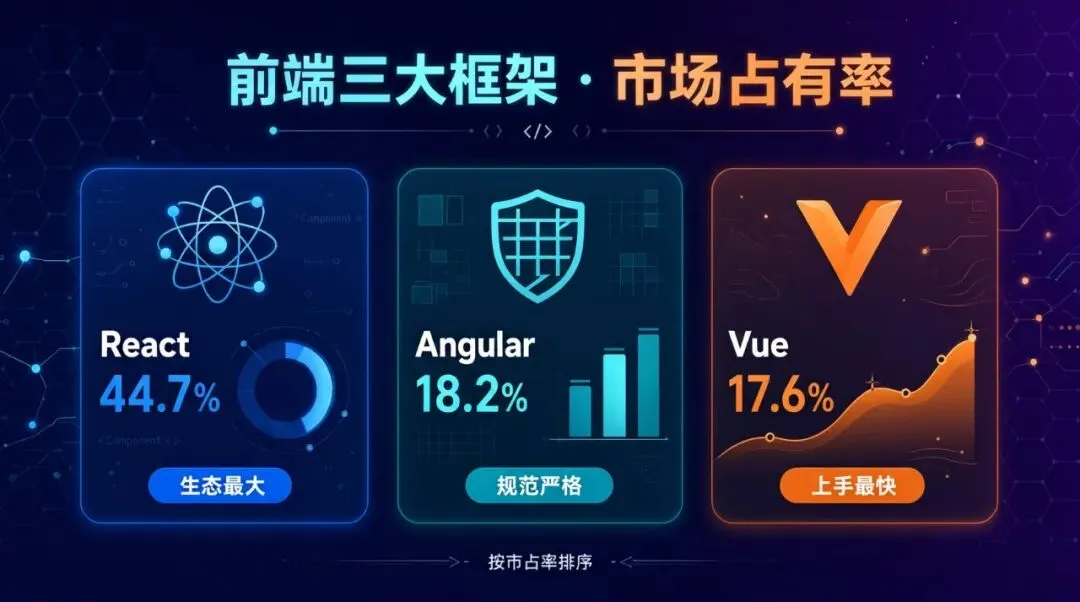
1.3 三大主流前端框架(按市占率排序)
| 44.7% | ||||||
| 18.2% | ||||||
| 17.6% |
市占率数据来源:Stack Overflow 开发者调查 2025(下同),指过去一年大量使用该技术的开发者比例。
入门选择:Vue 或 React 都可以;跟 AI 协作做项目,两个都很顺。
1.4 前端不止网页:软件的四种形态
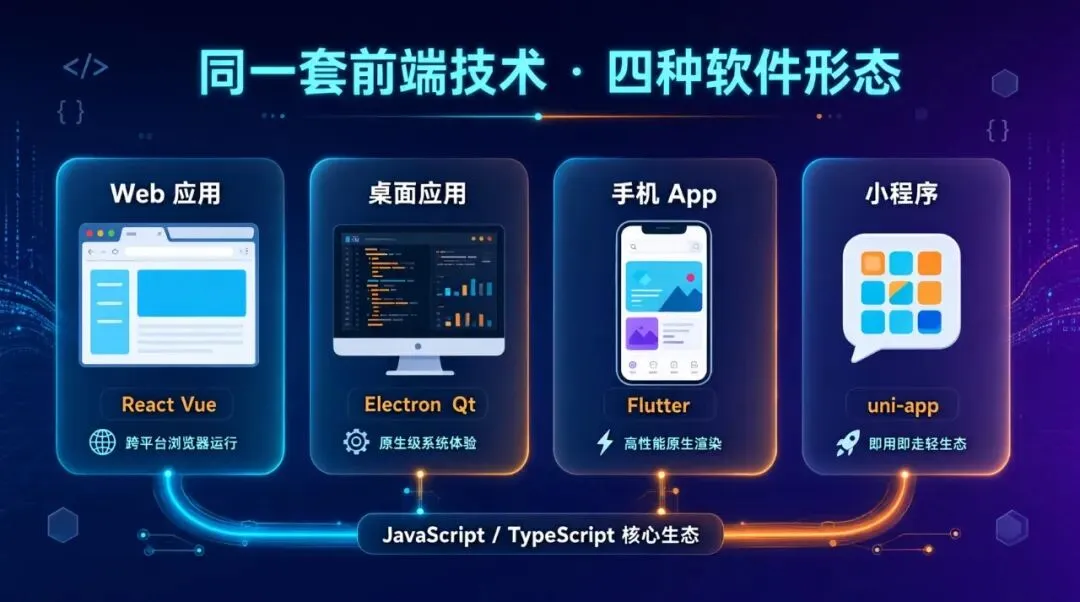
同样的前端技术思路,能长出四种不同的软件形态:
| Electron | |||
| Flutter | |||
二、后端:看不见但最关键
定义:用户看不到、在服务器上运行的程序,负责「业务规则」与「数据加工」。
做什么:接收前端请求、校验数据、读写数据库、做权限控制、返回结果。
举例:你在网页上点「保存」,真正把数据校验、写入数据库的那段程序,就是后端。
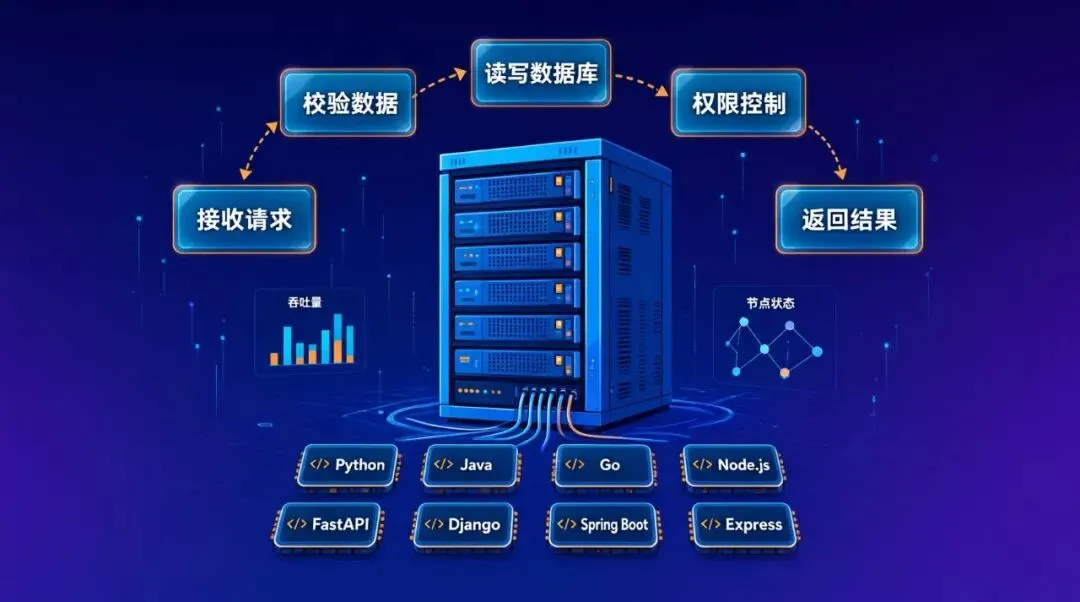
2.1 主流后端语言(按市占率排序)
| 66% | |||
| 57.9% | |||
| 29.4% | |||
| 16.4% |
2.2 后端也有框架(按市占率排序)
很多人以为框架是前端的专属,其实后端也有:前端框架管「页面怎么组织」,后端框架管「请求怎么处理」——路由分发、参数校验、数据库连接、鉴权,框架都替你安排好。
| 19.9% | |||||
| 14.8% | |||||
| 14.7% | |||||
| 12.6% | |||||
Gin 未进入该调查榜单,但它是 Go 生态最流行的 Web 框架;FastAPI 是本次调查增速最快的后端框架之一,一年涨了约 5 个百分点。
入门选择:Python + FastAPI,跟 AI 协作写后端非常省心。
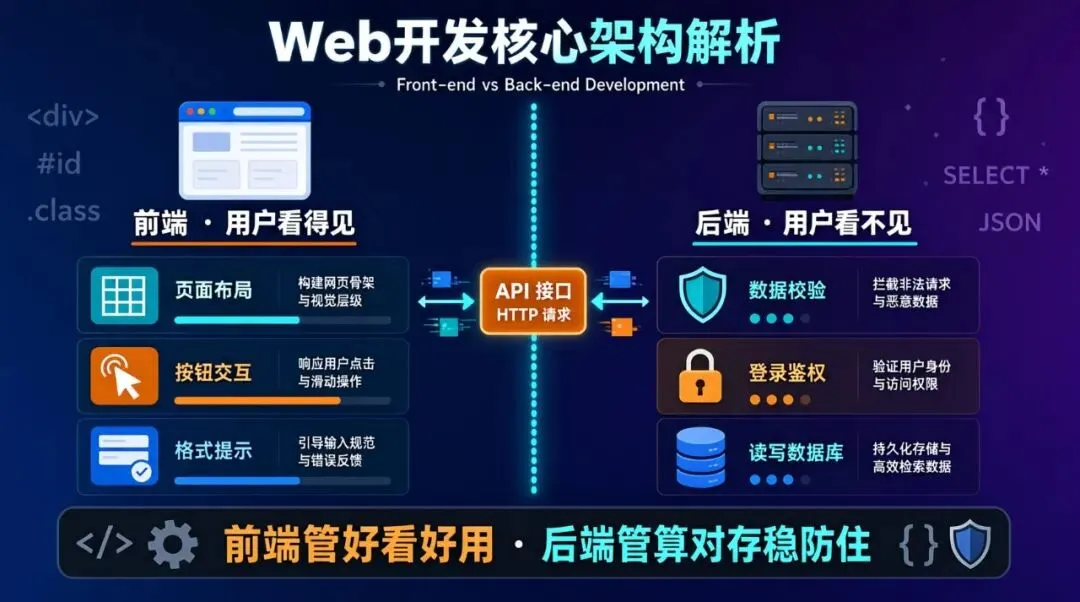
2.3 前端与后端的分工边界
| 后端 | ||
| 后端 | ||
| 后端 | ||
| 后端 + 数据库 |
记住这组分工:前端管「好看好用」,后端管「算得对、存得稳、防得住」。
三、数据持久化:数据存在哪
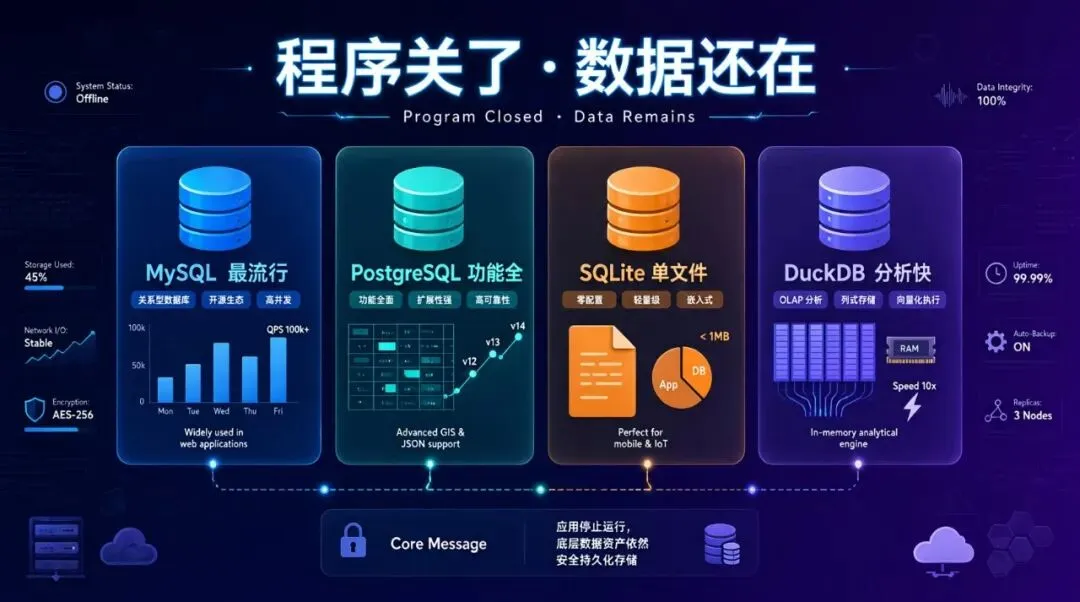
定义:把数据长久保存下来——程序关了、电脑重启了,数据还在。
不持久化会怎样:刷新页面登录状态没了、填了一半的表单清空了、昨天的记录今天找不到了。
实现方式:主要靠数据库;小型工具也可以直接存文件(JSON、Excel)。
3.1 什么叫关系型数据库?
数据库分两大流派:关系型和非关系型。日常业务系统里用得最多的是关系型,先把它的核心概念讲透。
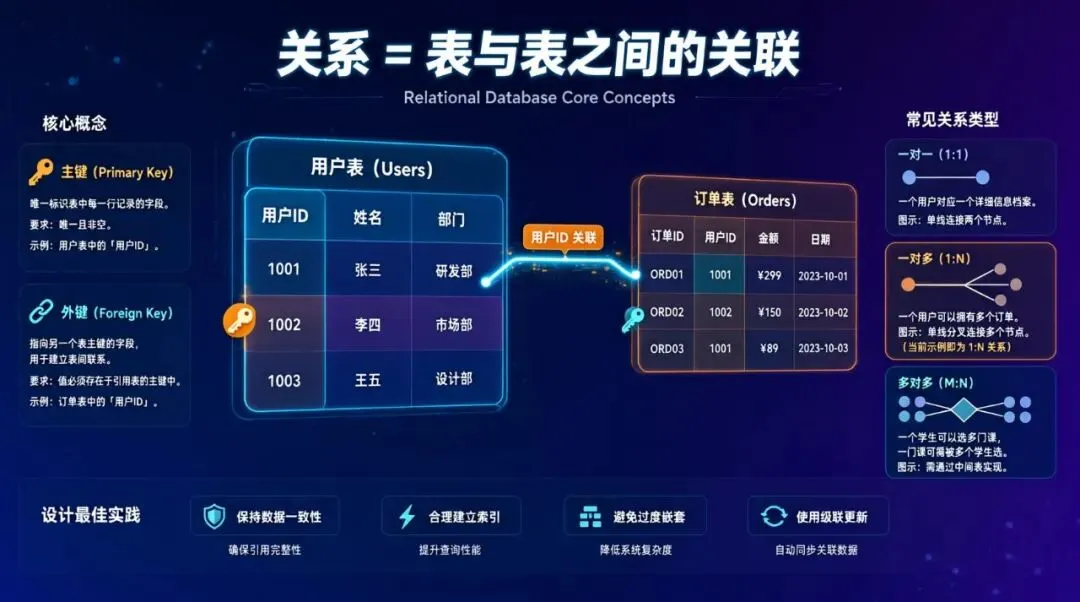
「关系」指的就是二维表——Excel 那种横平竖直的表。一张用户表长这样:
• 一行是一条记录,代表一个具体的对象:一个用户、一张订单、一台设备; • 一列是一个字段,描述对象的某个属性; • 关系型数据库的精髓在于表和表之间能关联:订单表里存一个「用户ID」,就能顺着它找到下单人的全部信息。数据之间靠 ID 相互引用,这种引用关系就是「关系」二字的来历。
这里澄清一个容易混淆的叫法:编程语言里「面向对象」的对象,指代码里「属性 + 方法」的封装体;数据库语境里的对象,通常指表里一行具体的数据(一个用户、一张订单)。同一个词,两个领域含义不同,听人聊技术时留意语境即可。
操作关系型数据库的语言叫 SQL,增删查改都是用它写的。
3.2 四大常用数据库对比(按市占率排序)
| 55.6% | ||||||
| 40.5% | ||||||
| 37.5% | ||||||
| 3.3% |
别看 DuckDB 市占率只有 3.3%,它是近两年增长最快的分析型数据库。SQLite 管日常存取,DuckDB 管分析查询,两者定位互补。此外还有 MongoDB(文档型)、Redis(缓存)等,按需再学。
3.3 怎么选
• 本地小工具、个人项目 → SQLite:一个文件就是一个数据库,零配置; • 一般 Web 业务 → MySQL 或 PostgreSQL:市占率最高的两个,遇到问题最好搜答案; • 复杂业务、数据分析 → PostgreSQL:功能最全面; • 数据分析、本地跑报表 → DuckDB:用 SQL 直接查 Excel 和 CSV,分析查询速度快。
四、接口与 API:前后端怎么对话
前端跑在用户的浏览器里,后端跑在远处的服务器上,两个世界靠 API 通话。
定义:API(Application Programming Interface,应用程序编程接口)是两个程序之间约定的「对话通道」——前端按约定发请求,后端按约定回结果。
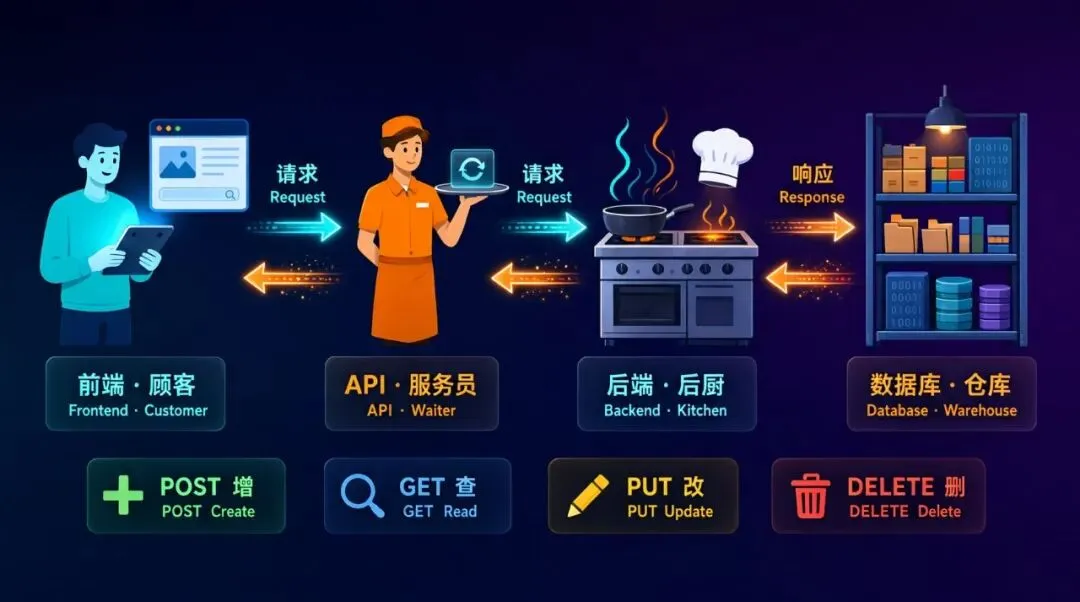
类比:像餐厅点餐——菜单是接口文档,服务员是 API,后厨是后端,端上来的菜是返回的数据。
4.1 一次 API 调用的完整流程
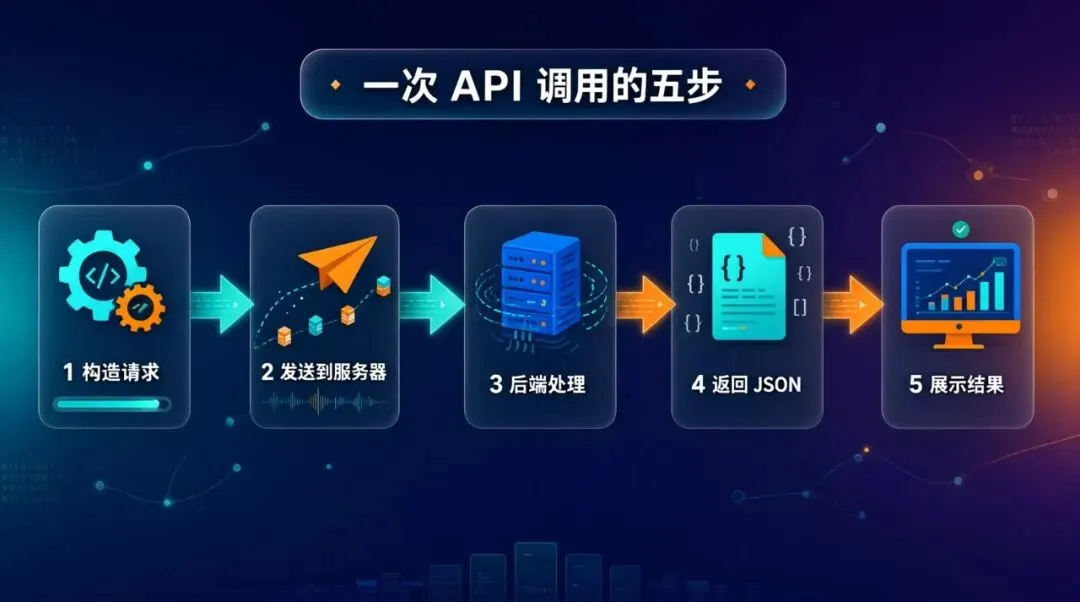
1. 前端按接口文档构造请求(URL + 方法 + 参数); 2. 请求发送到服务器(通常带 Token 验证身份); 3. 后端校验参数、处理业务、读写数据库; 4. 后端把结果(JSON)返回给前端; 5. 前端把结果展示给用户。
4.2 HTTP 与 HTTPS:明信片与挂号信
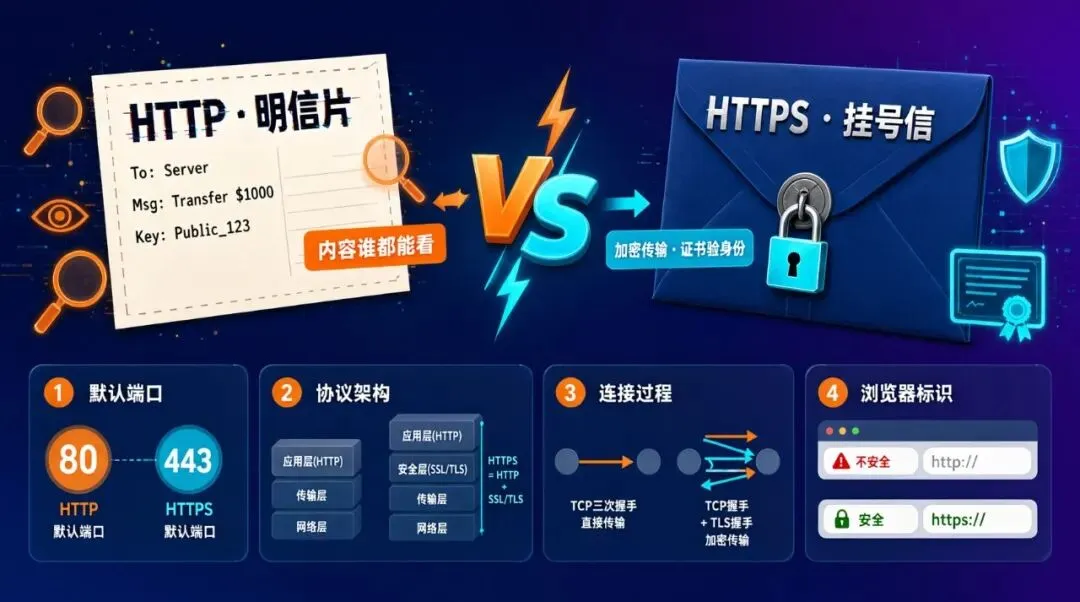
前后端对话用的协议叫 HTTP;HTTPS = HTTP + 加密(S 代表 Secure)。
• HTTP 像寄明信片:路上谁都能看到内容; • HTTPS 像寄密封挂号信:内容加密传输,并且有证书证明「对方真的是它声称的网站」。
现在正规网站全部使用 HTTPS,浏览器地址栏的小锁标志就是它的标识。密码、支付这类敏感数据,绝不能走明文 HTTP。
4.3 公钥、私钥与非对称加密:HTTPS 的数学底座
4.2 说 HTTPS 会「加密传输」,加密具体是怎么实现的?加密分两大门派:
对称加密:加密和解密用同一把钥匙。速度快(代表算法 AES),适合传输大文件;死结在于钥匙怎么安全地送到对方手里——快递钥匙的路上被截了,加密就白做了。
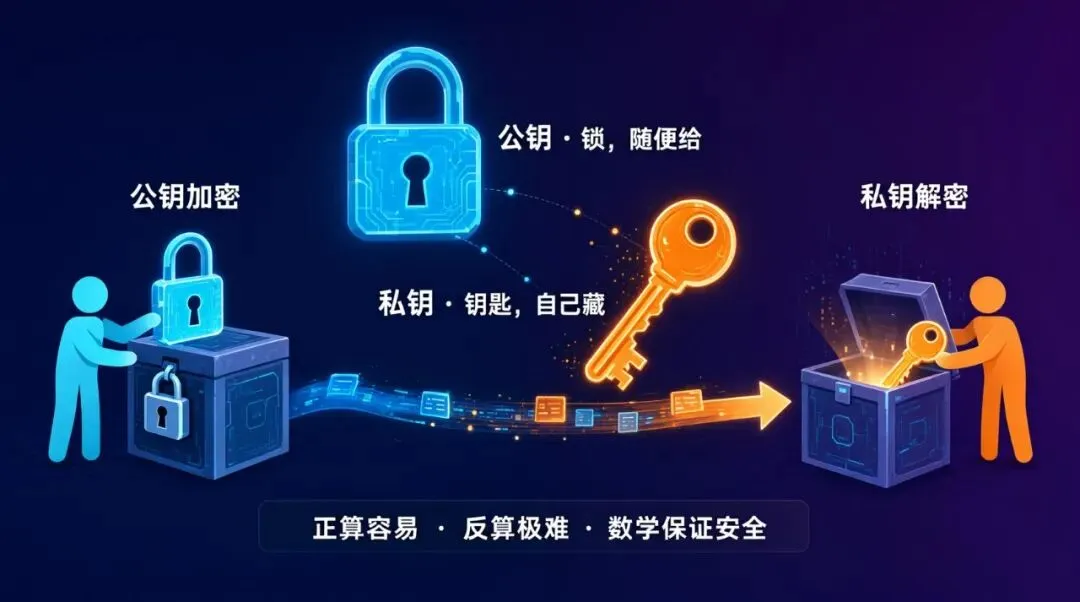
非对称加密:一把锁配两把钥匙——公钥和私钥:
• 公钥(public key):相当于一把打开的锁,随便发给任何人; • 私钥(private key):唯一能开这把锁的钥匙,自己藏好,绝不外传。
别人用你的公钥锁上的箱子,只有你的私钥能打开;反过来,你用私钥处理过的内容,所有人都能用公钥验证出自你之手——这就是「签名」,4.4 节数字证书防伪造靠的就是它。
为什么破解不了?它不靠「密码设得复杂」,靠数学上的单向性:以 RSA 算法为例,把两个大质数相乘非常快;反过来把乘积拆回两个质数,当数字达到 2048 位时,全世界的计算机一起算,耗时也远超宇宙年龄。正算容易、反算不可行,这就是安全的来源(量子计算机是未来的潜在威胁,业界已在推进「后量子加密」迁移,现阶段 RSA/AES 依然安全)。
HTTPS 的组合拳:非对称加密分发钥匙,对称加密负责干活——浏览器先用网站的公钥加密一个临时对称密钥发给服务器(只有服务器私钥能解开),之后的海量数据都用这个对称密钥传输,既安全又快。
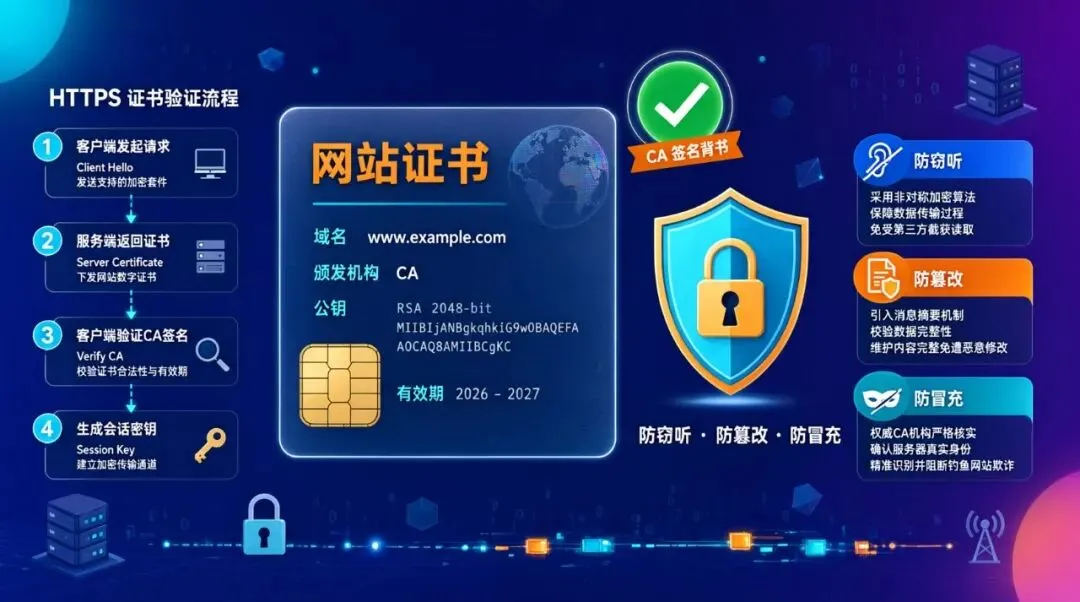
4.4 数字证书:HTTPS 的信任基石
证书是什么:由证书颁发机构(CA)签发给网站的一份电子证明,里面装着网站域名、颁发机构签名、公钥、有效期。HTTPS 加密握手的第一步,就是校验这张「身份证」。
证书和 4.3 节什么关系:证书里的「公钥」和「颁发机构签名」正是非对称加密的应用——网站把自己的公钥交给 CA,CA 用自己的私钥为它签名背书;浏览器拿到证书后,用 CA 的公钥验签,确认「这把公钥真的属于这个网站」。没有这一步,任何黑客都能伪造一把公钥冒充银行。
为什么需要它:明文 HTTP 有三宗罪——
• 被窃听:同一 Wi-Fi 下抓个包,你的密码看得一清二楚; • 被篡改:运营商可以在返回的页面里插广告; • 被冒充:假银行网站可以仿得和真的一模一样。
HTTPS 的证书机制同时解决这三件事:加密防窃听、签名防篡改、验身份防冒充。
怎么配置:
1. 选证书来源:个人和开源项目用 Let's Encrypt(免费、自动续期);企业正式业务向商业 CA 购买; 2. 在 Web 服务器(Nginx / IIS)或云负载均衡上配置证书文件和私钥,并把 80 端口的访问跳转到 443; 3. 公司内部自建系统的证书不被公共 CA 承认,需要给员工电脑手动导入信任(自签名证书)——这也是为什么打开公司内网系统有时会提示「证书不受信任」。
证书出问题的风险:
• 证书过期 → 浏览器全屏红色警告,用户大量流失,大厂也翻过这种车; • 用户在警告页点「继续访问」→ 数据等于明文裸奔; • 私钥泄露 → 攻击者可以解密流量、伪造官网搞钓鱼; • 程序不校验证书 → 会被「中间人攻击」,流量被第三方截走。
4.5 HTTP 方法与增删查改(CRUD)
CRUD = Create(增)、Read(查)、Update(改)、Delete(删),是后端最核心、最基本的四种数据操作。
POST /api/orders | |||
GET /api/orders/1001 | |||
PUT /api/orders/1001 | |||
DELETE /api/orders/1001 |
一切业务功能都是 CRUD 的组合:登录是查 + 比对(Read 用户表,比对密码);审批是查 + 改(Read 单据,Update 状态);导入 Excel 是增(Create 批量写入);数据清洗是查 + 改(Read 原值,Update 写回);报表统计是查 + 聚合(Read 数据后计算)。
把增删查改四个动作理解透,就等于掌握了后端的一半;剩下的一半,是把业务规则组合到这四个动作里。
4.6 API 鉴权:怎么证明「你是你」
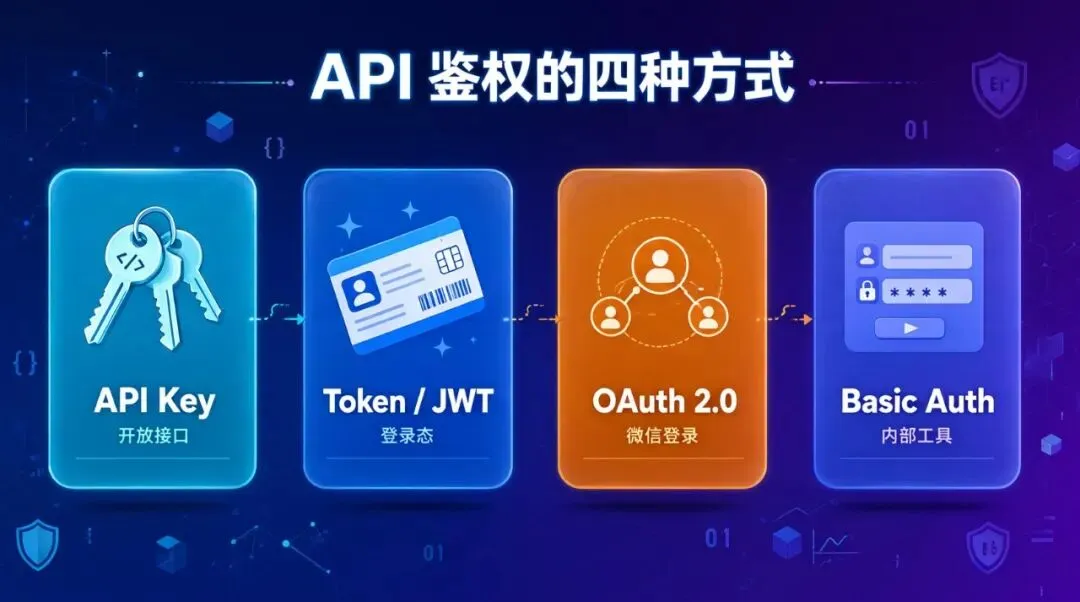
后端收到请求,第一件事是确认「谁在调用、有没有权限」——这就是鉴权。主流方式有四种:
| API Key | |||
| Token / JWT | |||
API Key 的三条铁律:不写死在代码里、不传到公开仓库、只走 HTTPS 传输。Key 泄露的后果不是「资料被看」,是「别人拿你的额度消费」——大模型 API 被盗刷,基本都是 Key 管理不当。
4.7 HTTP 状态码详解:报错时先看它
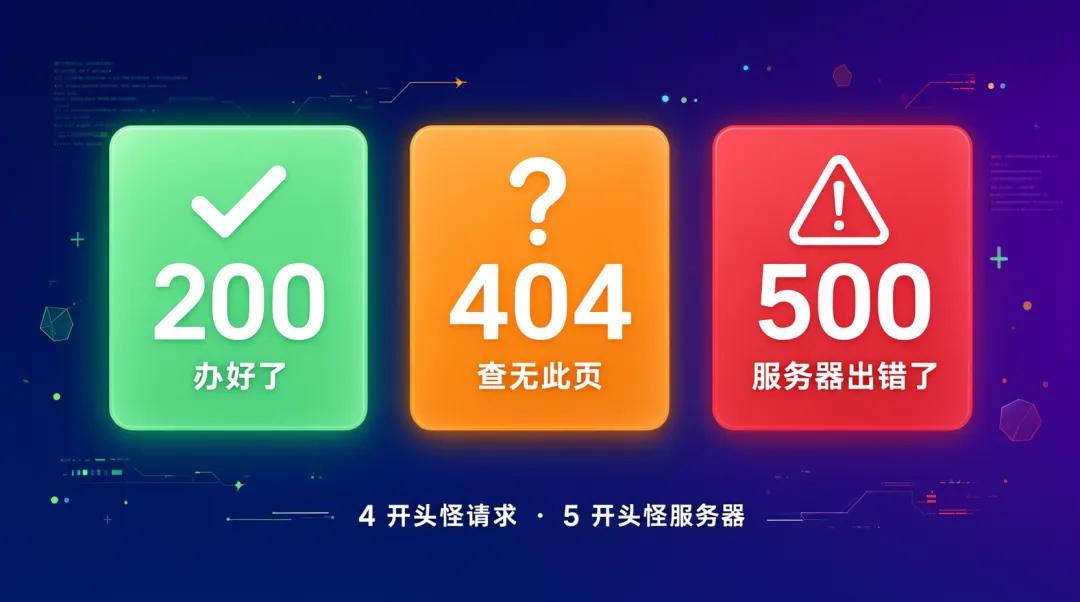
每次请求,服务器都会回一个三位数状态码。排查问题时先看它,能立刻判断该找谁:
记忆规则:4 开头,问题出在请求方;5 开头,问题出在服务器。
五、网络基础:数据是怎么在世界上跑的
前面讲的是前后端怎么对话,这一章把镜头拉远,看对话背后的网络世界。
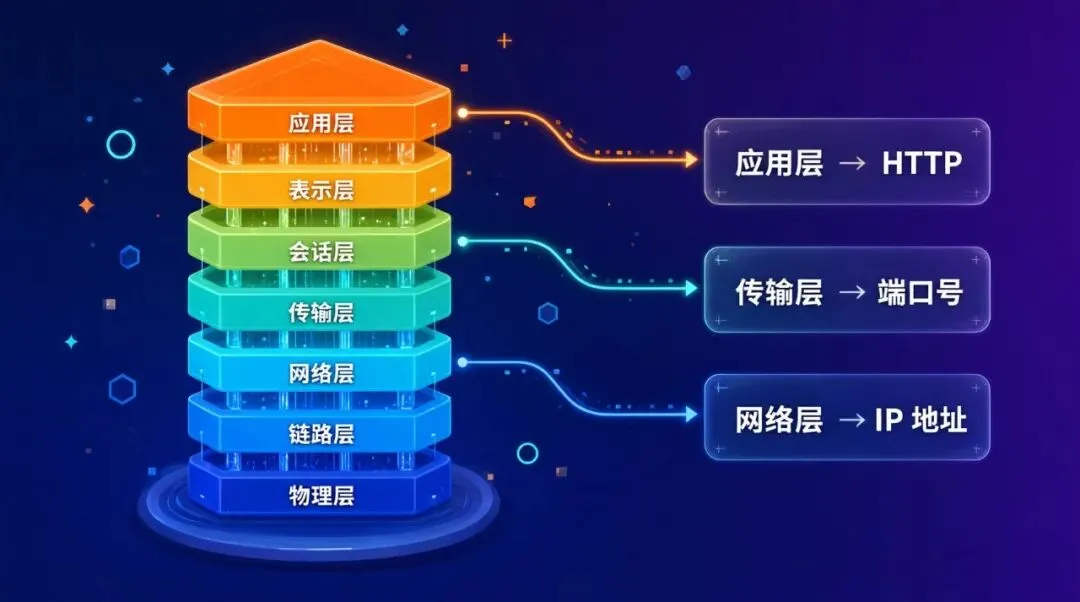
5.1 OSI 七层模型:每层在实际里对应什么
网络教材把通信过程分成七层(OSI 参考模型)。背定义没用,重要的是知道每一层在实际里对应什么东西:
| TCP | ||
| IP 地址 | ||
实际工程更常用简化的 TCP/IP 四层模型(应用层 / 传输层 / 网络层 / 网络接口层),把上面 5–7 层合并。七层记不住没关系,记住三样东西在哪一层就够用:域名和 HTTP 在应用层,端口号在传输层,IP 地址在网络层。
5.2 IP 地址详解:回环、内网、公网、管理地址
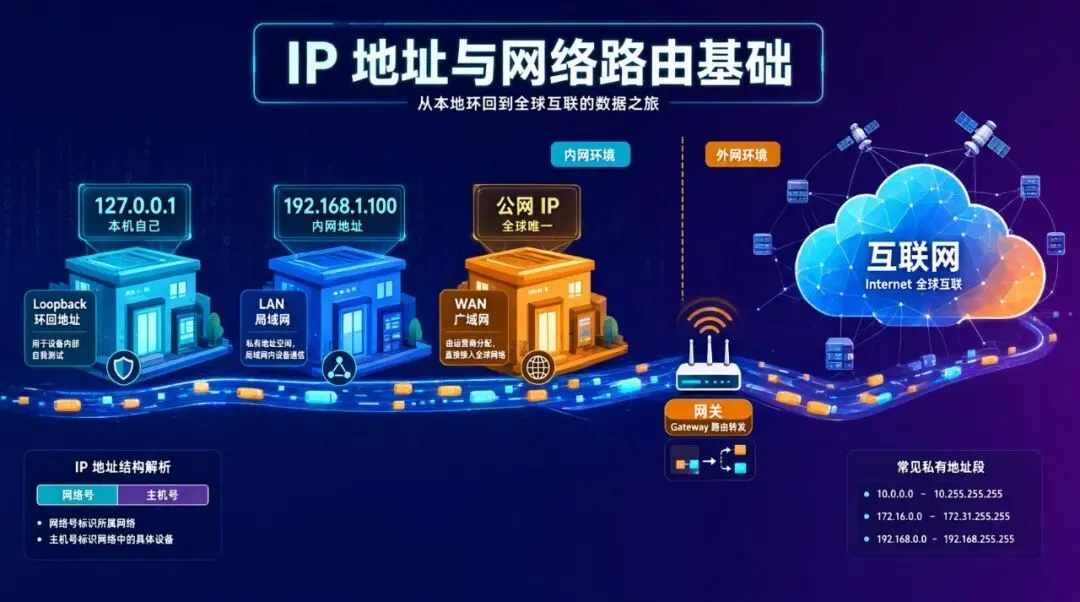
IPv4 地址是 32 位二进制数,通常写成四段(每段 0~255)。你天天打交道、但值得弄明白的几种:
记住结论:看到 192.168、10.、172.16~31 开头就是内网地址;127 开头是本机自己;其余的才可能是公网地址。
IPv6 是下一代地址:128 位,写成 2001:db8::1 这样的格式,地址多到号称能给地球上每粒沙子分一个,用来接替已经耗尽的 IPv4。家里多台设备现在还能上网,是因为大家共享一个公网 IPv4 出口——这个共享机制叫 NAT,5.5 节展开讲。
5.3 子网掩码:谁跟我是一个局域网的
子网掩码(如 255.255.255.0)用来划分 IP 地址里哪段是「小区名」(网络号)、哪段是「门牌号」(主机号)。
两台设备的网络号相同,就在同一个局域网里,可以直接互访;不同就要经过网关绕行。举例:192.168.1.100 和 192.168.1.200(掩码 255.255.255.0)是一家人,192.168.2.100 就是隔壁小区了。
5.4 网关:局域网的大门
局域网里的设备要访问外面(比如打开百度),数据必须先经过网关——家里通常就是路由器。它把内网设备的请求转发到公网,再把回程数据送回来。内网与公网之间的进出,都走这扇大门。
5.5 NAT:IP 地址不够用的破局之道
5.2 节说过,IPv4 只有约 43 亿个,早就不够全球设备分。但你现在家里五六台设备同时上网毫无压力——靠的就是 NAT(Network Address Translation,网络地址转换)。
NAT 干的事:路由器把内网设备的「内网 IP + 端口」改写成「公网 IP + 新端口」再发出去,回程数据按自己记的一张对照表改写回来、交给对应的设备。对外,全世界只看到你家那一个公网 IP。
现在的上网,其实要过两层 NAT:
• 第一层在你家:手机、电脑都是 192.168.x.x 的内网地址,出门时路由器统一换成宽带线路的 IP; • 第二层在运营商:公网 IPv4 连运营商都不够分,很多宽带拿到的并不是真公网 IP,而是 100.64.x.x开头的运营商大内网地址,出去时运营商再做一次转换(叫 CGNAT,运营商级 NAT)。你的请求实际走的是「家庭内网 → 运营商大内网 → 互联网」两道转换。
NAT 解决的问题:让成百上千台设备共享一个公网 IPv4,硬是把 IPv4 的寿命延长了二十多年。代价是两个副作用:
• 只许出去、不许进来:外面无法主动连接你家里的设备——这正是 5.9 节内网穿透要解决的问题,也是远程访问家里 NAS 需要配置「端口映射」的原因; • 对外难以区分是谁:出口只显示共享的公网 IP,同一出口下的成百上千人无法直接区分(运营商留存有映射记录,可供依法调取)。
IPv6 普及后每台设备都有全球唯一地址,理论上不再需要 NAT——但出于安全和管理考虑,NAT 在 IPv6 时代依然会保留使用。
5.6 DNS 与 CDN:电话簿与就近仓库
DNS(域名系统)负责把域名翻译成 IP 地址:www.baidu.com → 某台服务器的 IP。电脑只认 IP 不认域名,所以 DNS 出故障的典型症状是:QQ 能上(直接连 IP),网页打不开(域名翻译不出来)。
CDN(内容分发网络)解释了「网站为什么快」:你在北京打开抖音,图片多半不是从千里之外的机房传来,而是从离你最近的缓存节点拿到。CDN 把网站的静态资源提前复制到全国乃至全球各地,用户就近取用——相当于把仓库的货铺到各地便利店。
5.7 端口与监听:为什么要关注端口号
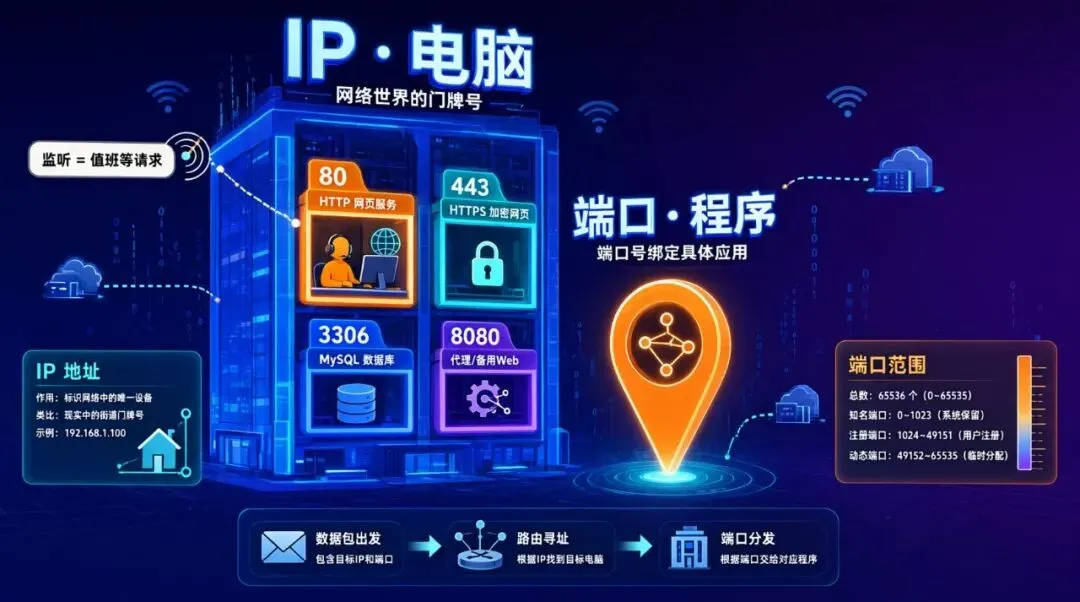
IP 定位到「哪台电脑」,端口定位到「这台电脑上的哪个程序」。端口号范围 0~65535,192.168.1.100:8080 表示这台电脑上跑在 8080 端口的服务。
为什么要关注端口号?三个实际场景:
1. 服务起不来:提示 port already in use,说明端口被别的程序占了,得找到占用者或换端口;2. 安全:对外开放一个端口就多开一扇门。勒索病毒正是通过 445(文件共享)、3389(远程桌面)这类端口大规模传播的; 3. 远程访问与内网穿透:必须明确「访问哪台机器的哪个端口」。
「监听」是什么意思:程序启动后在某个端口上值班等待请求,这个动作叫监听(listen)。监听地址有讲究:
• 监听 127.0.0.1:8080→ 只有本机能访问,安全,适合开发调试;• 监听 0.0.0.0:8080→ 所有网卡都在等,局域网里其他设备也能连上。开发完忘了关,等于在局域网里开了个无人值守的服务。
查看谁占用了端口:netstat -ano | findstr 8080(Windows)。
常用端口号速查表(面试和排障都高频):
5.8 防火墙详解:入站、出站与实际设置
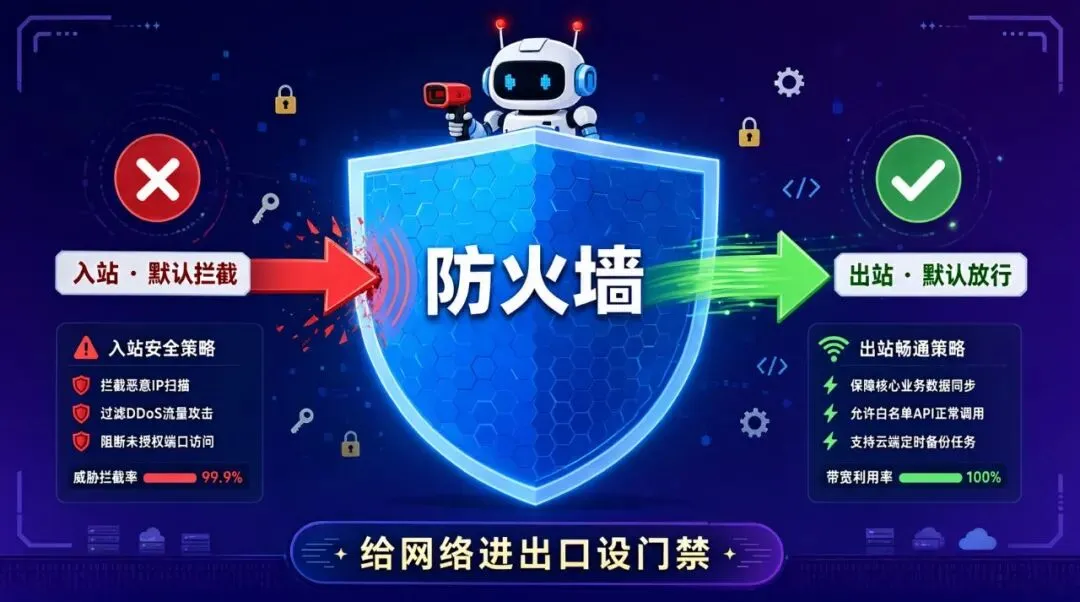
防火墙按规则决定「哪些流量放行、哪些拦截」,是网络的守门员。Windows 自带防火墙、公司机房有硬件防火墙、云服务器有安全组,本质都是同一件事:给网络进出口设门禁。
两个方向,规则完全不同:
• 入站(Inbound):外部主动连进来——同事访问你电脑上的服务、外网扫描你的端口。这是风险方向,默认拦截; • 出站(Outbound):你主动连出去——打开网页、连接数据库。默认放行(不放行连网都上不了;公司会额外管控出站)。
个人最常见的四个防火墙问题,对号入座:
1. 本地起了服务,手机或同事连不上 → 入站规则没放行。Windows 程序首次联网会弹窗问「是否允许访问网络」,当时点了取消,就一直在拦; 2. 局域网里搜不到别人的共享文件夹或打印机 → 对方 445 端口的入站被拦; 3. 某个软件死活连不上网 → 出站规则把它拦了; 4. 重装系统后远程桌面连不上 → 3389 端口入站没放行。
公司场景:公司出口架设企业级防火墙,策略与家用相反——默认全部拦截,按申请逐条开放。所以「我在本地起的服务为什么同事访问不了」「为什么连不上某个外部接口」,第一反应应该是找网络管理员确认端口是否已开放,而不是反复重装软件。云服务器同理:阿里云、腾讯云控制台里的「安全组」就是云端防火墙,新开的服务器往往只放行了 22/3389/80/443,自己部署的服务要先去控制台放行对应端口。
Windows 防火墙怎么设置:
1. 打开「设置 → 隐私和安全性 → Windows 安全中心 → 防火墙和网络保护」; 2. 简单场景:进入「允许应用通过防火墙」,勾选你的程序,注意区分「专用」和「公用」网络; 3. 精确到端口:「高级设置」→ 入站规则 → 新建规则 → 选「端口」→ 填端口号(如 8080)→ 允许连接 → 建议只对「专用网络」生效 → 命名保存。
三条设置原则:默认拒绝、按需最小开放、用完及时关闭。
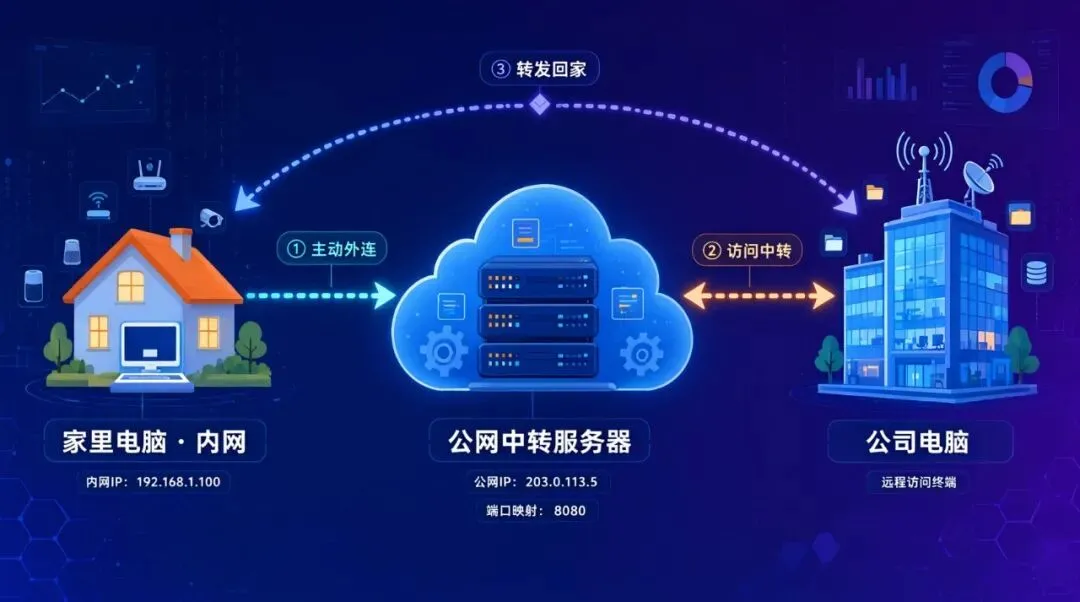
5.9 内网、公网与内网穿透
• 公网 IP:全球唯一,任何人都能直接访问到它(云服务器就有一个); • 内网 IP:只在局域网内有效(192.168.x.x、10.x.x.x),外面访问不到你家里的电脑。
5.5 节说过,NAT 默认「只许出去、不许进来」——家里电脑上跑了个服务,外面天然够不着。人在公司想访问怎么办?这就要用内网穿透。
内网设备没有公网 IP,外网找不到它;内网穿透的思路是借一台有公网 IP 的服务器当中转站:
1. 家里电脑主动连上公网中转服务器(主动往外连不受防火墙入站限制); 2. 公司电脑访问中转服务器; 3. 中转服务器把流量转发给家里电脑。
常见工具:frp(开源自建)、花生壳(开箱即用)、Tailscale / Cloudflare Tunnel(新派方案,连组网都省了)。典型场景:远程访问家里的 NAS、本地开发的网站临时给客户演示、远程调试设备。
补充区分:VPN 和内网穿透解决的是两类问题——VPN 是你从外面安全地加入一个内网;内网穿透是让外面的人够到内网里的某个服务。
5.10 代理与 WebSocket(进阶选读)
• 正向代理:代理客户端。你访问不了某网站,找台中间服务器替你去访问,对方看到的是中间服务器(公司上网网关就是这个思路); • 反向代理:代理服务器。你访问的其实是大门,后面几台真实服务器在干活,你不需要知道细节。Nginx 是代表:转发请求、负载均衡、统一挂 HTTPS。
区分方法:正向代理对客户端透明,反向代理对服务端透明。前者藏客户端,后者藏服务器。
WebSocket 解决「服务器主动推送」的问题。普通 HTTP 一问一答,问完就断;聊天室、行情刷新、协同编辑需要服务器随时主动发消息,WebSocket 在一次握手之后保持长连接,双方随时都能发消息——HTTP 像打电话问一句挂一句,WebSocket 像一直在线的对讲机。
5.11 两个实例:数据到底经过了什么
实例一:在家用手机打开淘宝
1. 手机向 DNS 服务器查询 www.taobao.com的 IP(应用层);2. 浏览器与服务器的 443 端口建立 TCP 连接(传输层),随后完成 TLS 握手、校验数字证书(表示层); 3. HTTP 请求从手机经 Wi-Fi 发出(物理层/链路层)→ 家里路由器做第一层 NAT 转换,把内网 IP 换成宽带 IP 出门(网络层)→ 运营商再做第二层 NAT(CGNAT)→ 运营商骨干网 → 淘宝 CDN 节点返回图片视频(就近取用)→ 动态请求到达数据中心 → 负载均衡分发给某台后端服务器 → 后端查数据库、渲染数据、原路返回; 4. 手机收到响应,渲染出页面。
整条路径:手机 → 家里路由器(网关/NAT)→ 光猫 → 运营商 → CDN / 数据中心 → 服务器,每一跳都对应七层模型里的若干层。
实例二:在公司访问业务系统
• 办公电脑接入公司交换机,位于公司内网(通常用域账号登录,由域控统一管理权限); • 访问公司内部系统:流量不出公司,直达内网服务器; • 访问外部网站:流量经过上网行为管理(审计、过滤)→ 企业防火墙(按出站策略放行)→ 出口 NAT → 互联网; • 外部用户访问公司对内发布的系统:请求先到公司防火墙,只有明确放行的端口(如 443)进得来,再由反向代理转发给内网真实服务器——内网结构对外完全不可见。
这两个例子,把 IP、网关、DNS、CDN、端口、防火墙、代理、证书全部串了起来。
5.12 网络概念速查卡(建议收藏)
127.0.0.1 | |
192.168.x.x10.x.x.x | |
192.168.1.1 | |
六、开发工具链与部署:程序写完之后
6.1 终端、CLI 与 VS Code:开发者的工作台
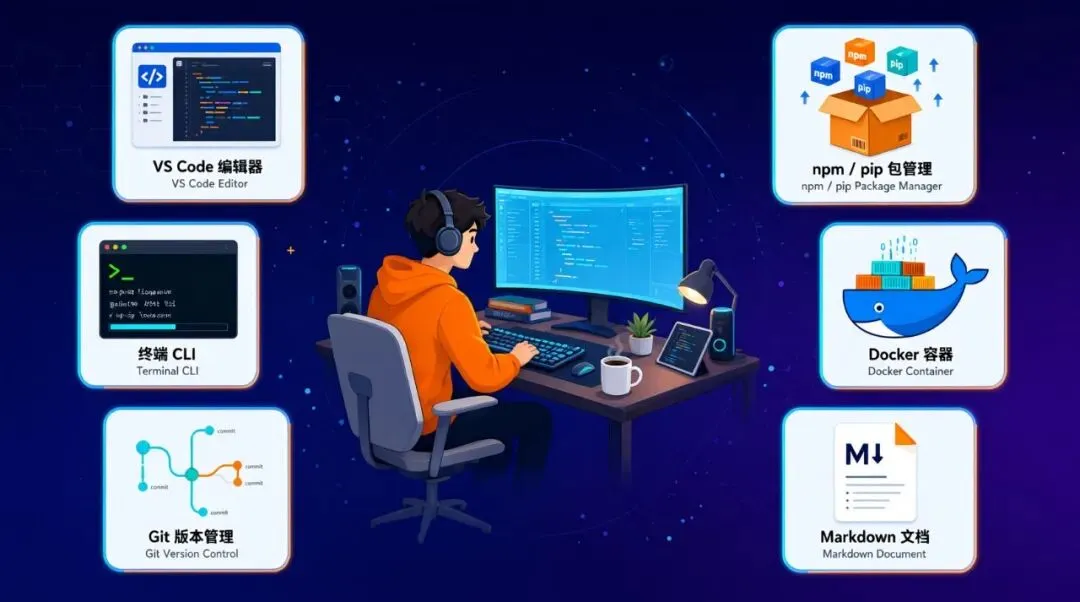
• 终端(Terminal):用文字命令操作电脑的界面,输入一行命令、回车、出结果; • CLI(命令行界面):程序通过文字命令交互的方式。终端是「窗口」,CLI 是「窗口里跟程序说话的方式」。服务器一般没有图形界面,只能靠 CLI 操作; • VS Code:微软的免费开源代码编辑器,全球最流行——写代码、调试、内置终端、Git 可视化,一个全包。
三者的配合:在 VS Code 里写代码 → 内置终端里敲命令(Git / npm / 脚本)→ AI 编程插件边写边帮。VS Code 是办公桌,终端和 CLI 是跟电脑说话的方式。
6.2 基础工具链
6.3 Docker:容器是什么,用不用
Docker 是容器化技术:把「应用 + 运行环境 + 依赖」打包成一个容器,在任何机器上一键运行,解决「在我电脑上明明是好的」这个经典问题。
按场景决定用不用:
Docker 是按需引入的工具,新手先把功能跑通。
6.4 部署形态对比
七、总结:一条链看懂软件全流程
前端(给人看)→ API(传话)→ 后端(处理事)→ 增删查改(操作数据)→ 数据库(存数据)→ 返回展示
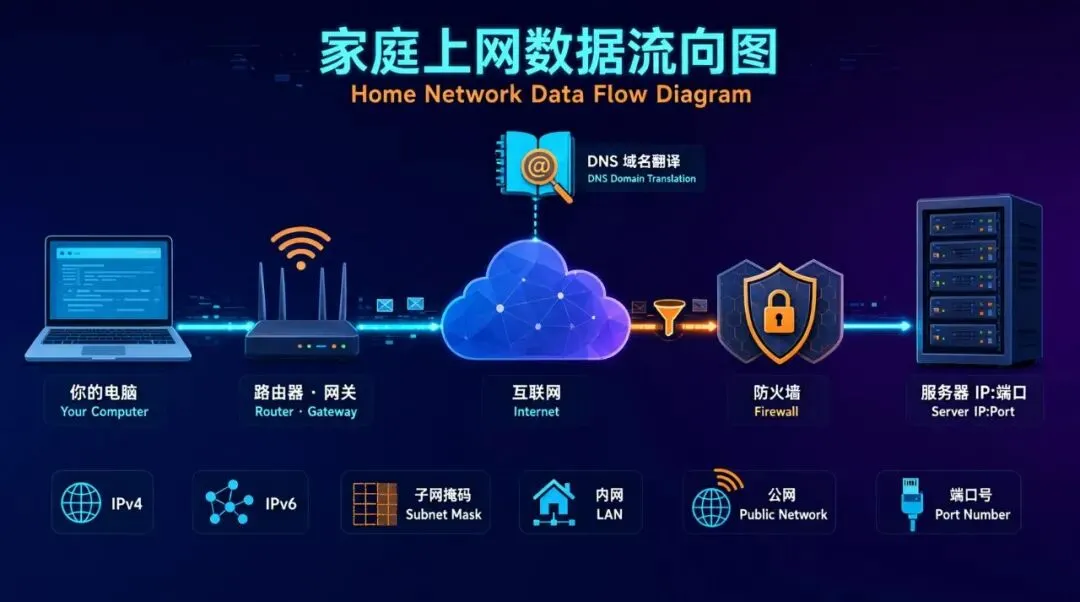
配上网络视角再看一遍:请求从你的设备出发,经过网关出门、DNS 翻译域名、CDN 就近加速、穿过防火墙,抵达服务器(IP:端口),后端处理完再原路返回。
学习路径建议:
1. 先学 Python + 前端三件套,能写重复脚本、做简单网页; 2. 用 AI 把一个小功能完整跑通:「需求 → 实现 → 验证 → 使用」; 3. 再按需补概念:数据库怎么存、API 怎么连、框架怎么写大项目、网络怎么通; 4. 更复杂的需求,交给 AI 编程工具继续加速。
(完)