ARTICLE · 1150110
AI 时代,测试用例才是一等公民
AI 时代,测试用例才是一等公民做测试这些年,我听过最多的一句话是: 三个问题,像三道关卡。而过去很长一段时间里,"写用例"和"写自动化脚本"是两件事:用例写在 Excel 里,脚本写在 IDE 里,中间隔着一个既懂业务又懂框架的测试开发。 但最近做的一个尝试,让我对这件事有了新的体感: 测试用例从来不是测试工作的"文档",它本身就是测试工作的核心。在 AI 时代,一条写得足够好的测试用例,可以直接是给 Agent 的提示词,也可以几乎无损耗地变成可执行的测试代码。 今天把这个过程和思考分享给大家。 先看我们项目里的一个真实案例。 这是一条网络设备的测试用例,存在 Excel 里,和大多数公司的用例没什么两样——标题、分组、步骤描述、预期结果: 用例标题:TCP单链接逐包发送_修改MTU_进程模式 
步骤描述长这样: 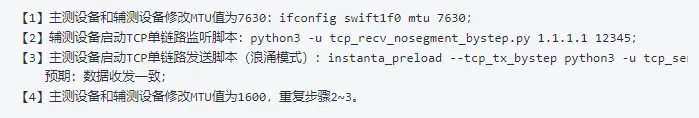
非常普通的用例,对不对?但经过我们固化下来的一套转换规则(在 Trae 里以 Skill 的形式存在),它生成了这样一份 Robot Framework 脚本: 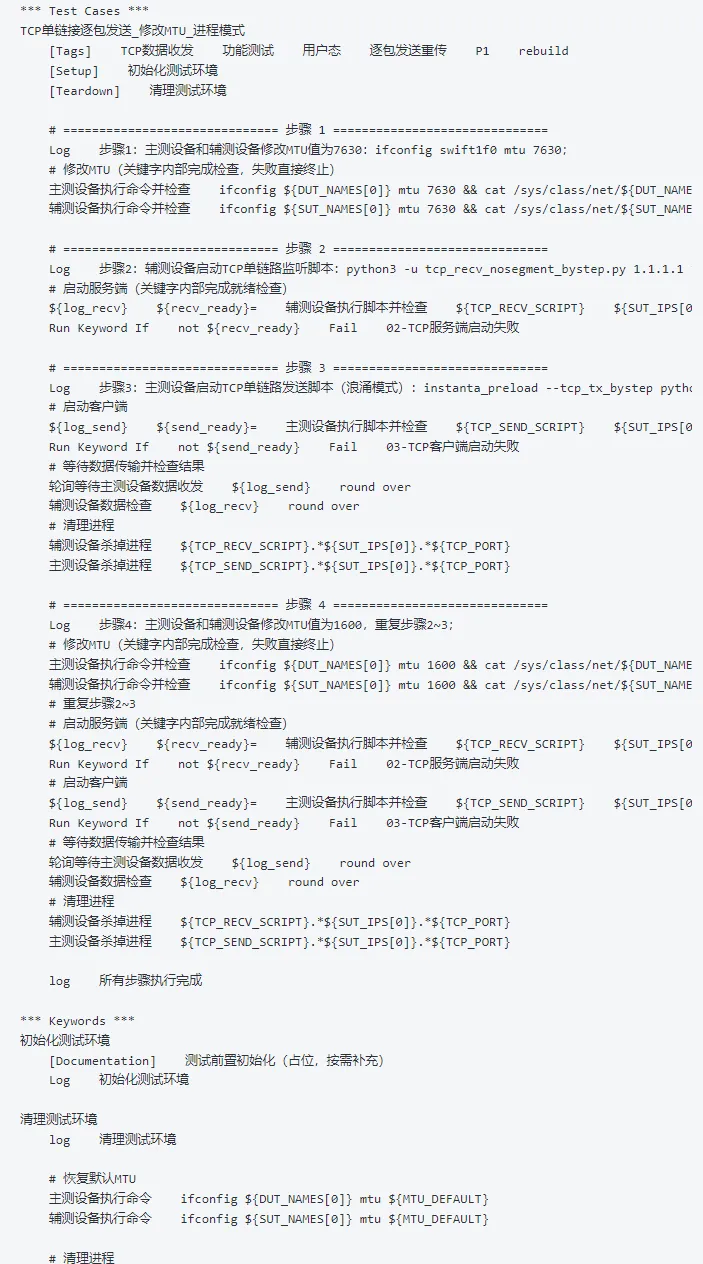
它们之间的关系,已经不是"需求文档"和"代码实现"的关系了,更像是一句话的两种说法。 我们逐行对比一下:
看出规律了吗? 动词几乎没有被翻译。"启动脚本"对应"执行脚本并检查","监听"对应检查 Listening on,"数据收发一致"对应检查 round over。主语也保留了——主测设备、辅测设备,原样出现在关键字里。 被替换掉的只有两类东西: 环境相关的具体值:IP、端口、网卡名,变成了变量; 自然语言里的预期:"监听成功""收发一致",变成了程序可判定的字符串。 而这两件事,恰恰是有明确规则可循的。规则一旦固化,转换就是机械劳动——机械劳动,就是 AI 最擅长的部分。 我现在越来越确信一句话: 这里有个问题:你们这个转换,换个框架行不行? 理论上都行,但 Robot Framework 让这件事的成本低到了一个夸张的程度。原因藏在它的两个设计基因里。 第一个基因:关键字驱动——把"做什么"和"怎么做"彻底分开。 Robot 的脚本看起来不像代码,更像在调用一个个"动词"。而这些动词是我们自己用 Python 封装的,并且可以直接用中文命名: 主测设备执行命令并检查——SSH 登录、执行、抓回显、比对字符串,失败直接终止,全在关键字内部; 主测设备执行脚本并检查——自动 nohup 后台拉起、生成唯一日志、检查进程存活、检查业务就绪标志; 主测设备杀掉进程——内部就是pkill -f,但使用的人不需要知道。 框架层面有一个金字塔: 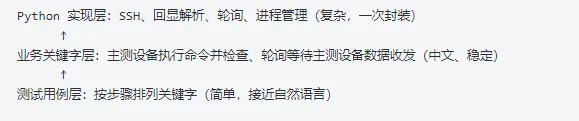
测试人员(或者 AI)写用例时,只需要在最上面一层"选词填空",永远不需要下探到底层。关键字的命名质量,决定了用例和脚本之间的距离。当关键字直接用业务语言命名时,这个距离趋近于零。 第二个基因:表格语法 + 自然语言——脚本的语法本质就是"关键字 + 参数"。 Robot 的一条语句,语法上就是: 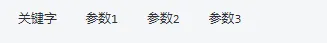
没有类、没有继承、不需要任何编程范式。关键字名可以是中文,变量统一是 ${名字},注释就是 #。这意味着: Excel 表格里的一行步骤,天然对应 Robot 里的一行语句; 用例里的"步骤与预期一一对应",天然对应 Robot 社区推崇的one-step-one-check(一步一检查); 甚至连"重复步骤2~3"这种描述,都可以朴素地处理——把那几行代码复制一遍,不需要循环、不需要封装,可读性和用例完全对齐。 所以传统自动化最耗时的部分——"把脑子里的业务操作翻译成代码"——在这套结构里退化成了按规则做映射。 我们不妨拆解一下,以前"用例自动化"的成本到底花在哪: 学框架、学语法; 理解用例背后的业务意图; 逐行编写脚本; 调试环境差异(IP、端口、网卡名); 长期维护,用例一改脚本就过期。 关键字驱动 + 变量化,把 1 和 4 摊薄到了一次性投入;而 AI 把 2、3、5 几乎打没了。 我们做的事情,本质上是把"一位资深测试开发看到用例后的翻译直觉"写成了一份规则说明书(Skill),包括: 关键字白名单:只能用封装好的十几个简化关键字,禁止裸写底层命令; 映射表:ifconfig 改 MTU →执行命令并检查;.py监听脚本 →执行脚本并检查 expects=Listening on; 变量替换规则:swift1f0→${DUT_NAMES[0]},裸 IP →${SUT_IPS[0]},裸端口 →${TCP_PORT}; 版式约束:每个步骤前加注释、步骤内联、重复步骤直接复制代码。 AI 拿到一份新用例,要做的就只剩模式匹配。生成完再跑一遍 robot --dryrun,语法正确性自动兜底。 这时你会发现一件很有意思的事:一条"好提示词"的特征,和一条"好测试用例"的特征,几乎是同一组词。 目标明确; 步骤原子化; 每一步都有可判定的成功标准; 输入具体(值是多少、在哪个设备上执行); 有前置、有清理、可重复执行。 这不就是提示词工程里讲的清晰指令、可验证结果、边界条件吗? 所以"测试用例作为 Agent 提示词"不是一个比喻。把上面这条 TCP 用例直接交给一个有设备执行权限的 Agent,它就是一份完整的任务书:第一步做什么、检查什么,第二步预期看到什么,失败了怎么报错,结束后怎么恢复 MTU、清理进程——用例自己就把 Agent 干活的SOP写完了。 一条用例,从此拥有了三种身份: 经过这轮实践,我们反过来给用例设计提了一组更苛刻的要求。我把它总结成一张小清单: 1. 步骤原子化,一步只做一件事。 "改 MTU、启动监听、启动发送"必须拆成独立步骤,揉在一句话里,人和 AI 都没法执行。 2. 步骤和预期严格一一对应。 预期不能写"功能正常",要写成可判定的事实:日志里出现round over、回显里出现7630。不可判定的预期,等于没有预期。 3. 操作主体明确。 是"主测设备"还是"辅测设备",还是两者都做,不能留歧义。 4. 命令和参数具体化。 给得出真实命令、具体数值(7630,不是"一个较大的 MTU"),执行器才不需要猜。 5. 环境依赖变量化。 IP、端口、网卡名在用例里可以写示例值,但要能被规则稳定识别和替换。 6. 可重复、可清理。 重复步骤怎么处理、结束后恢复什么配置、杀掉哪些进程,都要交代清楚。 坦白说,这套标准不新鲜——它就是测试工程讲了很多年的"好用例"标准。**AI 没有改变用例的审美,它只是让"不达标"的代价变得肉眼可见:**用例差一口气,生成的脚本就差十行补丁;用例写得完美,转换就是一键的事。 这件事再往前走一步,画面是这样的: 测试同学在用例平台上勾选几条回归用例,点击"执行"。后台自动完成转换、语法校验、排队、下发设备、跑完回传报告。用例评审通过的那一刻,它就已经是"自动化就绪"状态——不再有排期里那个叫"自动化开发"的独立环节。 测试人员的精力,会被真正释放回测试最值钱的部分:场景设计、风险分析、边界与异常、用户视角的探索。而不是反复把同一段业务逻辑,从 Excel 翻译到代码里。 我不敢说所有类型的测试都能走到这一步,复杂的性能、稳定性场景还有很长的路。但至少在有明确步骤、有明确预期的功能和协议测试领域,这个趋势已经在发生了。 测试这行,用例是根。 脚本、框架、平台不是硬核资产,框架会换、语言会换、AI 会一代代更迭,但"在什么条件下、做什么操作、应该看到什么"这三件事,永远是测试的本体。 AI 没有让测试用例贬值,恰恰相反—— 当用例可以直接被 Agent 读懂、被框架执行,它第一次从"给人看的文档",变成了整个质量体系里可以直接驱动执行的一等公民。
"这个功能测了吗?用例写了吗?自动化了吗?"
01 一条 Excel 用例,是如何"长"成测试脚本的
02 用例和脚本之间,已经薄得像一层纸
Excel 里的用例描述 | Robot 脚本里的语句 |
主测设备和辅测设备修改MTU值为7630 | 主测设备执行命令并检查 ... expects=7630(主、辅各一条) |
辅测设备启动TCP单链路监听脚本 | 辅测设备执行脚本并检查 ... expects=Listening on |
主测设备启动TCP单链路发送脚本 | 主测设备执行脚本并检查 ... expects=connected to server |
预期:数据收发一致 | 轮询等待主测设备数据收发 ... round over + 辅测设备数据检查 ... round over |
重复步骤2~3 | 把步骤 2、3 的代码原样再来一遍 |
1.1.1.1 / 12345 / swift1f0 | ${SUT_IPS[0]} / ${TCP_PORT} / ${DUT_NAMES[0]} |
如果一条测试用例需要测试开发"发挥一下"才能写成脚本,那问题往往不在脚本,而在用例写得还不够好。
03 为什么是 Robot Framework?因为它天生"说人话"
04 AI 时代,转换成本是怎么塌下来的
给人评审的文档、给 Agent 的提示词、给自动化框架的代码源码。
一份资产,三处复用。