ARTICLE · 1154190
给AI技能做安全体检:OpenClaw集成腾讯AIG,恶意用例识别率达98.6%
前面几期聊过"Agent 安全"(Open Shell、身份认证、控制平面)。今天这条更具体——怎么给"AI 技能/插件"做安全审查。
01 发生了什么:两个扫描器 + 一个 AI 评审
OpenClaw 宣布,将腾讯混元 AI-Infra-Guard(AIG)集成到开源命令行安全审查工具 ClawScan。
它的用途: 对 ClawHub 上所有技能与插件做安全审查。
机制很有意思——"双扫描器 + AI 评审":
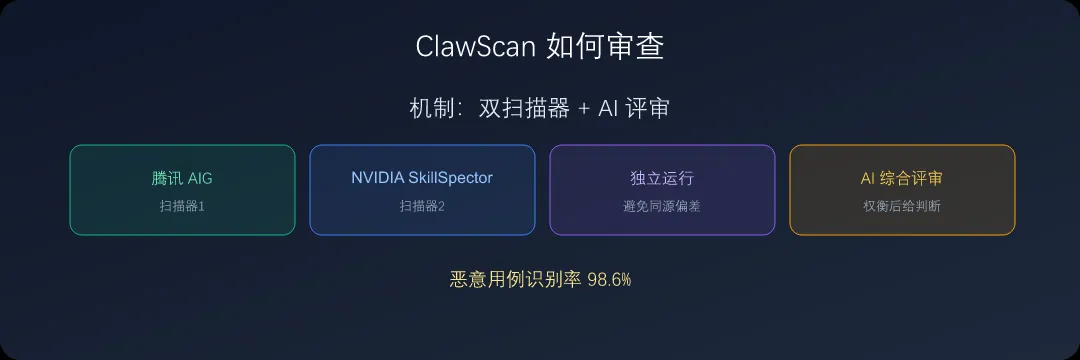
- • AIG(腾讯混元) 与 NVIDIA SkillSpector 两个扫描器独立运行
- • 再由 AI 评审综合两者的发现,给出最终评估
效果(在 SkillTrustBench 的 556 个固定用例上):
- • 与基准标签匹配率 86.9%
- • 恶意用例正确分类率 98.6%
为什么"98.6% 恶意用例识别率"值得关注?
因为 AI 技能/插件的安全问题很特殊:
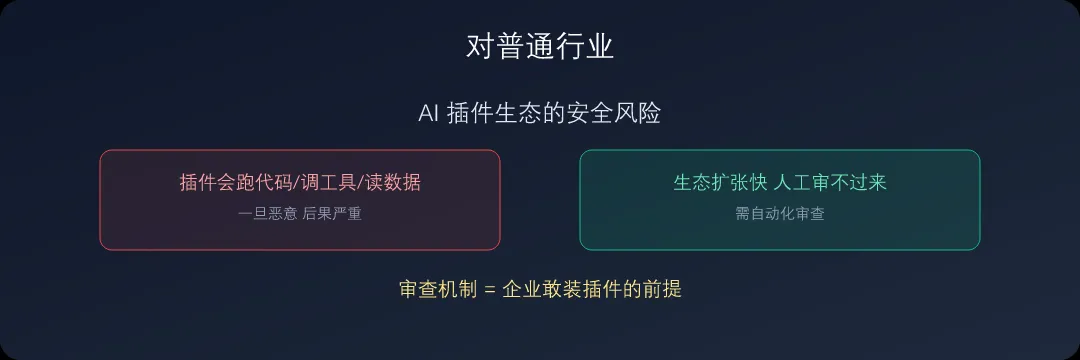
- • 插件会"跑代码、调工具、访问数据"——一旦是恶意的,后果严重
- • 生态扩张快(OpenClaw 刚新增 50+ 插件、合作 Notion/Canva/Dropbox 等)
- • 人工审查跟不上——技能数量增长远快于安全团队
"用 AI 审 AI"+"两个扫描器交叉验证"的思路,正好解决了"审查吞吐量"这个问题。
02 对普通行业的影响:AI 插件生态的"质量门槛"在建立
这条新闻,对"要用 AI 插件/技能"的企业是重要保障。
现在的现实是: AI 平台都在开放插件生态(ChatGPT 应用市场、OpenClaw 插件、各类 Agent 连接器)。
这带来一个新问题:谁来保证插件是安全的?
消费者维度想一下就知道风险:
- • 一个插件要求"读取你的邮件权限"——它是真需要,还是在收集数据?
- • 一个技能声称"帮你自动下单"——它会不会偷偷改价、乱花钱?
ClawScan 这类工具的意义在于:
- • 给插件建"准入审查"——上架前先过安全关
- • 给出可量化的信任指标(98.6% 恶意识别率)
- • 让企业敢装插件——有了审查机制,才能放心扩展能力
一句话:AI 生态从"能装更多插件"走向"装的插件是安全的"——这是生态成熟的前提。
03 对程序员的影响:"AI 审 AI"成为安全工程的标准范式
对技术人,这条新闻给了一个可直接借鉴的工程范式。
"双扫描器独立运行 + AI 评审综合"这个结构,值得记住:
① 独立运行——避免"同源偏差"(一个工具漏了,另一个可能发现) ② 交叉验证——两个结果对比,提升可信度 ③ AI 综合评审——不是简单"取并集",而是让 AI 权衡后给判断
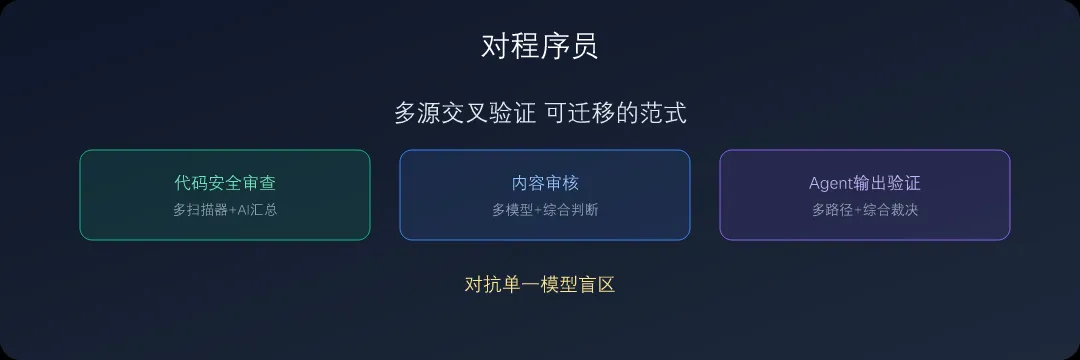
这套思路可以迁移到很多场景:
- • 代码安全审查(多个扫描器 + AI 汇总)
- • 内容审核(多模型 + 综合判断)
- • Agent 输出验证(多路径验证 + 综合裁决)
对程序员的启示: 呼应前几期——"AI 安全"正在从"单点防御"走向"体系化工程"。 而"多源交叉验证"是其中最重要的设计模式之一,因为它天然对抗"单一模型的盲区"(回到 9/3 那条"6比0 漏检"的教训)。
一句话总结
OpenClaw 集成腾讯 AIG 到 ClawScan,用"双扫描器独立运行 + AI 评审综合"审查 AI 技能——恶意用例识别率 98.6%。对普通行业,是 AI 插件生态的"质量门槛"在建立、企业敢装插件了;对程序员,是"AI 审 AI + 多源交叉验证"成了安全工程的标准范式。
📌 影响与可跟进行动
影响
- • AI 插件/技能的生态扩张带来安全审查需求,自动化审查成为生态准入的必要环节。
- • "多扫描器交叉验证 + AI 综合"成为对抗单一模型盲区的标准工程范式。
可跟进行动
- 1. 企业:引入 AI 插件前,先确认平台是否有类似的安全审查机制,或自行做准入筛查。
- 2. 开发者:在安全敏感的系统里,采用"多源交叉验证"设计(多扫描器/多模型),而非依赖单一工具。
- 3. 插件开发者:主动了解平台的审查标准,把"可被安全审查"作为开发要求之一。
- 4. 建立可量化指标:为你的安全流程定义"识别率/误报率"指标,用数据衡量,而非凭感觉。
👇 觉得有收获,点个「在看」。
关注「科技洞察助手」,AI 安全这条线我持续追,下一篇拆"AI 插件该怎么审查,一份可落地的清单"。
信源:无矩AI 10/5 速览、OpenClaw 官方。数据基于公开口径;影响分析为综合判断。