ARTICLE · 1154613
AI如何推动科学发现以及为什么验证仍是最大瓶颈
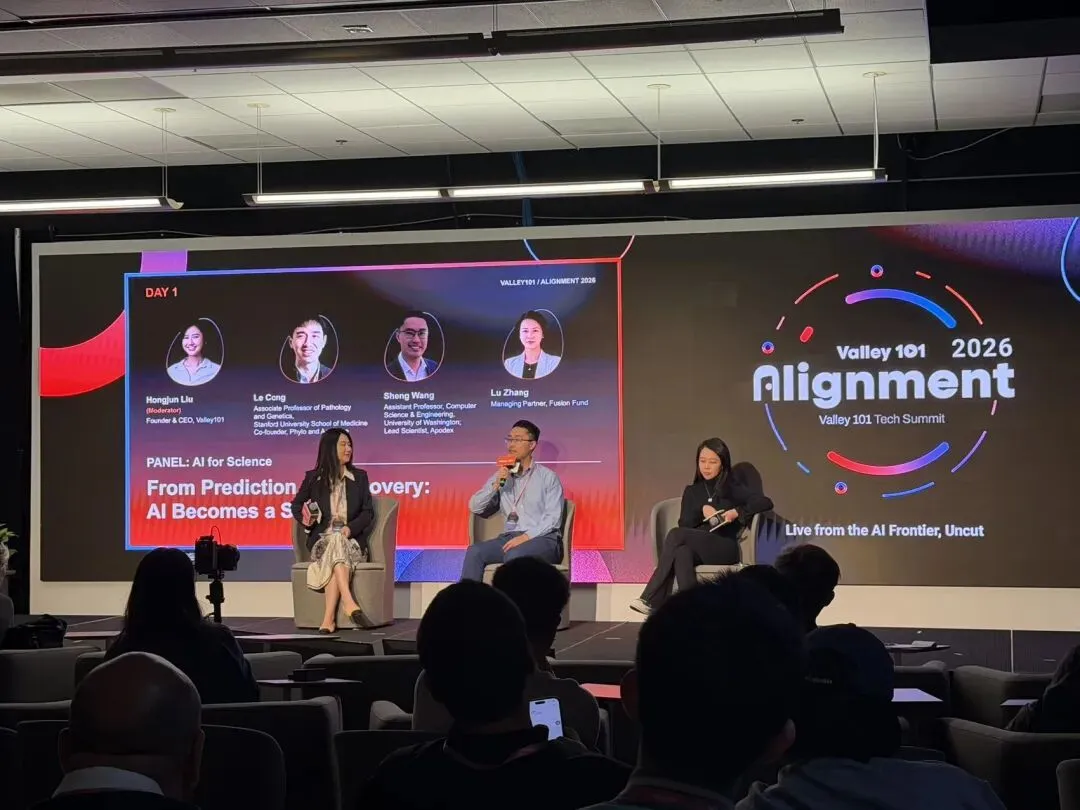
今天来参加硅谷一零壹举办的线下大会,有很多个分会的主题,这个是AI for since也是现在最火的一个讨论项目,AI能承担哪些工作,哪些环节仍离不开人类科学家;两者如何协作、怎样判断一项发现是否成立——这些问题也都得到了一次深入而具体的探讨。把内容录音总结录下
AI如何推动科学发现,以及为什么验证仍是最大瓶颈
这场圆桌讨论聚焦于 AI在生物医学和科学研究中的作用。与会者认为,AI正在从“预测工具”逐渐变成能提出假设、设计实验的研究伙伴;但真正限制AI科研落地的,往往不是模型算得不够快,而是后续的实验验证太慢、太贵,也缺少可供模型学习的高质量数据。
一、讨论背景:从预测走向科学发现
主持人以 Anthropic 模型识别出一种类似 CRISPR 的系统 ART 为引子,讨论这是否代表AI已经开始真正发现科学规律。
与会者整体上对AI识别新候选对象并不意外。他们认为,计算机可以快速搜索大量数据、发现人类难以察觉的模式,尤其适合那些可以相对快速验证的问题。
但“模型在21小时内找到候选对象”并不等于“21小时内完成科学发现”。这个数字通常只代表计算阶段,背后还包括:
* 人类如何定义问题、准备数据和设定搜索范围;
* 研究者如何判断候选结果是否有意义;
* 实验室如何验证候选对象;
* 后续如何弄清它的生物学功能,以及能否转化为实际应用。
因此,ART案例展示了AI缩短“提出候选发现”所需时间的能力,却不能单独证明其生物功能已被充分理解,也不能说明整个科研过程已经大幅缩短。
二、最大的瓶颈:从“发现候选”到“验证结果”
与会者反复强调,AI在计算层面的发现速度正在加快,但湿实验验证仍然需要大量时间和资金。生物医学研究尤其如此:一个模型给出的候选结果,仍需在实验室中进行检验;如果进一步进入药物研发,还可能涉及漫长的临床试验。
讨论中区分了两个环节:
1. AI发现:从数据中识别模式、提出候选机制或研究假设。
2. AI验证:设计实验、执行实验,并用结果判断假设是否成立。
当前AI在第一个环节进展较快;第二个环节难得多。AI不只是需要“给出一个答案”,还要能决定接下来做什么实验、怎样安排实验条件、如何控制预算、怎样根据实验结果调整下一步计划。
这更接近一个完整的“实验闭环”,而不是一次模型预测。讨论者认为,训练AI完成实验闭环的公开数据尤其不足,因此这项能力目前仍然困难。
三、为什么失败实验数据也很重要
生物医学领域有大量实验没有得到预期结果,但这些负面数据通常不会像成功结果那样充分发表或共享。
这会带来几个问题:
* 模型看到的研究结果偏向“成功案例”,难以学习哪些方向行不通;
* 不同实验室的数据分散在各自系统里,难以汇总;
* 失败实验可能包含有价值的信息,却缺乏标准化记录和共享机制。
与会者指出,几乎每个实验室都积累了失败实验数据,难点在于如何在保护隐私、知识产权和商业利益的前提下,把这些数据系统地整理和利用起来。
如果AI能够接触到成功与失败的实验结果,就可能避免重复试错,并更准确地规划后续实验。具备机器人和自动化能力的实验平台,也更容易在实验过程中完整记录条件、过程和结果,持续形成可用于训练模型的数据。
四、生物数据并不适合照搬大语言模型的扩展路径
讨论者认为,生物学数据与训练大型语言模型所使用的文本数据存在显著差异。生物数据的规模相对有限,来源分散,质量和格式也不统一。因此,目前不能简单假设:只要把模型做得更大、数据堆得更多,就会复制大语言模型的进步路径。
有与会者提到,在某些生物医学任务中,数据量小到简单的线性模型有时也能与深度学习模型竞争。这说明问题不仅是模型架构,也包括可用数据的规模、质量、代表性和实验产生速度。
讨论中对“生物领域会不会出现类似大语言模型的 scaling law(规模扩展规律)”持审慎态度:
* 如果未来能够收集足够多、高质量、可比较的生物数据,规模扩展规律或许会显现;
* 但目前数据规模和实验吞吐量都不足,不能据此确定模型单纯扩张就会带来相同收益;
* 生物数据可能比互联网文本更有针对性,因此小而专的模型也可能在特定任务上表现很好。
五、数据孤岛与潜在解决方式
生物数据往往分散在高校、医院、药企和各个实验室内部。由于隐私、知识产权和竞争关系,机构未必愿意直接集中共享数据。
讨论提到的解决方向包括:
* 联邦计算:数据保留在原有机构,模型或计算流程在不同数据持有方之间协作;
* 公共与私人机构合作:通过项目合作建设更大规模的数据资源;
* 标准化数据收集:让不同实验室记录的实验条件和结果更容易比较;
* 持续产生新数据:通过实验自动化形成质量更稳定、结构更一致的数据。
Biohub一类合作被视为可能的推动力量。讨论者认为,企业为提前获得这类数据或合作机会付费,买到的不只是数据本身,也可能是调整研发方向、建立内部能力的时间优势。即使数据未来会开放,提前一年使用也可能帮助企业更早试错、打磨模型和工作流程。
六、垂直AI公司与大模型公司的竞争
讨论中,多位与会者认为,目前生物医学AI更适合发展专用模型和垂直解决方案,而不是只依赖大型通用基础模型。
垂直AI的优势可能包括:
* 面向明确的生物医学任务,减少不必要的计算成本;
* 更容易嵌入药企、医院和实验室的现有流程;
* 可以与实验设备、自动化平台和机器人结合;
* 有机会在特定数据和特定工作流上形成更强的实际表现。
大型AI公司拥有强大的模型、算力和研发资源,但未必愿意投入长期资金去解决非常细分、周期漫长、需要深厚领域经验的生物医学问题。因此,前沿模型公司不一定会完全取代垂直AI公司。
不过,垂直公司的护城河也不只是“有一个专用模型”。与会者强调,更难复制的优势可能来自:
* 独有的高质量实验数据;
* 能够持续运行的验证体系;
* 对特定疾病或实验流程的专业知识;
* 将模型、实验室和临床研发流程真正连接起来的能力。
换句话说,数据和验证能力可能比模型本身更能构成长期竞争优势。
七、实验自动化与“物理AI”
投资人 Lu Jiang特别强调,AI与机器人结合后,可能从分析实验数据走向直接参与实验过程。例如,AI制定实验计划,机器人执行实验,系统记录结果,再由模型根据结果调整下一轮实验。
这类系统的价值在于能够形成反馈闭环:
模型提出假设 → 自动化设备执行实验 → 系统记录成功与失败 → 数据回流训练模型 → 模型改进下一轮实验
如果这个闭环能够稳定运行,它既能提高实验效率,也能产生竞争者不容易复制的专有数据。对创业公司而言,实验自动化因此不仅是节省人力的工具,也可能成为建立数据壁垒和模型优势的基础。
八、AI会取代科学家吗?
与会者普遍不认为AI会简单取代科学家。更可能发生的是科学分工改变:
* AI承担更多计算、模式搜索、预测和理论假设生成工作;
* 科学家负责判断问题是否值得研究、提出好问题、设计关键验证,并解释实验结果;
* 自动化设备承担部分重复性实验操作。
一位研究者用物理学作类比:AI可能更像提出理论的“理论物理学家”,人类更像负责实验验证的“实验物理学家”。未来研究成果和专利的署名、贡献认定可能需要重新讨论,但AI能否提出假设,并不意味着人类科学家的判断和验证工作就会消失。
九、对“AI发现”的谨慎态度
讨论最后还指出,AI专家和生物学专家看待AI发现时,关注点可能不同:
* AI研究者更容易关注模型是否能够泛化、是否从数据中发现了新模式;
* 生物学家可能更谨慎,因为不同生物系统和研究领域之间差异很大,某个领域有效的模式不一定能直接推广到另一个领域。
因此,对AI科研成果的评价不能只看模型是否找到一个看起来新颖的模式,也要继续追问:
* 这个模式是否能够重复验证?
* 它是否有清晰的生物学功能解释?
* 换一批数据或实验条件后是否仍然成立?
* 它能否产生真正可用的研究或临床价值?
结论
这场讨论的核心判断是:AI正在加快科学假设和候选发现的产生,但科学价值最终仍要经过实验验证。当前限制AI在生物医学中大规模落地的主要因素,包括湿实验速度、数据稀缺、失败实验数据缺失和机构间的数据孤岛。
接下来更值得关注的方向,可能是能够连接模型、实验室自动化和数据反馈的系统。真正有长期优势的公司,未必只是拥有最大模型的公司,也可能是能够持续产生高质量数据、快速完成验证,并把AI嵌入实际科研流程的团队。
一句话概括:AI已经能更快地提出“可能是什么”,但科研的关键仍在于能否高效、可靠地证明“它确实是什么”。