ARTICLE · 1167592
AI 工具体系:Operator Stack【芮博数理工场·TAO+AI+结构智能】专栏第7期
【编者按】
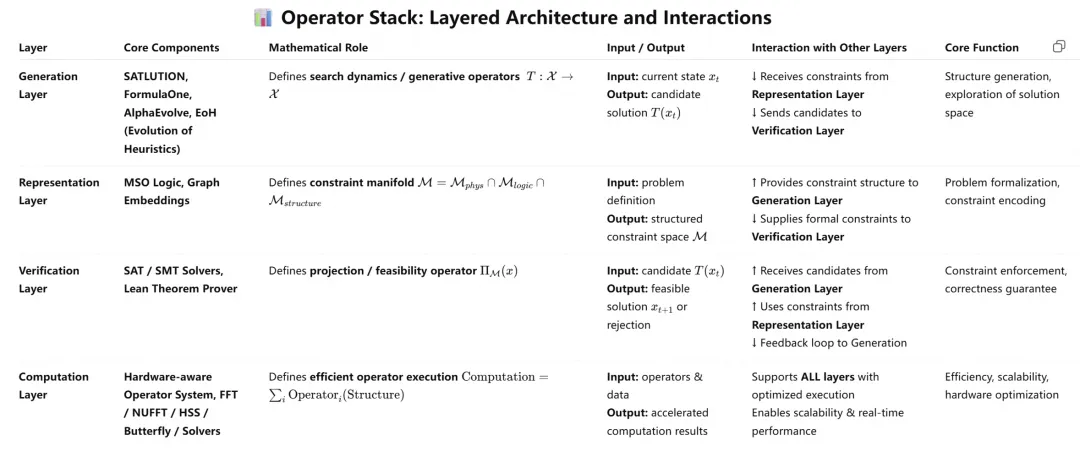
本文围绕SATLUTION智能优化框架,介绍其基于Operator Stack搭建的四层分层架构,全文依次拆解生成层、表达层、验证层、计算层,分别讲解解生成算法、数学建模工具、形式化验证手段与高性能计算算子,完整梳理整套框架的技术体系。
【观点摘要】
SATLUTION框架依托生成层与验证层的交替迭代闭环系统,能够确保求解结果满足全部约束条件,并持续迭代优化至最优解。
FormulaOne并非改良版演化算法,而是实现了从进化搜索到结构生成动力系统的技术跃迁,核心是能量驱动生成与约束投影的有机结合。
表达层通过单子二阶逻辑与图嵌入技术,将复杂问题的抽象结构和约束转化为标准化数学模型,为后续优化与验证提供核心支撑。
验证层依托SAT、SMT与Lean定理证明系统形成多层级校验体系,从布尔约束、复杂理论约束到形式化数学证明,全方位保障解的合法性与严谨性。
SATLUTION计算层通过硬件感知算子系统与自动化算法选择机制,动态匹配最优计算算子,最大化挖掘硬件算力价值,实现大规模约束优化问题的高效求解。
在现代AI架构中,Operator Stack 是指一系列按层次组织的计算单元,每一层都承担不同的计算任务,并逐步构建出最终的优化解。生成层是Operator Stack中的第一层,它负责生成潜在的解。通过逐步优化和结构化搜索,生成层探索解空间,寻找最优解。SATLUTION框架中的生成层与验证层共同构成了闭环系统,通过生成和验证的交替迭代,确保解满足所有约束条件,并优化至最优解。
一、生成层
生成层是SATLUTION框架中的基础层,其核心任务是探索解空间,并生成满足约束条件的解。生成层通常包括启发式算法、演化算法和其他搜索方法,以便在大规模、高维度的优化问题中有效地找到可行解。生成过程的结果是一个潜在的解,通过后续的验证层进行校验。
生成层的目标是将搜索过程从无序的、局部的搜索转化为有结构的、全局优化的过程,结合演化和启发式搜索方法,逐步逼近最优解。生成层的具体实现方式包括FormulaOne、AlphaEvolve算法和启发式进化。
1.1 FormulaOne
FormulaOne 是一种基于结构约束驱动的生成与验证统一框架,其核心思想不是通过随机演化逐步逼近解,而是通过显式建模约束结构、构造连续势能空间,并在生成–验证闭环中直接生成可行解。相比于传统演化算法,FormulaOne 更强调:

在SATLUTION框架中,FormulaOne 可以被理解为:
xt+1=V(G(xt))
即生成与验证的耦合动力系统。
(1)生成–投影过程(Generation–Projection Process)
FormulaOne 不再依赖“选择–交叉–变异”的离散演化,而是通过连续生成 + 约束投影实现结构生成,其核心过程由两个算子组成:
生成算子(Generation Operator):
生成过程由连续动力系统驱动:
xt+1=xt−η∇J(xt)
其中:
J(x):结构势能函数(见SATLUTION 6.3)
∇J(x):结构冲突梯度
η:步长
该过程本质是:
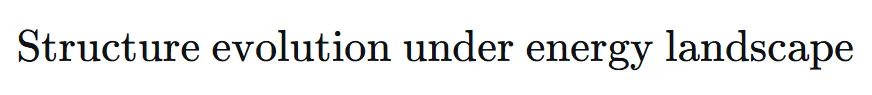
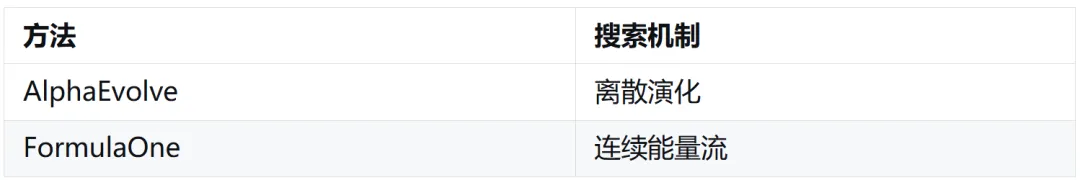
与 AlphaEvolve 不同:
AlphaEvolve:在离散空间中搜索
FormulaOne:在连续结构流形中演化
投影算子(Projection / Verification):
生成的连续解需要投影回可行结构:
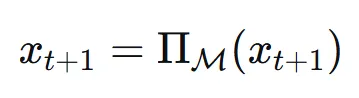
其中:
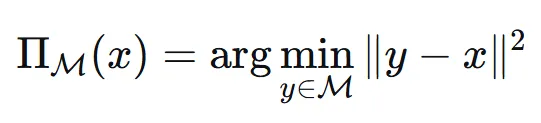
这一步等价于:
SMT求解(Z3)
定理证明(Lean)
或局部修复(repair)
统一形式:
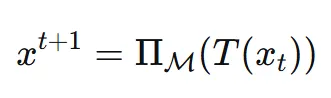
(2)结构势能与约束优化
FormulaOne 的核心在于将约束转化为势能函数:
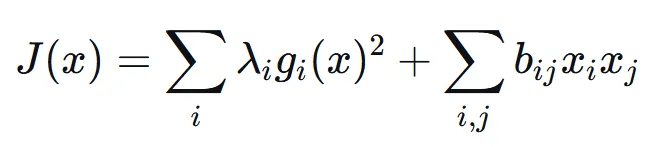
其中:
gi(x)=0:硬约束
bijxixj:冲突项
优化目标:
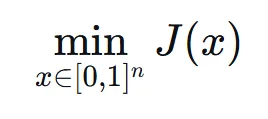
关键区别:
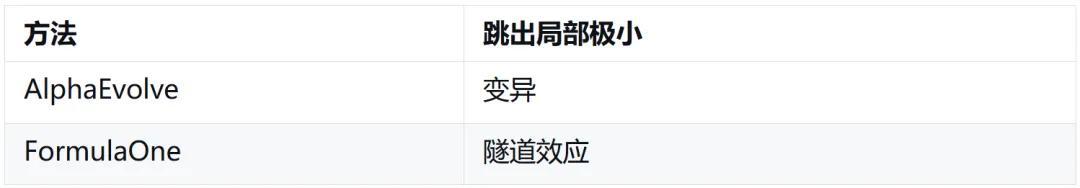
(3)隧道效应(Tunneling Mechanism)
为了避免陷入局部极小,FormulaOne 引入类似物理系统的隧道效应:
dxt=−∇J(xt)dt+σdWt
或:
p(x)∝e−J(x)/T
含义:
随机扰动 → 跨越能量屏障
温度 T → 控制探索强度
对比:
(4)可行性驱动优化(Feasibility-driven Optimization)
FormulaOne 的优化目标不是“最优解”,而是:
Feasible Structure First
即:
J(x)→0⇒x∈M
关键机制:
生成:降低能量
验证:保证约束
闭环:收敛
(5)核心差异总结
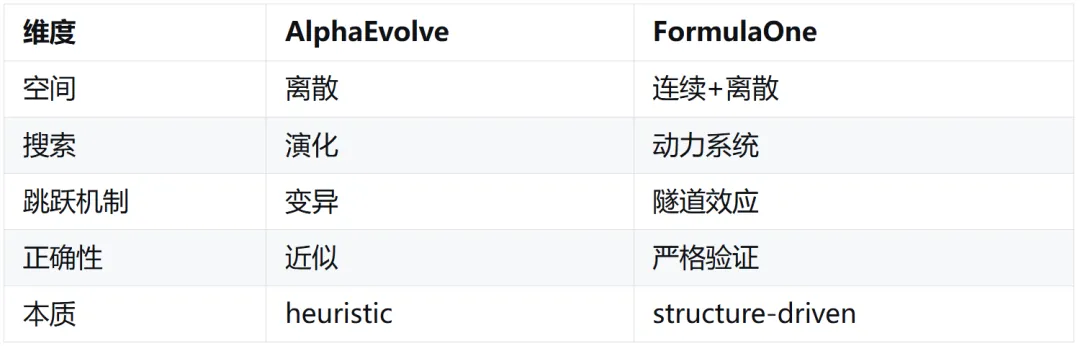
(6)核心结论
FormulaOne 不是“改进的演化算法”,而是从“进化搜索”跃迁到“结构生成动力系统”。
其本质可以总结为:

1.2 AlphaEvolve
AlphaEvolve 是一种基于演化算法(Evolutionary Algorithms,EA)的生成方法。它模仿自然选择的过程,通过选择、交叉和变异等操作生成新解,并逐代优化,逐步逼近最优解。在SATLUTION中,AlphaEvolve 作为生成层的重要组成部分,能够在大规模、复杂约束的环境下高效地进行搜索。
(1)演化过程
AlphaEvolve中的演化过程由三个基本操作组成:
选择(Selection):
从当前种群中选择表现最好的个体,通常根据适应度函数评估个体的优劣。例如,在SAT问题中,适应度函数可以表示为:
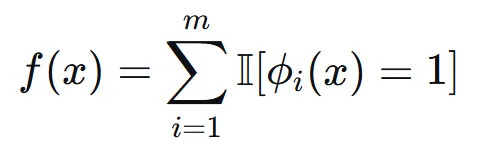
其中,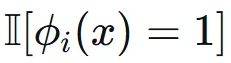 是指示函数,表示变量配置是否满足约束。
交叉(Crossover):
通过将两个亲本个体的特征进行组合,生成新的子代个体。交叉操作模拟了生物学中的遗传过程,是演化算法中重要的搜索策略。交叉操作的数学表示可以是:
xnew=Crossover(x1,x2)
其中,x1 和 x2 是亲本个体,xnew 是交叉得到的新解。
变异(Mutation):
在生成新个体时,随机改变某些基因位点,以增加解空间的探索能力。变异操作的数学表示为:
xnew=x+δ⋅N(0,σ2)
其中,δ 是变异强度,N(0,σ2) 是高斯噪声,模拟了解的随机变化。
(2)适应度函数与优化
演化过程中的适应度函数通常设计为目标函数与约束条件的组合。例如,在SAT问题中,适应度函数不仅考虑了目标函数(如布尔公式的符合度),还包括约束条件(如时序约束或功耗限制)。优化目标是最小化(或最大化)适应度函数,最终得到满足约束条件的最优解。
通过不断选择、交叉和变异,AlphaEvolve 能够在解空间中逐步探索,并最终收敛到满足约束的解。
1.3 Evolution of Heuristics(EoH)
similar to Model-based RL(交互迭代)
启发式进化(Evolution of Heuristics)是一种基于启发式方法的生成策略,它结合了传统的启发式搜索与演化算法。在这个过程中,启发式方法不仅用于生成潜在解,还通过不断优化启发式函数来引导解的生成。与AlphaEvolve类似,启发式进化也通过不断优化种群中的解来寻找最优解。
(1)启发式方法
启发式方法通过利用问题的特定结构来加速搜索过程。例如,在网络优化问题中,启发式方法可以利用网络的拓扑结构来选择最优路径;在调度问题中,可以利用任务之间的依赖关系来生成初步解。启发式方法通过设计一个启发式函数 H(x) 来评估解的质量:
H(x)=Evaluate(x)
其中,H(x) 表示解 x 的适应度,通常是目标函数与约束条件的综合衡量。
(2)启发式进化过程
启发式进化通过在生成过程中优化启发式函数来引导搜索,具体过程如下:
初始化: 生成初步解,并根据启发式函数评估解的质量。
优化: 通过演化算法(如遗传算法、模拟退火等)不断调整启发式函数的参数,以便在搜索空间中更有效地引导搜索。
局部搜索: 在生成解的过程中,结合局部搜索策略(如邻域搜索、局部梯度下降)进一步优化解。
启发式进化的核心优势在于,它能够利用问题结构信息加速搜索过程,而无需对解空间进行穷举式搜索。这使得启发式进化能够在大规模问题中有效地找到高质量的解。
(3)启发式函数的进化
在启发式进化中,启发式函数是一个动态调整的目标函数。通过演化操作,启发式函数不断被优化,以便更好地引导解的生成。例如,在多目标优化问题中,可以根据不同的目标调整启发式函数的权重,以便平衡不同目标之间的冲突。数学上,启发式函数的演化可以表示为:
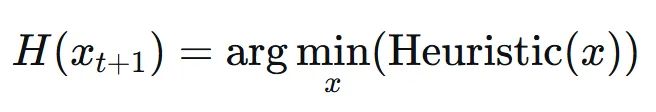
其中,Heuristic 表示启发式函数,xt+1 是更新后的解,目标是通过优化启发式函数来减少目标函数的值。
二、表达层 – 数学建模
在SATLUTION框架中,表达层是系统的核心组成部分之一,负责将问题的抽象描述、约束和目标函数转化为数学模型,为优化和验证层提供输入。在表达层,问题的结构性和约束通过更强大的数学表示形式(如MSO和图嵌入)被表达出来,这些方法在图论、逻辑推理以及大规模优化中有着广泛应用。表达层的设计使得SATLUTION能够更加精确地处理复杂的约束问题,特别是涉及到图结构、逻辑推理和高维数据表示的任务。
2.1 MSO:单子二阶逻辑(Monadic Second-Order Logic)
单子二阶逻辑(MSO)是对一阶逻辑(FOL)的扩展,允许对集合进行量化。MSO的强大之处在于它能够表达涉及到集合的约束,特别适用于图结构和复杂约束的建模。MSO比一阶逻辑更具表现力,因为它不仅可以量化个体(如节点),还可以量化集合(如图中的节点集或边集)。这使得MSO在图论、网络优化以及许多需要集合表达的任务中有着广泛应用。
(1)MSO的基本语法和表示
MSO扩展了传统的一阶逻辑(FOL),支持个体量化和集合量化。一阶逻辑公式可以表达个体之间的关系,而二阶逻辑则引入了对集合的量化,能够更灵活地描述复杂约束。具体来说,MSO的公式由以下几个基本部分构成:
个体量化: 例如 ∀x 或 ∃x,用于量化个体。
集合量化: 例如 ∀S 或 ∃S,用于量化集合。
MSO公式的基本语法可以表示为:
∀x ϕ(x)或∃S ψ(S)
其中,ϕ(x) 是一阶公式,表示个体 x 的性质或关系;ψ(S) 是二阶公式,表示集合 S 的性质。通过引入集合量化,MSO能够对复杂的集合约束进行建模,这使得它在描述图结构、网络拓扑等问题时更为有效。
(2)MSO在图问题中的应用
在图问题中,MSO可以用来表达图的结构性质,例如节点之间的连通性、路径的存在性、图的平面性等。我们可以利用MSO表达图的连通性和路径约束,并为SATLUTION提供高效的逻辑建模手段。
例如,假设我们有一个图 G=(V,E),节点集合 V 和边集合 E。我们可以使用MSO表达图中的路径约束,如下所示:
∃P ∀u,v (Path(P,u,v)⇒Connected(u,v))
在这个公式中,Path(P,u,v) 表示从节点 u 到节点 v 的路径 P,而 Connected(u,v) 表示节点 u 和节点 v 是连通的。通过MSO,我们能够准确地表达图中节点之间的连通性和路径约束,这对于许多优化问题(如最短路径、最大流、图着色等)具有重要意义。
(3)MSO与约束优化
在SATLUTION中,MSO不仅可以用来描述图的结构,还可以用于描述优化问题中的约束。假设我们在一个优化问题中需要满足某些结构性约束,这些约束可以通过MSO公式表达。例如,考虑一个图着色问题,我们可以使用MSO来确保图中每两个相邻节点的颜色不同:
∀x,y (E(x,y)→(C(x)≠C(y)))
在这个公式中,E(x,y)表示节点 x 和节点 y 之间有一条边,C(x) 和 C(y) 分别表示节点 x 和节点 y 的颜色。这个公式确保了每两个相邻的节点都有不同的颜色。
通过使用MSO表达式,SATLUTION能够将图结构问题与复杂约束(如图着色、最大流、图匹配等)有效结合,从而提高了问题求解的表达能力和灵活性。
(4)MSO潜在挑战:可微性问题
MSO 逻辑是离散且不可微的。要实现结合,通常需要以下硬核技术手段:
连续松弛(Continuous Relaxation): 将 MSO 逻辑运算符(∧,∨,¬)转化为 T-norm 模糊逻辑,使其在 Embedding 空间可导。
GFlowNet 采样: 用 GFlowNet 作为桥梁,由 Embedding 提供流的强度(Flow),由 MSO 提供流的边界(Boundary)。
2.2 Graph Embeddings:图嵌入
图嵌入是将图中的节点、边、子图等信息映射到低维空间中的一种技术,使得图的结构信息能够以向量形式表示。图嵌入通过将图的结构和关系映射到低维空间,使得我们可以利用常见的优化算法(如梯度下降)进行图问题的求解。图嵌入的关键目标是保留图的局部和全局结构信息,以便进行后续的学习和优化。
(1)图嵌入的目标与方法
图嵌入的核心目标是通过低维向量表示图中的节点和边,使得图的结构得以保留。例如,图中的节点和边可以通过嵌入向量 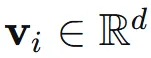 来表示,其中 d 是嵌入空间的维度。这些向量的设计目标是使得在图中距离较近的节点,其嵌入向量之间的距离也较近。
图嵌入的方法包括:
DeepWalk(随机游走): 通过在图中执行随机游走,生成节点的上下文,使用Skip-Gram模型进行训练。
Node2Vec: 结合深度优先和广度优先的搜索策略,生成节点的上下文,优化嵌入向量。
Graph Convolutional Networks(GCN): 通过卷积操作捕获图的结构信息,将节点嵌入到低维空间。
(2)数学表示与目标
假设我们有一个图 G=(V,E),节点集合 V 和边集合 E。每个节点 vi 被嵌入为一个向量 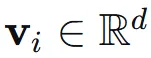 ,我们的目标是通过训练一个嵌入模型,使得图中结构相似的节点在嵌入空间中保持相似。
我们可以通过最小化以下目标函数来优化嵌入:
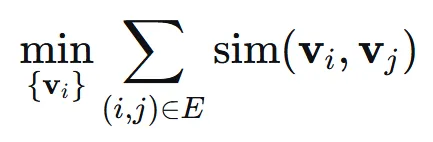
其中,sim(vi,vj) 是节点 vi 和 vj 之间的相似度度量,通常使用余弦相似度或欧几里得距离。
(3)图嵌入的应用
图嵌入在许多应用中具有重要价值,包括但不限于:
节点分类: 通过图嵌入得到节点的低维表示,用于后续的分类任务。
图分类: 将整个图映射到低维空间,进行图分类。
链接预测: 预测图中可能出现的边,通过节点嵌入向量计算边的相似度。
图嵌入在处理网络结构问题(如社交网络分析、推荐系统)中非常有用,因为它能够将图结构信息有效地转化为机器学习模型可以理解的向量表示。
本节总结
表达层在SATLUTION框架中起到了至关重要的作用,它通过使用MSO和图嵌入等方法,将问题的约束和结构转化为数学模型。MSO提供了一个强大的工具来表达复杂的逻辑约束,尤其是在图论和集合约束问题中。而图嵌入则通过将图的结构映射到低维空间,使得我们能够利用现有的机器学习算法进行高效的优化和推理。两者的结合不仅提高了问题求解的灵活性,还提升了整个优化过程的效率。
三、验证层
在SATLUTION框架中,验证层是确保生成解满足所有约束条件的核心部分。验证层的核心任务是检查约束条件是否得到满足,确保生成解的合法性。验证不仅仅是在解空间中找到一个解,更要确保生成的解在约束条件下是可行的。因此,验证层依赖于形式化的逻辑工具,如SAT求解器、SMT求解器和定理证明系统(如Lean),来确保生成解的正确性。
验证层的重要性不言而喻,特别是在面对复杂的优化问题时,通过形式化验证,我们能够排除不符合约束的解,从而加速收敛到最优解。以下是SATLUTION中验证层的关键组成部分。
3.1 SAT:可满足性问题(Satisfiability Problem)
SAT问题(Satisfiability Problem)是计算机科学中的经典问题,其目的是确定一个布尔公式是否存在满足该公式的变量赋值。SAT问题是NP完全问题,是许多计算理论和优化问题的基础。
(1)SAT问题的形式化
SAT问题可以通过布尔公式来描述,公式由一组子句组成,每个子句是若干个文字的析取。一个典型的布尔公式 ϕ(x1,x2,…,xn)的形式为:
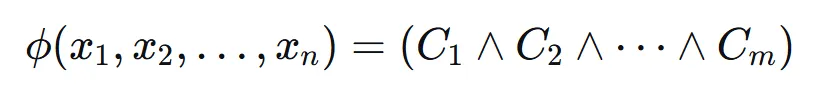
其中,每个子句 Ci 是由文字(变量或其否定)通过析取组成的,例如:
C1=(x1∨¬x2∨x3)
我们的目标是找到一个变量赋值 x1,x2,…,xn,使得整个公式 ϕ(x1,x2,…,xn) 的值为真。SAT问题的求解过程就是寻找这个赋值,使得公式成立。
(2)SAT求解器
SAT求解器用于寻找布尔公式的可满足性,即判断是否存在某种变量赋值使得公式为真。当前最流行的SAT求解器采用DPLL算法(Davis-Putnam-Logemann-Loveland)或其变体(如CDCL算法),这些算法通过分支限界法和剪枝策略大幅提高了求解效率。
SAT求解器的工作流程通常包括以下几个步骤:
选择一个变量并进行赋值;
根据当前赋值推导出公式的值,然后根据布尔约束进行简化;
判断公式是否满足,如果满足则返回解;如果不满足,则回溯并调整赋值。
(3)SAT在SATLUTION中的应用
在SATLUTION框架中,SAT求解器用于验证生成解的可行性。例如,在图着色问题中,我们可以将图的约束转化为一个布尔公式,使用SAT求解器来验证是否存在一个符合约束的着色方案。通过SAT求解器,SATLUTION能够检查生成解是否满足所有的图约束。
例如,对于一个图的着色问题,我们可以将图的约束转化为以下SAT公式:
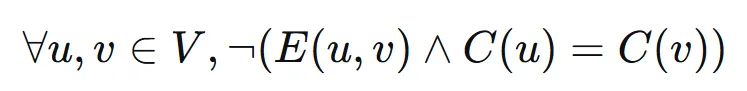
其中 E(u,v) 表示节点 u 和 v 之间有边,C(u) 和 C(v) 表示节点 u 和 v 的颜色。SAT求解器会检查是否存在一种颜色分配,使得图中没有两个相邻节点具有相同颜色。
3.2 SMT:可满足性模理论(Satisfiability Modulo Theories)
SMT求解器是对SAT求解器的扩展,它不仅处理布尔变量,还支持处理更复杂的数理逻辑,如整数、实数、数组等数据结构。SMT问题是SAT问题的一个推广,涉及对多个理论(如线性算式、数组、整数算式等)进行求解。
(1)SMT的数学表示
一个标准的SMT问题可以描述为:
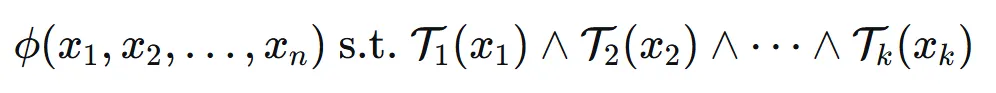
其中,Ti(xi) 是某个数据理论(例如,整数约束、线性约束等),而 ϕ(x1,x2,…,xn)是布尔公式。
例如,在整数线性规划中,SMT求解器会处理如下类型的约束:
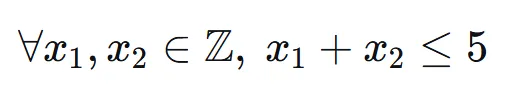
(2)SMT求解器的工作原理
SMT求解器结合了SAT求解与理论推理。其核心思想是将复杂问题拆解成布尔求解问题和理论求解问题的结合。在处理问题时,SMT求解器首先将理论公式转化为布尔公式,再使用SAT求解器进行求解,同时保持理论的一致性。
SMT求解器会通过以下几个步骤来求解问题:
转换布尔部分: 将所有非布尔约束转化为布尔约束。
理论求解: 使用特定的理论(如整数算式理论)对约束进行求解。
回溯和剪枝: 根据布尔部分的求解结果,进行回溯和剪枝,找到满足所有约束的解。
(3)SMT在SATLUTION中的应用
在SATLUTION框架中,SMT求解器可以用于处理更加复杂的约束,例如时间约束、空间约束和非线性约束。例如,在自动驾驶的路径规划问题中,我们不仅需要考虑路径的可行性(布尔约束),还需要考虑路径的物理特性,如速度、加速度等限制条件。这些问题可以通过SMT求解器进行验证。
3.3 Lean:定理证明系统
Lean 是一个现代化的定理证明系统,它通过形式化的数学证明来验证一个问题的正确性。在SATLUTION框架中,Lean被用来对生成解进行严格的定理证明,确保每一步生成的解都符合逻辑和数学上的正确性。
(1)Lean的工作原理
Lean使用形式化的数学语言进行推理,通过定义公理、定理、引理(axioms, definitions, lemmas, and theorems)等数学结构来构造证明过程。它的核心优势在于其可以自动化地生成证明,并且可以验证解是否满足所有逻辑约束。
Lean的基本步骤包括:
定义理论: 通过定义数学对象(如集合、关系、函数等)来构建问题模型。
构造证明: 利用定理和引理构造问题的证明,逐步推导出结论。
验证结论: 验证解是否满足所有逻辑和数学约束。
(2)Lean在SATLUTION中的应用
在SATLUTION中,Lean被用于形式化验证。例如,在自动驾驶的控制问题中,Lean可以用来证明某个路径规划算法是否满足安全约束,或者某个控制策略是否能够保证车辆的稳定性。在这种情况下,Lean能够提供数学上的保证,确保生成的解不仅仅是符合约束的解,而且是经过形式化证明的。
3.4 数学表达与总结
验证层的关键任务是确保生成的解满足所有的约束条件。在数学上,验证可以表示为以下形式:
SAT验证: 判断公式是否可满足,形式为:
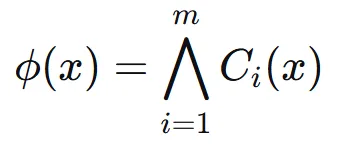
SMT验证: 考虑更复杂的数据结构和理论约束,形式为:
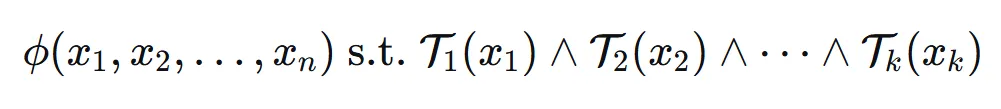
定理证明: 通过形式化证明来验证生成的解是否正确,形式为:
Theorem T(x) is true, if and only if ϕ(x)
本节总结
验证层在SATLUTION框架中发挥着至关重要的作用,通过SAT、SMT和Lean等工具,SATLUTION能够确保生成的解不仅是满足约束的,而且是经过数学证明的。SAT求解器处理布尔约束,SMT求解器处理更加复杂的理论约束,而Lean则通过形式化定理证明确保每一步的正确性。通过这些工具,SATLUTION能够保证生成解的合法性,从而提高整个优化过程的准确性和可靠性。
四、计算层
在SATLUTION框架的计算层,计算效率和资源的优化非常关键。为了应对大规模的数据和复杂的约束优化问题,框架采用了一系列高效的数值计算工具,如FFT、NUFFT、HSS、Butterfly算法、Wavelet和Laplacian等算子。这些算子在不同的应用场景下发挥着重要作用,如何选择合适的算子,并根据硬件状态和算法特性进行高效计算,是本节讨论的核心内容。
本节将介绍算子库管理框架,并比较常用算子如FFT、NUFFT、HSS、Butterfly、Wavelet的优缺点。通过结合硬件感知算子系统、结构化加速算子库、自动化算法选择机制等方法,展示如何通过优化算子选择、资源调度和硬件感知,提升算力的使用效率。
4.1 硬件感知算子系统:O(NlogN) 的计算革命
硬件感知算子系统是SATLUTION框架的核心组件之一,它在传统的算法基础上,结合硬件特性进行优化,推动了 O(NlogN) 计算效率的革命。该系统的核心思想是根据不同硬件的特性(如多核处理器、GPU、FPGA等),动态选择最适合的算法和数据结构,从而确保计算任务能够以最小的时间复杂度完成。
硬件感知的重要性
随着计算硬件的不断发展,计算平台从传统的CPU发展到多核、GPU、FPGA等高性能计算单元。每种硬件有其特定的优势和计算瓶颈。硬件感知算子系统正是通过以下方式优化计算效率:
多核并行: 针对多核CPU或GPU的并行计算特性,选择适合并行计算的算法,如FFT和Butterfly算法,通过分治法和并行化提高计算效率。
内存访问优化: 针对硬件内存的带宽限制,选择数据访问模式更加高效的算法,如HSS和Laplacian算子,通过优化内存访问,减少缓存未命中和内存带宽瓶颈。
特定硬件优化: 如在GPU上,使用特定的矩阵运算库(如cuBLAS)加速矩阵运算,或在FPGA上实现定制化加速。
数学表达
硬件感知算子系统可以通过以下数学框架描述:
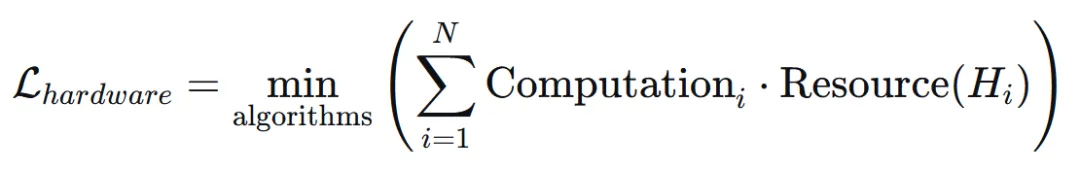
其中,Computationi 表示算法中每个计算任务的复杂度,Resource(Hi) 表示硬件平台 Hi 的资源消耗,目标是选择使得计算和资源消耗最优化的算法。
4.2 结构化加速算子库
结构化加速算子库通过高效的数据结构和算法优化计算过程,使得复杂的数值计算问题能够更高效地解决。在SATLUTION框架中,结构化加速算子库通过对常见运算模式(如矩阵运算、傅里叶变换、卷积等)进行优化,降低了计算的时间复杂度和存储需求。
算子分类
变换类(Transform Class): 包括FFT、NUFFT和Butterfly变换等,这些算子用于在时域和频域之间进行高效转换,广泛应用于信号处理和图像分析。
结构类(Structural Class): 如HSS矩阵压缩等,这些算子用于处理大规模的稀疏矩阵和具有特定结构的矩阵,通过低秩分解和分层分解加速计算。
求解类(Solvers Class): 包括直接法、迭代法和预条件器等,这些算子用于高效求解线性方程组和优化问题,保证系统的收敛速度和计算效率。
4.3 变换类:FFT / NUFFT 与蝴蝶变换
在SATLUTION框架的计算层,变换类算子(如FFT、NUFFT、Butterfly变换)用于执行时域与频域之间的高效转换。变换类算子是信号处理和数据分析中的基础工具,它们通过将数据从时域映射到频域,帮助揭示信号中的周期性或频率特性。以下是对这三种算子(FFT、NUFFT 和 Butterfly变换)的详细讨论。
(1)FFT(快速傅里叶变换)
FFT是离散傅里叶变换(DFT)的高效算法,广泛应用于信号处理、图像分析、通信等领域。FFT的优势在于将DFT的时间复杂度从 O(N2)降低到 O(NlogN),在处理大规模数据时具有显著的速度优势。
优点:
高效性: FFT显著提高了频率转换的计算速度,适用于处理大规模数据。
并行性: FFT具有良好的并行化特性,适合在多核处理器、GPU等并行计算环境中加速计算。
缺点:
均匀采样限制: FFT仅适用于均匀采样的数据,对于非均匀采样的数据,FFT无法直接应用。
(2)NUFFT(非均匀快速傅里叶变换)
NUFFT是FFT的扩展,适用于非均匀采样的数据。它通过插值操作将非均匀采样数据转化为均匀数据,再进行傅里叶变换。
优点:
适用于非均匀采样: NUFFT能够处理现实世界中常见的非均匀采样问题,如医学成像和地震数据分析。
高效: NUFFT的计算复杂度接近FFT,且能有效处理非均匀采样数据。
缺点:
插值误差: NUFFT需要插值,可能在不规则数据下引入误差。
计算复杂性: 插值和傅里叶变换的组合增加了NUFFT的计算开销。
(3)Butterfly变换
Butterfly变换用于快速计算傅里叶变换,采用递归分解的方式将计算过程拆解为多个子问题。它通过合并子问题的结果来高效计算傅里叶变换,适用于大规模数据。
优点:
并行化: Butterfly变换天然适合并行计算,能够在现代硬件上充分发挥性能。
计算高效: 通过递归分解,Butterfly算法提高了傅里叶变换的计算效率。
缺点:
内存访问开销: 频繁的数据交换和内存访问可能导致内存瓶颈,尤其是在处理大规模数据时。
排序需求: Butterfly变换需要对输入数据进行排序,这可能导致额外的计算时间。
(4)Wavelet(小波变换)
小波变换是一种时频分析工具,能够将信号分解成不同频率和时间尺度的分量。小波变换广泛应用于图像压缩、信号降噪和数据压缩等领域。
优点:
时频局部化: 小波变换能够同时提供信号的时域和频域局部信息,特别适合分析非平稳信号。
多分辨率分析: 通过不同尺度分解,小波变换能够捕捉信号中的细节,适合进行精细的信号分析。
缺点:
计算复杂性: 小波变换相较于傅里叶变换,计算复杂度较高,尤其是在进行多尺度分析时。
函数选择难度: 选择合适的小波基函数对信号的分析结果有重要影响,且这需要一定的经验。
数学公式
FFT的计算公式为:
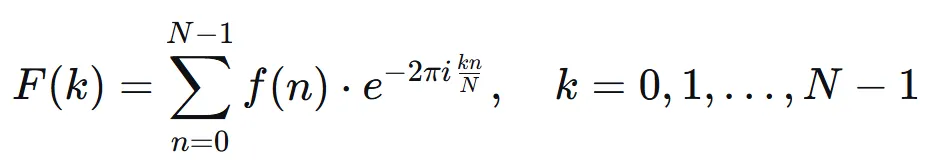
NUFFT的计算公式为:
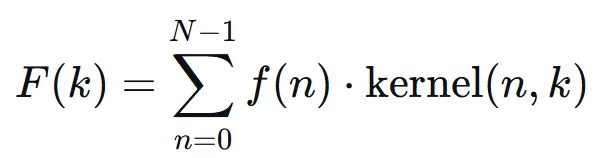
Butterfly变换的递归公式为:
F(k)=F(k)+W(k)⋅F(k+1)
离散小波变换(DWT)的一般公式为:
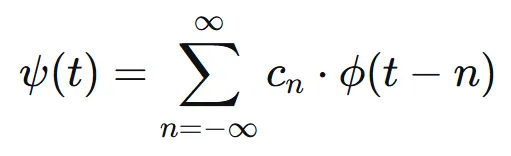
其中,ψ(t) 是小波基函数,cn 是小波系数,ϕ(t) 是尺度函数。
4.4 结构类:分层块结构与 HSS 矩阵压缩
结构类算子(如HSS矩阵和分层块结构)主要用于处理稀疏矩阵和具有特殊结构的矩阵。HSS通过低秩分解和块对角化技术,将大规模矩阵压缩为更小的子矩阵,以减少存储和计算的复杂度。
(1)HSS(分层可分解矩阵)
HSS矩阵是一种高效的矩阵表示方法,适用于稀疏矩阵和具有层次结构的矩阵。通过分层分解和低秩压缩,HSS矩阵显著减少了存储需求和计算开销。
优点:
高效存储: HSS矩阵压缩大规模矩阵的存储空间,尤其适用于稀疏矩阵。
加速计算: 通过矩阵的低秩近似,HSS加速了矩阵运算,特别是求解大规模线性方程组。
缺点:
适用性限制: HSS矩阵适用于具有层次结构的矩阵,对于不规则矩阵效果较差。
实现复杂性: HSS的实现复杂,尤其是在需要对矩阵进行低秩分解和压缩时,算法的实现较为繁琐。
数学表达
HSS矩阵表示为:
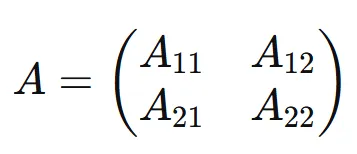
其中,每个子矩阵 Aij 都可以进一步分解压缩,降低计算和存储开销。
4.5 求解类:直接法、迭代法与预条件器
求解类算子(如直接法、迭代法和预条件器)用于求解线性方程组和优化问题。这些算子分别适用于不同的矩阵类型和问题规模。
直接法: 直接法(如高斯消元法)用于精确求解线性方程组,但计算复杂度较高,适用于小规模问题。
迭代法: 迭代法(如共轭梯度法)适用于大规模稀疏矩阵,能够通过反复迭代逼近解,计算效率高。
预条件器(Preconditioner): 预条件器通过对矩阵进行预处理,改善迭代法的收敛速度,常用于大规模优化问题。
4.6 自动化算法选择机制(Algorithm Selector)
自动化算法选择机制是SATLUTION框架中的一个重要组成部分。它根据数据的特征、问题的复杂度、硬件状态等因素,自动选择最适合的算法进行计算。通过这一机制,框架能够确保在不同的计算任务中选择最优的算法,从而提高计算效率。
核心目标:
根据矩阵特征: 分析矩阵的结构特性,如稀疏性、规模、条件数等,选择最适合的求解算法。
硬件感知选择: 根据硬件的计算资源(如CPU、GPU、内存等),动态调整算法,选择最能高效利用硬件资源的算法。
实时优化: 在计算过程中实时监测算法的性能,根据反馈动态调整算法,以确保达到最优的计算效果。
4.7 基于矩阵特征与硬件状态的路由逻辑
路由逻辑是SATLUTION框架的核心机制之一,它负责根据矩阵的特征和硬件的状态,自动选择最合适的算子和计算路径。该机制使得SATLUTION框架能够根据计算资源和任务需求,动态地选择算法和优化策略。
(1)路由机制的基本原理
路由逻辑通过以下几个步骤进行优化:
矩阵特征分析: 根据矩阵的稀疏性、结构、维度等特征,选择合适的算法。
硬件状态感知: 根据硬件平台的性能(如处理能力、内存带宽等)来优化计算路径。
动态算法调整: 根据运行中的计算反馈,动态调整算法选择,确保计算效率最大化。
(2)数学表达
路由逻辑可以通过以下数学公式描述:
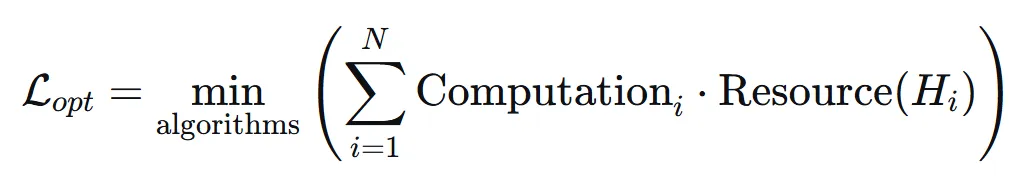
其中,Computationi 是每个算法任务的计算复杂度,Resource(Hi) 是硬件平台 Hi 上的资源消耗,目标是选择最优算法组合,确保计算资源的最大利用。
本节总结
算子优缺点比较总结
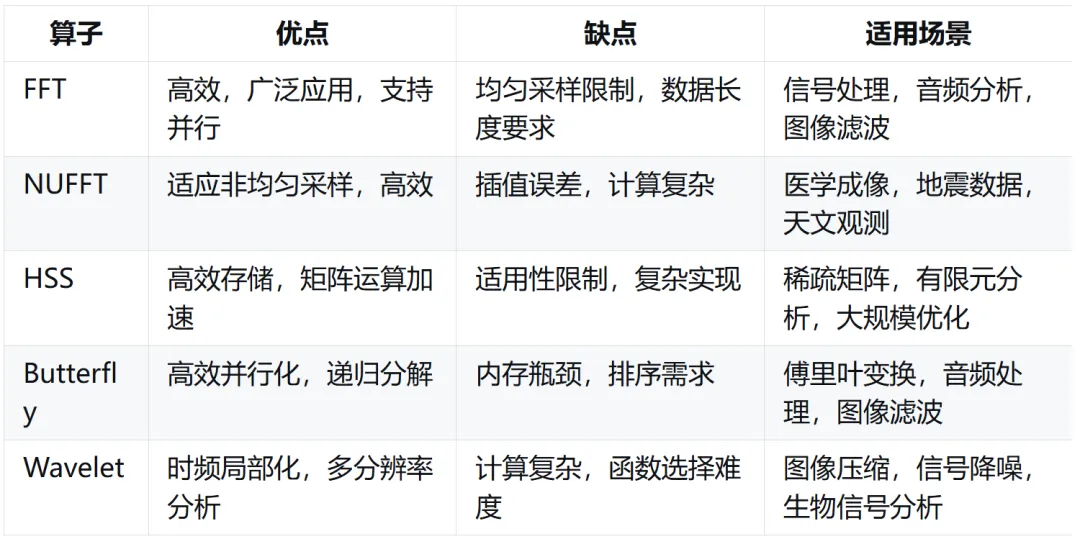
通过对FFT、NUFFT、HSS、Butterfly算法、Wavelet变换等算子的优缺点比较,可以看出它们在不同的应用场景下有着各自的优势和局限性。在SATLUTION框架中,算子库管理框架通过引入硬件感知算子系统、自动化算法选择机制和路由逻辑,结合硬件和矩阵特征动态选择最适合的算法,从而确保计算过程能够高效执行,提升单位算力的价值密度。
在实际应用中,选择合适的算子和算法能够极大地提高计算效率,减少计算资源的浪费,使得SATLUTION框架在解决大规模约束优化问题时更加高效。
整体架构图 Operator Stack:Layered Architecture and Interactions
Shang-Ling Jui 芮祥麟
芮博数理工场 | The Morphism Factory
往期阅读:
*点击“阅读原文”,解锁专栏更多内容。
扫码进入茶思屋科技网站
加入茶思屋产学研思想碰撞
转载请联系本公众号获得授权
投稿:hdncsw@huawei.com