ARTICLE · 1192178
FoveaVLA 源码精读:预测「下一眼看哪」的注视动作,怎么替掉机械臂腕上的相机
FoveaVLA 源码精读:预测「下一眼看哪」的注视动作,怎么替掉机械臂腕上的相机一台 Franka 机械臂在桌面上叠布、搬远处的杯子,腕部相机是这类系统的默认配置——手到哪看到哪,特写不丢。代价也明摆着:相机跟着末端走,视野锁死在手边一小块,目标一旦离开腕部视野,策略就成了睁眼瞎。2026 年 10 月 14 日挂上 arXiv 的 FoveaVLA(斯坦福与普林斯顿合作,仓库次日开源)给了一个反直觉的答案:把腕部相机整个拆掉,让策略在输出动作块的同时多吐一个「下一次查询时该盯着哪里看」的边界框,再从原分辨率的外部图像里裁出那块喂给下一拍。四个真实任务套件上,单外相机版本成功率 70.8%,带腕部相机的 π0.5 基线 52.1%,双外相机版本 77.1%。我没有跑训练和真机评测,下面把论文和代码放在一起读。 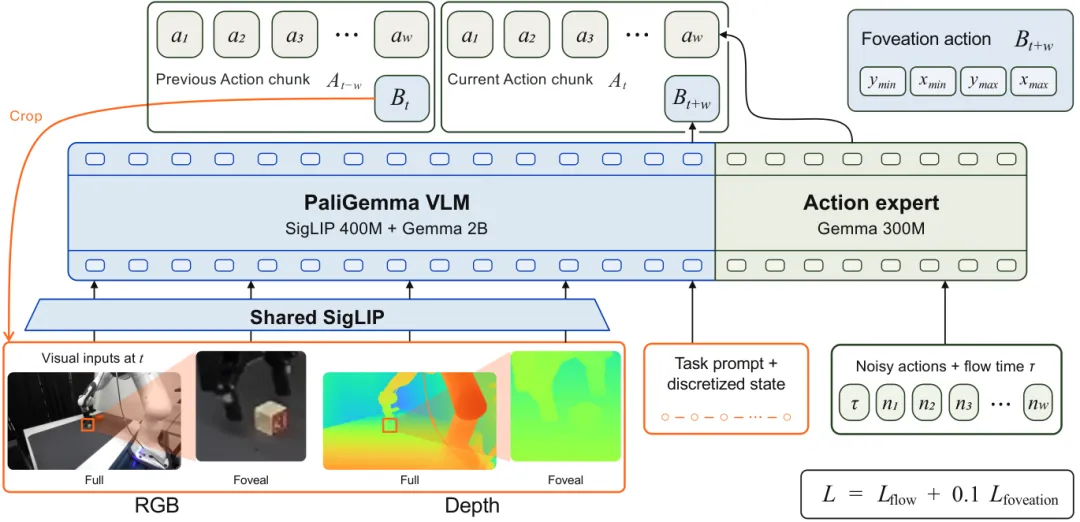
FoveaVLA 解决的是「无腕部相机的近距细节」问题:外部相机拍得到全场景,但整幅缩到策略的 224×224 输入后,夹爪和物体的细节被抹平,纯外视角后训练的 π0.5 在同一组真机套件上只有 25.0% 成功率。改法是在 π0.5 上加一个「注视动作」输出:模型复用 PaliGemma 词表里现成的 1024 个位置 token,把 t+w 时刻交互区域的框自回归解码出来,w 是两次查询间执行的动作数(8)。训练只加一项 0.1 权重的交叉熵,跟流匹配动作损失一起回传骨干。停在哪:单视角必须配深度——裁剪无深度 20.8%、深度无裁剪 6.3%,合起来才 70.8%;评测规模是每套件 12 个随机化实例、共 48 次真机试验;监督依赖 RoboInter 标注的角色覆盖。只想看一处代码,看 src/foveavla/models/future_bbox.py,90 行,把框的坐标系、量化和 token 映射全部写完。 腕部相机的好处有一长串文献背书,坏处是三条:视野受限,远目标和场景上下文经常出画;增加硬件,还跟「无腕视角录的人示教视频」存在观测错位;外部视角又缺一个稳定的几何参照——腕机相对末端位姿固定,外机随摆放变。直接抬外部图的分辨率也不行:算力都花在背景区域上。 替代路线各有前提。生成式方法从外部观测合成腕部图像;另一路从三维场景表示渲染虚拟视角;还有给机器人装可动相机(云台、第二只机械臂)。靠人眼注视数据做注视裁剪的工作离目标最近,但要在采集时戴眼动仪——DROID 数据集里没有这个信号。FoveaVLA 的切入点是:不动相机、不加传感器,从现成的机器人示范里学「往哪看」。 主线是 π0.5 骨干(SigLIP 视觉编码器 + Gemma 语言骨干 + 流匹配动作专家)之上的一条旁路。输入端每个外部视角给四路图:全图 RGB、注视裁剪 RGB、以及各自对齐的深度(双目 Fast-FoundationStereo 估计米制深度,对数刻度上色)。输出端两个头共享观测前缀、互不打扰。 设计一:注视动作零新参数。PaliGemma 的词表本来就有为检测与定位准备的 1024 个位置 token,π0.5 基线检查点从不输出它们。FoveaVLA 把框的四个坐标(画布系 y、x、y、x 顺序)各量化到 1024 桶,单视角 4 个、双视角 8 个 token,贪心解码,输出词表锁死在位置 token 上——语言模型的输出头原样复用,没有新增一层。 设计二:单前向双分支。动作专家和框解码在同一个注意力掩码下跑:共享观测前缀,两个输出分支互相屏蔽,动作分支只看前缀,框 token 额外看前面的框 token。推理分级:先出动作块立刻返给机器人,机器执行前 8 步的窗口里,用缓存的前缀 KV 贪心解码框——新帧到站时框已备好,不占控制节拍。 一个必要公式:L = L_flow + λ·L_foveation,λ=0.1。三个量:L_flow 是流匹配的速度场回归,动作块与高斯噪声按流时间 τ 插值,τ=0.999u+0.001、u 服从 Beta(1.5,1),回归目标是噪声减动作;L_foveation 是 4N 个位置 token 的 teacher-forcing 交叉熵,监督目标是 t+8 时刻交互区域(夹爪、物体、目标区域三个角色框的最小外接矩形)量化后的 token 序列;λ 把两路拉在一起更新骨干。 入口链:相机工作站跑 examples/droid/main.py(Python 3.10 的 DROID 客户端),经 WebSocket 连 scripts/serve.py 起的策略服务器(--model=foveavla_single 或 foveavla_dual);服务器外面再包一层 FastFoundationDepthPolicy 做运行时双目深度。模型侧入口是 foveavla.py 的 sample_actions_with_future_bbox:prepare_inference_prefix 把观测编码一次,sample_actions_from_prepared_prefix 走 10 步欧拉积分出 16 步动作块,sample_future_bbox_from_prepared_prefix 从同一份缓存前缀贪心解码框——论文 IV-D 节「框解码藏在动作执行窗口内」就是这三步的次序。 对照一:公式 L 的实现,src/foveavla/models/foveavla.py 的 _compute_loss(L418 起): ```python time = jax.random.beta(time_rng, 1.5, 1, batch_shape) * 0.999 + 0.001 x_t = time_expanded * noise + (1 - time_expanded) * actions u_t = noise - actions ... return action_loss + self.bbox_loss_weight * bbox_loss[:, None], metrics ``` 对应关系:beta(1.5,1) 乘 0.999 加 0.001 就是 τ 的采样式(论文附录 B-D),x_t 是插值后的噪声动作块,u_t 是流匹配回归目标;最后一行即 L=L_flow+λ·L_foveation,bbox_loss_weight 在 foveavla_config.py 里定死 0.1。掩码分支在 make_joint_attn_mask(L70),注释原话「Build independent VLM-bbox and action attention branches in one forward pass」,正是公式 1 的因式分解。 对照二:框的坐标与 token 化,src/foveavla/models/future_bbox.py(L5–L46): ```python MODEL_IMAGE_SIZE = 224 NUM_LOCATION_BINS = 1024 LOCATION_TOKEN_START_ID = 256_000 ... return np.stack([y1_canvas, x1_canvas, y2_canvas, x2_canvas], axis=-1) ... return np.clip(np.rint(coords * (NUM_LOCATION_BINS - 1)), 0, NUM_LOCATION_BINS - 1) ``` 对应关系:论文 IV-B 与附录 B-C 说「四个坐标在缩放加填充的全图上量化为 1024 桶、按 (y,x,y,x) 序列化」——代码先把 1280×720 原图 letterbox 到 224×224 画布(_letterbox_geometry 算出 224×126 居中、上下各垫 49 像素),坐标乘 1023 四舍五入入桶;token id 等于桶号加 256000,直接落进 PaliGemma 位置 token 的区段。解码端的 _decode_future_bbox(L373)逐坐标 argmax,非法框(x1≥x2)按论文附录 B-C 的口径复用上一个有效框或退回全图。 再看一个代码替论文做的选择:foveavla_config.py 的 image_keys 仍是 ("base_0_rgb", "left_wrist_0_rgb"),注释写明「wrist 命名的槽位装的是注视裁剪图,不是腕部图像」;droid_policy.py 的 DroidInputs 把 observation/foveal_image 塞进 left_wrist_0_rgb 槽——这样 π0.5 检查点的图像槽位与权重一一对应,不用改任何加载逻辑。 数据与监督:从 π0.5 base 检查点后训练,DROID 约 7.5 万条遥操作 Franka 回合(Robotiq 2F-85 夹爪、两台外部双目相机),只用外部视角;交互框监督来自 RoboInter 标注,按角色映射取夹爪、物体、目标区域的最小外接矩形,t 与 t+8 两帧标注都有效的样本才入训练。优化:8 张 H100,全局批 256,学习率 5e-5 先热身 1000 步再恒定,全参数更新。输入侧:深度按 0.2–3.0 米对数刻度上 Turbo 色图(近暖远冷),14×14 深度 patch 有效像素不足 25% 就从注意力里屏蔽,训练时每路深度以 0.1 概率整体丢弃,RGB 只做亮度/对比度/饱和度抖动(0.3/0.4/0.5),不做几何增广——几何增广会破坏裁剪、深度与框坐标的对齐。推理:流匹配 10 步积分,16 步预测、执行 8 步再查询;控制目标 15Hz、900 步封顶。评测协议:四套件(普通抓放、带干扰物抓放、布料折叠、远物搬运),每套件 12 个随机化物体/摆放/指令实例,成功标准是任务完整完成,报均值加减标准误。 真机总表单独读:Single 70.8%、Dual 77.1%、腕部 π0.5 52.1%、纯外视角 π0.5 25.0%。普通抓放上三者都 100%,差距全在难套件——带干扰物从 25.0% 提到 58.3%(Single),远物搬运从 41.7% 到 75.0%;Dual 在折叠与搬运上最强(75.0%、83.3%)。论文的注意力图解释:基线 π0.5 的图像注意力几乎全压在腕部视角上,目标出画就丢;FoveaVLA 一直看全图,裁剪补细节。 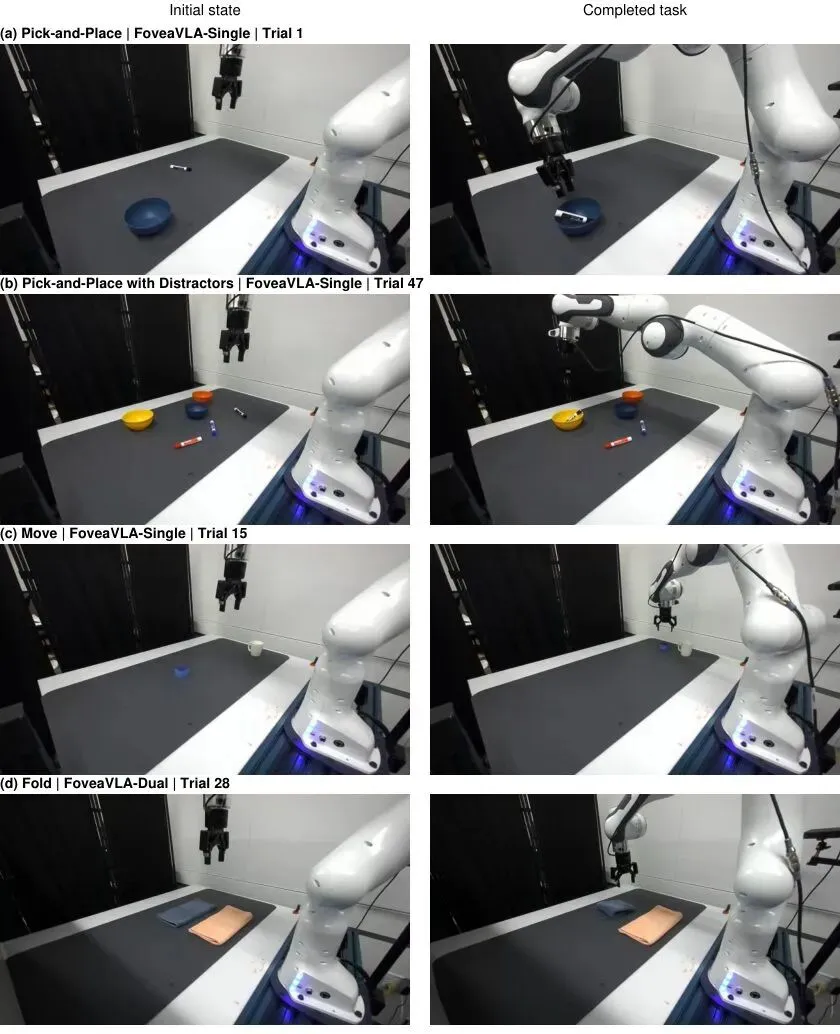
消融表再单独读:单视角 RGB-D 不裁剪只有 6.3%,双视角不裁剪 41.7%;框监督但不裁剪(ECoT 风格)31.3%,加上裁剪的 Dual-RGB 66.7%——监督值 6.3 个点,裁剪再值 35.4 个点。裁剪与深度在单视角下缺一不可:只裁剪 20.8%,只深度 6.3%。第二视角能顶一部分深度的作用(无深度时双视角 66.7% 接近单视角 RGB-D 的 70.8%)。 零样本与注视质量分开读:MolmoSpaces 上 8,915 回合平均 22.4%,对照已发表 π0.5-DROID 榜单 17.8%,九个任务七项领先;论文自己声明两者相机布局、分辨率、深度可用性都不同,只作 published reference,不构成受控比较。注视预测上 0.465 mIoU、0.483 Acc@.5,与要看目标帧的 YOLO11s(0.492/0.488,另加 29 毫秒)相当,π0.5-DROID 原生输出位置 token 只有 0.009 mIoU——交互框监督就是从这里救回来的。延迟:RTX 5080 上 Single 每次查询约 125 毫秒、缓存前缀框解码约 50 毫秒,Dual 约两倍,框解码不占控制节拍。这些数字全部出自论文表 I–III 与正文,我没有跑。 对得上的:损失公式、双分支掩码、框坐标系与 1024 桶量化、贪心解码与非法框回退,前文逐条对过。代码比论文多做的:serve.py 起服务前校验检查点必须带 params/ 与 assets/droid/norm_stats.json;客户端包里的 foveation.py 做新旧字段名映射(future_interaction_roi 与旧名互转),让已发布的机器人客户端不用改就能连新服务器;droid_policy.py 校验深度质量图必须在 [0,1] 区间。配置选择别当缺陷看:image_keys 沿用腕部槽位名是为了原样加载 π0.5 权重;位置 token 是 PaliGemma 词表自带的,π0.5 论文用它做定位辅助监督,这里改成推理期真正开口说坐标。仓库另带完整的数据工程脚本(build_foveal_filter.py、extract_droid_fast_foundation_depth.py 等十余个),比论文附录 A 写的还细。 环境:Linux、Python 3.11、NVIDIA GPU,用 uv 管理;服务器环境约 8GB 磁盘,单个预训练检查点约 12.4GB,服务显存约 13GB。最小路径不需要训练:uv run scripts/download_checkpoint.py --model=foveavla_single 下载权重,uv run scripts/serve.py --model=foveavla_single 起 8000 端口;相机工作站按 docs/deployment.md 装 Python 3.10 的 DROID 客户端,跑 examples/droid/main.py 指定 ZED 序列号与服务器地址。成功标志:WebSocket 返回 16 步动作块加每视角一个框,客户端下一拍自动带注视裁剪。容易看错的三处:框的坐标系是 letterbox 后的 224 画布不是原图,逆变换在 canvas_yxyx_to_source_xyxy 里做完还会裁剪到图界;第一次查询没有历史框,注视输入就是全图(训练时也按比例把真值裁剪换成全图来对齐这一点);日志里 left_wrist_0_rgb 槽位流的是裁剪图,别按名字找腕部图像。 有证据的价值:不加传感器拿到近距细节,四个真机套件上把「无腕」从 25.0% 拉到 70.8%;注视头零新增参数、延迟藏在动作执行窗口里,工程账算得干净;交互框监督取自现成标注,没有额外采集成本。限制也清楚:单视角下深度不可省,说明裁剪补的是纹理、几何还得另求;48 次试验的评测规模,百分点级差距要谨慎读;MolmoSpaces 对照非受控,论文自己标了;RoboInter 标注的角色映射决定监督上限,长尾物体未必覆盖。我的看法:对腕部相机易遮挡或损坏的工位、腕部视野天然不够用的移动操作平台、以及从无腕视角的人示教视频学策略(论文结论里点的这条),这套机制可以直接搬;想用它证明「腕部相机该淘汰」还不够——基线在普通抓放上同样是 100%,它赢的是干扰、布料与远物这些腕部视野吃亏的场景。 论文:FoveaVLA: Foveation Actions Replace the Wrist Camera in VLAs,arXiv 2610.20064(v1,2026-10-14 提交),https://arxiv.org/abs/2610.20064 仓库:https://github.com/Stanford-TML/FoveaVLA(main 分支,仓库创建于 2026-10-15,Apache-2.0;源码行号依据当日 tarball) 模型:https://huggingface.co/bingaochen/FoveaVLA-Single 与 https://huggingface.co/bingaochen/FoveaVLA-Dual(FoveaVLA-Single/Dual 检查点与 DROID 归一化统计) 项目页:https://tml.stanford.edu/FoveaVLA/ 精读所依据的源码文件:src/foveavla/models/foveavla.py、src/foveavla/models/future_bbox.py、src/foveavla/models/foveavla_config.py、src/foveavla/policies/droid_policy.py、packages/foveavla-client/src/foveavla_client/foveation.py、scripts/serve.py、src/foveavla/training/droid_foveal_dataset.py 底座与数据:π0.5(Physical Intelligence)、DROID 数据集、RoboInter 交互标注(论文引用 [23][24][5])
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看