ARTICLE · 1198297
上下文工程五层模板:让 Agent 少翻车的那层"系统架构"(附可直接抄的)
小刚爱AI · 手把手实操
上下文工程五层模板:让 Agent 少翻车的那层"系统架构"(附可直接抄的模板)
你大概率遇到过这种场景:昨天还顺手得很的 Agent,今天让它改一个脚本,它把没坏的逻辑也顺手重写了;你把要求反复讲了三遍,它还是用了早就废弃的接口;换了个会话,它又把上次的错重犯一遍。
多数人的第一反应是"模型不行",于是去换模型、调参数、升级套餐。方向错了。模型没变蠢,是它每次干活时"看到的东西"变了、错了、缺了。
这件事在行内有专门的说法,叫上下文工程。第一次听的话,一句话解释:上下文工程,就是想办法让 AI 在干活时看到该看的东西,别看不该看的——模型的能力上限你改不了,但它每次"带脑子"的质量,完全由你决定。
单次 prompt 是一次性的,五层结构才是系统。下面这套模板,是把散装 prompt 升级成可维护工作系统的最小骨架,每一层都给了可以直接抄的片段。
五层总览
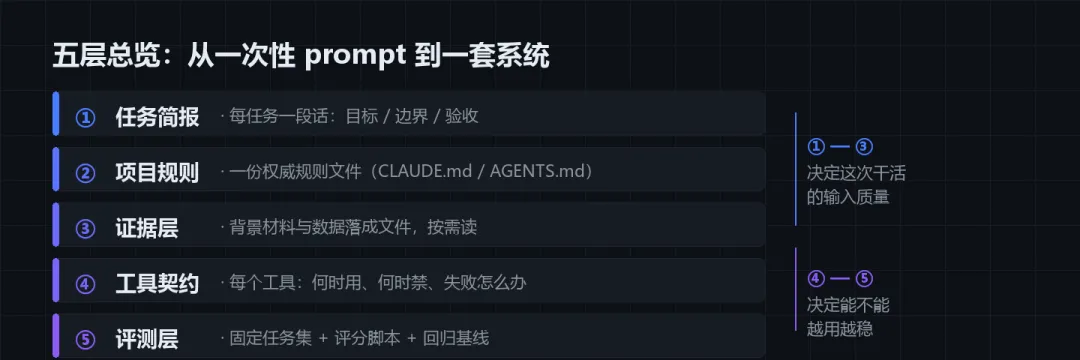
先给全景,再逐层拆:
五层从上往下是"一次任务"到"长期系统"的关系:前三层决定它这次干活的输入质量,后两层决定它能不能越用越稳。
第①层:任务简报——每任务一段话,讲清目标、边界、验收
一句话:接任务前,先用一段话把"干什么、不干什么、怎么算干完"写死。
大部分翻车不是模型不会做,而是它不知道做到哪算完,于是自由发挥。模板直接抄:
【任务】给 utils/date.py 补齐单元测试 【边界】只新增测试,不改实现代码;不引入新依赖 【验收】pytest tests/test_date.py 全部通过;不删减任何现有测试 【先读】tests/conftest.py(了解现有测试写法)再动手关键在"验收"两个字:验收标准必须可判定。"代码质量要好""写得干净点"这种话等于没写,因为判定权在 Agent 自己手里;"测试全绿""不改现有文件"这种才可判定,判定权在你手里。
再补一个老手细节:简报会过期。长任务做到中途,开头那段简报早已被大量中间输出冲淡,所以在关键节点(比如改完一个模块、跑通一次测试之后)要把验收标准重申一遍,再继续往下干。
第②层:项目规则——一份权威规则文件,同一规则只留一个位置
一句话:跨任务都要守的约束,写进项目根目录的规则文件,别每次手打。
Claude Code、Codex CLI 这类 Agent 编码工具,启动时会自动读取项目根目录下的规则文件(如 CLAUDE.md、AGENTS.md),把里面的内容注入上下文。也就是说,这个文件就是你给 Agent 的"项目宪法",写一次,每次会话自动生效。
模板(文件名以 CLAUDE.md 为例):
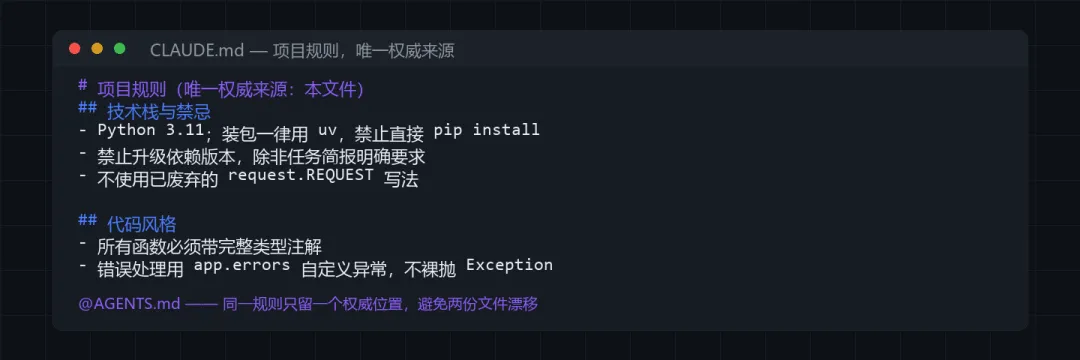
# 项目规则(唯一权威来源:本文件) ## 技术栈与禁忌 - Python 3.11;装包一律用 uv,禁止直接 pip install - 禁止升级任何依赖版本,除非任务简报明确要求 - 不使用已废弃的 request.REQUEST 写法(见 docs/migration.md) ## 代码风格 - 所有函数必须带完整类型注解 - 错误处理用 app.errors 里的自定义异常,不要裸抛 Exception ## 提交规范 - 提交信息用中文,格式:<模块>: <一句话改动>这条有个容易踩的坑:多工具并行时,别维护两份规则文件。Claude Code 自 v2.1.277 起,当项目里没有 CLAUDE.md 时,会尝试读取 AGENTS.md(AGENTS.md 是多家工具都在靠拢的通用约定);如果你要同时服务多个工具,推荐的做法是只维护一份 AGENTS.md 作为权威来源,在 CLAUDE.md 里写一行引用:
@AGENTS.md这样规则只有一个权威位置,不会两份文件各改各的、慢慢漂移。版本迭代较快,具体读取行为以你所装工具的官方文档为准。
写规则的口诀:规则写"约束",别写"背景知识"。"禁止升级依赖"是约束;"我们业务是电商"是背景——背景去第三层。
第③层:证据层——背景材料喂文件,别塞提示词
一句话:长材料、数据、样例,落成文件让 Agent 按需读,不要整段粘进 prompt。
三个理由:
1. 塞进提示词的长材料会占掉大量上下文窗口,挤压真正重要的规则和任务描述;
2. 材料一更新,粘过的旧版本就成了污染源——而文件可以跟着仓库版本走;
3. 提示词是"每次都要说"的,文件是"要用才读"的,成本结构完全不同。
做法:把需求文档、接口说明、样例数据放进仓库固定位置(如 docs/、data/),然后在任务简报里给路径、给阅读顺序:
【先读】docs/requirements/order-export.md 【参考样例】data/samples/export_head.csv(前 20 行即可) 【禁止】不要整目录扫读,按上述顺序读即可原则就一条:给地图,不给全书。你告诉它去哪找、按什么顺序读,比把全书背给它听效果好得多。
顺带补一句:文件也不是无限塞。遇到超大材料,先做一页摘要索引(目录 + 每节一句话),把索引给 Agent,需要细节时再指向具体小节——索引进上下文,全书留在盘上。
第④层:工具契约——每个工具,何时用、何时禁、失败怎么办
一句话:把"工具使用纪律"写成明文,Agent 才不会拿着锤子看什么都像钉子。
Agent 翻车的高发区不是推理,是工具滥用:为了找一个函数把 2000 行的文件从头读到尾;测试挂了不去修代码,反而改测试让灯变绿。这些都是没立契约。模板:
## 工具契约 - 定位代码:先用 Grep/Glob 搜符号定位到行号,再只读相关区段; 禁止全量读取大文件后再人工找 - 超过 500 行的文件:只读任务相关区段 - 跑测试:用 pytest;失败时修复实现代码,最多重试 2 次; 仍失败则停下汇报,禁止修改测试用例让测试变绿 - 联网搜索:仅当任务要求查新版本/新文档时使用,搜索结果需给出处重点说第一条,这是最省钱的技巧之一:用搜索定位代替全量读文件。先 grep 关键符号拿到行号,再只读那几十行——一个两千行的文件全读一遍和只读三十行,上下文占用完全不是一个量级。上下文窗口是预算,Agent 每读一个文件都是在花这笔预算;预算花在读代码上,就剩不下多少留给思考和规则了。
第⑤层:评测层——最小 eval,让"改好了"变成可证明的事
一句话:固定任务集 + 评分脚本 + 回归基线,改任何提示词/规则后跑一遍,好坏立刻见分晓。
这是五层里最容易被跳过、但价值最大的一层。没有它,你每次调 prompt 都在凭感觉:"感觉好像好点了?"——感觉是最不可靠的回归测试。
最小 eval 只需要三个件,二十分钟能搭完:
第一件:固定任务集。从你日常真实任务里挑 5-10 条有明确判定的,存成 tasks/eval/cases.jsonl,每行一条:
{"id": "case-001", "task": "把 orders.py 里的手写日期解析换成 dateutil", "check": "python check_scripts/check_001.py"} {"id": "case-002", "task": "给 utils/date.py 补齐 parse_ts 的单元测试", "check": "pytest tests/test_date.py -q"}check 字段是一条可以在命令行跑的判定命令:要么是现成的测试,要么是一个十几行的校验脚本(检查产出文件是否存在、关键内容是否匹配、被禁写法是否未出现)。注意 JSONL 格式一条记录占一行,上面的示例即按此格式。
第二件:评分脚本。run_eval.py,先无头执行任务,再跑判定,完整可跑:
import json, os, subprocess results = {} for line in open("tasks/eval/cases.jsonl", encoding="utf-8"): case = json.loads(line) # 无头执行任务;换工具(codex exec / cursor agent 等)只改这一行 try: subprocess.run(["claude", "-p", case["task"]], timeout=600) ok = subprocess.run(case["check"], shell=True).returncode == 0 except subprocess.TimeoutExpired: ok = False # 超时按 FAIL 记,不卡死整批 results[case["id"]] = ok print(case["id"], "PASS" if ok else "FAIL") os.makedirs("results", exist_ok=True) json.dump(results, open("results/latest.json", "w"), indent=2)执行与判定是解耦的:claude -p 是 Claude Code 的无头模式,把任务交给 Agent 跑完再退出;你用其他工具的,把这一行换成 codex exec、cursor agent 等对应命令即可,评测逻辑一行不用动。
第三件:回归基线。第一次跑完后,把 latest.json 复制为 results/baseline.json 存档。以后每次改了提示词、规则或工具契约,重跑一遍,再跑对比脚本 compare_baseline.py,和基线逐项对比:
import json latest = json.load(open("results/latest.json")) baseline = json.load(open("results/baseline.json")) for k in latest: if latest[k] and not baseline.get(k): print(k, "IMPROVED") elif baseline.get(k) and not latest[k]: print(k, "REGRESSION") # 出现这个,立刻回滚你的改动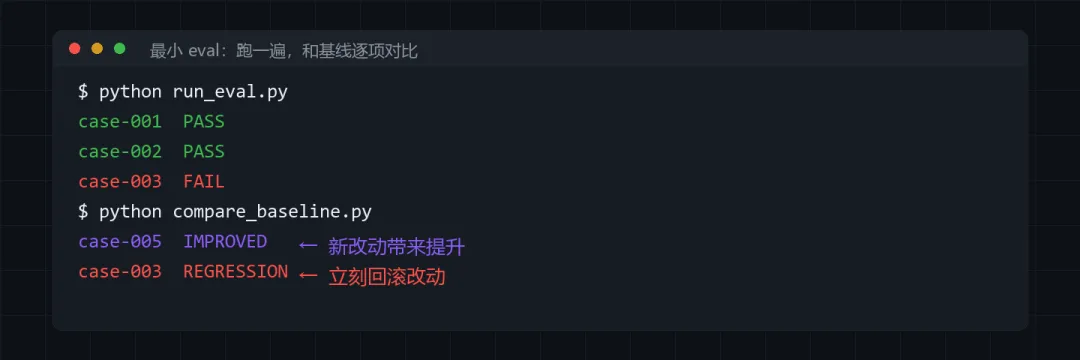
三条使用纪律:
1. 判定用命令行,不用 LLM 打分。LLM 评分自己都不稳定,跑两次结果都不一样,基线就没意义了;命令行判定才可复现。
2. 任务集冻结。eval 里的任务不许随手改,改了就等于换了考卷,基线作废。要加新任务,加完重存基线。
3. 先有再好。5 条粗糙但稳定的用例,远胜过 50 条永远"下次再补"的完美方案。你要的不是完美评测,是回归。
常见反模式自查
重复规则——同一条约束在简报、规则文件、对话里各写一遍,改规则时漏掉一处,Agent 收到矛盾指令。解法:一个权威位置,其他地方只引用。
规则塞提示词——每次开新会话都把"项目规范"粘贴一遍。解法:下沉到第②层规则文件,自动注入。
验收不可判定——"优化一下这段代码""写得专业点"。解法:换成可判定语句——测试通过、不改某文件、输出包含某字段。
喂整本书——把几十页文档整个粘进上下文。解法:落成文件,简报里给路径和阅读顺序。
无基线裸奔——改 prompt 靠印象判断好坏。解法:把第⑤层的二十分钟花掉,一劳永逸。
模型的上限你决定不了,但模型每次"带什么脑子"上场,从第一层到第五层,都由你决定。
Agent 时代的分水岭,不在你会不会写 prompt,而在于你把 prompt 当一次性的消耗品,还是当一套可以版本化、可以回归测试的系统。前者每次都在抽奖,后者每次都在迭代。
这是「手把手实操」栏目的新一期。下一期(第 02 期),我会拿一个真实的编码任务,从空目录开始,把这套五层模板一层一层实际搭出来、跑通一遍,包括中间踩的坑。
如果你已经在用 Agent 干活,建议今晚就先把第②层规则文件和第⑤层最小 eval 建起来——这两层的投入产出比最高。搭的过程中卡在哪一层,欢迎留言区交流,下期选题也会优先从大家的卡点里挑。
小刚爱AI · 把 prompt 变成系统AI 工具深度实操,只写给已经会用 AI 的你