ARTICLE · 1200795
AI读了资料,为什么还写错旧站名?
Ty的AI Coding实操手册 · 第 7 期
让 AI 写一篇末班车故事,题面只要求一个很轻的结尾:老人打开蓝色饭盒,认出孩子画在路线图上的旧站名,故事到此停住。有一份答卷先写图上方块旁是“现在这站的名字”,接着又说孩子记的是“老站名”;结尾还让司机在下一班车继续报站。字句通顺,甚至有画面,但同一个站名的新旧身份前后打架,收束位置也越过了题面。
更值得检查的是,这份答卷所属的运行确实读了知识卡,也成功加载了指定 Skill。资料进了工作区,工具调用成功,最终文本却仍有硬事实问题。若我只看运行页的绿色完成状态,或只看模型末尾自述“都读过了”,很容易把“资料已被调用”误当成“作品已经合格”。
这期我想回答一个实际问题:给 Agent 加知识库,怎样知道它真的帮上忙?我的验收分三层:先锁题面和资料来源,再核工具是否实际读取,最后把交付原句、硬事实和成本放在一起看。这样的检查不需要先相信一个总分,也不需要把某次失败直接归罪于 Skill。
先看同一题的三份答卷
这组故事题编号 ST01。题面里,林澄是女司机,在末班车捡到蓝色饭盒;第二天按规定交到车队失物处,老人第三天来领。饭盒里不是钱,而是孩子画的路线图。结尾必须停在老人认出图上的旧站名,两人不去找孩子。这些条件不要求写得华丽,却会决定故事的时间线、人物身份和最后一幕是否成立。
同题第一轮有 A、B、C 三个独立工作区。A 没有知识卡和 Skill,只读取题面与入口文件;B 配固定知识卡;C 配与 B 相同的知识材料,另加指定工作区 Skill。三份都用了同一个模型配置,且在这批记录中都显示技术执行完成。所谓“完成”是运行终态,不是文章合格证。故事原答、题面和每次工具调用都留在对应运行 ID 的历史文件里,避免不同轮次互相补洞。
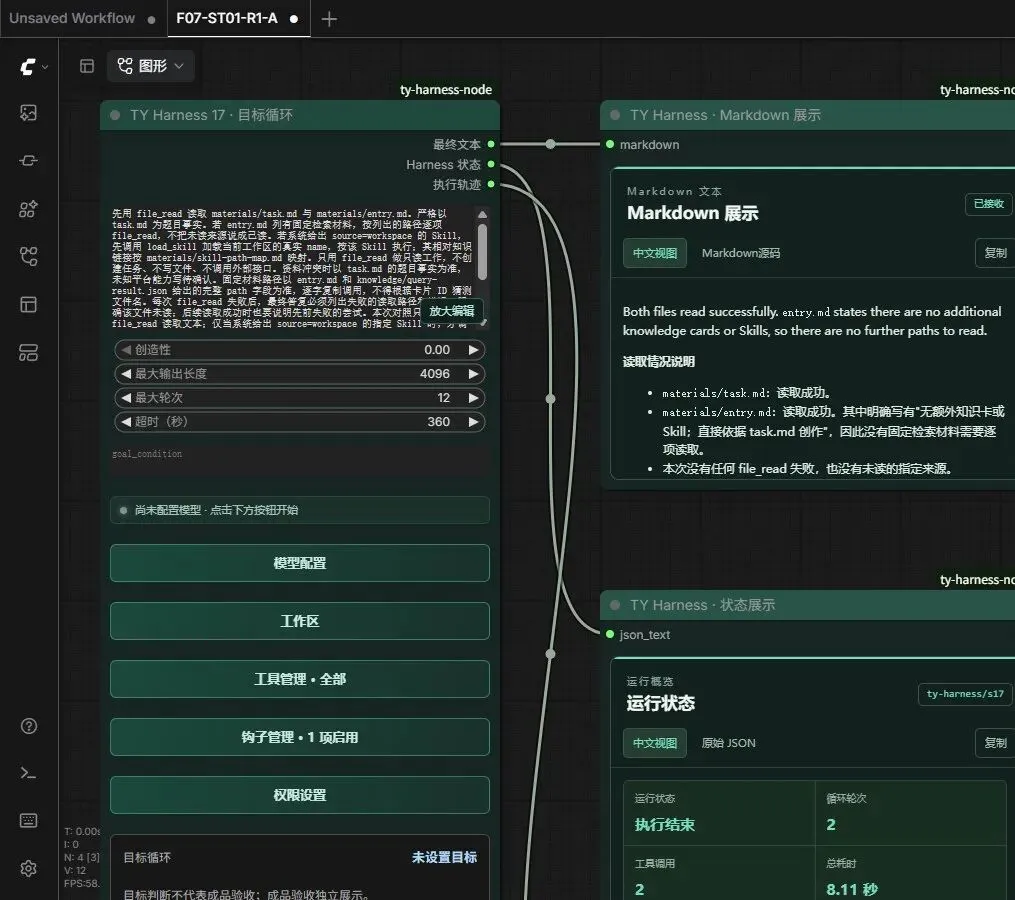
真实 ComfyUI 运行后截图,F07-ST01-R1-A,原图左侧局部裁切;只能显示工作流与部分答卷,不能单独证明工具调用内容。
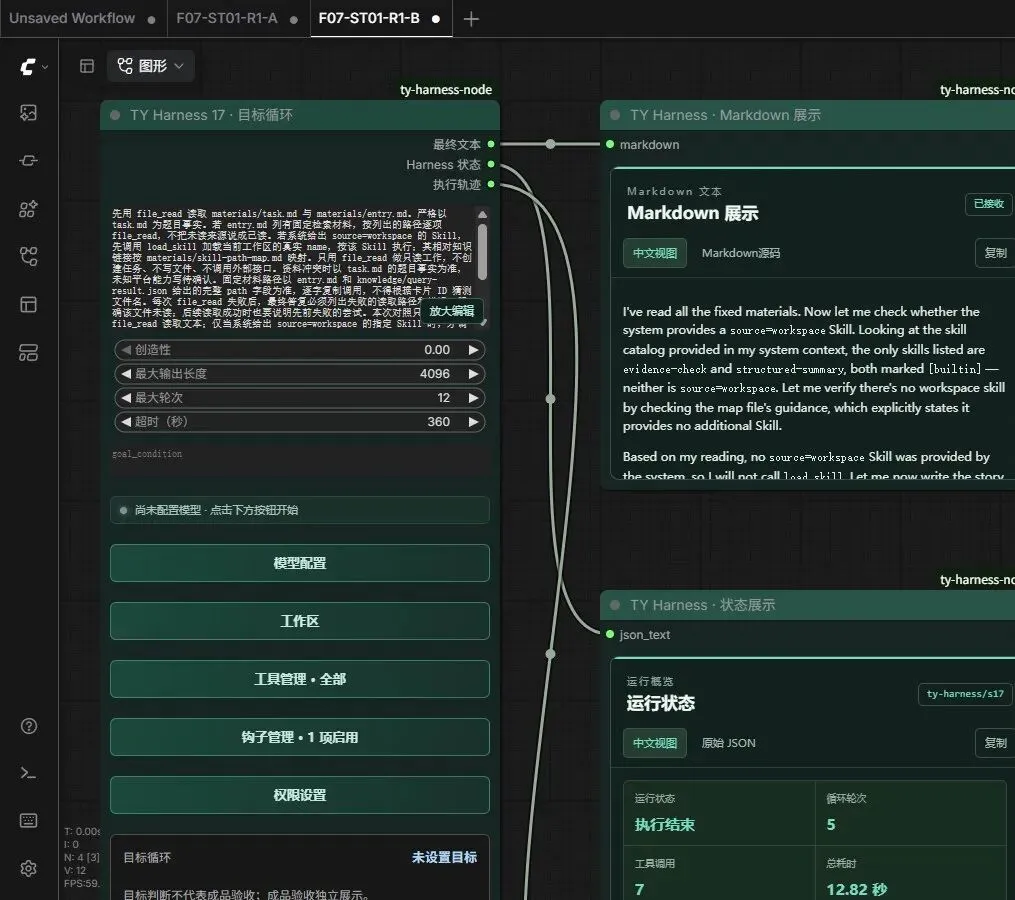
同题同轮 B 组原始运行截图局部。B 的知识卡读取结论来自同根 history.json 的工具回执,不从画面推断。
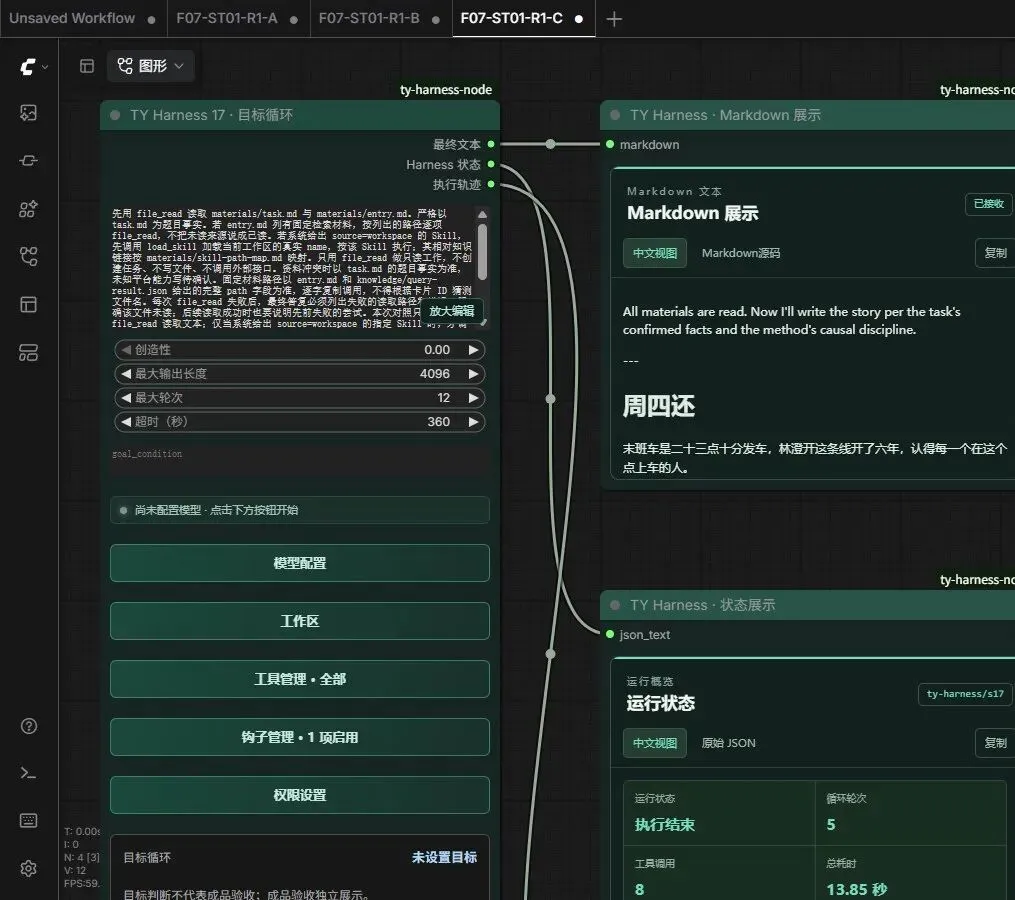
同题同轮 C 组原始运行截图局部。图上“执行结束”仅为技术状态;下文另外检查最终故事的硬事实。
A 的故事把饭盒多留了一天:它先设定当天是周二,随后写周三晚上老人没来,周四一早才交失物处。题面要求“第二天”交,按它自己的星期设定就应该是周三。它还把女司机写成“他”。编辑侧独立核读指出这些问题,自动文本评阅也把这根判为致命事实错、给 2.00/5。这不是我亲自打的分,我在正文里把评阅来源和原句分开说明。
B 写了“第二天一早,她按车队规定,把饭盒交到失物处”,至少在上交流程和主角称谓上守住了关键条件。自动评阅给 3.50/5,没有标致命错。但 B 对老人来领只写“周四那天”,没有先给拾获的具体星期;我不能仅凭这句宣布第三天这个时间条件已被明确落实。它比 A 的这处错误更少,不等于全部硬事实满分。
C 的故事更像一篇完整作品:饭盒、老人、车窗和站名都有连续的画面。然而答卷说图上写的是“现在这站的名字”,又让老人说“他记的是老站名”,同一处线索到底写新名还是旧名无法自洽。结尾又走到第二天末班车报站,超过题面规定的停点。自动评阅给 2.00/5,标了致命错;编辑侧独立核读把冲突定位到原答句子。对我来说,决定是否采用这篇的不是它读过多少资料,而是这两句能否同时成立。
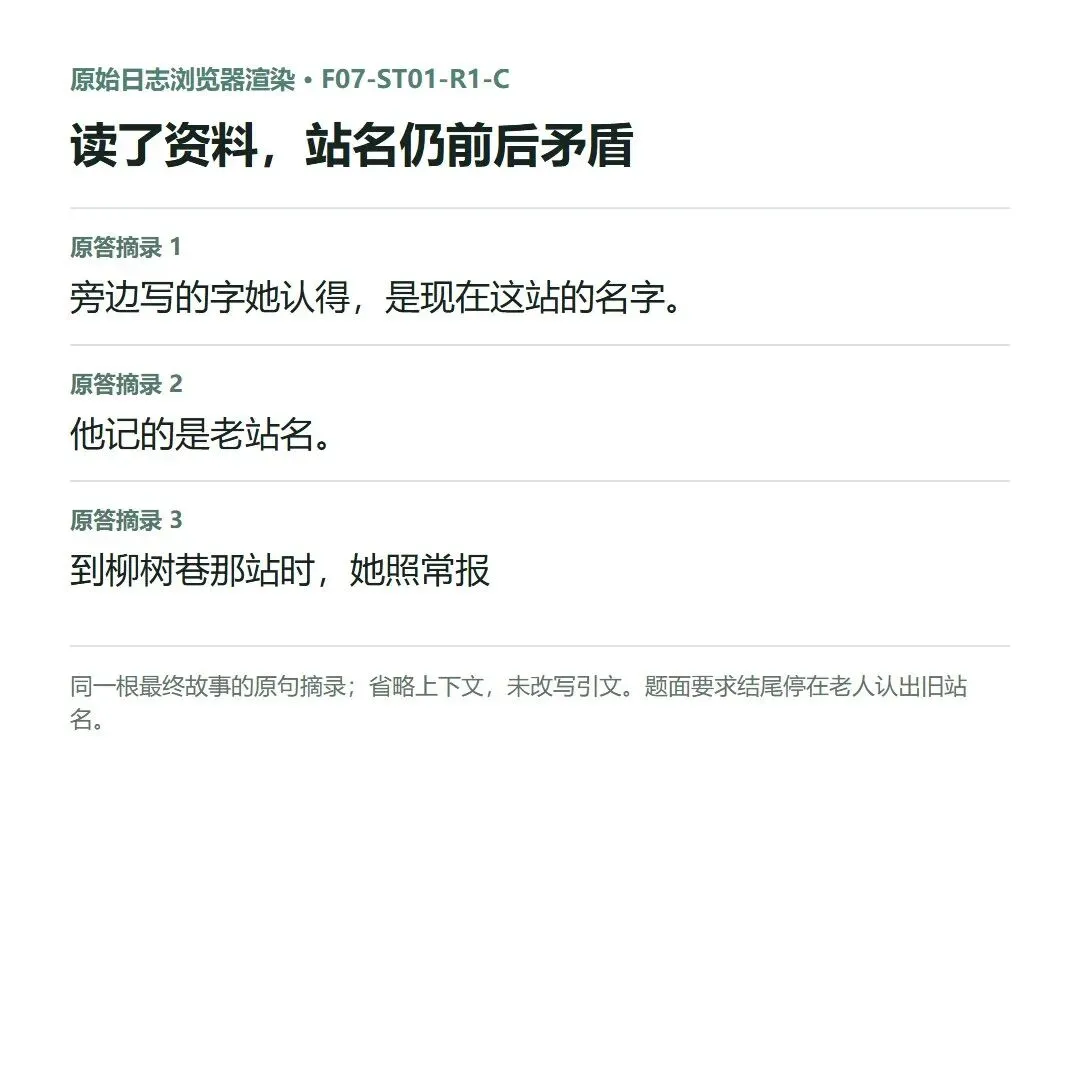
原始 history.json 中 F07-ST01-R1-C 最终文本的浏览器渲染摘录;保留原句与运行 ID,隐藏工作区绝对路径。是日志渲染截图,不是 ComfyUI 原生截图,也不是改写后的故事。
第一关:知识从哪里来,题目到底锁了什么
“装了知识库”并不是一个可检查的条件。至少要知道这次任务问什么、哪张卡与它相关、卡的版本和摘录来自哪里。ST01 的题面要求是人物、时间线、道具和结尾停点;知识卡提供故事因果与修改方法。方法材料可以帮助组织叙事,但不能覆盖本题已经确定的硬事实。若卡片与题面冲突,我会优先查清版本和来源,而不是把卡片数量当权威。
正式批次把 12 道题、A/B/C 三个条件和两轮安排事先写进预登记,共 72 根独立工作区。B 与 C 在同题同轮使用同一组知识材料,C 额外装配指定 Skill。这里的设计价值,是给“加料”留一个无知识基线,也防止看到一篇漂亮答卷后才改题、换模型或挑轮次。但它并不能让复杂的文本创作自动变成单变量因果实验:C 多的不只是一个按钮,而是额外方法、工具调用、上下文和生成轨迹。
知识卡本身也有边界。源项目对 30 张卡做过来源结构核验,但逐张语义人工核读还没有完成。结构上有出处,不能推导每条方法都准确、适配当前题目。我的第一关因此不写“知识库可信”四个字,而记下题面版本、候选卡片、来源摘录与不能越过的硬事实。如果资料还没核读,我会把它放在候选方法的位置,而不是把它升格为事实裁判。
这一步很容易被忽视,因为文件路径看起来特别像证据。提示词里写着某张卡的路径,只说明模型被告知路径;索引检索命中,只说明系统找到了候选;把卡片内容塞进上下文,又与工作区里真实调用 file_read 是不同条件。先把这些动作分开,第二关才有可查的工具账本。
第二关:它有没有真的读到,而不是说自己读过
我会从每根 history.json 找工具请求和回执,而不从模型自述倒推。ST01 第一轮,A 有 2 次 file_read,只读题面和入口;B 有 7 次工具调用,读到检索索引、知识卡、来源摘录、路径映射和详版指南;C 有 8 次,除同组知识材料外,load_skill ty-short-story 也成功,目录状态为 loaded=true。这个差别是具体工具事实:读什么、是否执行、返回什么状态,都能逐项追到调用 ID。
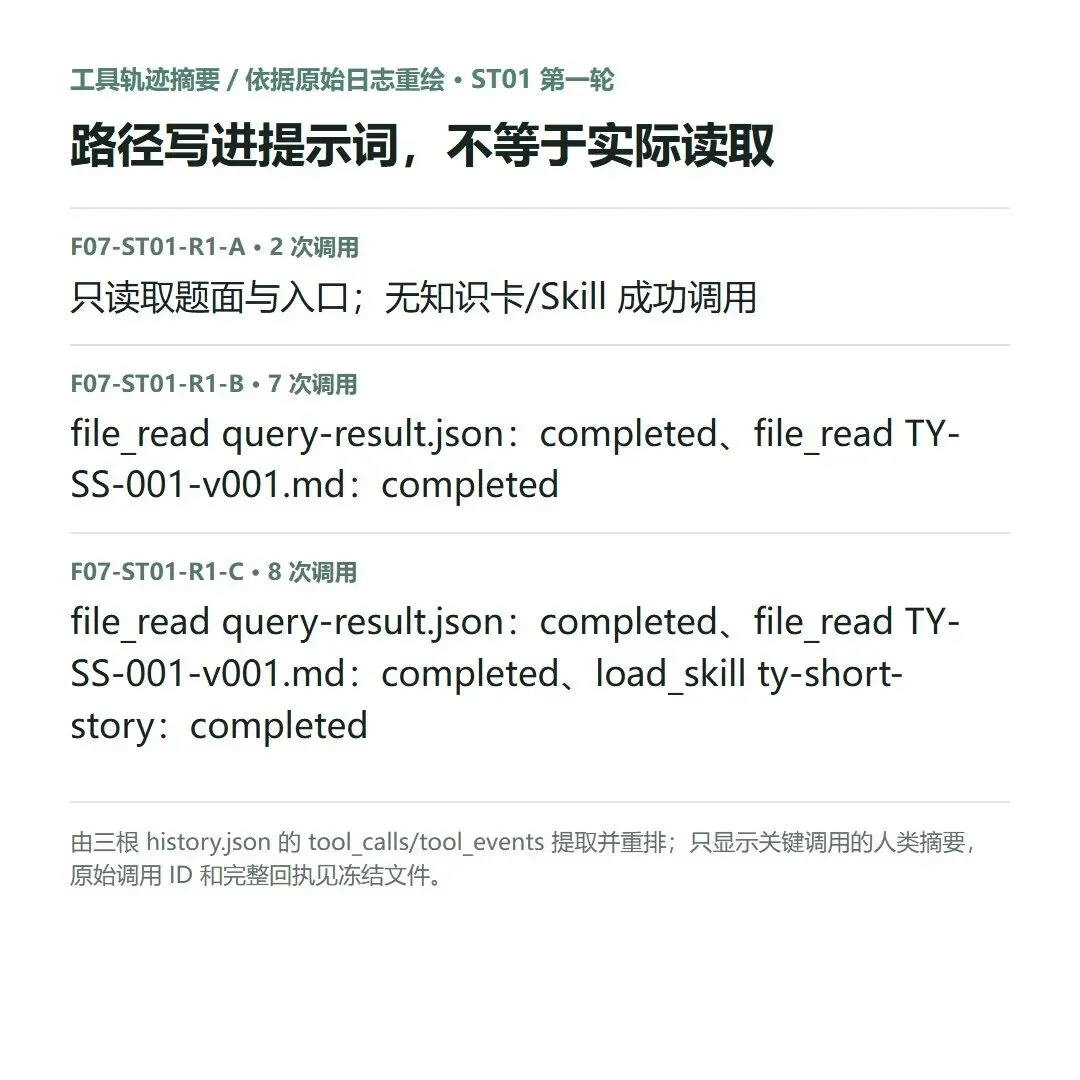
根据三根原始 history.json 的 tool_calls / tool_events 提取并重绘的调用摘要;为手机阅读只显示关键文件类别、状态及调用次数。图内不是原始工具日志截图,完整调用 ID 与回执仍在冻结的 history.json 中。
为什么要看返回?因为一个 Agent 可能尝试读取不存在的路径,也可能把索引里出现的卡名当成已经读完的正文。真实成功回执与失败请求必须分开记;Skill 被列在可用清单,也不等于这一根真的调用 load_skill。这次 C 的加载是成功的,所以旧站名错误不能用“根本没读到”解释。但同样不能倒过来说“正是 Skill 害它写错”:模型在取材、取舍和写作时有多处同时变化,原始记录没有隔离出那一个原因。
运行页截图保留了 ComfyUI 工作流的身份和终态,是必要的现场证据,却不适合拿来证明每个 tool_result 的内容。为此我从原始 JSON 提取关键调用,重绘成便于手机阅读的摘要图,并在图上标清身份。它不是原始日志截图;完整调用、回执和哈希仍在本地证据包供回查。截图、工具账本、文本输出各管一层,避免一张绿色状态图承担三种结论。
第三关:最终交付守住了什么,付出了多少
第二道题 ST02 更能说明“它自己承认错了”也不等于交付已改正。题面要求修钟学徒阿黛有船票,但师父事先不知道;她最终坦白想留下的是修钟手艺,钟响后仍登船。第一轮 C 成功读取知识卡并加载 Skill 后,故事正文却让师父说:“我早知道。船票露在你枕头外面三天了。”这句直接冲掉了题面的人物知情边界。
更特别的是,C 在故事后附的说明里自己写出“师父‘早知道船票’的台词与题目事实冲突”,并建议改写。但正文没有交出修订版。如果我只看最后那段自我检查,会以为错误被发现就算解决;真正要发给读者的故事仍保留了那句台词。交付验收必须指向最终作品,不让解释段替正文补票。ST02 的 A、B 正文分别写“师父不知道船票的事”“他不知道船票的事”;这只是同题第一轮两处事实对照,不是对 A/B 整体文采的判定。
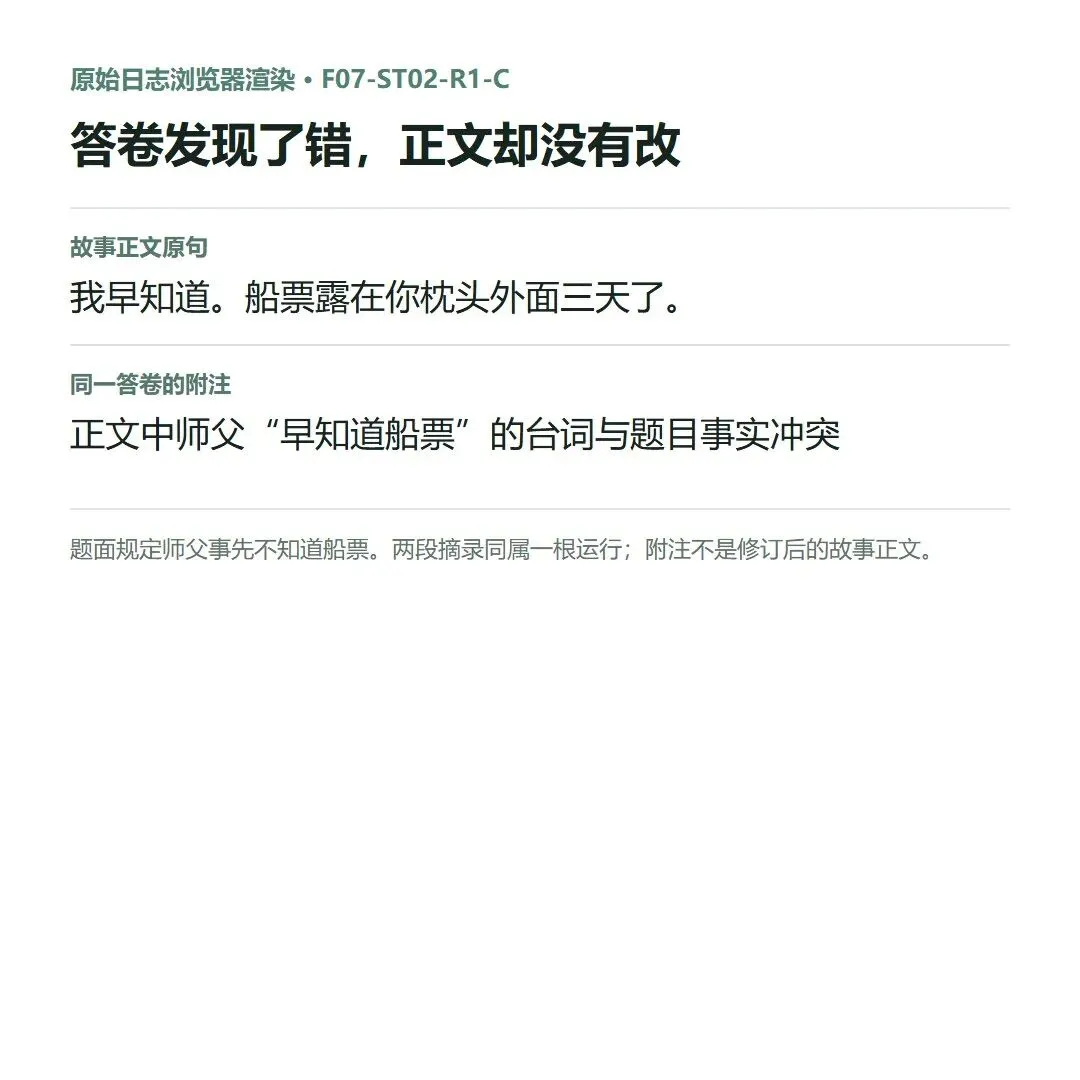
F07-ST02-R1-C 原始 history.json 最终文本浏览器渲染摘录:左侧为故事原句,右侧为同一答卷附注。两段均来自同一根,附注没有替换正文。
这时再看全批次才比较稳。72 根都达到了 S17 的 completed 技术终态,A/B/C 各 24 根;这不表示 72 篇创作都通过。去条件自动文本评阅的均分是 A 4.138、B 4.254、C 3.896,满分 5。B 相对 A 只高约 0.12,未达到预设的 +0.5 增益门槛;C 相对 A 低约 0.24。自动评阅标出的致命错误根数分别是 2、0、4。分数与致命错来自自动文本评阅,编辑侧人工核读只覆盖这里展示的 ST01/ST02 第一轮六根关键事实,不是我亲自评分,也不是全 72 根人工复评。
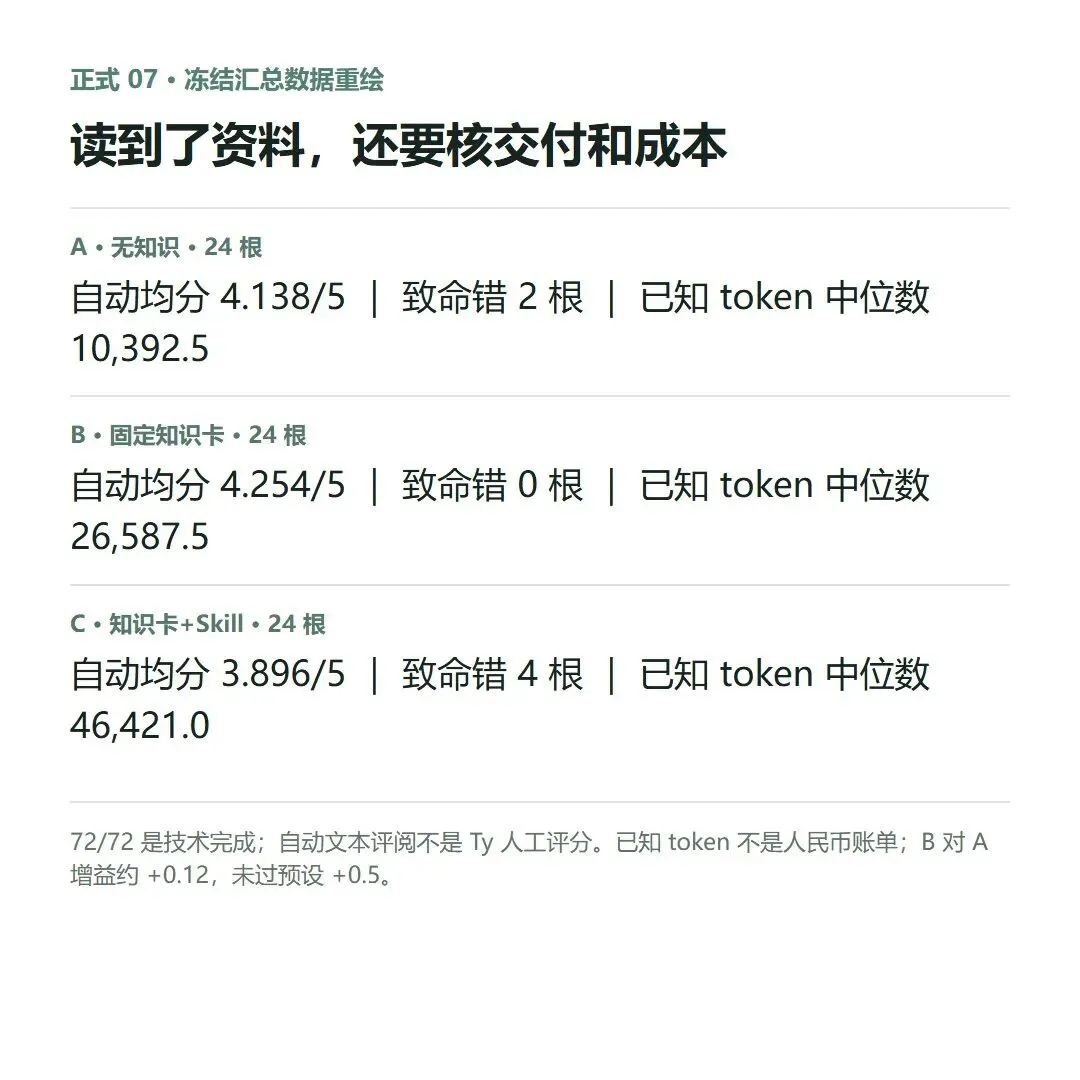
依据冻结的 text-review/aggregate.json 和 runtime-aggregate.json 重绘;自动评阅、致命错根数与已知 token 中位数分栏呈现。不是 ComfyUI 原生截图,不是人工双盲,也不是人民币花费。
成本同样不能藏起来。全批已知 token 中位数 A 为 10,392.5,B 为 26,587.5,C 为 46,421;耗时中位数约 11.10、14.61、18.74 秒。ST01 第一轮的单根账本也给出 A 9,750、B 35,818、C 37,098 已知 token,对应 2、7、8 次工具调用。它们说明这次取材和加载付出了更多上下文与调用成本,但“已知 token”不是最终结算金额,耗时也受运行环境影响。我不会以其中一根的比例估算所有任务的价格。
把质量与成本并列,是为了避免另一个常见误判:如果多读几份资料后均分只微升,调用量却明显增加,这是否值得,要看具体任务有没有守住必须正确的事实,以及下一步是否真会采用交付物。本批 B 没过预设增益门槛,C 又有更多致命错,只能说在此题集、模型、知识版本和评阅口径下,尚不足以证明额外材料带来了稳定可用的增益。不能推出“知识库整体无效”,也不能推出“Skill 普遍有害”。
把三道验收变成自己能复做的记录
下一次我给 Agent 装知识库,会先留一份不带知识的同题答卷。题面写清人物知道什么、日期如何推进、哪个结尾不能越过;知识卡记录版本和来源。这样即使新增资料后的文本变得更流畅,我仍能回到同一把尺子。换题、改模型或临时修改资料,再漂亮的差值也不再是这组同题对照。
正式运行时,我会逐根保留六栏:题面与基线、硬事实、知识卡与来源、实际 file_read/load_skill、最终输出逐句核对、已知 token 与耗时。第一栏确认比较对象,第二栏把“不能错”写在生成之前;第三和第四栏分别问“资料是什么”“资料是否真的进入了这根运行”;第五栏只读交付原句,不能让模型自己的总结代答;第六栏计算为这次改善付出的代价。若某根读取失败,我会把失败路径和回执留在账本里,不能悄悄归入“已读知识”的条件。
核读时也不必把每一句都交给抽象审美分数。我先找两三条会让作品失效的硬事实:性别、日期、金额、人物知情、结尾停点。逐条写成“题面约束—答卷原句—判定”。ST01 的新旧站名与 ST02 的船票知情都是这种可定位的错。随后再讨论节奏、文风和可执行性。如果事实还没守住,文学表达的高分不能替它通关;若事实都守住,也不能只凭硬约束宣布故事有感染力。
最后我会把三种结果分开报告。工具执行是否完成,是技术层;故事或方案是否符合题面,是内容层;读者是否喜欢、能否拿去制作,是使用层。本期的 72/72 只属于第一层,自动文本分属于第二层的有限代理,尚没有图像、视频成品和读者盲评去支持第三层。自主发现任务也未运行,30 张卡仍缺逐张语义核读。这些缺口不该在结论里缩成一个小脚注,因为它们决定了这篇方法能说明到哪里。
我最后保留的判断很朴素:资料被找到、被读取、被正确使用,是三个不同事件。ST01-C 的工具记录能证明前两步发生,旧站名矛盾提醒我第三步还要单独验;ST02-C 的自我纠错说明,指出问题也未必意味着交付已经改好。给 Agent 加知识库之前,我先把题面和验收表写好;加完以后,我仍然看原答、看工具回执、算成本。这样知识库才是可被检验的工作材料,而不是贴上去就自动变准的标签。