ARTICLE · 1200922
中国 AI 只会搞短剧和娱乐?一张图暴露了多少人的技术无知
最近有一张图传得很广:
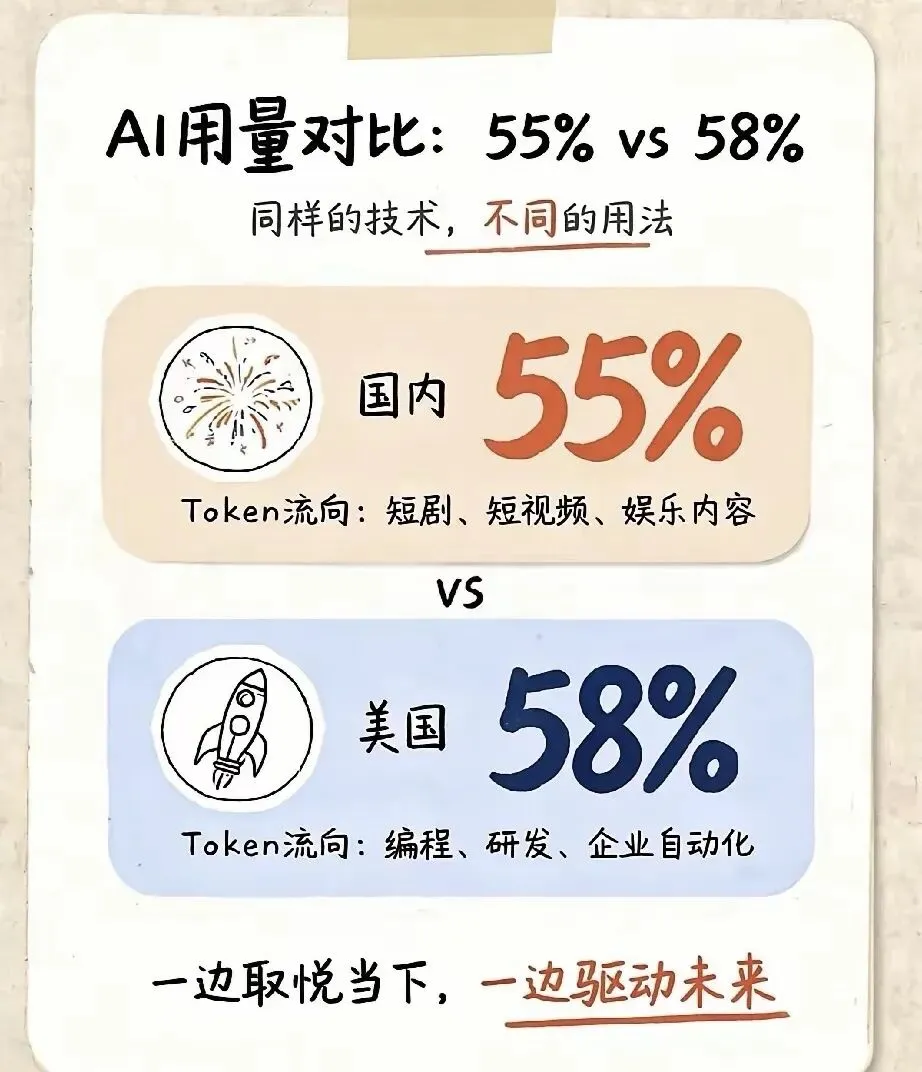
图上说,国内 55% 的 Token 流向短剧、短视频和娱乐内容,美国 58% 的 Token 流向编程、研发和企业自动化。最后配了一句话:
"一边取悦当下,一边驱动未来。"
看起来很有道理,也很容易激起情绪。
但作为一个做了十几年软件工程、现在每天都在用 AI Coding 和 Agent 工具的程序员,我觉得这张图的结论不但武断,背后还有好几个明显的技术误读。
它默认了一个从来没被证明过的前提:美国人在用 AI 创造生产力,中国人在用 AI 消遣。
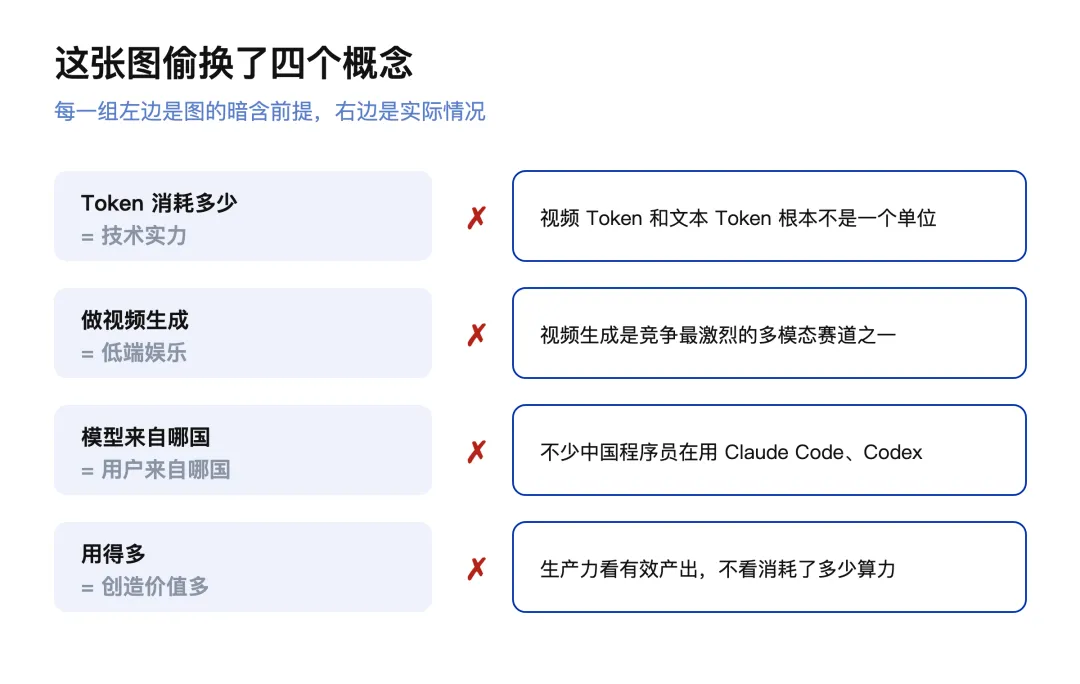
拆开来看,它至少偷换了四个概念:把 Token 消耗当成技术实力,把视频生成当成低端娱乐,把模型的国籍当成用户的国籍,把用量当成生产力。下面一个一个说。
一、先问一句:55% 和 58% 是从哪来的?
我首先关心的不是这两个数字高不高,而是它们从哪来。图上没有统计机构、没有样本范围、没有时间,也没说 Token 是怎么算的。
我顺着往回查了一下,结果很有意思:
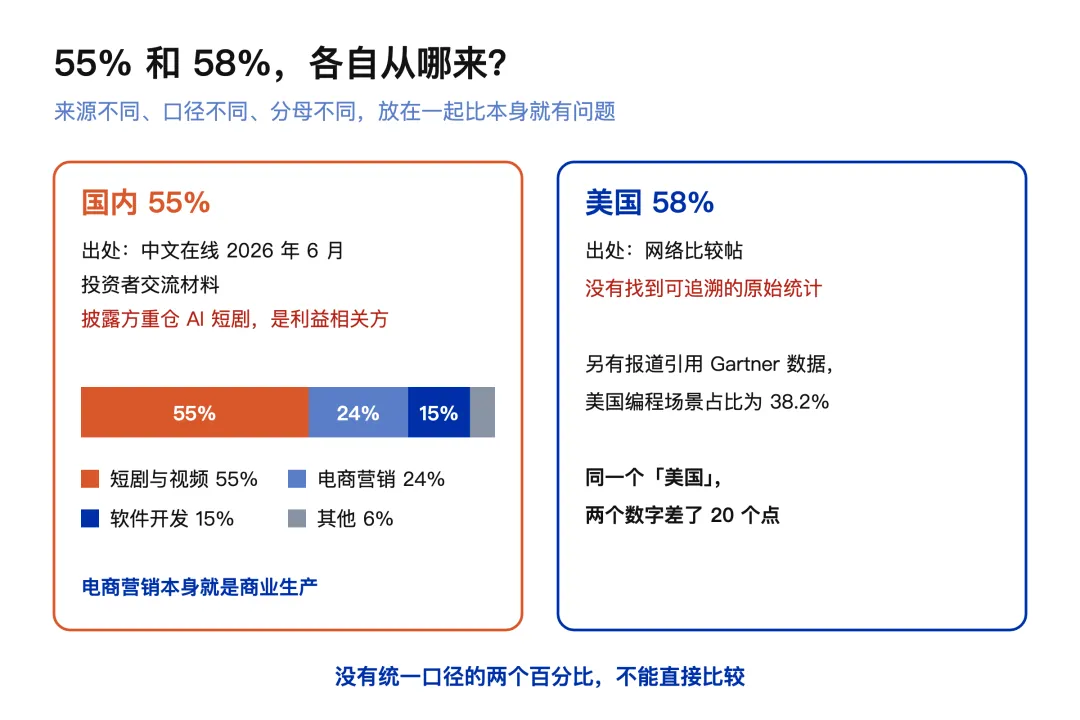
国内的 55%,据凤凰网、虎嗅等媒体追溯,出自中文在线 2026 年 6 月的投资者交流材料:AI 短剧与视频生成占 55%,电商与营销占 24%,软件开发占 15%,其他占 6%。
问题在于,中文在线自己重仓 AI 短剧,是这个数字的利益相关方,不是中立的统计机构。而且另有报道引用中国信通院的监测,说微短剧相关的 Token 占比是 32.7%,和 55% 差得不小。
美国的 58%,我没找到可以追溯的原始统计,最早只能追到网上的比较帖。另有报道引用 Gartner 的数据,说美国编程场景的占比是 38.2%。同一个"美国",两个数字差了 20 个点。
就算这些数字都是真的,还有四个问题绕不过去:
- 统计的是哪个平台?
包不包括海外模型、私有化部署和开源模型的本地推理? - 按用户算,还是按模型算?
这一点后面专门讲。 - Token 怎么分类?
电商公司用 AI 做商品视频、游戏公司做素材、影视公司缩短后期周期,算娱乐还是生产? - 分母是什么?
两边覆盖的用户、算力和计量方式都不一样,百分比没法直接比。
还有一个讽刺的细节:就按中文在线自己的数据,电商与营销占了 24%,这本身就是实打实的商业生产。图里只挑了 55% 那一块。
一组口径不明、来源有利益关系的数据,被包装成了国家科技竞争的结论。这个逻辑首先就站不住。
二、同样叫 Token,算的根本不是一回事
很多人看到 Token,会下意识地认为每个 Token 都一样。其实不是。
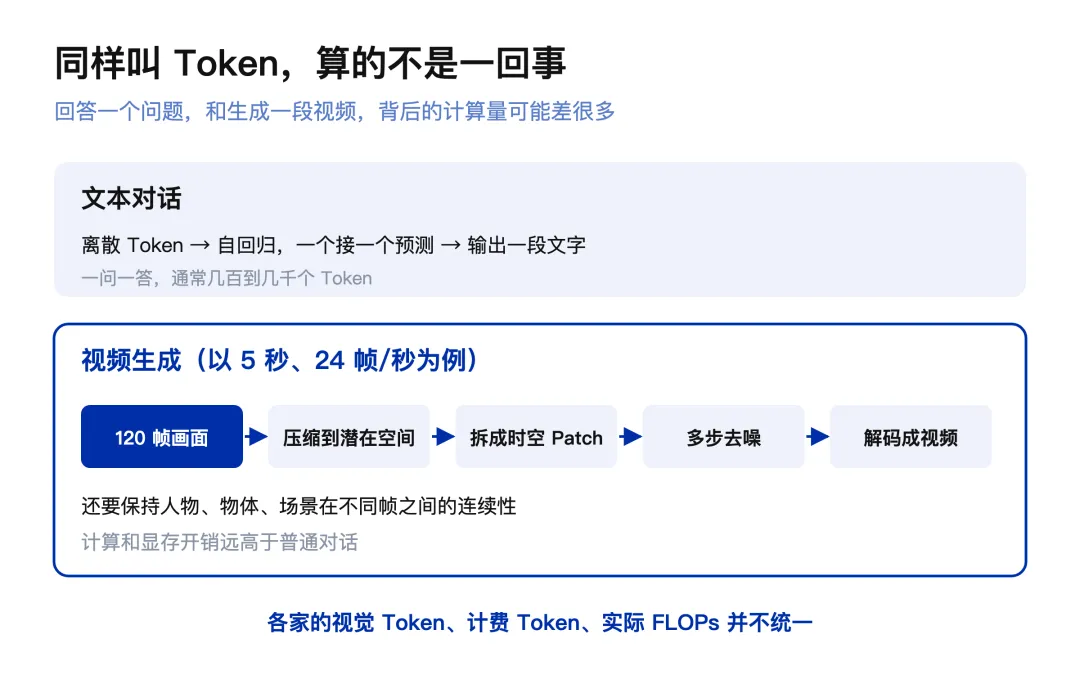
文本模型处理的是离散的 Token,一个接一个往后预测,一问一答通常就几百到几千个 Token。
视频生成完全是另一套。OpenAI 在 Sora 的技术报告里介绍过一种做法:先把视频压缩到潜在空间,再拆成时空 Patch,交给扩散 Transformer 生成。
举个例子,生成一段 5 秒、每秒 24 帧的视频,意味着要产出 120 帧画面,还要让人物、物体、场景在不同帧之间保持连续。很多扩散模型还要多步去噪,最后再解码成视频。计算和显存的开销,比一次普通对话高得多。
所以,一个国家的视频生成需求旺盛,Token 占比自然会被视频本身的计算密度推高。 这反映的是需求结构,不是"一半的 AI 资源都拿去娱乐了"。
但也要说清楚:不能简单说一个视频 Token 等于多少个文本 Token,也不能断言每次视频生成都比 Coding Agent 更耗算力。 一个跑几十轮、反复读代码仓库、跑测试的 Coding Agent,同样能烧掉海量 Token。各家的视觉 Token、计费 Token 和实际 FLOPs 本来就不统一。
正确的比较方法,是分模型类型核算实际计算量、服务成本和产出的价值,而不是把所有 Token 混在一起,按应用名称排高低。
三、视频生成恰恰是中国最强的赛道之一
这张图最荒唐的地方,是把视频生成和娱乐消费画上了等号。
事实上,视频生成是当前生成式 AI 竞争最激烈、技术门槛最高的方向之一。看看排行榜:
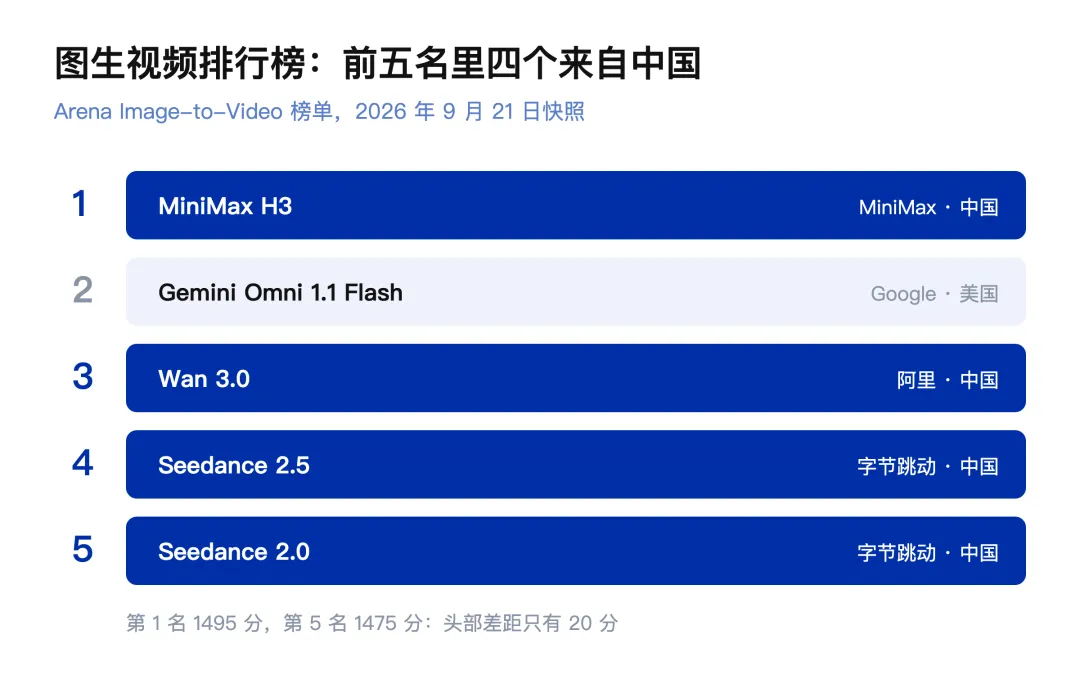
在 Arena 图生视频榜单 9 月 21 日的快照里,前五名有四个来自中国:MiniMax H3 排第一,阿里的 Wan 3.0 第三,字节的 Seedance 2.5 和 Seedance 2.0 分列第四、第五,唯一的例外是 Google 的 Gemini Omni 1.1 Flash。文生视频榜上,Google、xAI 占着前面的位置,但 Seedance、Wan 也都在前十之内。
所以准确的说法是:中国在视频生成的部分细分方向已经领先,整体上也是全球最强的竞争者之一。 说中国全面领先美国不对,但把中国的视频 AI 描述成"只会搞娱乐的低水平技术"更不对。
视频生成要解决的是运动一致性、时空建模、物理规律模拟、主体身份保持、多镜头一致性和音画同步。这些能力可以用在广告、影视、数字人、游戏,也和仿真、机器人、具身智能的研究相关。当然,能生成逼真的视频不等于模型真正理解了物理世界,但说它没有技术含量,是低估了多模态的难度。
反过来问一句:如果中国真的只会用 AI 搞娱乐,这些全球一流的视频模型又是谁做出来的?
四、模型从哪来,不等于用户在哪里
还有一个很现实的问题:中国程序员不用 AI Coding 吗?
我自己的日常开发就离不开 Claude Code、Codex。复杂的代码修改、重构、测试、Agent 工作流,AI 已经是实打实的生产工具。我身边不少开发者也是这样,具体比例需要调查,我不凭个人经验推算。
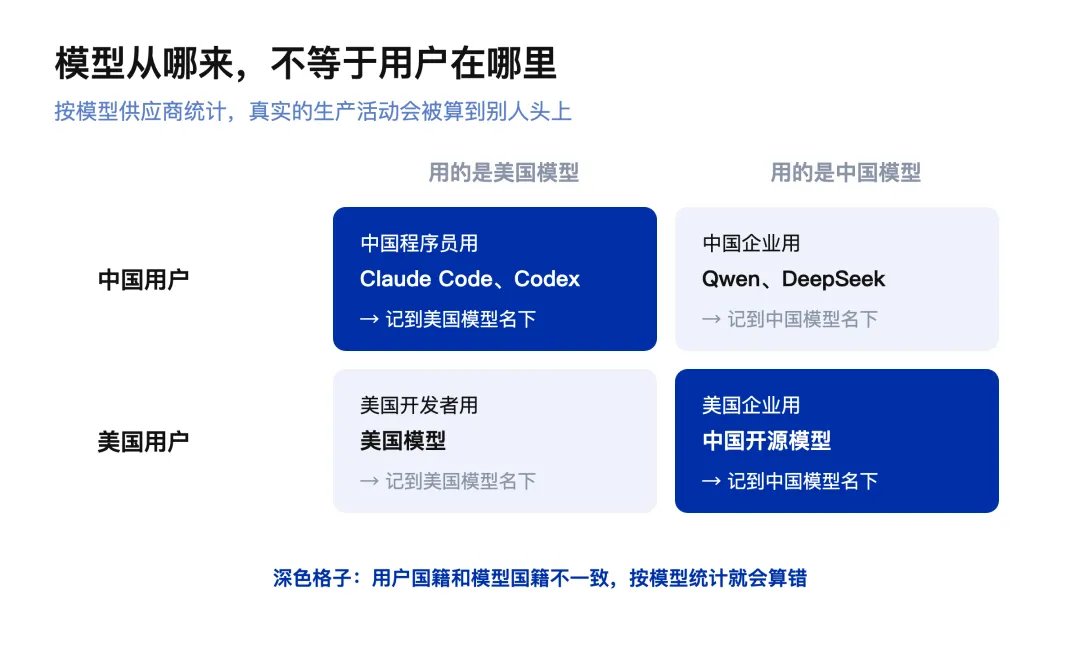
关键在于:中国程序员用美国模型产生的 Token,在很多统计里会被算成美国模型的用量。 反过来,美国企业用 DeepSeek、Qwen 这些中国开源模型,又会被算到中国模型名下。
更复杂的是,现在的 Coding Agent 往往不是单模型系统:一个模型做规划,一个模型写代码,再通过工具编译、测试、部署。任务发生在中国企业的研发环境里,请求却可能经过海外服务商。再加上企业自建的模型服务、离线部署和本地推理,按"哪国模型"统计,必然漏掉大量真实的生产活动。
所以,AI 的模型供给能力和应用能力,必须分开看。 中国企业用美国模型写软件,依然是中国企业在用 AI 提升效率;美国公司用中国开源模型,也不能说美国企业没创造生产力。AI 本来就是一条全球化的供应链。
五、别忘了,中国本来就在更紧的算力约束下
中美 AI 竞争,还有一个绕不开的变量:资源。
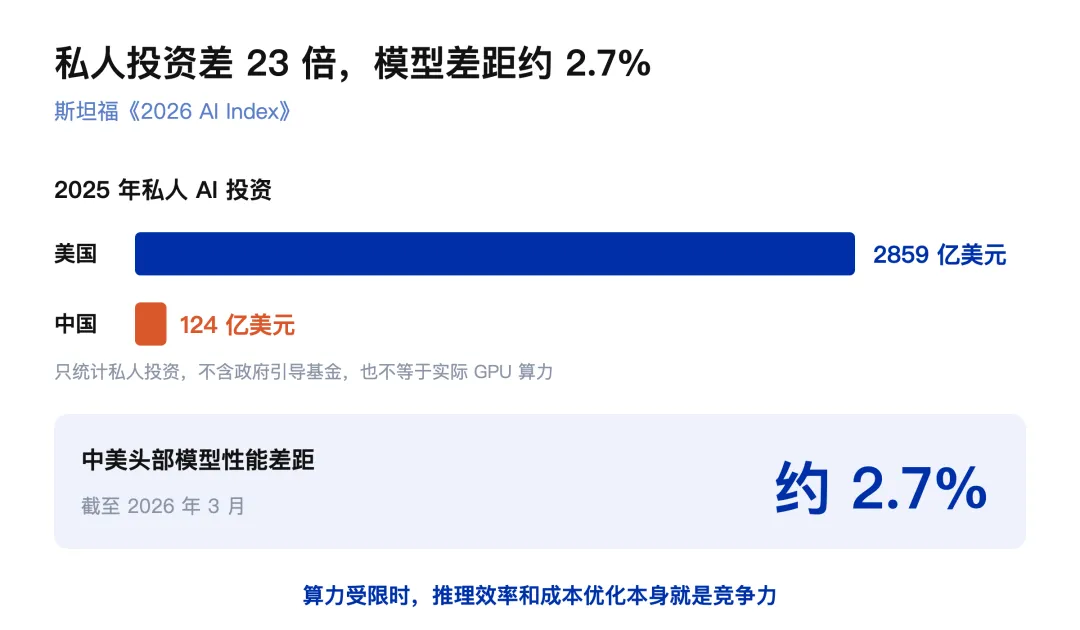
斯坦福《2026 AI Index》的数据是:2025 年美国私人 AI 投资约 2859 亿美元,中国约 124 亿美元,相差 23 倍。这个数只统计私人投资,不包括中国的政府引导基金,也不等于实际的 GPU 算力,但至少反映了资本投入的量级差距。再加上先进芯片的出口限制,中国企业还要额外解决芯片供应、软硬件适配、集群通信和推理成本这些问题。
同一份报告还说,截至 2026 年 3 月,中美头部模型的性能差距大约只有 2.7%。这不等于每项能力都只差 2.7%,但至少说明中国模型早就不是远远落在后面的状态。
想象两家公司:一家 GPU 充裕,训练、评测、推理随便开;另一家预算紧张,必须在不同业务之间取舍。两家的 Token 使用结构不同,能说明后者没有技术追求吗?显然不能。
算力受限的情况下,推理效率、成本优化和工程落地能力,本身就是核心竞争力。 真正该比的,是同样的算力能完成多少任务、解决多少真实问题。
六、中美 AI 要分三层看
我认为讨论中美 AI,必须分清三个层次:基础模型、工程能力、产品应用。它们相关,但不是一回事。
基础模型层,美国的 OpenAI、Anthropic、Google 依然很强,尤其在复杂推理、长程 Agent、前沿训练和基础设施上。这一点没必要回避。但 DeepSeek、Qwen、Kimi、GLM、MiniMax 已经构成了相当完整的生态,在开源模型上更是全球最活跃的力量之一。
工程能力层,以 AI Coding 为例,国内已经有 Qoder、Trae、CodeBuddy 等产品,正在从代码补全走向仓库理解、任务规划、自主执行和测试部署。企业级研发真正难的从来不只是生成代码,还有上下文管理、权限控制、工具调用、测试验证和异常恢复,也就是现在常说的 Agent Harness。模型能力越趋同,竞争就越会转向工程系统、开发者体验和成本效率。 在这一层,中国企业完全有机会做出很强的产品。
产品应用层,中国有庞大的电商、物流、制造、内容和企业服务市场,从客服、供应链预测、质量检测到代码研发,AI 能落地的场景非常多。当然,场景多不等于已经落地得好,降本增效要靠数据验证。但同样,也没有任何可靠证据能支持"中国 AI 主要用于娱乐,所以中国企业不擅长 AI 应用"这个结论。
所以我既不赞成用一张夸张的图证明中国 AI 不行,也不赞成为了反驳它就说中国已经全面超越美国。"中国只落后几个月"可以是某些方向上的局部判断,但不能当作整个 AI 领域的统一结论。
七、写代码,不是唯一的生产力
最后说这张图最深层的问题。它暗含了一个价值排序:写代码比做视频高级,企业自动化比内容生产有价值。
但软件工程从来不是唯一的生产力。一段视频可能是消遣,也可能是一条企业广告、一个商品展示、一份教学材料,或者一部影视作品的一部分。AI 把几天的制作周期压缩到几十分钟,这同样是生产效率的提升。
反过来,用 AI 写代码也不一定在创造价值。一个 Agent 反复改错代码、执行无效任务、产生大量没意义的工具调用,Token 烧得再多,也不代表生产力更高。
Token 消耗的是算力,生产力衡量的是有效产出。 这才是整件事的核心。
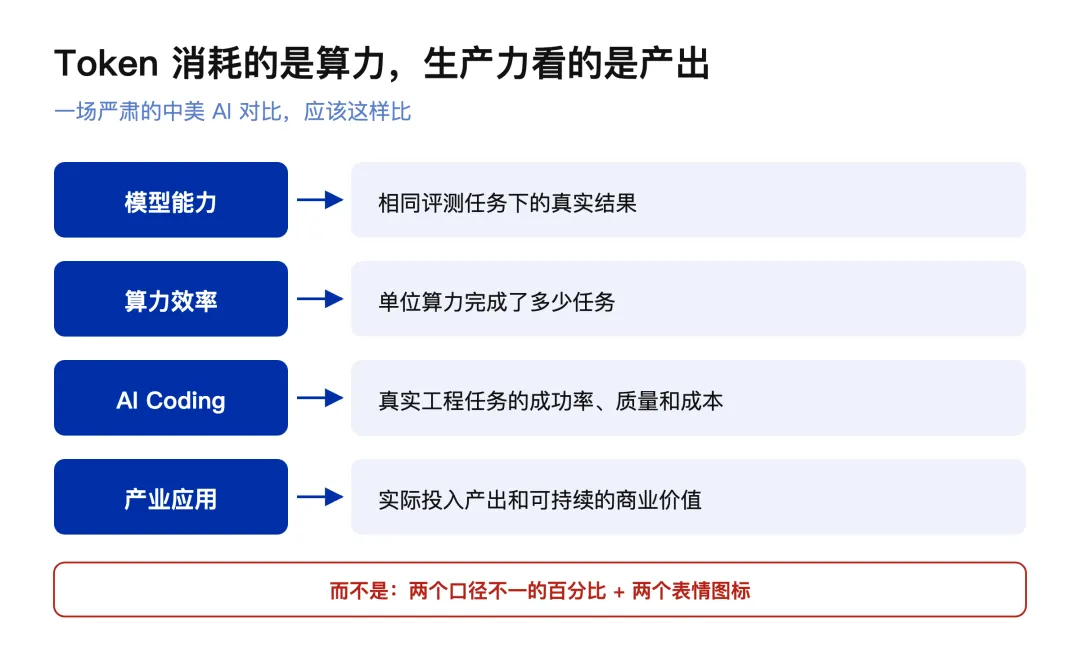
一场严肃的中美 AI 对比,应该这样比:模型能力,拿相同的评测任务说话;算力效率,看单位算力完成了多少任务;AI Coding,看真实工程任务的成功率、质量和成本;产业应用,看实际的投入产出和可持续的商业价值。
而不是拿两个口径不一的百分比,配两个表情图标,就宣布一个国家在创造未来,另一个国家只会娱乐。
写在最后
中国 AI 当然有短板:我们需要更先进的算力、更强的基础研究、更成熟的模型生态,以及更多真正创造商业价值的 AI 产品。这些问题值得认真讨论。
但也不该忽略另一个事实:在算力受限的情况下,中国依然把开源大模型、视频生成、AI Coding 和多模态应用推到了全球有竞争力的位置。
中国 AI 不需要靠否认差距来证明自己,更不应该被一张没有统计依据的图轻易定义。
技术竞争最终比的,不是谁的 Token 看起来更高级,而是谁能把有限的算力,变成更强的模型、更好的产品和更多真正的生产力。
至于"一边取悦当下,一边驱动未来",我倒觉得,能把复杂的技术做成人人都愿意用的产品,本身就是在创造未来。
真正值得警惕的,不是有人用 AI 生成短视频,而是有人连 AI 的计算成本、统计口径和产业价值都没搞清楚,就开始给两个国家的未来下结论。