ARTICLE · 1201528
AI编程(四十):网页结构入门 - 看懂网页的"骨架"
👆 点击上方蓝字关注我,获取更多干货
沈阳 · 阴天 · 10°C ~ 17°C
⛅ 多云转晴,心情正好
📋 文章概览
AI编程(四十):网页结构入门 — 看懂网页的"骨架"
前39篇你已经能让程序上网拿数据了,但至今走的都是"官方点餐窗口"(API)。可世上不是每家网站都开窗口——窗口不开的时候,就得自己看懂网页的骨架,才谈得上从里面取东西。
今天不写爬虫、不装任何新库,只干一件事:像"看懂房间布局"一样看懂网页的结构——标签、层级、class 和 id。骨架看懂了,下一篇的爬虫就是顺手的事。
CHAPTER 01从"我想把这张表搬下来"说起CHAPTER · 章节内容
上一篇的天气工具做完,你大概正得意:程序能自己上网了!然后你遇到这么一件事——
你们单位的公告栏网页上挂着一张排班表,领导说:"把这张表整理成 Excel 存档,每周一次。"你心想:这不就是上一篇的活儿吗?发请求、拿数据、存文件。于是你打开那个网页,右键"查看网页源代码",准备找那个"官方点餐窗口"(API)——
没有窗口。人家网站压根没提供 API。
你面对的是一整页花花绿绿的文字,右键一看源代码,满屏的 <> 符号,像外星文。你默默关掉页面,开始每周手工复制粘贴。
停。这正是今天要解决的问题。
网页本身就是一份"数据",只不过它被"包装"成了给人看的样子。你能看见排班表,浏览器能渲染排班表,凭什么程序就拿不到?程序当然拿得到——唯一的前提是:你得看得懂网页是怎么"搭"起来的。
这就是今天这篇的全部野心:看懂网页的骨架。注意,今天不写爬虫、不装 BeautifulSoup、不抓任何数据——下一篇才动手抓。
今天只练"看"。就像学开锁之前先学认锁芯:急不得,但也不难。
CHAPTER 02网页就是"一摞带标签的盒子"CHAPTER · 章节内容
一个生活类比:网页是套娃,不是报纸
你小时候玩过套娃吗?大娃娃肚子里装着中娃娃,中娃娃肚子里装着小娃娃。网页就是这么个结构——一层套一层。
想象一个网页是一套房子:
<html> | ||
<body> | ||
<div> | ||
<p><img> | ||
classid |
你看,所谓 HTML(HyperText Markup Language,超文本标记语言),名字唬人,干的事朴素得很:给内容贴标签,然后一层层套起来。"标记"(Markup)就是"贴标签",没别的。
认识几个最常用的标签
打开任何一个网页,右键"查看网页源代码"(Chrome/Edge 是"查看网页源代码"或"显示网页源代码"),你看到的东西大概长这样:
<html> <body> <h1>2026年10月值班表</h1> <p>发布日期:2026-10-16</p> <table> <tr> <td>周一</td> <td>张三</td> </tr> <tr> <td>周二</td> <td>李四</td> </tr> </table> </body></html>
逐个翻译成人话:
<h1>...</h1>:大标题。h 是 heading(标题),1 是"一号字"。 <h2>、<h3>是小一点的标题。<p>...</p>:一段文字。p 是 paragraph(段落)。 <table>、 <tr>、<td>:表格三件套。table 是"一张表",tr 是"一行"(table row),td 是"一格"(table data)。<img src="photo.jpg">:一张图片。图片内容在 src 指定的文件里,所以它是"单标签",没有 </img>。<a href="https://...">点这里</a>:一个链接。a 是 anchor(锚点),href 是链接去哪。 <div>:一个"啥都不是的盒子"。它不表示任何具体内容,纯粹用来把东西分成一组一组,是网页里用得最多的标签,没有之一。
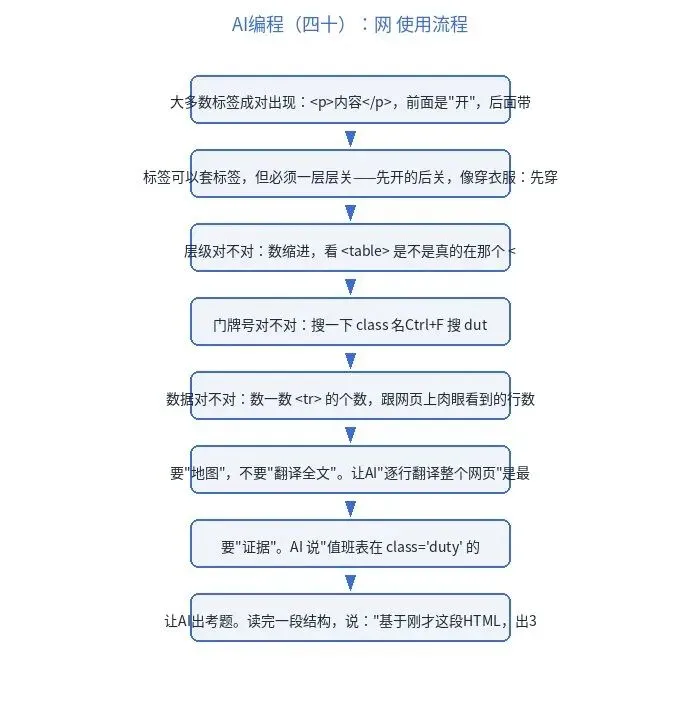
标签的铁律只有两条: 1. 大多数标签成对出现:<p>内容</p>,前面是"开",后面带斜杠的是"关",内容夹在中间; 2. 标签可以套标签,但必须一层层关——先开的后关,像穿衣服:先穿衬衫再穿外套,脱的时候先脱外套再脱衬衫。<div><p>hi</p></div> 是对的,<div><p>hi</div></p> 是错的。
class 和 id:给盒子贴名字
光有 <div> 还不够。一个页面上可能有几十个 <div>,你想找"值班表那个盒子",怎么跟程序描述?靠 class 和 id——写在标签里的"名字":
<div id="duty-table" class="table-box highlight"> <p class="date">2026-10-16</p></div>
人话翻译:
id="duty-table":这个盒子的身份证号。全页唯一,一个 id 只属于一个元素。 class="table-box highlight":这个盒子的标签贴纸,可以贴好几张。全页可以有很多元素共用同一个 class——就像很多盒子都贴着"易碎"的贴纸。
为什么这两个东西重要?因为下一篇写爬虫时,你说的"帮我抓那个值班表",落实成代码就是"抓id等于duty-table的那个盒子里的表格"。
class 和 id 就是你给程序指路的门牌号。今天认识它们,下一篇不迷路。
用"缩进"看层级:网页是折叠的
源代码几万行,怎么读?答案:不用全读,看缩进。层级关系看缩进就够了:
<body> ← 第1层:客厅 <div id="duty-table"> ← 第2层:客厅里的柜子 <h2>值班表</h2> ← 第3层:柜子上的牌子 <table> ← 第3层:柜子上的表 <tr> ← 第4层:表的一行 <td>周一</td> ← 第5层:行里的一格 </tr> </table> </div></body>
浏览器的开发者工具(F12)就是个"折叠套娃查看器":按 F12 打开"元素"(Elements)面板,鼠标划到哪块网页,对应的源码就高亮,而且层级一目了然——这比盯着原始源代码看舒服一百倍。今天的小练习里有一题就是用它。
CHAPTER 03跟AI说需求→读懂→改进:把"外星文"翻译成"人话"CHAPTER · 章节内容
今天不写程序,但"跟AI说需求→读懂→改进"的学习法照用——只是对象从"要代码"变成"要翻译"。
第一步:跟AI说需求
把你看到的一段网页源码甩给AI,说清楚你要干嘛:
"我是编程初学者,正在学网页结构。这是我们单位公告栏的一段网页源代码(粘贴在下面)。
我想从里面提取值班表的数据(日期、姓名)。请帮我:1)翻译这段HTML的结构,用'盒子套盒子'的方式说明层级;2)指出值班表在哪个标签里、靠什么 class 或 id 能定位到它;3)先不要写爬虫代码,只讲结构。"
(把源代码粘贴在提示词后面。不会看源代码?网页上右键→"查看网页源代码",全选复制就行。)
第二步:读懂(对照着看)
AI 给你的翻译大概是这个味道:
"这段HTML的结构是:body 下有一个
<div id='content'>,里面挂着<h2>标题和一个<table class='duty'>。值班表就是那个 table,它有 4 个<tr>(4行),每个<tr>里有 2 个<td>(日期和姓名)。定位它用id='content'里的table,或者直接用class='duty'。"
你对照源码验证三件事:
- 层级对不对
:数缩进,看 <table>是不是真的在那个<div>里面; - 门牌号对不对
:搜一下 class 名(Ctrl+F 搜 duty),看是不是真的在<table>上; - 数据对不对
:数一数 <tr>的个数,跟网页上肉眼看到的行数对不对得上。
三样都对上,你才算"读懂了骨架"。读不懂就追问:"class='duty' 是写在哪个标签上的?
它和 id 有什么区别?"——追问是免费的,脸皮厚点。
第三步:改进(今天改进的是"眼睛")
读懂一段结构后,试着让AI把难度升一级:
"这段源码里的日期有好几种写法('10月16日'、'2026-10-16'、'10/16'),如果我想统一提取,看HTML结构本身能解决吗?还是要在代码里处理?"
AI 会告诉你:HTML 只管"东西在哪",不管"东西长啥样"——数据规整是下一篇爬虫写完之后"数据清洗"的活儿(第29篇你练过)。这就是今天最值钱的认知:骨架(HTML)只负责"在哪","长啥样"是另一码事。带着这个认知去看任何网页源码,你都不会再发懵。
CHAPTER 04四个必踩的坑(先打疫苗)CHAPTER · 章节内容
坑1:把"看到的文字"当成"源码里的文字"。网页上明明写着"10月16日 值班:张三",源码里搜这行字却搜不到——因为它可能是 JavaScript 动态生成的(页面打开后才"变"出来的),或者藏在别的格式里。疫苗:搜不到就先认怂,动态网页是爬虫的进阶关卡(第43篇会碰到);今天先把"静态写死在HTML里"的看懂,别跟动态内容较劲。
坑2:以为 class 名是"官方认证"的,死记硬背。class="duty"是这个网站的开发人员随手起的名,换个网站可能叫shift-table、叫ban-biao,甚至叫box1。
疫苗:class/id 的名字每个网站都不一样,看现场,别背。你要练的不是记名字,是"找到名字并确认它挂在哪个标签上"这个动作。
坑3:<div>和<span>傻傻分不清楚,然后纠结该用哪个。<div>是"块级盒子"(自己占一行),<span>是"行内小纸条"(夹在文字里)。
但对你今天的目标(看懂结构)来说,它俩的差别几乎不重要——都是"盒子"。疫苗:先当它俩是一回事,等将来你自己写网页(第70篇之后)再细分,现在纠结纯属浪费时间。
坑4:一上来就"全选源码喂给AI,帮我抓数据"。几万行源码直接甩给AI,AI 也会看花眼,抓出来的数据十有八九张冠李戴。
疫苗:先定位,再下手——用 Ctrl+F 搜你看得到的那几个字(比如"值班"),找到它附近的标签,把那一小段(前后各几十行)复制给AI。精准打击,别地毯式轰炸。这个习惯下一篇抓数据时救命。
CHAPTER 05跟AI协作的正确姿势(看结构特供)CHAPTER · 章节内容
今天这种"纯看不写"的课,跟AI协作的姿势也有讲究:
- 要"地图",不要"翻译全文"
。让AI"逐行翻译整个网页"是最低效的问法。高手问的是:"这个网页里,跟'值班表'有关的部分在哪个区域?把那一块的结构画成层级图。"要地图,别要全本字典。 - 要"证据"
。AI 说"值班表在 class='duty' 的 table 里",你必须回到源码里 Ctrl+F 验证一下。AI 读源码也会看走眼,尤其是几万行的页面——它说的每一句结构判断,都值得你花10秒核实。下一篇你要靠这个判断写代码,地基不能是猜的。 - 让AI出考题
。读完一段结构,说:"基于刚才这段HTML,出3道'这个数据在哪个标签里'的小题考我。"自己找和被考,是两倍的学习效率——出题这个套路,从第1篇用到今天,依然好使。
CHAPTER 06今日小练习CHAPTER · 章节内容
练习1:给你的手机浏览器"验明正身"。打开你常看的任意一个网站(新闻站、单位公告栏都行),右键"查看网页源代码",然后回答三个问题:①最大的标题是<h1>还是<h2>?
②页面里<div>大概出现了多少次(源码页 Ctrl+F 搜<div,看匹配数)?③能找到几个id="..."?
提示:第②问的匹配数不用数精确,"几十个还是几百个"这个量级就够了——你多半会大吃一惊:一个不起眼的页面,盒子比你想的多得多。这就是为什么看网页要"定位"而不是"通读"。
练习2:玩一次"F12 抓娃娃机"。随便开一个网页,按 F12 打开开发者工具,点左上角的小箭头图标("选择元素"),然后用鼠标点网页上的某段文字——右边面板会自动高亮对应的源码。
请找出:那段文字外面一共套了几层"盒子"?最外面那层的 class 或 id 是什么?
提示:右边面板里,被高亮的行如果左边有个小三角,说明它肚子里还有东西——点开三角就是"打开套娃"。数盒子层数的时候,只数高亮的那条链路就行。
练习3(动脑题):给"值班表"画门牌。假设你要跟AI描述"帮我抓你们单位网页上的值班表",在不给AI看源码的情况下,你会怎么描述它的位置?
试着写两三句话,越具体越好(比如"页面正中间的大表格,标题写着'值班表',有日期和姓名两列")。提示:这题练的是"把肉眼看到的东西翻译成结构描述"的能力——下一篇你给AI提需求时,就该这么说话。写完留着,第41篇开卷对照,你会发现自己已经会"点菜"了。
CHAPTER 07下篇预告PREVIEW · 明日预告
下一篇(第41篇):爬虫入门 — 第一次亲手从网页"取"东西。骨架看懂了,今天欠的账该还了:装上 BeautifulSoup 这把"万能钥匙",把上一篇练习里那张值班表真的抓下来、存成文件。
标签、层级、class、id——今天认的门牌号,下一篇全用得上。到时候你会发现:爬虫不是黑客技术,就是"看懂结构 + 按图索骥",而按图索骥的功夫,你今天已经练完了。
📌 流程总结
既然看到这里了,如果觉得有用,随手点个赞、推荐、转发三连吧
点赞
推荐
转发
THANKS FOR READING