ARTICLE · 1203506
AI能设计新材料,为什么还是落不了地?
实验室里跑出一个好结果,想复现,发现工艺参数对不上;想用AI预测材料性能,发现数据格式五花八门,清洗比建模还费时间;好不容易训好一个模型,换台设备、换个批次,预测就不准了。
这篇发表在 Communications Materials 上的综述,讨论的正是这个问题:材料发现和先进制造,缺的不是单个AI模型,而是从数据到部署的整套开源基础设施。
01 核心问题:材料发现的瓶颈,不在算法,在基础设施
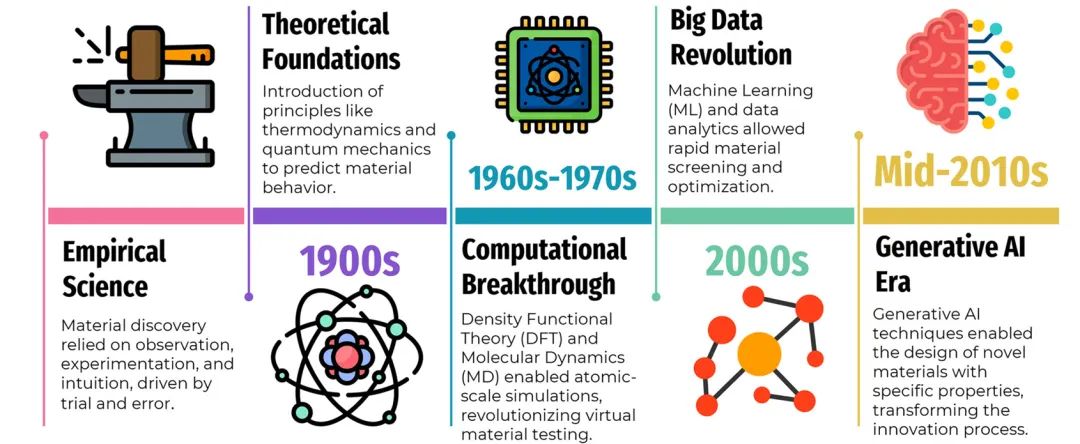
论文开篇回顾了材料发现范式的演进:
经验科学 → 理论科学 → 计算科学 → 大数据驱动 → 生成式AI
每一次范式跃迁,都让材料探索的效率和范围大幅提升。但论文指出一个关键问题:
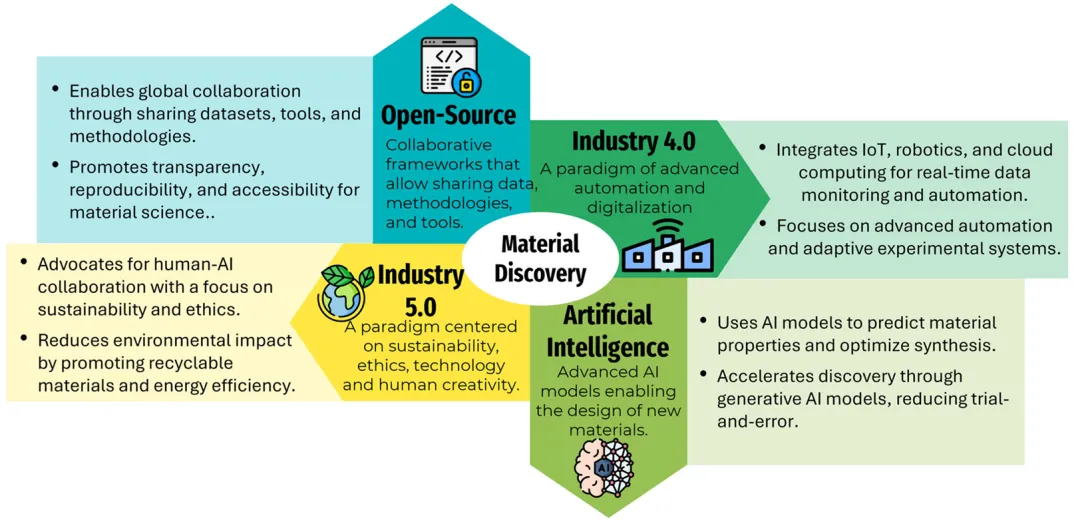
当代材料发现,不是靠单一方法,而是数据中心实践、物理模拟和机器学习的协同。
数据决定了模型能学什么;
模拟提供了物理因果性;
机器学习提供了高维设计空间的 scalability。
三者互补,但它们的有效整合,需要基础设施层面的支撑。论文的核心主张是:
材料发现应该被当作系统级问题,数据、模型和计算工作流必须协同设计,而不是孤立对待。
换句话说,可重复性、可扩展性和长期可持续性,不能只靠单个算法解决,必须嵌入整体研究框架。
02 数据生命周期:从采集到组织
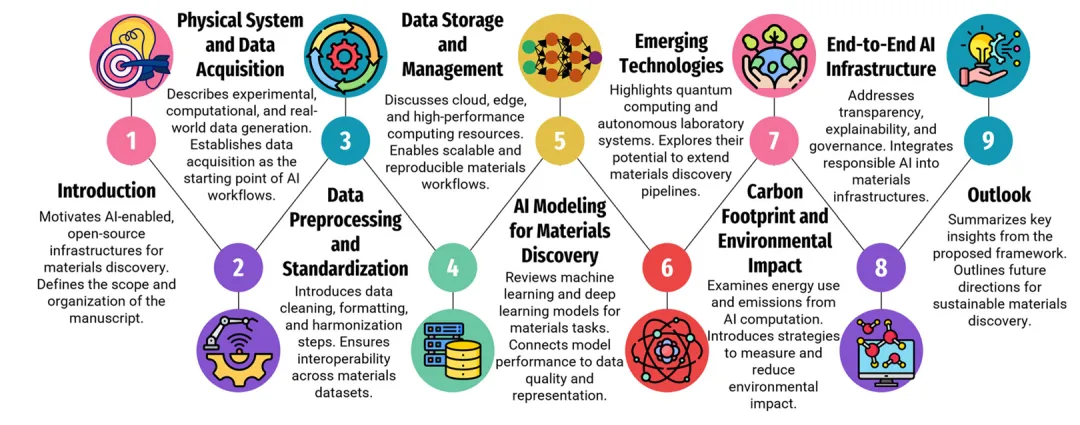
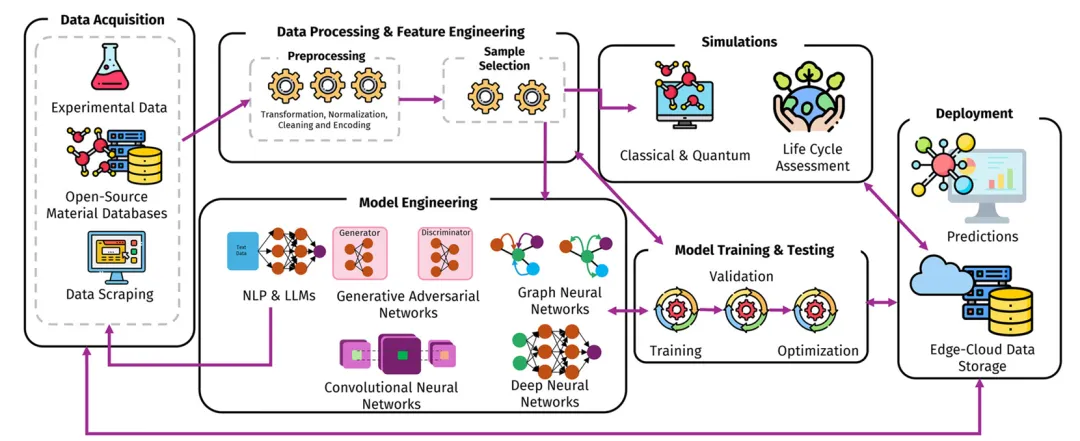
论文按数据生命周期组织内容,覆盖采集、预处理、存储、组织、AI建模和部署。
数据采集:从手工实验到自动化系统
传统数据采集依赖实验,耗时、昂贵、依赖专家经验。数据往往分散在不同课题组,缺乏标准化,难以比较和共享。
现代数据采集包括:
开源数据库:PubChem(超1.13亿化合物)、ChEMBL、COD、ZINC、CSD、ICSD、PDB等;
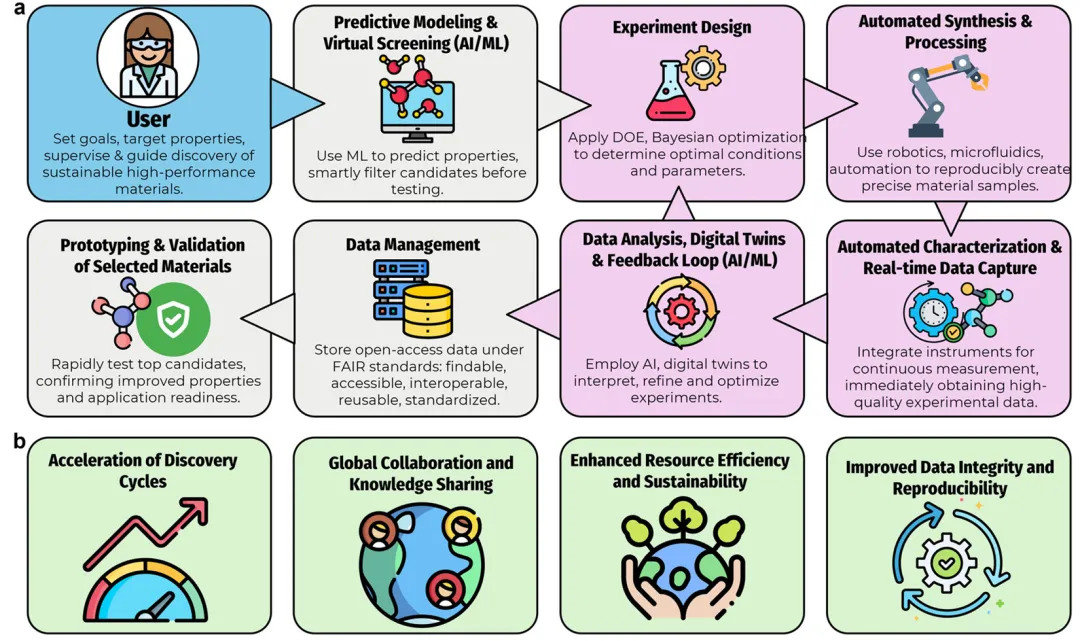
自驱动实验室(SDL):集成自动化、ML和机器人,形成闭环系统,实验设计、执行、优化无需人工干预;
数字孪生:物理实验设备的虚拟表示,支持远程监控和调整;
合成数据:MD、DFT、量子化学等in silico模拟,以及VAE、GAN等ML生成数据;
网络爬取:Beautiful Soup、Scrapy、Selenium等工具,从文献和数据库中自动提取数据;
AI驱动文献提取:BERT、GPT-3、GPT-4等LLM,从科学文献中大规模提取材料-性质关系。
关键结论:SDL把传统线性发现流程变成动态自适应系统,但物理自动化本身不保证标准化或可重复性,还需要SOP、质控样本、仪器校准和独立验证。
数据预处理:清洗、标准化、特征工程
材料数据异质性强,预处理是AI基础设施的关键第一步。
Pandas、NumPy:数据操作和数值计算;
RDKit:化学信息学,分子标准化、指纹生成、化学特征提取;
OpenRefine、KNIME、Talend:可视化预处理流程;
Apache Spark:大规模分布式数据处理。
数据存储:云与边缘计算
云计算:AWS、Azure、GCP,提供可扩展的HPC资源,支持大规模材料筛选;
边缘计算:在数据源头处理,降低延迟,适合实时分析;
混合方案:云+边缘,按计算需求和能效优化任务分配。
关键结论:云计算可扩展性强,但能耗和碳足迹是问题;边缘计算降低延迟,但算力和存储有限。混合方案是务实选择。
数据组织与索引
材料数据组织的挑战包括:数据类型多样、可扩展性、互操作性、溯源记录不足。
FAIR原则:可发现、可访问、可互操作、可重用;
灵活数据模型:Materials Project支持新数据类型;
EMMO:欧洲材料建模本体,建立通用描述框架;
AiDA:基于图的数据结构,捕捉计算和数据的复杂关系;
分层索引、语义索引、自适应索引:提升检索效率。
03 AI建模:从预测到生成
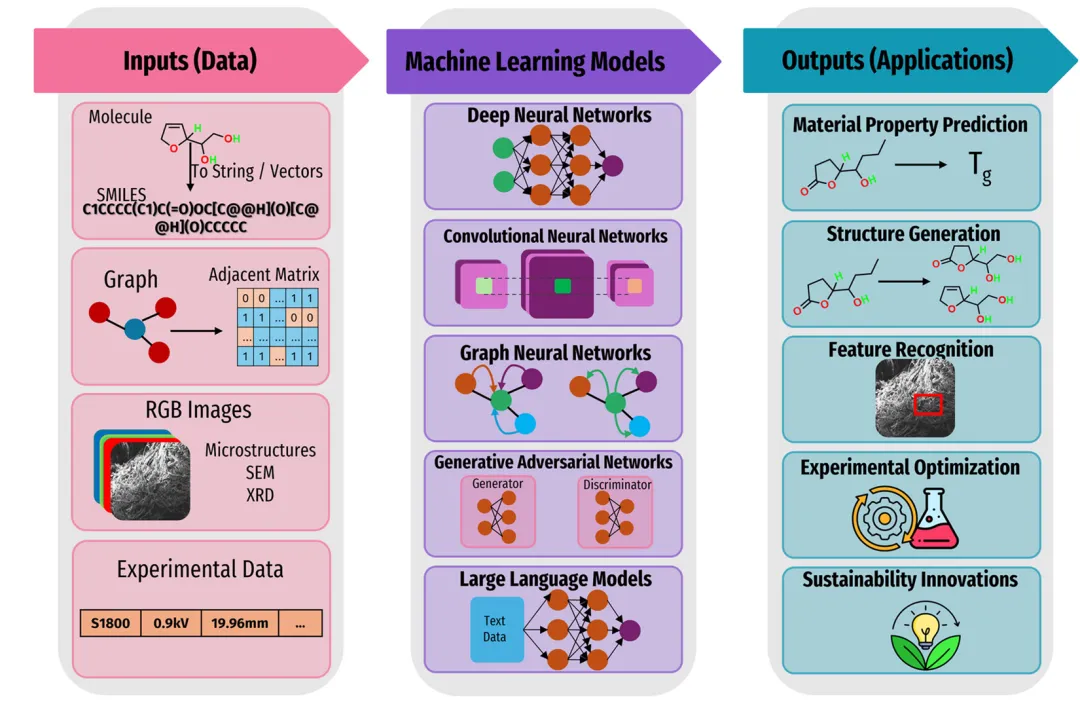
论文系统梳理了材料科学中的AI模型类别。
传统ML模型
SVM、ANN、决策树等,在材料合成优化、纳滤、生物材料开发中表现有效。贝叶斯优化和随机森林,减少了实验需求,推动了纤维素复合材料、离子液体、金属玻璃等研究。
深度学习模型
图神经网络:PU-MPNN预测有机半导体性质,训练时间减少98%,准确率超80%;
通用原子间势:MACE、CHGNet,RMSE低至0.3–0.7 J/m³;
CNN和DenseNet:微结构分类,准确率超94%;
DeepXRD:预测XRD谱;
SA-GNN、GeoCGNN:形成能MAE低至0.044 eV/atom;
MultiMat:多模态数据整合,弹性张量MAE降低10%。
外推问题
论文特别指出:很多材料科学中的OOD评估,实际上反映的是插值而非真正的外推,导致泛化能力被高估。
E2T框架:用匹配神经网络,在人工生成的外推任务上训练,在聚合物和杂化钙钛矿中展现出优越泛化能力;
更严格的OOD基准:确保评估考虑真正不同于训练数据的材料。
联邦学习
联邦学习是去中心化训练范式,模型更新共享,原始数据留在本地。适合材料科学中数据分散、隐私或IP受限的场景。
MatSwarm:联邦学习+区块链+可信执行环境,支持大规模多机构参与;
增材制造:联邦学习用于熔池异常检测、零件认证和尺寸预测,性能接近集中式学习。
可解释AI
XAI在材料科学中越来越重要,用于:
验证学习到的关系是否符合领域预期;
识别可操作的变量;
将模型行为转化为人类可理解的假设。
两种范式:
事后、模型无关解释:SHAP、LIME,量化输入如何驱动预测;
内在可解释或物理融合建模:CrabNet等,可解释性嵌入表示或架构。
关键结论:XAI输出应被视为模型行为的解释,用于验证、优先级排序和约束设定,而非因果关系的直接证据。
生成式AI
VAE和GAN:逆向设计的基础工具,但训练需要大数据,生成样本可能过于接近训练集;
扩散模型:通过迭代去噪生成候选,训练更稳定,结构保真度更高,支持条件生成;
LLM到agentic AI:MOFGPT、MAPPS、MatAgent、MOFGen等,整合LLM推理、生成模型、物理评估和外部工具,实现迭代优化。
关键结论:agentic AI仍面临可靠性、可解释性和标准化挑战。领域专用、多模态基础模型,以及带显式规划和人在回路控制的agentic架构,是未来方向。
04 开源部署与可及性
论文强调开源部署在材料发现中的价值。
基础设施和部署工具
GitHub:版本控制,CI/CD流水线;
Docker、Kubernetes、VirtualEnv:容器化环境,消除依赖冲突;
Streamlit、Flask:交互式Web应用;
Hugging Face:模型和数据集共享。
可及性与数据透明度
完全开源系统:BLOOM,模型、训练数据、文档全部开放;
半开放系统:LLaMA、Gemini,训练数据不透明;
封闭系统:GPT-4,训练数据完全保密,阻碍独立验证。
关键结论:透明度直接影响可重复性和可信度。材料发现依赖高质量、可溯源的数据集,封闭系统可能限制多样性覆盖和协作。
05 新兴技术:量子计算与区块链
量子计算
Willow量子芯片:纠错和稳定性突破;
分子量子比特:化学可调,长相干时间;
VQE、qubit-ADAPT-VQE:计算分子基态能量,MOF吸附和CO₂捕获;
Grover搜索:识别Ni-Ti形状记忆合金;
量子相位估计:研究耐腐蚀材料。
量子机器学习
QNN:硬件木马检测,准确率97.27%;
QLSTM:逆合成任务,准确率80%;
QVC、QSVM:过渡金属化合物分类,准确率99%;
QGPR、QKRR:预测压电系数、带隙、NMR化学位移。
区块链
数据组织与存储:Merkle树、IPFS、动态数据模板;
安全透明数据共享:智能合约、去中心化账本、来源追踪;
协作与开放研究:BlockFlow、Hyperledger Fabric;
联邦学习+区块链:去中心化协作,无需集中化数据。
06 碳足迹与环境影响
论文专门讨论了AI计算的环境成本。
关键数据:
2020年ICT行业占全球温室气体排放的1.4%;
数据中心和传输网络贡献0.1–0.2%;
ML训练能耗年增长150%,推理增长105%;
BLOOM语言模型排放24.7–50.5吨CO₂;
GPT-3排放284吨CO₂,相当于一辆汽车终身排放。
应对策略:
FLOPs:衡量计算强度的标准指标;
生命周期评估(LCA):考虑运营能耗和硬件制造、处置的嵌入式排放;
CodeCarbon、Carbontracker、eco2AI:实时监控能耗和温室气体排放;
TPU:比传统CPU和GPU能效高30–80倍;
可再生能源数据中心:Google 2017年起100%可再生能源,AWS 2025年目标,Microsoft 2030年碳负。
关键结论:材料发现社区需要双管齐下——创新和可持续性。优化模型架构、使用高效硬件、优先可再生能源数据中心、延长硬件寿命,都是必要措施。
07 伦理与负责任创新
论文强调AI驱动材料发现的伦理问题:
数据集偏见:导致预测偏差和不公平的材料推荐;
黑箱模型:降低科学信任;
负责任创新:需要透明度、问责制和公平获取。
指导框架:
OECD AI原则;
UNESCO AI伦理指南;
FAIR数据实践;
XAI、LCA、伦理审查:整合到模型开发中。
08 案例研究:纤维基包装材料的端到端AI基础设施
论文用一个完整案例,展示AI基础设施如何用于设计、验证和放大高性能纤维基包装材料。
Step 1:数据采集与知识聚合从Materials Project、NOMAD等数据库聚合数据,用Scrapy、Beautiful Soup爬取文献,用LLM提取方法细节和实验条件。
Step 2:数据标准化与特征工程用Pandas、NumPy清洗、归一化、标注,识别纤维组成、涂层配方、工艺条件和终端性能之间的关联。
Step 3:模型开发与生成式筛选用GAN提出候选聚合物-纤维复合材料、纳米添加剂分散体和生物基层压结构,用贝叶斯优化平衡性能、成本、环境影响。
Step 4:结构-性能分析与多尺度建模用CNN分析SEM和AFM图像,检测表面缺陷和分层风险;用GNN建模纤维素原纤相互作用和交联行为;用DNN整合热物理性质、工艺参数和降解模型。
Step 5:模拟引导验证与自主实验用MD模拟水蒸气和氧气扩散,用FEA评估机械稳定性,用SDL进行机器人合成和表征。
Step 6:放大、监控与部署用LCA和TEA量化环境足迹、能耗和成本效益,用PINN模拟制浆、涂层和干燥动力学,用区块链记录数据来源和合规性,用边缘AI传感器实时监控纤维排列和涂层分布。
关键结论:这个案例展示了AI基础设施如何协调数据摄入、建模、模拟和制造反馈,支持可持续高性能纤维基包装材料的规模化开发。
09 我读后的几点感悟
第一,材料发现的瓶颈,越来越像“基础设施问题”,而不是“算法问题”。数据格式不统一、来源不可追溯、工具不可复用、部署不可扩展,这些问题比模型精度更影响实际进展。
第二,开源不是口号,是材料AI能否协作的关键。封闭系统可能保护商业利益,但也限制了数据多样性、独立验证和跨机构协作。材料发现需要FAIR原则真正落地。
第三,AI的环境成本必须被认真对待。训练一个大模型的碳排放,可能相当于一辆汽车终身排放。材料发现本身是为了可持续发展,如果AI基础设施本身不可持续,就自相矛盾了。
第四,agentic AI很热,但可靠性、可解释性和标准化仍是硬骨头。LLM在材料任务中可能幻觉、数值推理弱、结构信息处理不一致。领域专用、多模态基础模型,加上人在回路控制,是更务实的方向。
第五,从实验室到工厂,需要全生命周期视角。LCA、TEA、实时碳追踪、区块链溯源,这些不是附加项,而是AI驱动材料发现基础设施的组成部分。
10 对科研人员的启示
做材料AI,先建数据基础设施。数据采集、清洗、标准化、存储、索引,每一步都影响模型上限。不要等到建模时才处理数据问题。
优先使用开源工具和数据库。Pymatgen、Matminer、RDKit、ASE、Materials Project、OQMD、NOMAD等,能大幅降低开发成本,提高可重复性。
把物理约束嵌入模型。PIML、PINN等方法,能提高数据效率、可解释性和鲁棒性,减少非物理预测。
关注外推,而不只是插值。很多OOD评估实际上是插值。用E2T等框架,或更严格的OOD基准,才能真正测试泛化能力。
考虑联邦学习。如果数据分散、隐私或IP受限,联邦学习能在不共享原始数据的前提下,实现协作建模。
把可持续性设计进流程。用CodeCarbon、Carbontracker等工具追踪碳足迹,优化模型架构,优先可再生能源数据中心。
拥抱开源,但也要关注治理。开源提高可及性和透明度,但也需要数据治理、伦理审查和知识产权保护。
一句话总结
材料发现的下一步,不是再多一个AI模型,而是构建透明、可扩展、可持续的开源基础设施——从数据采集到AI建模,从实验自动化到工业部署,把数据中心实践、物理模拟和机器学习真正协同起来。
论文的核心洞察是:可重复性、可扩展性和可持续性,不能靠单个算法解决,必须嵌入整体研究框架。 这对做材料AI、自动化实验、智能制造和科研基础设施的科研人员,都有长期参考价值。
原文信息Mariangeles Salas, Anand Singh, Carlos Pignataro, Lokendra Pal. AI-powered open-source infrastructure for accelerating materials discovery and advanced manufacturing. Communications Materials, 2026, 7:65.DOI: 10.1038/s43246-026-01105-0资源库:https://palarmi.github.io/ai-infrastructure-for-materials-discovery本文为综述解读,版权归原作者所有;若引用请以原文为准。
一个模型搞定分子和材料:ZATOM-1的跨域统一建模开源模型
一个模型搞定化学、生物、材料百种任务:SciReasoner奠定跨学科科学推理基础
AI正在改写材料科学的“游戏规则”:从“试错”到“设计”,从“人类直觉”到“机器认知”
从LLAMA到LLAMAT:当材料科学遇上大语言模型,一场“小而美”的逆袭