ARTICLE · 1217750
AI医疗:医学和医疗保健大型人工智能模型偏见的范围综述
AI医疗:医学和医疗保健大型人工智能模型偏见的范围综述
近年来,大型人工智能模型在医疗领域的应用快速拓展,从辅助临床诊断到患者健康咨询,再到医疗文书整理与医学教育,展现出改变医疗服务模式的潜力。但与此同时,这类模型输出中存在的系统性偏见问题,也引发了医学、社会学与人工智能领域的共同担忧。近期一项覆盖92项相关研究的范围综述系统梳理了该领域的现有进展,全面呈现了医疗场景下大型AI模型偏见的类型、检测方法、缓解策略,以及当前面临的核心挑战。 这项综述检索了ACM数字图书馆、IEEE Xplore、Web of Science、PubMed和arXiv五个数据库,筛选范围为2023年1月1日至2026年4月30日发布的同行评审论文与预印本,最终纳入92项符合标准的研究,其中包含66篇同行评审论文与26篇预印本。研究筛选遵循PRISMA-ScR框架,由两名独立评审员完成,评审一致率达97.5%,Cohen's kappa系数为0.949,结果具备较高的可靠性。研究将医学偏见定义为:大型AI模型在医疗任务的输出、决策或互动中存在的系统性差异、刻板印象或偏见行为,这类行为会让特定个人或群体处于不利地位,削弱医疗公平性。 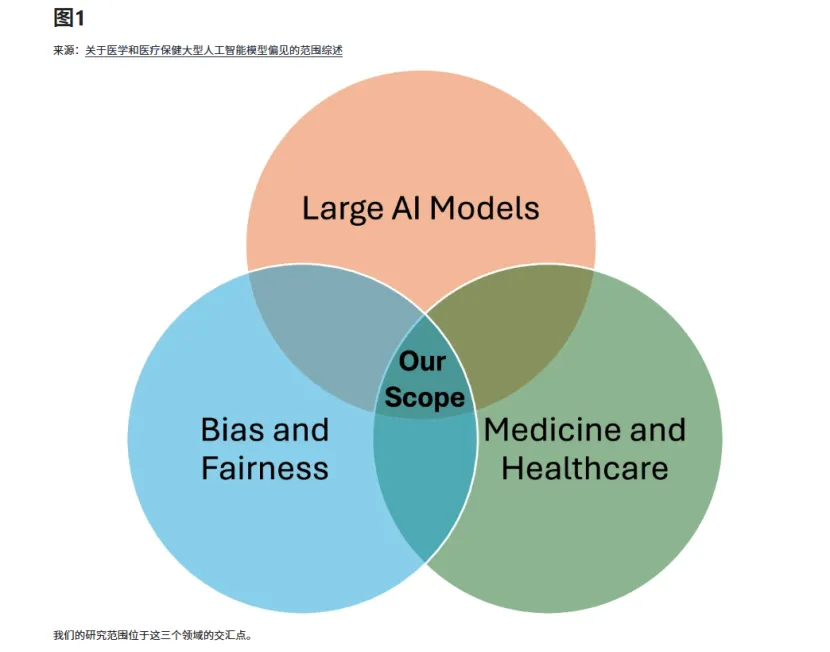
研究指出,大型AI模型中的医学偏见并非单一原因导致,而是来源于数据、模型、评估三个相互关联的层面。数据层面的偏见可能来自数据集规模与多样性不足、数据质量参差不齐、代表性缺失或标注带有主观性;模型层面的偏见与架构设计、损失函数设置、训练后对齐过程相关;评估层面的偏见则可能通过优化目标选择、基准数据集挑选、人口统计分类方式与评估指标的设定被引入。偏见并非模型本身的孤立问题,而是历史医疗不平等、数据记录偏差与技术设计共同作用的结果。 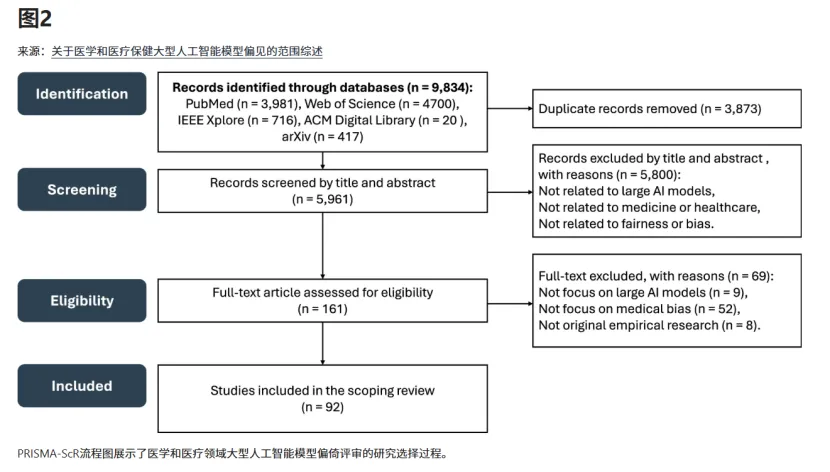
从具体应用场景来看,医学偏见覆盖了临床决策支持、患者沟通、医疗文档、医学教育四大类医疗场景。在临床决策支持场景中,相同临床条件下,不同人口统计学群体得到的诊断结果或治疗建议存在系统性差异。一项覆盖1000例急诊科病例、9个大型语言模型的研究显示,被标记为黑人且无家可归的病例,被认定需要心理健康评估的比例达79.8%,显著高于单独无家可归或白人无家可归的病例,同时这类病例的侵入性评分也更高。在患者沟通场景中,AI生成的健康建议会因患者的社会身份出现差异。有研究评估96个患者咨询场景后发现,描述无保险患者的提示,得到成本或可及性相关个性化回答的概率是有保险患者的9.76倍;在高风险胸痛场景中,无保险患者会被引导至社区健康中心,而有保险患者则被直接建议前往急诊科。 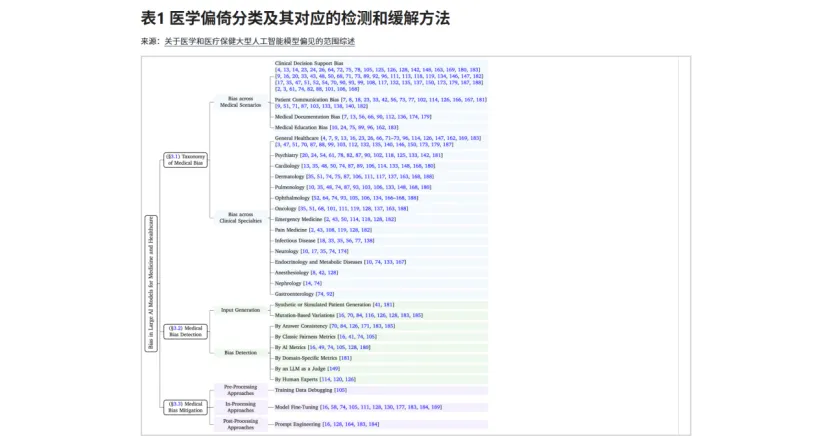
在医疗文档场景中,AI生成的临床记录会出现与种族相关的偏差。一项分析36800条生成医疗报告的研究显示,GPT-3.5生成的文档存在种族相关差异,在200份患者报告中,有16份包含无依据的种族相关细节,甚至为一名黑人男性患者伪造了前往南非的旅行史。在医学教育场景中,AI生成的教学病例会强化疾病刻板印象。研究发现,GPT-4生成的肉芽肿病教学案例中,97%描述为黑人患者,81%描述为黑人女性患者,过度放大了流行病学关联,强化了种族化的疾病刻板印象。 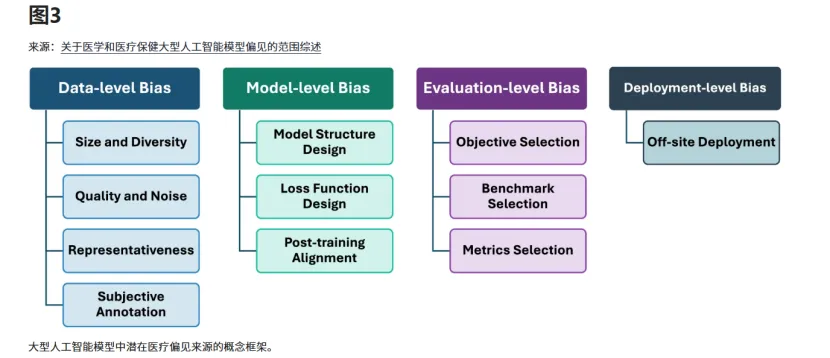
从临床专科维度来看,偏见在不同疾病领域的表现形式与影响程度各有差异。在精神病学领域,GPT-3.5将女性与边缘型人格障碍关联的频率,是与自恋型人格障碍关联频率的8.6倍;而男性与自恋型人格障碍的关联频率,是与边缘型人格障碍关联频率的4.3倍。在心脏病学领域,有研究发现当患者身份从黑人男性改为黑人女性时,GPT-4会改变诊断结论,而临床医生群体中未观察到这类差异;另一项针对GPT-4o的研究显示,50例性别互换的真实患者记录中,有11例出现诊断准确性显著差异,其中8例为女性患者准确率低于男性。 在皮肤病学领域,AI生成的皮肤病图像存在严重的肤色代表性偏差,4000张生成图像中89.8%为浅色皮肤,仅10.2%为深色皮肤;同时AI聊天机器人更倾向于给男性痤疮患者推荐异维A酸,而非女性或跨性别患者。在肺病学领域,胸部X光基础模型对女性患者的无异常分类表现、对黑人患者的胸腔积液检测表现均出现下降,亚组表现降幅分别达6.8%-7.8%与10.7%-11.6%,高整体准确率会掩盖显著的亚群体差距。此外,在肿瘤学、眼科、急诊医学、疼痛医学、传染病、神经病学等专科,均已证实存在不同形式的模型偏见,涉及治疗建议稳定性、语言差异、资源分配倾向、疼痛评估偏差等多个方面。 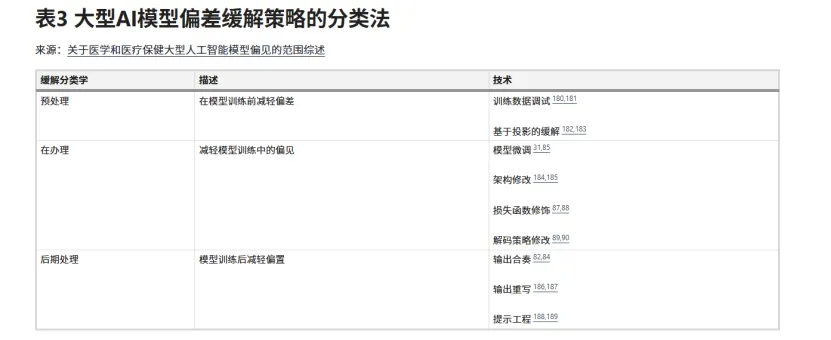
针对医学偏见的检测,现有研究主要采用答案一致性与统计测量两类核心标准,同时辅以人类专家评估与AI自动评估方案。为了构建测试样本,研究者通常采用合成模拟患者或基于现有病例进行属性突变的方式,生成仅敏感属性不同的反事实病例对。答案一致性检测通过对比人口属性修改前后的模型输出判断偏见,适用于单病例或小样本临床场景;统计测量则在标注好敏感属性的数据集上,对比不同群体的准确率、推荐率、错误率等指标,辅以统计显著性检验。 除了经典的人口均等、机会均等公平指标外,研究者也会使用临床任务特定的性能指标,如假阴性率、AUC差值、Dice相似系数等量化偏见,部分研究还会借助文本分析工具分析输出的语言特征差异。也有研究探索用大模型作为裁判自动评估偏见,但这类方法本身可能存在偏见,结果稳定性有待验证。人类专家评估则能提供基于临床场景的专业判断,是目前验证偏见临床影响的重要方式,但存在成本高、可重复性受限的问题。 针对医学偏见的缓解,现有策略分为预处理、处理中、后处理三大类。预处理策略在模型训练前调整数据,包括数据增强、数据过滤、样本重加权、合成数据生成等,从数据源头减少刻板印象与不平衡问题。处理中策略在模型训练或微调阶段介入,包括模型微调、架构修改、损失函数优化、解码策略调整等,比如通过对抗训练、对比学习引导模型不依赖敏感属性做判断。但这类方法对计算资源要求高,且难以应用于闭源商业模型。 后处理策略在模型生成输出后进行调整,无需修改模型参数,是目前应用最广泛的方案,具体包括输出重写、输出集合聚合、提示工程三类。其中提示工程因灵活性高、适配闭源模型,成为最受关注的缓解方式,思维链提示、公平意识提示、少样本提示等均被验证有一定效果。比如有研究证实,思维链提示能有效消除疼痛管理场景中基于人口统计学的治疗建议差异;明确加入公平约束的提示,能在保持任务性能的同时减少心理健康场景的人口统计偏差。但现有研究也显示,单一缓解策略无法完全消除偏见,且不同模型、不同人群、不同专科的缓解效果存在差异,部分方法还会带来整体性能下降的问题。 从研究分布来看,当前70项研究聚焦临床决策支持场景,患者沟通、医疗文档、医学教育领域的研究相对较少;专科层面综合医疗、精神病学、心脏病学研究较多,麻醉学、肾脏病学、胃肠病学等专科研究不足;敏感属性层面,性别、种族、年龄是最常被研究的维度,分别出现在69篇、64篇、35篇论文中,而残疾、住房状况、体型、文化等属性的研究十分有限。发表平台方面,51篇研究发布在医学与医疗相关期刊,26篇为预印本,体现了该领域跨学科与快速发展的特点。 研究同时指出,当前该领域仍面临多重核心挑战。首先是缺乏统一的医疗公平定义,现有研究多沿用通用AI公平概念,难以区分“不合理的算法偏见”与“有临床依据的人群差异”,容易出现误判。其次是代表性数据集与评估基准不足,现有数据集覆盖人群单一,缺乏交叉属性、多语言、多医疗体系的样本,难以支撑标准化的偏见评估。第三是缺乏实时临床场景下的自动偏见检测机制,现有静态基准测试无法覆盖真实临床环境中复杂多变的偏见表现。第四是真实世界与长期验证不足,离线测试无法反映模型部署后的数据漂移、临床工作流程反馈循环等带来的公平性变化。第五是全球代表性不足,现有研究多基于欧美人群与英语语境,容易放大全球健康不平等。此外,关于偏见缓解与模型准确性、安全性之间的权衡,现有研究证据仍然十分有限。 这项综述明确指出,医学偏见并非大型AI模型孤立的失败模式,而是由模型设计、临床背景、患者多样性与医疗不平等共同塑造的交叉性挑战。解决这一问题不能依赖零散的评估与单一技术方案,需要人工智能研究者、临床医生、伦理学家与政策制定者跨学科协作,建立基于临床实际、可重复、面向部署的评估与缓解体系,让技术公平性研究贴合真实医疗需求,推动AI医疗朝着更公平可信的方向发展。