ARTICLE · 1229346
【数智】当AI学会物理定律, “机理+数据”双驱动如何破解油气智能化的“最后一公里”
【数智】当AI学会物理定律, “机理+数据”双驱动如何破解油气智能化的“最后一公里”
编译 | 晴天 纯数据驱动的AI在油气行业“水土不服”,根源在于数据稀缺、物理一致性无法保证、泛化能力差。物理信息神经网络(PINN)将物理定律“编织”进神经网络,以昆仑大模型、识油大模型等工业实践为例,论证“机理+数据”双驱动是油气智能化的必然路径——同时不回避PINN自身面临的一些硬挑战。
油气藏数值模拟就是在计算机里建一个“虚拟油气藏”,模拟地下流体的流动规律。地下流体遵循质量守恒、动量守恒、能量守恒等偏微分方程,这些方程非线性且因岩石非均质性而几乎无法解析求解,自上世纪60年代以来一直依赖数值方法近似求解。 但传统数值方法面临三重困境。一是计算成本高昂。大型油气藏模型可包含数亿个网格节点,每轮历史拟合需反复正演模拟,计算量随时间步、迭代次数和每次线性求解的计算量三者乘积增长。二是网格生成困难。断层、裂缝、尖灭等复杂地质构造使结构化网格难以贴合,非结构化网格的生成质量直接影响精度和收敛性。三是多物理场耦合的非线性挑战。如CO2驱油中,CO2溶解改变原油黏度同时引起孔隙压力变化,耦合效应使控制方程刚性大幅增加,求解器容易不收敛。
深度学习在图像、自然语言领域所向披靡,但到油气藏就碰了钉子。第一,数据稀缺且“有数据无质量”。中国工程院院士刘合指出,油气行业标准不统一、标注不充分、跨部门共享难。第二,物理一致性无法保证。纯数据驱动模型只学习统计相关性,可能预测出“负孔隙度”或“违反质量守恒”的结果。《Computers & Industrial Engineering》的论文指出,这会造成“虚假信心”(false confidence)。第三,泛化能力差。一个在A油田训练的模型直接用到地质条件不同的B油田,效果往往大幅下降。中科院沈阳自动化研究所明确指出,纯数据驱动模型“难以保证物理一致性和泛化能力”。
物理信息神经网络(PINN)的核心思想是:不只用数据训练神经网络,还用物理定律来约束它。传统神经网络的损失函数只有预测值与标签的误差,PINN增加了物理方程残差——将神经网络预测的解代入偏微分方程,计算两边的差值。如果预测违反物理定律,残差就会很大,损失函数就会惩罚它。这个残差通过自动微分计算,无需离散化网格。这意味着即使标签数据不足,只要物理方程已知,神经网络也能学到物理上合理的解。 近两年PINN在油气藏领域取得实质突破。2025年Chen等在《Petroleum Science》发表PIGNN,将流场视为图,节点间信息传递遵循物理守恒定律。在非均质油气藏压力场预测中,PIGNN相比标准PINN平均L2误差降低76.93%,R2平均得分提高了3.56%——直接验证了物理约束对数据依赖的“替代效应”。中科院沈阳自动化研究所提出的PI-DeepOKAN框架融合Kolmogorov-Arnold网络,构建了“全链路物理约束损失函数”,涵盖多相流控制方程、初始条件、内外边界条件和断层界面约束。 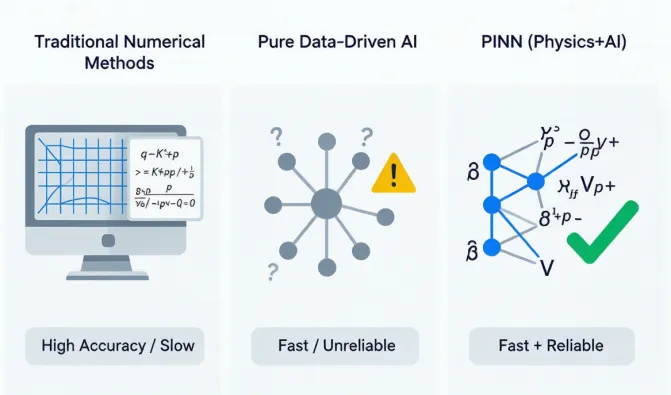
图1 三种油气藏模拟范式对比:传统数值方法、纯数据驱动AI与PINN
全波形反演(FWI)被称为给地球做“CT”,但传统FWI依赖海量算力和人工初始模型,实际生产应用率不足5%。中石油东方物探联合华为、人民大学,基于昆仑大模型攻关AI4FWI,技术路线有三个关键创新:一是数据与机理双驱动的波动方程智能求解,构造物理约束损失函数,推理阶段实现“AI预测-传统算法修正”的协同计算范式;二是基于自动微分的反演框架,减少约50%计算量;三是基于扩散模型的三维地质数据生成。 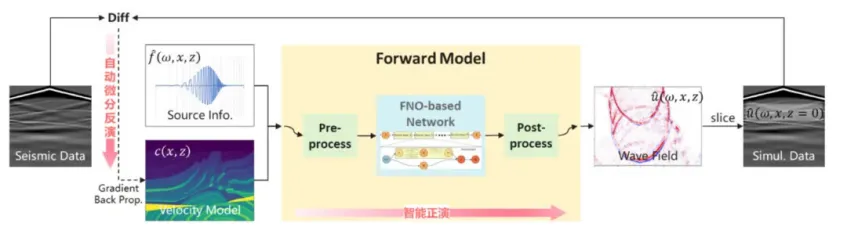
图2 模型推理过程示意 实测数据显示,半小时内可完成一条二维海洋拖缆测线FWI一轮迭代,传统方法需6小时,整体效率提升10倍以上,初始模型依赖程度降低40%。这里有一个关键的技术选择:东方物探没有试图用AI完全替代传统FWI,而是采用“AI预测+传统修正”的协同模式——AI加速物理计算,而非推翻物理定律。 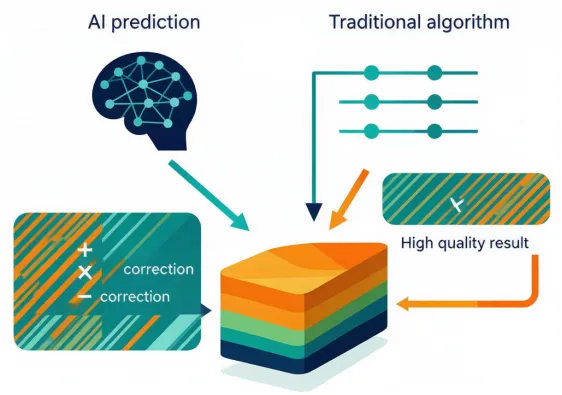
图3 “AI预测+传统修正”协同计算范式示意 胜软科技的识油大模型是国内首个在油气勘探、开发、生产全链条落地应用的工业大模型。据大众新闻报道,“把地质统计学、渗流力学等‘看家本事’揉进模型,让数据规律和物理规律协同发力”。识油大模型已积累超200万份标注数据与1000余条行业规则——这些规则就是油气行业的物理定律和经验公式,被编码为模型约束条件。实际效果:设备故障处置时间从8小时缩短至2.5小时,开发方案优化周期从30天压缩至12天。中国石化的长城大模型2.0则采取大小模型协同架构,机理模型给大模型方案做“物理审查”。 这三个工业案例的共同特征值得注意:无论是波动方程、行业规则还是机理模型,它们都在把物理机制作为AI的“内核约束”而非“外部后置”。这与互联网行业AI应用的“先搜数据再找规律”路线截然不同——油气行业是“先有物理规律,再用数据优化”,物理规律不是发现的,而是已知的。
神经网络天生倾向于先学习低频、光滑的函数,而水驱前沿、裂缝扩展、气液界面跳跃都是高频现象,PINN可能“模糊”掉关键物理细节。 损失函数中数据项和物理项的梯度量级可能相差几个数量级,导致训练极不稳定甚至塌陷为平凡解:“数据项希望模型记住边界条件,而物理项却在强迫模型满足剧烈振荡的物理守恒”。 PINN嵌入的PDE(偏微分方程)通常是理想化的,假设恒定黏度、忽略热效应。一个满足嵌入方程的PINN解,可能在数学上完美,却因忽略多尺度耦合效应而与真实相去甚远。 目前大多数PINN油气研究仍在二维、小规模上验证,真实油气藏的三维全尺寸模型网格规模可达数亿,PINN能否在合理时间内收敛仍是未解之问。
判断一:“机理+数据”是必选项。油气行业的特殊性——物理规律明确但边界条件复杂、数据稀缺但试错成本极高——决定了纯数据驱动AI走不通。物理约束不是限制AI的“枷锁”,而是让AI在数据稀缺场景下仍能工作的“指南针”。中石油经研院副院长吴谋远强调,“深度融合物理规律的PINN技术突破”是未来关键方向。 判断二:AI与传统数值方法是“协同”而非“替代”。昆仑大模型的“AI预测-传统修正”协同范式提供了范本:AI负责快速近似解,传统算法负责精确修正。这种“粗算+精修”的思路,比“用AI完全替代传统方法”务实得多。 判断三:代理模型是近期最佳落地形态。在PINN能直接求解大规模三维油气藏之前,更务实的路径是将其作为传统模拟器的代理模型。 油气行业的智能化,不是在一张白纸上画AI,而是在积累的物理认知上叠加AI。真正的突破不来自“用AI颠覆物理”,而来自“让AI理解物理”。PINN的价值不在于比传统方法更精确,而在于:用物理约束大幅降低了对数据的依赖,让AI在数据稀缺的油气场景下有了可用的可能。昆仑大模型把物理约束写进了波动方程求解器,识油大模型把渗流力学揉进了行业规则,长城大模型让机理模型给大模型“兜底”——这些工业实践共同指向同一个结论:“机理+数据”双驱动,是油气智能化的“最后一公里”。 - END - 欢迎加入石油圈科技人才广场 ↓↓↓ 
01. 油气藏数值模拟:难啃六十年的“

02. 纯数据驱动AI的“致命盲区”

03. PINN:把物理定律“编进”AI

04. 从实验室到油田:工业实践的验证

昆仑大模型AI4FWI:“AI预测+传统修正”
识油大模型与长城大模型:机理兜底
05. 冷静思考:PINN不是万能药

06. 趋势判断:AI加速物理,而非替代物理

结语