ARTICLE · 1229337
我翻完了 to-tickets 的源码,它真正管的是切片、粒度和依赖边
适用:已经在用 AI Coding Agent、但工单越拆越乱、越拆返工越多的团队。读完你会得到一套判断工单拆得好不好的方法,以及一个可能让你不舒服的结论:返工的账记在切片方式头上,不在模型头上。文中所有行为描述来自 to-tickets 的 SKILL.md 源码与 Matt Pocock 在 aihero.dev 上的官方文档。
一、先看那个数字
1 每四次运行,三次在返工
有个团队把一次改动拆成了 26 个工单,按层来拆——语料层、生产层、聚合层、选择层,听起来很规整,也是大多数团队自然而然会采用的拆法。
结果是平均每个工单要跑二十次 agent 才关得掉,而这二十次里大约十五次是在返工。
换算一下:26 个工单跑下来,agent 有三百多次是在把上一次做错的地方重做一遍。
而他们自己的复盘把每一类失败都追到了同一个地方:切片方式,而不是实现。
这个数字来自 Matt Pocock 的官方文档,值得放在开头,因为它把“拆工单”这件事从流程洁癖变成了成本问题——每四次 agent 运行,有三次是在给错误的切片还债。
你可以现在打开自己的工单列表核一遍:有多少条的验收标准里写着“等另一个工单的接口”“联调通过后再验证”。
凡是这么写的,它们在依赖完成之前,既没法通过也没法失败。
2 按层拆,对人类是对的
先说清楚一件事:按层拆不是蠢办法,它是给人类的团队设计的,而且已经跑了几十年。
人类开发者之间可以并行推进,可以互相问一句“你那个接口签名定成什么样了”,也可以在站会上当场对齐。按层拆的时候前端组写 UI、后端组写 API,中间靠一份约定撑着最后再集成,这个模式的代价被沟通能力吸收掉了。
Agent 没有这些缓冲。它接手一个工单时上下文里就只有这个工单本身,既不知道另一个工单里的接口长什么样,也开不了口去问,更不会在站会上举手。
于是按层拆出来的工单会同时犯两个错:一是每个工单自己都不完整,做完之后没有任何东西能跑起来。二是每个工单的验收标准必须伸手到别的工单的地盘里才能验证。
第二条比第一条更致命。一个工单的验收标准如果依赖另一个工单的产出,那么在那个工单完成之前,它既不算做完,也不算做错——你没有任何办法判断它是通过了还是没通过,只能等。
等着没法验收的工单,和没有验收标准的工单,代价是一样的。
二、垂直切片:一条能跑通的细线
1 tracer bullet
to-tickets 对这个问题的解法叫 tracer bullet,曳光弹。
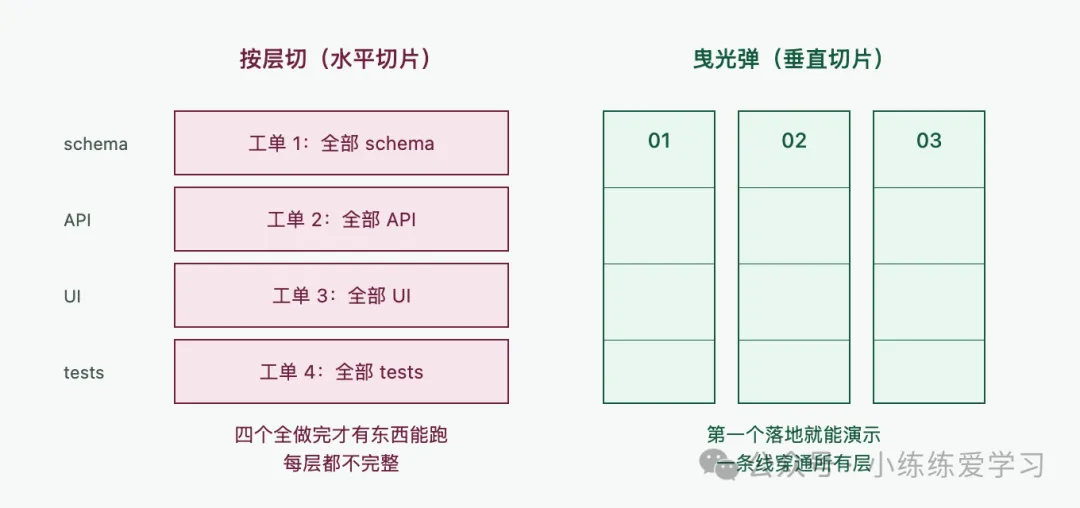
— 左边是按层切:每层都不完整,最后才能集成。右边是曳光弹:一条细线穿通所有层,落地即可演示
源码里给了四条硬规则,一条比一条具体。
每个切片要穿过每一层的一条窄而完整的路径(schema、API、UI、测试,缺一不可),一个完成的切片自己就能演示或验证。另外两条是:每个切片的大小要能装进一个全新的上下文窗口,需要预重构的部分排在最前面。
第二条和第三条的组合效果值得单独看:它不只要求“完整”,还要求“小到能被一个没见过 spec(需求文档)的会话独立完成”。这两条叠在一起,才把工单从任务清单变成了可派发的单元。
2 一个判断方法:做完了你能演示什么
官方文档里给了一个特别朴素的检验法,我认为这是全文最实用的一句——对每个工单问一遍“做完了我能演示什么”,答不上来的就是水平切片。
官方文档记录了一位使用者的做法:在工单模板里加一行 demo path 专门写这个,反馈是加了这一行之后模型明显更容易产出垂直切片。
这个技巧值得直接抄走,因为它把一个抽象的设计原则变成了一个模型每次都要填的字段。
三、粒度的单位被换掉了
1 从人天到上下文窗口
源码里那句 “sized to fit in a single fresh context window” 是被低估的一句话,也是我认为这个 skill 最重要的一处设计。
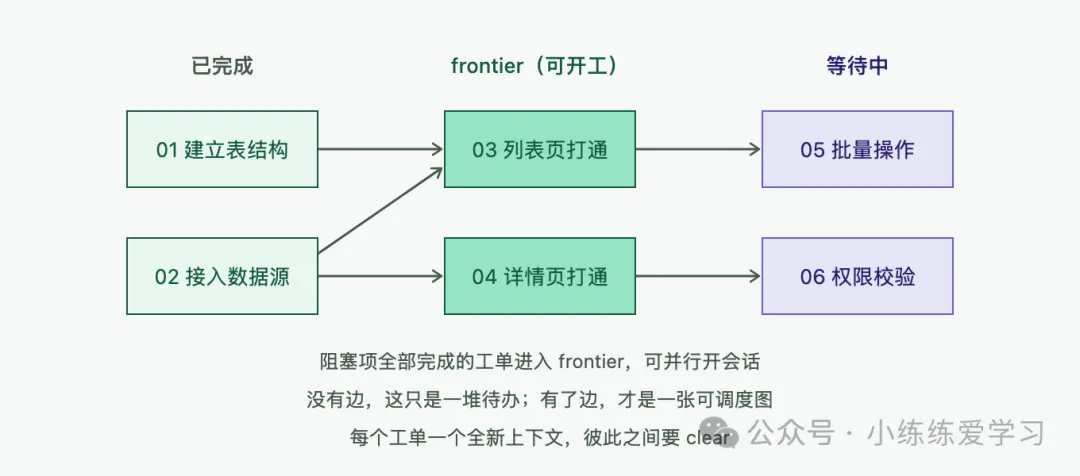
— 同一个需求,换一个度量单位,拆出来的形状和数量都不一样
传统拆工单的度量单位是人天或者故事点,隐含假设是接手的人有项目背景、知道上下文,缺的只是时间。to-tickets 把单位换成了上下文窗口,隐含假设完全相反——接手这个工单的会话,从来没见过你的 spec。
这不是措辞变化,是度量单位的替换。工单的粒度不再由“多久能做完”决定,而是由“多小的东西能让一个零上下文的会话独立完成并且验证”决定。同一个需求按人天拆可能是三个工单,按上下文窗口拆可能是七个,也可能一个都不用拆。
2 太细,也是失败
三行改动拆出十二个工单,这是 to-tickets 被报告最多的问题,原因并不玄——模型默认按原子单位拆解,它看得见最小的操作,看不见人脑里那个“这几步其实是一件事”的分组。
修的地方在 quiz 环节(拆完之后逐条拿给你确认的那一步),直接让它合并它就会照做,这后面会讲到。
3 细的下面还有一层:太粗就别拆
官方文档写得很直接:如果整个改动能装进一个上下文窗口,你根本不需要这个 skill,直接 implement 就好。
这条边界是 skill 自己声明的,它很重要。它说明 to-tickets 的定位是“只有跨会话的工作才需要工单”,而非“所有工作都要拆工单”。
工单的本质是跨会话的信息载体。一个会话就装得下的活,拆成工单只是给自己增加同步成本。
四、边,才是这个产物的重点
1 没有边就没有调度
官方文档有一句原话:“The edges are the point of the artifact.”
每个工单都要声明它的 blocking edges(阻塞边)——哪些工单必须先完成它才能开始,而没有任何阻塞项的工单可以立刻开工。
为什么边才是重点?因为没有边的工单列表只是一堆待办,有了边才是一张可调度图。
它决定两件事:哪些工单现在就能派给 agent(这批叫 frontier,就是没有阻塞项、随时能开工的那几个),哪些必须等。
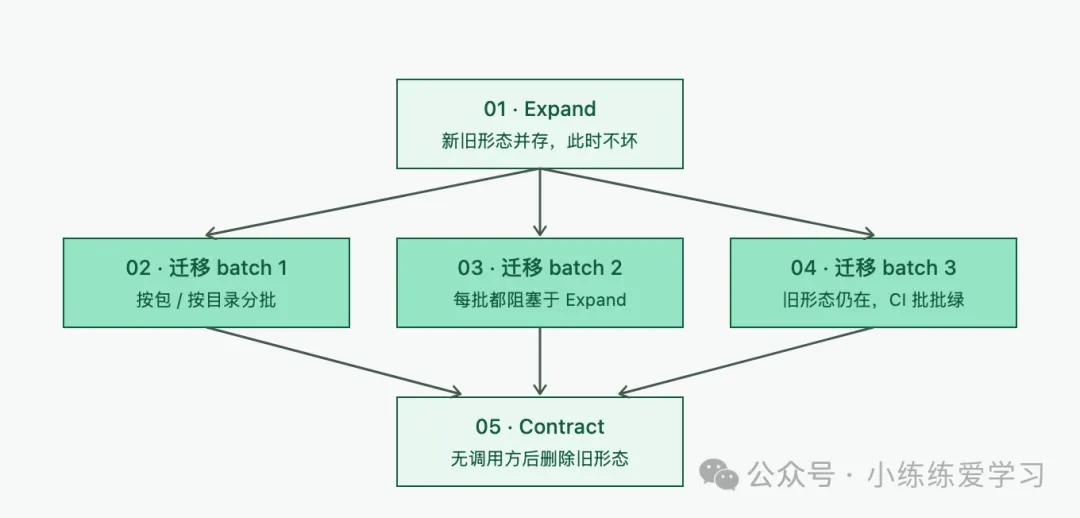
— 有边才有 frontier:03、04 的阻塞项都完成了,可以并行开两个会话;05、06 还得等
2 两种落地形态
边的表达方式取决于 tracker,工单本身则完全不变:本地 markdown 把边写成每个工单文件里的 Blocked by 文字,按编号从上到下手工推进;真实 tracker(GitHub、Linear)用平台原生的阻塞关系或子工单,阻塞项完成的工单会自动进入 frontier。
本地模式把工单写在 .scratch/<feature-slug>/issues/<NN>-<slug>.md。一个工单一个文件,从不合并成一个文件,编号从 01 开始按依赖顺序排,阻塞者在前。
这里的 NN 不是装饰,它是真 ID——你可以直接 /implement 03,不用再敲一遍长标题。真实 tracker 上按依赖顺序发布(阻塞者先发),这样每个工单创建时都能拿到前序工单的真实编号,然后打上 ready-for-agent 标签。
3 工单模板里藏着三条规则
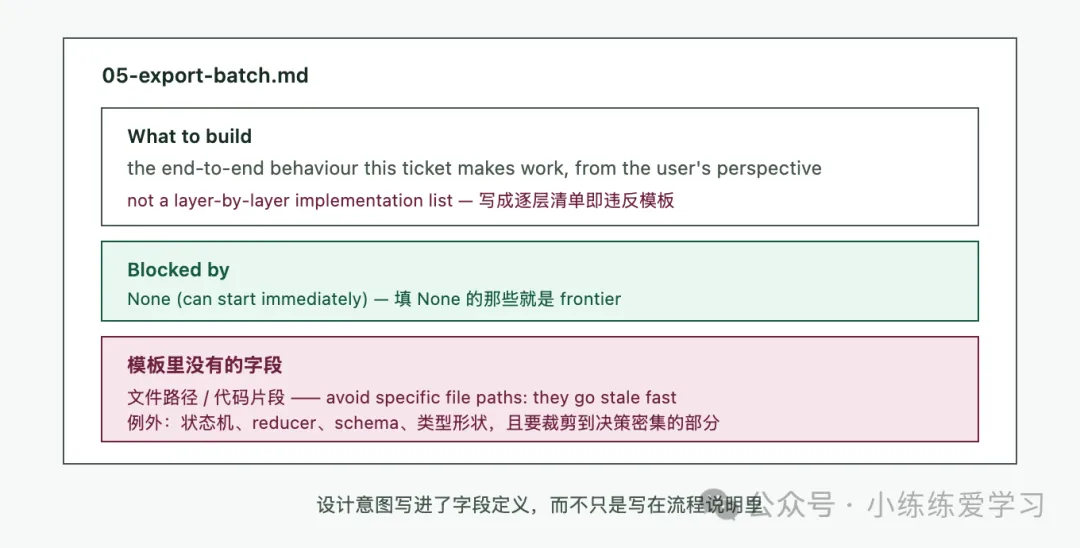
源码给了两套模板,本地文件和 issue 各一套,但真正有意思的是模板里那几个字段的措辞,它们把设计意图写进了字段定义而不只是流程说明。
— 三个字段的设计:一个规定了写法,一个让 frontier 可见,一个是刻意缺席
第一条:What to build 后面跟的是“the end-to-end behaviour this ticket makes work, from the user’s perspective, not a layer-by-layer implementation list”。也就是说垂直切片这条规则不只写在流程里,还写进了字段本身——填这个字段的时候如果写成了逐层实现清单,就已经违反了模板。
第二条:Blocked by 允许填 “None (can start immediately)”。这个默认值看着不起眼,但它让 frontier 一眼可见——扫一遍所有工单,填 None 的那些就是现在可以开工的。
第三条,也是最反直觉的一条:模板里没有“文件路径”和“代码片段”字段。源码原话是 “avoid specific file paths or code snippets: they go stale fast”,因为路径和行号会过期,而行为描述不会。唯一的例外是原型产出的、能把决策表达得比散文更精确的片段(状态机、reducer、schema、类型形状),而且源码强调要裁剪到决策密集的部分,不是把能跑的 demo 整段贴进去。
第三条值得单独记一下,因为大多数团队的工单里恰恰写满了文件路径。
五、两个例外
1 发布前那一步:prefactoring(预重构)
在切切片之前,to-tickets 会先找预重构的机会,并且把它们排在最前面,依据的原则是一句老话:“Make the change easy, then make the easy change.”(先让改动变容易,再做那个容易的改动。)
这句话在工程上是对的,但在排期上经常输给“先做功能”,而 to-tickets 把它写进流程,等于在排期层面给了它优先级。
2 硬套垂直切片会翻车的那一类
有一类改动硬套垂直切片会翻车,那就是 wide refactor(大范围重构)。
它是一次纯机械的改动(改个列名、换个共享类型),但爆炸半径覆盖整个代码库——一处改动让几千个调用点同时报错,没有任何垂直切片能在落地时保持 CI 绿。
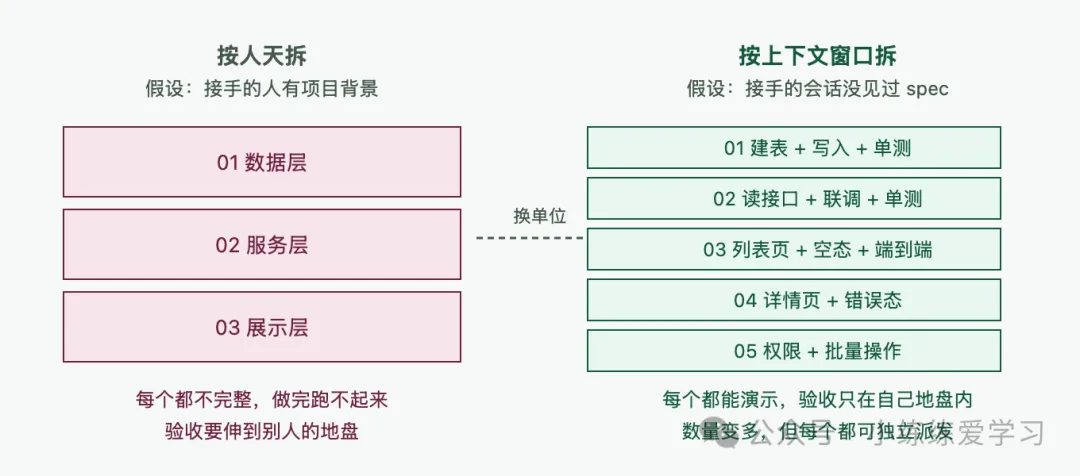
to-tickets 对它的处理是 expand–contract 三段式:
— expand–contract:先并存,再分批迁移,最后删除旧形态,CI 全程保持绿色
Expand 阶段在旧形态旁边加入新形态,此时什么都不坏。Migrate 阶段按爆炸半径分批迁移调用点,一批一个工单、每批都阻塞于 expand,因为旧形态还在,所以 CI 可以做到批批绿。Contract 阶段确认没有调用方了再删掉旧形态,这个工单阻塞于所有 migrate 批次。
源码还留了个更极端的情况:如果连分批都保证不了每批单独绿,那就让它们共用一个集成分支,全部阻塞于最后那个“集成并验证”的工单,绿色只在那里承诺。
这段是整份 SKILL.md 里工程密度最高的部分,也是唯一一处为“分批也保证不了绿色”留了退路的地方。
六、人的位置
1 quiz:必须人批准才发布
拆完之后不是直接发,而是先拿给你看,逐条问三个问题:粒度合适吗(太粗还是太细)、阻塞边对吗(每个工单是不是只依赖真正卡住它的那些)、有没有要合并或继续拆的。
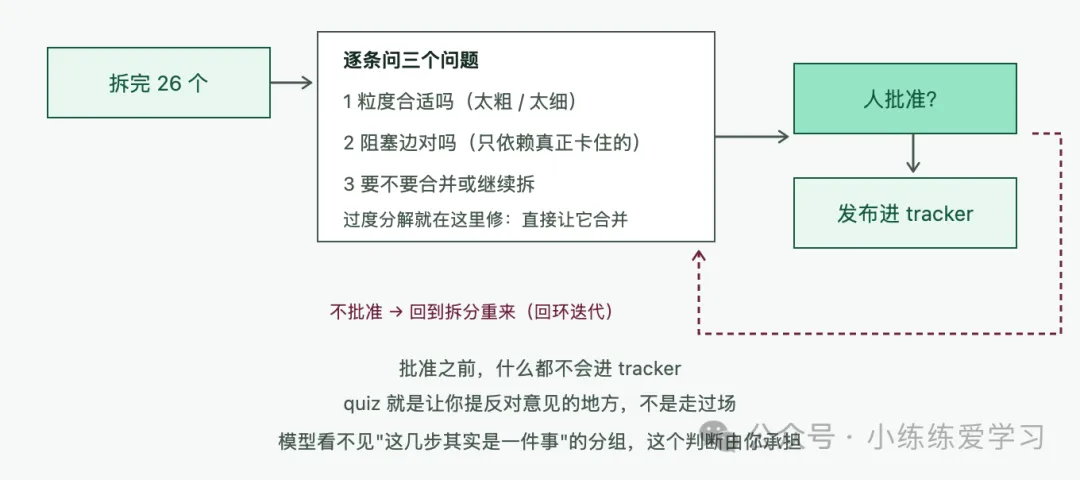
— quiz 是回环不是过场:不批准就回到拆分重来
迭代到你批准为止,在批准之前什么都不会进 tracker,官方文档说得很明白:这个 quiz 就是让你提反对意见的地方。
2 为什么不让模型自己调用
SKILL.md 的 frontmatter 里有一行 disable-model-invocation: true,意思是模型不会自动触发这个 skill,必须用户显式调用。
这个设计选择值得琢磨:拆工单不是执行而是决策,它决定了接下来几十次 agent 运行的形状,让模型自己决定“我要不要把这段对话拆成工单”,等于把排期权交了出去。
同类判断还有一条——官方文档特别说明,to-tickets 产出的工单天生就是 agent 就绪的,不要再对它们跑 triage,因为 triage 是给外部来的活做分类的,对自己刚拆出来的工单做分类纯属浪费。
七、作者自己承认的七个坑
1 七个已知的坑
下面是作者自己在文档里承认的问题,我原样搬过来,因为一份只讲优点的工具介绍不值得信。
坑一:过度分解。三行改动出十二个工单,修法在 quiz 环节让它合并。
坑二:它有时还是会按层切。垂直切片的规则就写在那儿,模型仍有跑偏的时候,识别方法就是「做完了你能演示什么」那个问题——做完了能演示什么?
坑三:GitHub 上没建成子工单。在十几次运行、多个模型上都出现过,集中记录在 issue #554,现已修复:to-tickets 会把每个工单建成源工单的子工单,tracker 模板里给了命令(gh issue create --parent <n>,需要 gh 2.94+)。
坑四:“Blocked by” 被写进了正文而不是真实阻塞链接。记录在 issue #513,其中有个细节挺有意思——agent 当时甚至声称 GitHub 根本没有原生阻塞关系,实际上是有的:gh issue create --blocked-by 12,15。因为 skill 按依赖顺序发布,创建时前序编号总是已知的。正文里那段文字只是给没有原生边能力的 tracker 兜底,不该是默认行为。
坑五:单文件 tickets.md 的写竞争。v1.1 的说明里写的是根目录一个 tickets.md,这是个 bug——多个 agent 并行写同一个文件会打架,现在改成每工单一个文件。
坑六:大 spec 读到一半就截断。spec 太大时 tracker 一次返回不完,agent 反复分块抓取,永远读不到底。
官方给的建议是别在 /to-spec 和 /to-tickets 之间做 clear 或 compact——放在同一个上下文窗口里跑,agent 根本不用把 spec 取回来。
坑七:验收标准本来就是绿的。这是七个坑里最隐蔽的一个,后文会细说。
2 验收标准为什么可能天生是绿的
模板要求写验收标准,却没要求这些标准有失败的可能,于是就出现了某些标准在还没动手之前就已经通过的情况。
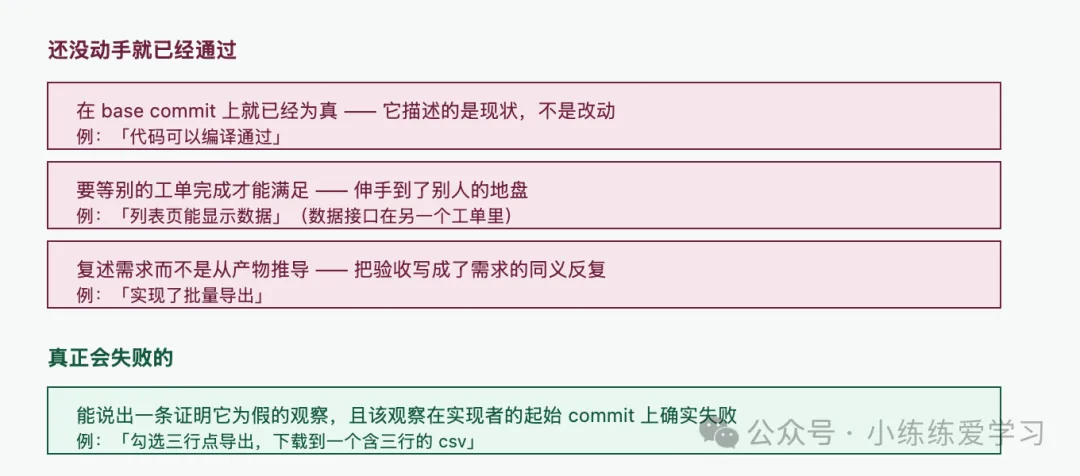
— 上三条在开始时就不会失败,下一条才是真标准
文档里总结了三种形态:
· 在 base commit(动手改之前的那份代码)上就已经为真的(它描述的是现状,不是改动)
· 只有别的工单完成才能满足的(伸手到了别人的地盘)
· 复述了需求而不是从产物推导出来的
垂直切片能挡掉大部分,因为一个真正交付新行为的切片,在动手改之前的那份代码上本来就跑不通;但文档也说了手工检查仍然值得做,方法是——对每一条标准,想出一条能证明它不成立的观察,再确认这条观察在实现者起步的那份代码上确实是失败的。
一条在开始时就不会失败的标准,测不出任何东西。这句话值得贴在每个工单模板上。
3 它没告诉你怎么派活
官方文档里有个很直白的说明:这个 skill 停在产出物,没有自动派发模式。
派发是手工的——看板上一数,有几个工单的阻塞项都完成了,就开几个 agent 会话,每个工单给一个全新上下文,彼此之间要 clear。
另外还有个容易踩的细节:implement 并不会可靠地把工单关掉或勾掉,GitHub 上不会,本地 markdown 也不会,工单状态得你自己更新。
八、怎么用起来
1 前置条件与一次完整调用
to-tickets 要往 tracker 里发东西,所以必须先跑一次 /setup-matt-pocock-skills,把 tracker 和 triage 标签词汇表配好。
两种 tracker 都行:真实的 GitHub / Linear,或者本地 markdown(.scratch/ 下,不需要额外配置)。
安装命令:
npx skills add mattpocock/skills --skill to-tickets
调用方式是有 spec 时 /to-tickets #<spec_issue>,或者计划只存在于对话里时直接 /to-tickets 让它读当前对话。它在整条链上的位置是:
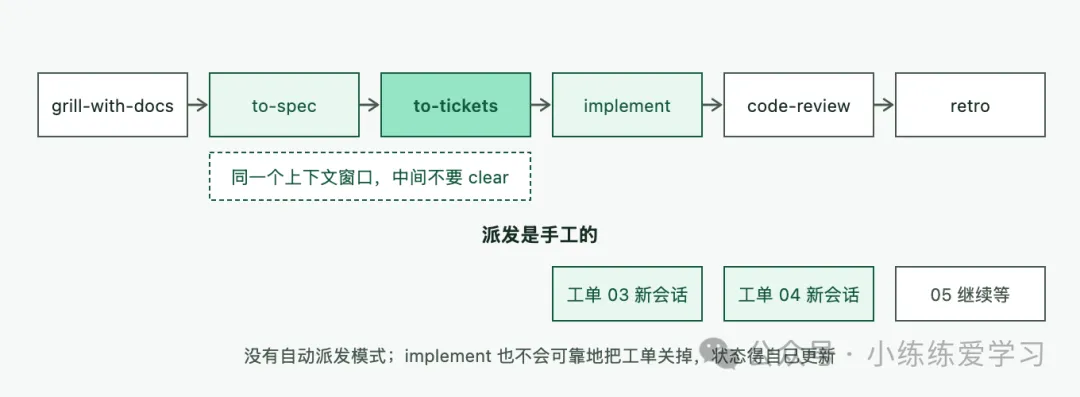
— to-spec 与 to-tickets 要同窗口;往下每个工单一个全新会话,派发靠人手
grill-with-docs → to-spec → to-tickets → implement → code-review → retro
链条最前面的 grill-with-docs 负责把模糊的需求问清楚,最后的 retro 负责复盘。
上游是 to-spec,交过来一份已经定下来的 spec,两个 skill 要放在同一个上下文窗口里跑,中间不要 clear(见坑六);下游是 implement,一个工单一个全新会话。
2 团队落地:tracker 这一关
to-tickets 的原生阻塞关系依赖 GitHub 或 Linear,而很多团队在用的 TAPD、Jira、飞书多维表格里,多数没有标准的 blocking link(阻塞关系)能力,只有“关联工单”或者自定义字段。这直接影响一件事:frontier 算不出来,得靠人扫。
落地路径分两种。
团队已经在用 GitHub 或 Linear 的,直接用真实 tracker 模式,边的价值能全部兑现。用内部 tracker 的,先走本地 markdown 模式(.scratch/ 下一个工单一个文件),它不依赖 tracker 的任何能力,编号本身就是 ID,等确认真有价值了再考虑接内部系统。
如果一定要接内部 tracker,可以用自定义字段模拟 blocked by,但会有两个小问题:一是 frontier 得人工算,二是并行度上不去——边的价值有一半来自“谁可以开工”能被机器回答。
九、什么情况下别用它
1 五个别用的信号
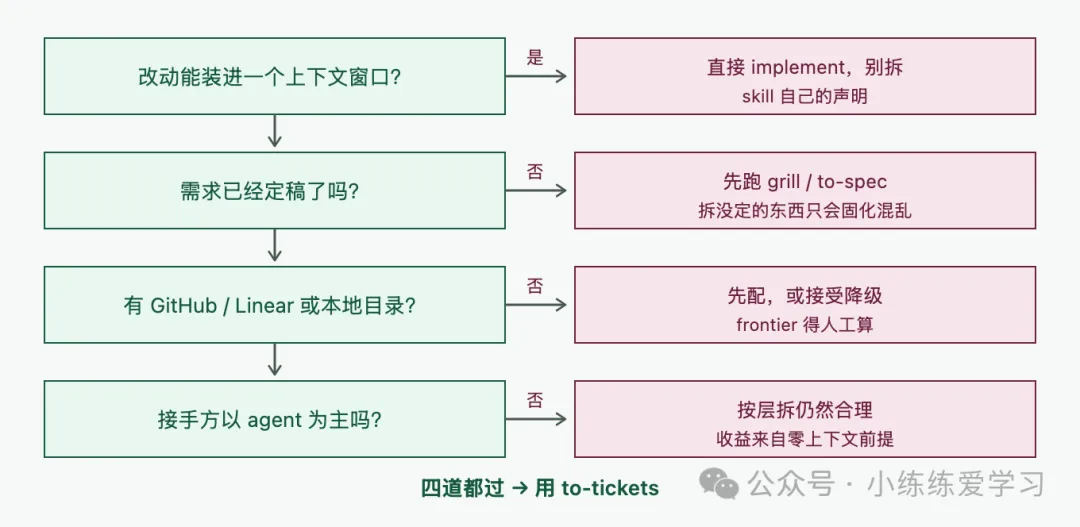
— 别用的信号
· 改动能装进一个上下文窗口——直接 implement,别拆(skill 自己的声明)
· 需求还没定——先跑 grill-with-docs 和 to-spec,拆一个没定的东西只会把混乱固化成工单
· 你没配 tracker——要么先配,要么接受本地 markdown 模式
· 团队以人为主而非以 agent 为主——按层拆对人类协作仍然合理,垂直切片的收益主要来自“接手方零上下文”这个前提
· 你期待它自动派活和自动关单——它不做这两件事(见《它没告诉你怎么派活》)
2 它没解决什么
三个没被覆盖的地方。
一、粒度判断仍然要靠人。模型给不出“这几步是一件事”的分组,这个判断在 quiz 环节由你承担,它不会因为装了 skill 就自动变好。
二、工单之间的信息损耗只是被降低,没有被归零。每个工单一个全新上下文,意味着前序工单的实现细节不会被继承,垂直切片把损耗压到了最低,但跨工单的架构一致性仍然需要一个人在上面看。
三、它不评估工单是否值得做。它只管怎么拆,不管该不该拆,需求本身错了的话,拆得再漂亮也只是更快地做错。
十、真正值得带走的三条
回到开头那个数字。一个团队把一次改动拆成 26 个工单,平均每个工单要跑二十次 agent 才关得掉,这二十次里大约十五次是在返工。复盘把每一类失败都追到了切片方式,而不是实现。
这件事的反直觉之处在于,团队通常以为返工是模型能力问题,于是换模型、加提示词、补上下文,但账其实记在了切片方式头上。
to-tickets 真正值钱的地方不在“帮你拆工单”这个动作,而在它把三件事写成了硬规则:切片必须穿通所有层且做完能演示、粒度单位是上下文窗口而不是人天、边是产物的一部分没有边就没有调度。
第三条最容易被漏掉——一堆工单和一张可调度图之间的区别,就在那些边上。
换模型救不了切片。那 75% 的返工,账记在切片头上,不在模型头上。
来源|mattpocock/skills 源码(MIT,含 SKILL.md 全文与工单模板)· Matt Pocock《to-tickets》官方文档 aihero.dev
既然看到这里了,如果觉得有用,欢迎点赞、关注、转发。