ARTICLE · 1235835
查个Bug还得开5个软件?36岁测开直接把5个Skill“焊死”成AI测试工作流矩阵矩阵,效率爆拉100倍,(附Skill)
上周复盘会,TL问了一句:“上个月线上问题平均定位时间是多少?”
我翻了一下记录,沉默了。
一个“支付成功但订单未更新”的Bug,我从Kibana翻日志,到MySQL查订单表,再到IDE看代码,又切回Kibana搜上游服务,再切到MQ控制台,再切回MySQL查支付流水,最后打开飞书翻历史Bug记录。前前后后切了7次工具,4个小时。
更扎心的是,那4个小时里,真正在“思考根因”的时间,不到40分钟。剩下的时间,全花在“找数据、搬结论、对格式”上。
有行业数据显示,测试工程师平均每天要在6个以上工具间切换,超过60%的时间花在信息搬运上。问题不在工具本身,在于它们之间没有一条打通的链路。
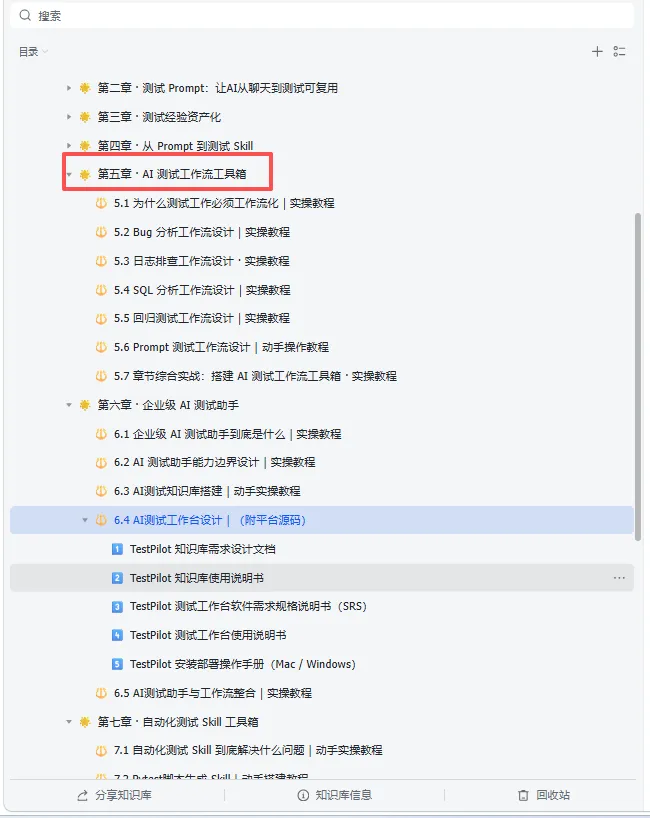
后来我花了整整两周,把测试工作中最高频的排查场景拆解、标准化、封装成了5个职责清晰的助手:Bug分析、日志排查、SQL分析、回归测试、Prompt测试。它们各司其职,又能通过统一的入口和规则串联成一条线。
今天把这套工作流矩阵完整拆给你:五个助手怎么设计、统一规则怎么定、联动怎么跑、源码怎么读。附完整Skill配置,照抄就能用。
一、为什么单点Prompt不够用
先复盘一下单工作流的困境:
手里有5个不同的Prompt,每次用都要翻聊天记录找,复制粘贴后再补充上下文,极其繁琐
Bug分析与日志排查输出各写各的,交给开发或Leader看风格混乱,难以对比和追溯
零散Prompt散落在个人电脑里,新人接手无从下手,无法沉淀形成团队规范
而AI测试工作流工具箱的价值,不是简单地多几个Prompt,而是提供了清晰入口 + 固定流程 + 统一输出。它把测试工作拆成可复用的资产,还能通过Git进行版本管理,真正实现了团队级的能力沉淀。
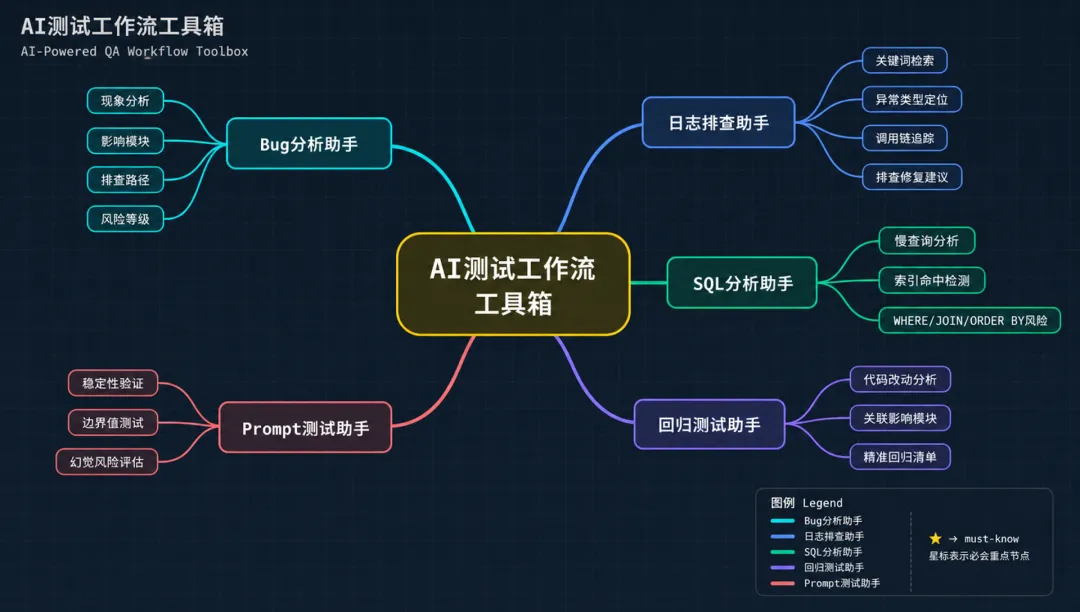
二、工具箱里有什么:5个助手各司其职
举个例子:你拿到一个“支付成功后订单未更新”的Bug,丢给Bug分析助手,它会立刻输出:影响模块是支付回调、订单状态、MQ;推荐日志是payment callback、order status update;推荐SQL是order_info、payment_record;风险等级P0。
每个助手专精一件事,组合起来解决复杂问题。
三、第一步:创建工程化骨架
在项目根目录执行:
mkdir -p $TOOLBOX/{system,workflows,prompts,outputs,assets,templates,examples}touch $TOOLBOX/SKILL.md目录树如下:
工具箱目录结构
$TOOLBOX/├── SKILL.md├── system/├── workflows/├── prompts/├── outputs/├── assets/├── templates/└── examples/各目录承载的资产与职责划分明确:
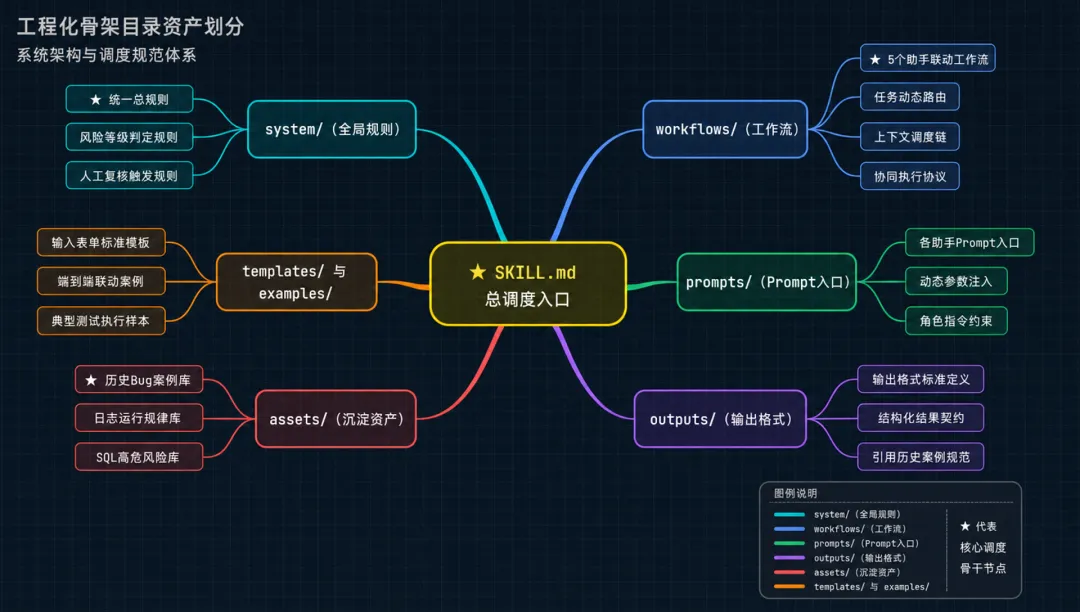
• system/:存放全局规则(风险等级规则、人工复核规则、总规则) • workflows/:5个助手的工作流 • prompts/:5个助手的Prompt入口 • outputs/:5个助手的输出格式定义 • assets/:历史Bug库、日志规律库、SQL风险库、回归规则库、Prompt案例库 • templates/:输入表单模板 • examples/:完整联动案例输出
其中system/层的三个统一规则是灵魂:
风险等级规则:全工具箱统一,P0(资金损失/订单错误/核心链路阻断)、P1(主要功能受损/大面积用户影响)、P2(局部功能/有绕行方案)、P3(展示类/低影响)。所有助手输出必须带P0-P3之一,并写一句理由。
人工复核规则:明确列出必须由测试人勾选确认的清单。
根因是否有日志、SQL或接口等客观数据支撑
风险等级评定是否与实际业务影响完全一致
回归范围划分是否存在过大或遗漏过小情况
SQL优化建议是否需要进一步联系研发或DBA确认
全链路调用排查与日志抓取是否存在断点
AI测试工作台总规则:只执行对应工作流,不得混用;输出必须符合对应格式;必须引用相关资产;证据不足时禁止硬编根因,按工作流列出缺失信息;所有输出文末附【人工复核点】。
四、五个助手的完整配置
助手一:Bug分析
输入模板(templates/bug_input.yaml):包含标题、步骤、实际结果、期望结果、日志片段、接口响应、版本变更。
工作流(workflows/Bug分析工作流.md)核心原则:
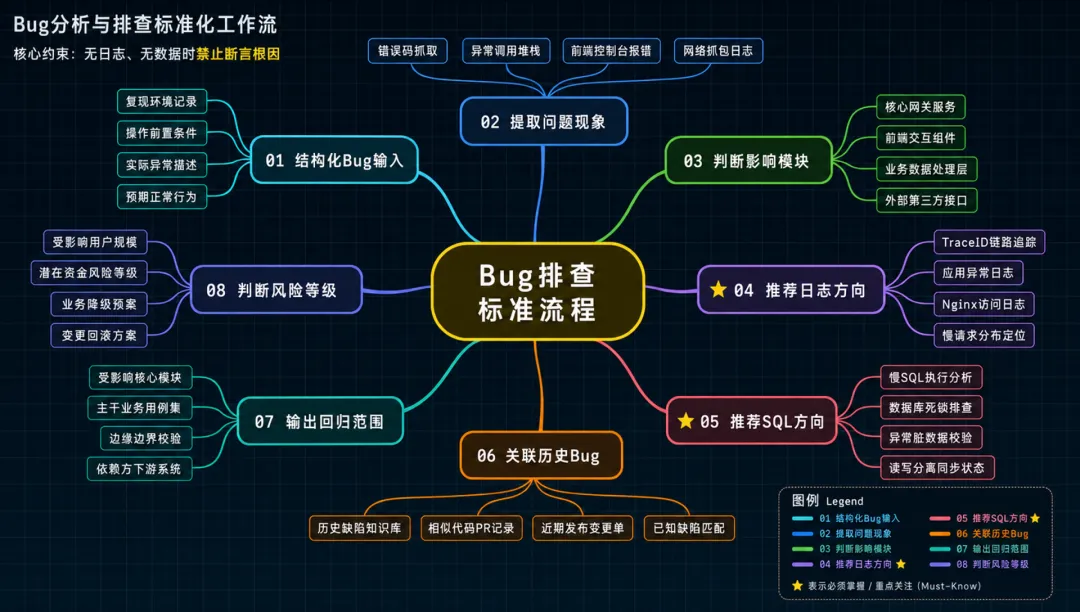
• 禁止跳步:必须按八步流程执行 • 无日志、无数据时禁止断言根因 • 回归分级:必测/建议测/抽测
将非结构化描述按标准模板对齐
梳理客观现象列表,严禁主观猜想原因
圈定关联的服务与业务模块清单
提取日志检索关键词并指定日志文件路径
给出验证数据状态所需的可执行查询语句
检索历史案例库,对齐相似案例与曾用根因
按必测、建议测、抽测分级输出覆盖清单
判定P0~P3等级并附带单句判定理由
输出格式(outputs/Bug分析输出格式.md):固定字段【问题现象、影响模块、可能原因、推荐日志、推荐SQL、关联历史Bug、回归范围、风险等级、人工复核点】。
Prompt入口(prompts/Bug分析助手Prompt.md):
你是Bug分析助手,严格按 workflows/Bug分析工作流.md 执行。加载 assets/历史Bug库.md。输出必须符合 outputs/Bug分析输出格式.md。助手二:日志排查
工作流(workflows/日志排查工作流.md)核心原则:
• 分页全量拉取(最多20页),禁止只查第一页 • 跨服务分析:自动识别上下游服务 • 代码联动:日志中的类名/方法名直接在代码里定位 • 无日志、无数据时禁止断言根因
六步工作流:
1. 关键词提取(异常类型、类名、方法名、错误码) 2. 异常类型识别 3. 调用链分析(上下游服务交叉验证) 4. 模块定位 5. 历史规律匹配 6. 排查建议输出
输出格式:固定字段【异常摘要、调用链路图、错误定位、根因分析、排查建议、风险等级、人工复核点】。
助手三:SQL分析
工作流(workflows/SQL分析工作流.md)核心原则:
• 红线优先:先检查会导致数据损坏的操作 • 分级输出:P0~P3 风险等级 + 理由 • 不自行拍板:不确定的风险标注[待确认]
三大检查维度:
• 安全红线(P0):没有WHERE条件的UPDATE/DELETE;返回敏感字段的SELECT;缺少LIMIT的大表查询 • 性能风险(P1):是否缺少索引;是否全表扫描;是否产生临时表 • 规范检查(P2):是否使用了SELECT *;命名是否符合团队约定;是否有SQL注入风险
输出格式:固定字段【SQL摘要、执行场景、安全红线检查结果、性能风险评估、规范检查结果、影响面评估、优化建议、风险等级、待确认项、人工复核清单】。
助手四:回归测试
工作流(workflows/回归测试工作流.md)核心原则:
• 区分必测/建议测/抽测三级 • 直接相关+间接相关+新增用例 • 按优先级排序输出
工作流:
1. 变更说明输入 2. 影响范围识别 3. 直接相关用例筛选(覆盖变更代码的直接功能) 4. 间接相关用例筛选(可能受影响的关联模块) 5. 新增用例建议(本次变更新增的场景) 6. 按优先级排序输出回归清单
输出格式:回归用例清单+新增用例建议,标注必测/建议测/抽测三级。
助手五:Prompt测试
工作流(workflows/Prompt测试工作流.md)核心原则:
• 固定任务集 + 显式评分规则,不靠主观印象 • 四维断言:版本/接口/禁用项/可追溯性 • 每轮迭代与评测集保持同步
工作流:
1. 定义测试用例集 2. 设定评分规则(Rubric) 3. 执行Prompt,收集输出 4. 执行确定性断言(语法/格式/必填字段) 5. 执行规则或语义评审(LLM-as-Judge辅助) 6. 输出评估报告(通过率/失败类型/改进建议)
输出格式:评估报告,包含通过率、失败类型分布、改进建议、四维断言检查结果。
五、总入口与多助手联动实战
有了5个助手,怎么让它们听你指挥?答案就在SKILL.md里:
--- ai-test-toolbox AI测试工作流工具箱。包含5个职责清晰的助手: Bug分析、日志排查、SQL分析、回归测试、Prompt测试。 当用户提到"分析Bug""排查日志""分析SQL""回归范围""测试Prompt"时触发。 --- # AI测试工作流工具箱 ## 任务路由 - 用户说"分析Bug" → 执行 workflows/Bug分析工作流.md - 用户说"排查日志" → 执行 workflows/日志排查工作流.md - 用户说"分析SQL" → 执行 workflows/SQL分析工作流.md - 用户说"回归范围" → 执行 workflows/回归测试工作流.md - 用户说"测试Prompt" → 执行 workflows/Prompt测试工作流.md ## 联动工作流 当用户描述完整Bug且需要全流程时,按顺序调用五个助手: Bug分析 → 日志排查 → SQL分析 → 回归测试 → Prompt测试(可选) ## 全局规则 所有助手必须引用 system/ 下的三大统一规则。 所有输出文末附【人工复核点】。 通过统一的元数据定义与任务路由,实现单助手精准调用与端到端链式协同调度。
我们来看一个完整的实战案例:“支付成功订单未支付”。
多助手联动执行链路
各步骤具体执行逻辑如下:
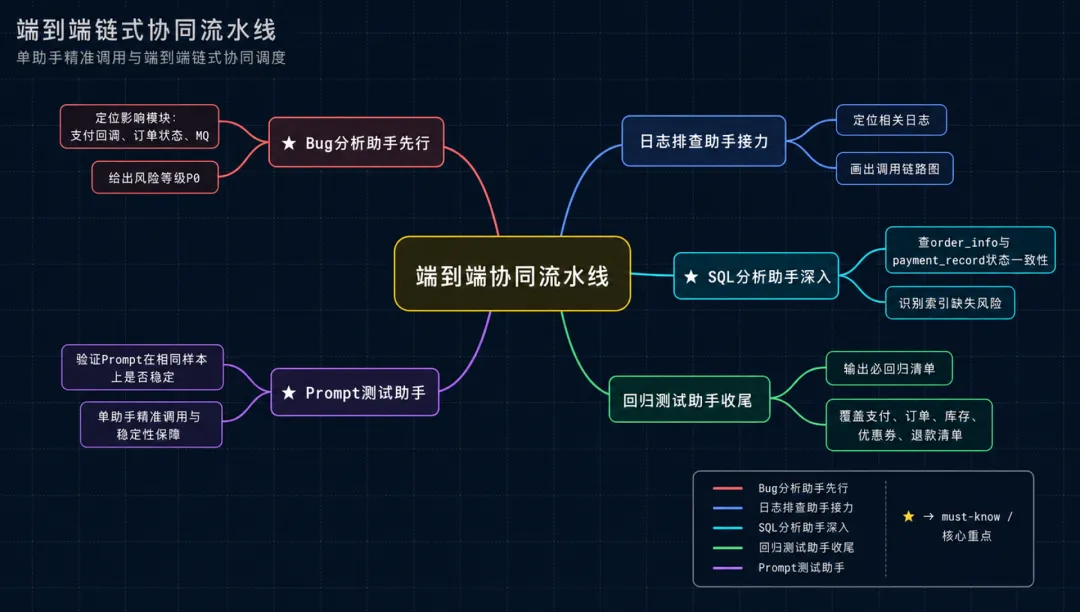
第一步:Bug分析助手先行。定位影响模块(支付回调、订单状态、MQ),给出风险等级P0,并推荐日志和SQL方向。
第二步:日志排查助手接力。根据推荐的日志方向,定位支付回调、订单状态、MQ相关日志,画出调用链路图。
第三步:SQL分析助手深入。根据推荐的SQL方向,查order_info与payment_record的状态一致性,识别索引缺失风险。
第四步:回归测试助手收尾。根据Bug影响范围,输出必回归的支付、订单、库存、优惠券、退款清单。
第五步:Prompt测试助手(可选)。验证Bug分析Prompt在相同样本上是否稳定,确保分析质量不退化。
标准化沉淀带来的产出差距显而易见:
合格输出 | 疑似模块:订单库;证据:支付成功订单未更新;建议SQL:查order_info与payment_record;风险:P0;人工复核:是否重复回调。 | 不合格输出 | 可能是数据库问题,建议检查。 | 规范化对比 :::
六、避坑指南与验收标准
在落地多助手工具箱时,需警惕常见设计误区并及时修正:
验收标准很简单:同事只看SKILL.md,能不能选对入口并完成一次任务?联动案例是否包含4类助手输出+统一P0风险+人工复核勾选?
七、写在最后
回到开头那个Bug。
现在我不切窗口了。我打开一个入口,输入现象和traceId,五个助手按顺序跑完,最后输出一份带证据链的报告。
问题平均定位时间
TL在周报上写了一行:“排查路径标准化完成,平均定位时间从4小时降到18分钟。”
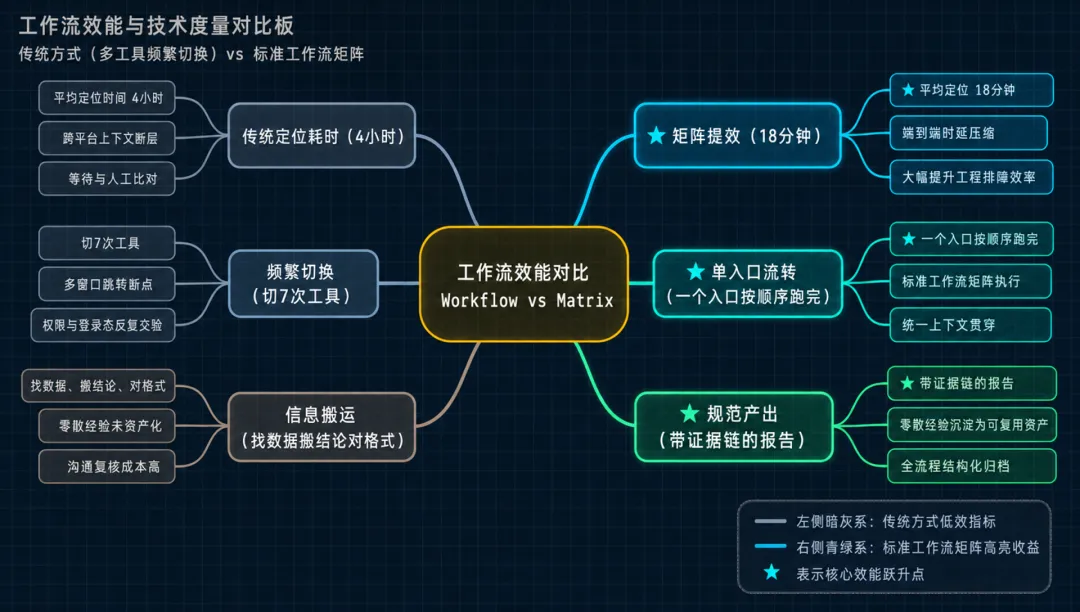
不是因为我变强了,是工具把“切工具、搬结论”这件事接走了。
这套工具箱的意义,不在于它有多复杂,而在于它把“零散的经验”变成了“可复用的资产”。一个Bug怎么查、日志怎么看、SQL怎么优化、回归怎么定,全都沉淀成了标准化的流程和规则。
新人来了,照着SKILL.md就能上手;团队协作,输出格式统一,沟通成本大幅降低。
你定规则,矩阵执行。