ARTICLE · 1236766
软件调用 | AI + Stata 还能有这些玩法?
这篇推文想讲清楚的
把 Stata 的成熟工作流,与 Python、AI Agent 的能力连起来
在寻找社科实证研究相关的 AI Agent Skill 时,我看到一个很有意思的项目:Auto-Empirical-Research-Skills(github.com/brycewang-stanford/Auto-Empirical-Research-Skills)。它整理了 23,000+ 个 Agent Skill,覆盖经济学、政治学、社会学、教育学、心理学等 8 个社会科学领域,获得了 4.7k Star。我们已经学习并把它封装到了实证研究这个套件。
其中有一个把 Stata、Python 和 AI Agent 结合得很紧密的方向——StatsPAI(斯坦福大学团队研发)。我研究了一番,又顺带对比了目前常见的几种“Stata + AI”玩法,整理成这篇推文分享给大家。
目前企小喵已经支持下面所有的能力:
在经管常用软件调用套件中,我们可以通过智能体用pystata直接调用 Stata,运行.do文件。
在实证研究套件中,我们可以调用 StatsPAI 完整经济实证流程,用 StatsPAI 生成 Python 版计量的.py文件。
可以通过 MCP 连接 Stata MCP 与 StatsPAI MCP,也可以做到上面的两种能力。
01
PART
为什么需要这些工具?
WHY THESE TOOLS
Python 已经成为机器学习、数据工程的主流语言,但很多社科研究者,尤其是经济学、管理学、公共政策领域的老师和学生,仍然习惯 Stata 的代码逻辑。比如这样一段很常见的固定效应回归:reghdfe y x, absorb(id year) vce(cluster id)和 Python 语法毫不相关。
问题是,Python 生态很强,但完全迁移代码成本很高;Stata 使用习惯成熟,但与 AI Agent、现代数据科学工具的连接还不够自然。所以现在出现了几种不同的“Stata + AI”玩法,把 Stata 的成熟工作流与 Python、AI Agent 的能力连接起来。
02
PART
简单介绍一下这些工具
THE TOOLBOX
目前玩法我整理出来了这些:StatsPAI、stata-code、pystata、Stata MCP 和 StatsPAI MCP。它们各有侧重,下面逐个介绍。
可以理解为 Stata/R 计量工作流的 Python 化、Agent 化版本。它提供 OLS、IV、固定效应、DiD、RDD、合成控制、匹配、DML 等常见方法,并尽量保留 Stata/R 用户熟悉的标准误、公式和后估计逻辑。简单说,可以把 Stata/R 命令转换成 Python 代码。调用 StatsPAI 的重点是在 Python 中完成实证研究,而不是直接启动本机 Stata。
更像是 Agent 与真实 Stata 之间的桥梁。它可以帮助 Agent 理解现有的.do文件、生成和修改 Stata 代码、执行 Stata 命令、运行完整.do文件、读取r()、e()结果,并返回日志、图形和结构化错误,还能在 Stata 与 StatsPAI 之间进行结果核验。它不是重新实现一个 Python 版 Stata,而是让现代 Agent、Jupyter、VS Code 和 MCP 可以更好地使用真实 Stata。
由 Stata 官方提供的 Python 库,涵盖了所有 Stata 和 Python 的交互方式。简单来说,它允许你在 Python 环境中直接调用 Stata 命令和功能,运行.do文件,实现 Python 与 Stata 之间的无缝交互。
例如 VS Code 中的 Stata MCP Extension,可以让智能体执行选中的 Stata 代码、运行完整.do文件、查看数据、获取回归结果、显示图形,并管理多个 Stata session。因此,Stata MCP 的重点是让 Agent 真正控制和运行本机 Stata。
这里容易混淆——它不是连接本机 Stata 的 MCP,而是把 StatsPAI 中的 Python 计量函数暴露给 AI Agent,让 Agent 通过 MCP 发现和调用 OLS、IV、DiD、RDD、SCM、DML、Matching 等计量方法。
五种工具一句话总结
03
PART
企小喵功能
QIXIAOMIAO · READY TO USE
上面这些玩法,恰好指向我们正在建设的企小喵实证研究智能体所覆盖的方向:一方面保留社科研究者熟悉的 Stata 思维和代码习惯,另一方面接入 Python、机器学习、因果推断、MCP 和可复现研究流程。而且,这些能力在企小喵里并不是需要自己拼装的零件,而是打包好的现成功能。
企小喵把 MCP 与 Skills 按科研任务预先打包成科研套件,开箱即用,不用自己搭环境、调配置,就能直接上手实证研究。它的科研环境管理会自动识别本机已安装的 Stata、R、Python,像 Stata MCP 一样连接本地软件跑回归;它支持 DTA 数据预览和 Jupyter Notebook 编辑运行,代码与结果自动留存,让每一步都可以复现。
连接 MCP 本身也是企小喵的基础能力,只要提供配置方法和对应的 API Key,就能把更多 MCP 工具接入对话中。
接下来我在下方用上述不同的工具演示一遍:
📒 演示任务:用三种方法跑通同一套流程
方法一:使用「经管常用软件调用」套件中的「企小喵-智能体调用 Stata」,实际运行自带的 nlsw88 数据:
① 对工资(wage)和教育年限(grade)进行简单描述统计,说明样本量、均值和标准差
② 绘制工资直方图,标明单位为美元/小时
③ 以 wage 为被解释变量、grade 为解释变量,进行一次线性回归,使用稳健标准误,报告系数、样本量和 R²,简要解释相关关系,不作因果推断
④ 保留 do 文件、运行日志、统计表、回归结果和图表,说明文件保存位置
并用方法二 stata-mcp 和方法三 statspai(StatsPAI 完整经济实证流程)将刚刚的流程复现一遍,结果放在 3 个对应的不同文件夹。
最终结果
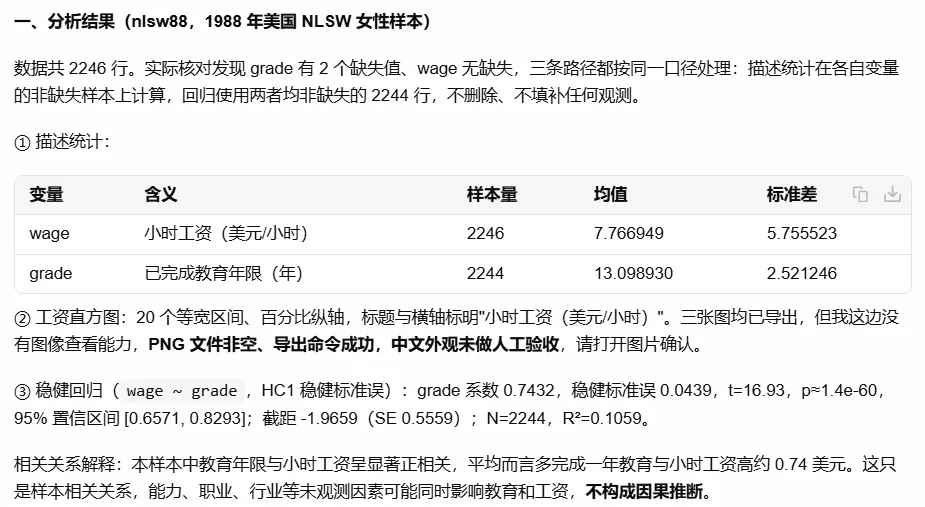
— 企小喵调用 Stata 跑 nlsw88:wage 样本 2246、grade 样本 2244;稳健回归中 grade 系数 0.7432,R² 0.1059
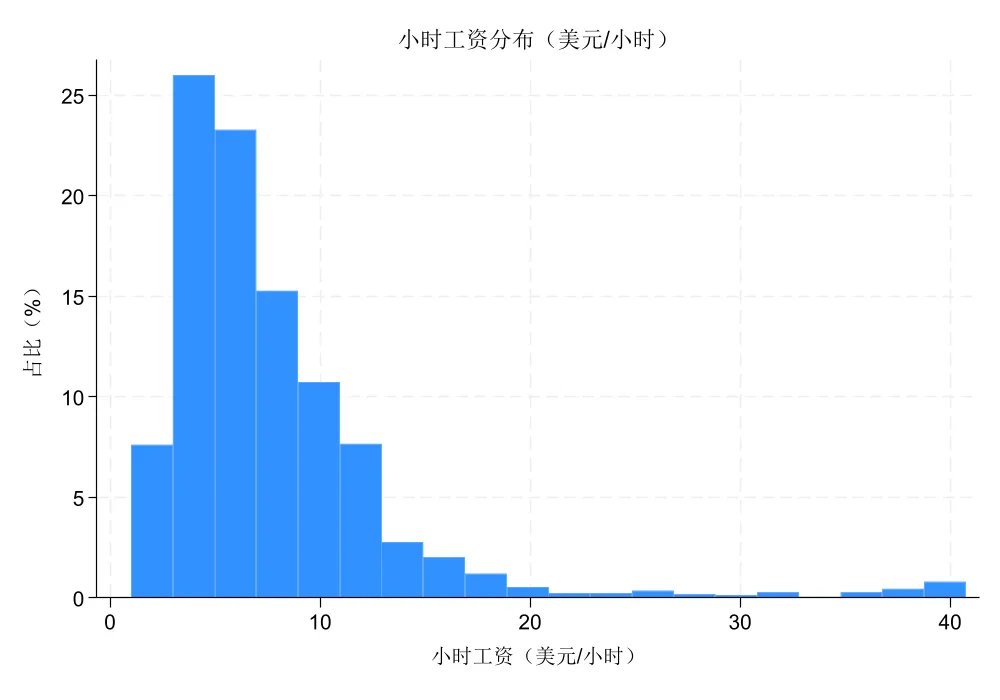
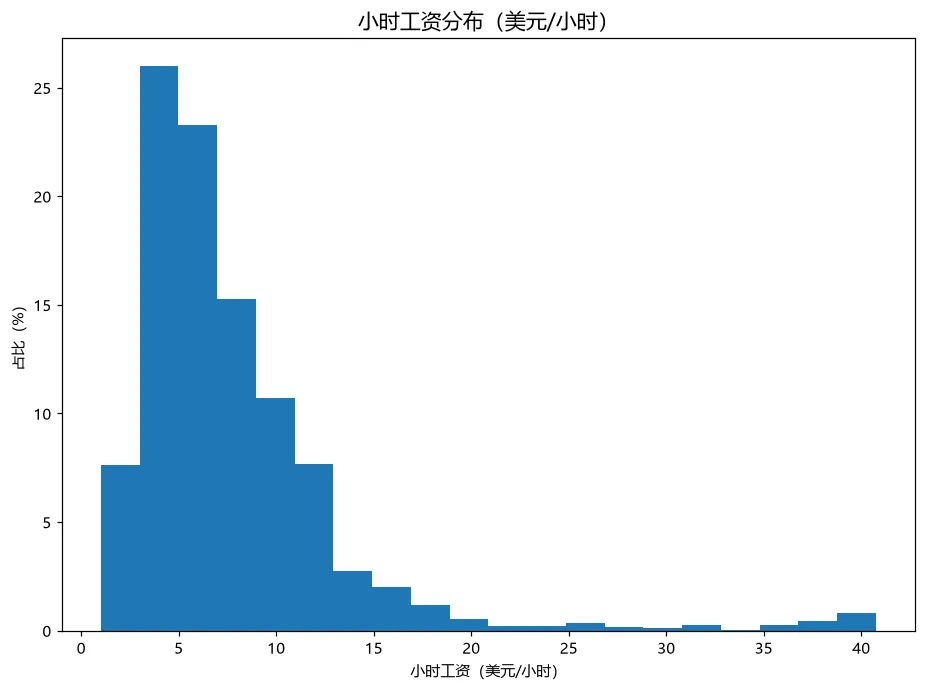
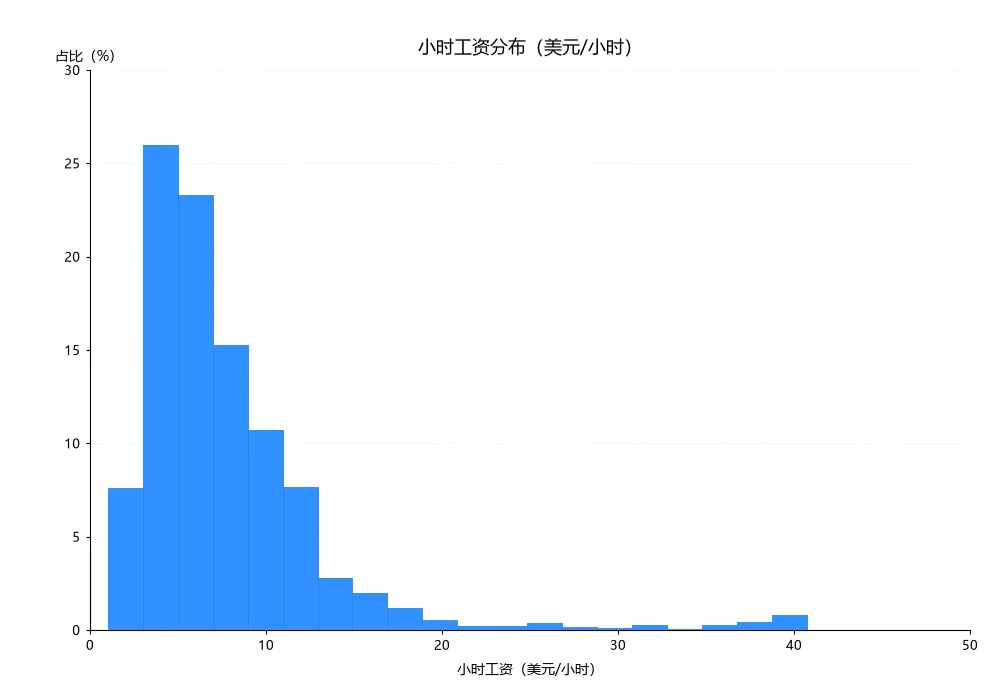
图1 方法1、方法2
图2 方法3
图3 数据可视化优化
图1 是用方法1、方法2 跑出来的,效果一样;图2 用方法三效果差了点,只是将 Stata 统计方法转化为 Python 跑了一遍;图3 用企小喵数据可视化的套件进行了优化。
///
LAST
写在最后
CONCLUSION
让代码编写留给智能体助手,这样,研究者可以把精力留给更重要的判断:识别策略、变量定义、样本处理、平行趋势和稳健性假设。
未来的实证研究工具,可能不再是单纯选择“Stata 还是 Python”,而是:
让 Stata 负责成熟的经验工作流,让 Python 扩展机器学习与因果推断能力,再让 AI Agent 把两者连接起来。
SKILLS 很多,但用心做的不多!
如果大家觉得不错,就来下载我们的企小喵实证研究智能体进行体验吧!
下载地址
agent.qiyansoft.com
-END-
数据 Agent
这里是人工智能、数据分析与学术研究的三叉路口
往期推荐