ARTICLE · 1239726
AI配音嘴型对不上?这款工具几分钟搞定专业团队数周的活
上周帮朋友处理一条产品讲解视频,中文改英文配音,人还是那个人,嘴还是那张嘴,声音一换,整个人像被抽了魂。配音演员的‘th’咬得干脆利落,画面里那张嘴却还在念中文的‘四’,软绵绵地咧着。观众说不上来哪里不对,但眼睛就是难受,三秒钟,划走。
这种‘音画两张皮’的膈应感,做过本地化视频的人都懂,深夜盯着时间轴一帧一帧对嘴型,对到凌晨三点脖子僵得像块木板,第二天客户还说‘感觉怪怪的’。
逐帧修嘴这门手艺,为什么又贵又慢
逐帧修嘴这门手艺,为什么又贵又慢。
模型干的活把声音拆成音素再贴回嘴上
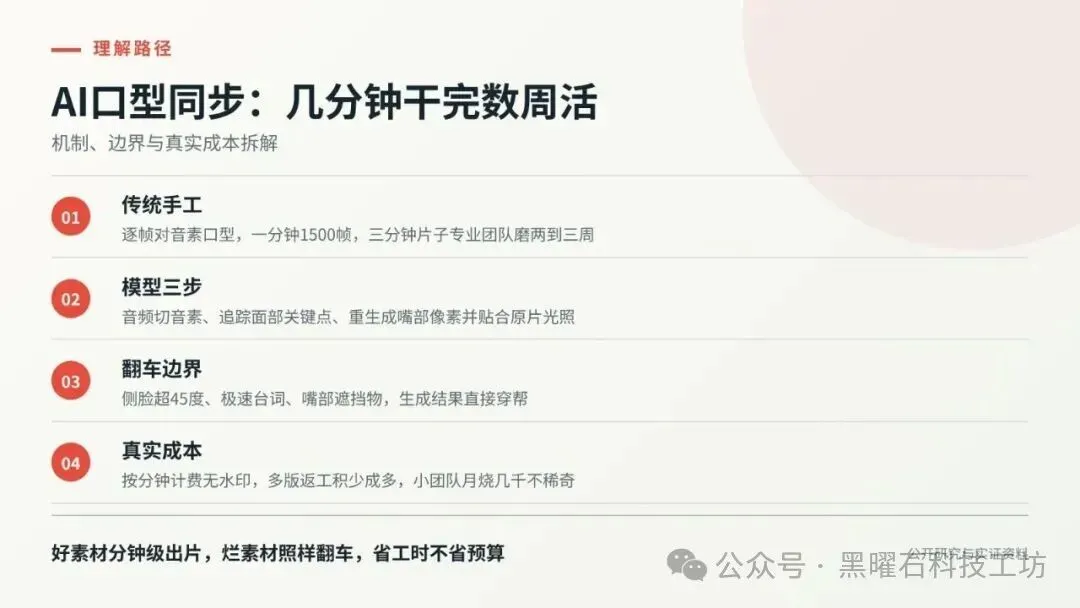
传统做法有多原始?后期师把视频按帧拆开,盯着发音找对应的口型关键帧,英语四十多个音素,每个音素对应一套嘴唇、牙齿、舌头的组合姿态,一分钟视频一千五百帧,熟练工一天也就修十几秒。一条三分钟的片子,专业团队磨两到三周很正常,报价按秒算钱。
这活儿累眼睛,更累腰,我认识的一个后期师修到腱鞘炎发作,手腕上贴着膏药还在拖时间轴。Synclabs 这类工具宣称几分钟干完这几周的活,核心是一个叫 lipsync-2-pro 的模型,支持真人、动画、AI 生成角色,网页端拖进去就能跑,也给了 API 让技术团队批量怼。
救不了的素材和躲不掉的翻车
模型干的活:把声音拆成音素再贴回嘴上。
动手前先看这三条
它干的事拆开看其实挺直白。第一步,把新配音的音频切成极短的片段,识别每段对应哪个音素,是爆破音还是摩擦音,嘴唇该闭还是该咧。第二步,在原视频里追踪说话人的脸部关键点,嘴唇轮廓、下巴开合、脸颊牵动,全标出来。第三步最吃算力:生成新的嘴部像素,让嘴唇动作卡上音素的时间点,同时把牙齿、口腔内部的暗部补出来,还得让新嘴和原来的光照、肤色、颗粒感糊在一起,不能贴上去一块假皮。
难就难在最后这步,人脸是全身最挑剔的部位,嘴角歪半毫米、牙齿反光不对,大脑立刻报警。这也是为什么这类模型推理时显卡风扇狂转,我跑一条 40 秒的 1080p 素材,云端排队加生成等了四分多钟,本地就别想了,消费级显卡跑这种活纯属自虐。
声音克隆
救不了的素材和躲不掉的翻车 但别急着把后期团队解散。我测下来,有几类素材它照样翻车。侧脸超过四十五度,嘴唇被鼻子挡住一半,模型只能靠猜,出来的嘴像含了颗糖。快速绕口令式的台词,音素切换快过帧率,嘴部会糊成一团果冻。还有原视频里人物喝水、捂嘴、抽烟的段落,遮挡物一上,生成的嘴直接穿帮。
另外声音克隆那部分,平台给到最多 50 个克隆额度,但克隆出来的声音读感情充沛的台词时,语调平得像机场广播,配上激动的画面反而更诡异。付费版无水印,按分钟计费,一条片子改五六版是常事,账单积少成多,小团队一个月烧掉几千块不稀奇。
动手前先看这三条 明天你要试,照这个来。先挑素材:正脸、光线均匀、嘴部无遮挡、语速中等,这种片子成功率最高。再把配音音频提前处理好,降噪、响度拉齐,脏音频进去,音素切分先歪一半。最后别贪长,先切 15 秒最激烈的台词段落丢进网页工作室试跑,看嘴角和牙齿细节能不能过你这关,过了再批量走 API。跑完导出,拉到剪辑软件里逐帧扫一遍下巴和脖子衔接处,那里最容易露馅。