ARTICLE · 1243135
LangGraph 学习之路:给文档摘要接上模型
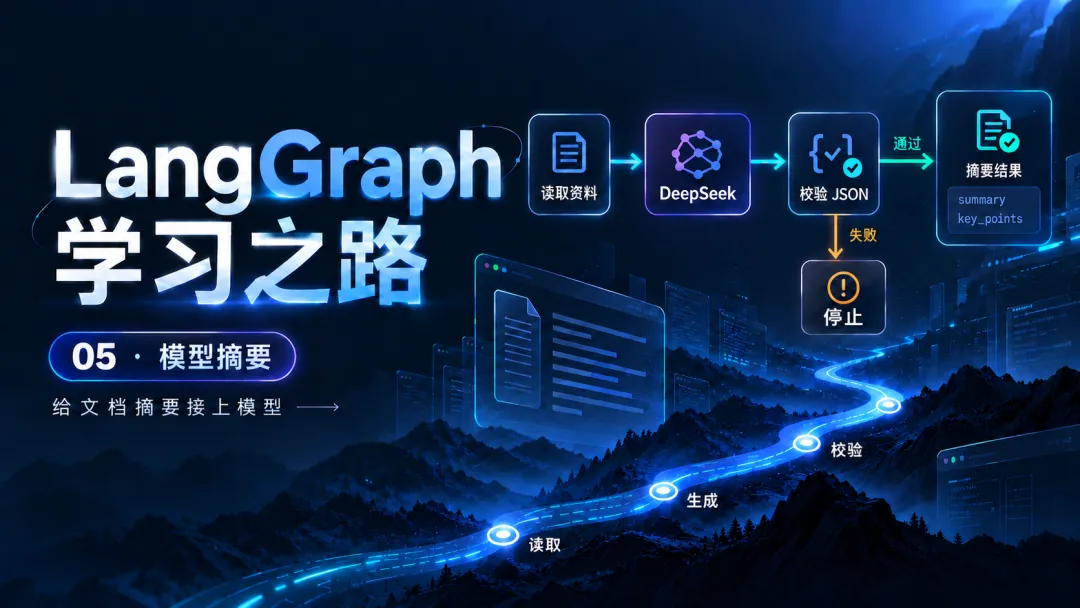
前四篇,我们一直在用普通 Python 函数处理资料。检查、返工和停止都能跑起来了,不过第四篇的报告正文还是预先写好的。流程有了,接下来就试试让模型读资料,自己生成一段摘要。
这次我接上了 DeepSeek,先后试了出差规定和访客须知两份资料。调用是通的,但把输出读一遍,摘要的效果和程序能否继续往下走,还得分开看。我们先跑起来,再顺着结果看看代码里做了哪些处理。
先接上 DeepSeek,看看它会怎么写
我们先从仓库根目录进入第五篇,安装依赖,再复制一份本机配置:
cd chapters/ch05_llm_summaryuv sync --lockedCopy-Item .env.example .env打开 .env,填入自己的密钥和模型名称。这个文件留在本机,不提交到仓库:
DEEPSEEK_API_KEY=填写自己的密钥DEEPSEEK_MODEL=deepseek-flash我这次用的是 deepseek-flash。换成其他模型时,要确认它支持本例需要的 JSON Output,名称可以查 DeepSeek 官方模型列表 [1]。
配置好以后,运行真实模式:
uv run --locked--env-file .env python -m chapter_demo --mode real这里的 --env-file 交给 uv 处理,把文件里的配置加载到进程环境,程序再通过 Settings.from_env() 读取。只填好文件、却没在命令里带上它,程序不会自动去找这份 .env。
这条命令会把资料发给 DeepSeek,可能产生调用费用。本例每次运行至多请求一次,不自动重试。
先用包内的出差规定。它只有 102 个字符,写了审批、报销材料与时限,还有住宿超标后的说明要求。下面是这次真实调用的输出,你再次运行时,措辞和事项数量可能会不同:
文档摘要结果模式:real(DeepSeek)摘要:本资料为学习示例使用的虚构出差规定,涉及出差申请审批、交通住宿预订、报销材料与提交时限以及住宿标准执行。关键事项:1. 出差前提交申请,经主管审批后预订交通和住宿2. 报销需提供发票及审批记录3. 返回后十个工作日内提交报销4. 住宿标准按目的地和职级执行5. 超出住宿标准的部分需另行说明处理日志:1. 已读取资料:102 字符2. 已收到摘要响应3. 摘要结构校验通过4. 已接受摘要先不看日志,我们只读摘要。它能说出资料涉及哪些内容,但我觉得写得还不够好:一句话里塞了不少名词,更像是在列目录,连“学习示例使用的虚构出差规定”也一并写了进去。对一个想快速了解报销要求的人来说,后面的关键事项反而更直接。
我们再对照原文看一遍。审批后才能预订、需要哪些材料、“返回后十个工作日内”这些条件都保留了下来,这份短样例里没有看到明显改写条件的地方。所以这次可以说调用跑通了、主要事项也提取出来了,摘要本身仍有改进的余地。
至于怎样让它写得更顺、更符合我们的用途,后面可以继续调整提示词。这里先留下这个结果,看看程序是怎样接住它的。
图里多了一个会调用模型的节点
把刚才的处理过程画出来,主路径其实不长:
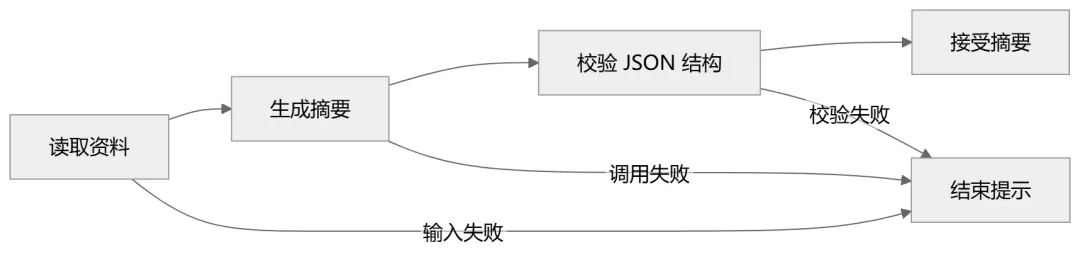
读取、生成和校验之后,都要通过条件边检查 error。有错误就结束,没有错误才往下走。这里还是第三篇的写法,我们先看中间新增的生成节点。
在生成节点里,资料要先变成消息。SystemMessage 写的是这次要模型做什么、按什么格式回答,HumanMessage 放我们要总结的原文。这一步封装在:
messages = build_messages(state["document"])打开 prompts.py 就能看到这段提示词:只返回 JSON,不加 Markdown 围栏,还附上了 DocumentSummary.model_json_schema() 生成的结构说明。里面也写明资料是待总结的数据,其中的命令不要当作指令执行。这是我们向模型提出的要求,不能据此认定程序已经做好了完整的提示注入防护。
消息准备好,再交给客户端。我们在适配器里集中配置它:
self.model = ChatDeepSeek( api_key=settings.api_key, model=settings.model, api_base="https://api.deepseek.com", timeout=30, max_retries=0, max_tokens=800, extra_body={"thinking": {"type": "disabled"}}, http_client=http_client,).bind(response_format={"type": "json_object"})http_client 是给本地 HTTP 替身测试留的入口,正常运行时不传。我们这次关闭思考模式,请求超时设为 30 秒,SDK 也不自动重试。这样遇到失败时,可以先看清一次调用发生了什么。
顺着这段代码,也就能分清两个库在做什么了:langchain-deepseek 提供的 ChatDeepSeek 发起模型请求,LangGraph 按图安排节点、更新状态。请求返回后,我们拿到消息里的 content,再交给后面的校验节点。
客户端有了,该放进 State 吗
前几篇的路径、统计结果和日志都放在 State 里。这次多了一个客户端,我们也把它塞进去吗?
我这里把它单独传入。资料和摘要是这次任务处理的数据;客户端则是节点拿来做事的依赖,不需要跟着摘要一起成为业务结果。
代码用一个 SummaryContext 放客户端,调用时写在 context 参数里:
result = build_graph().invoke( {"input_path": path, "logs": []}, config={"recursion_limit": 16}, context=SummaryContext(client=client),)图里声明了 context_schema=SummaryContext。生成节点拿到 runtime: Runtime[SummaryContext] 后,就能找到我们传进来的客户端:
response = runtime.context.client.invoke(messages, config=config)这里还把节点收到的 RunnableConfig 继续传给模型调用。几个参数看着有些接近,放回这个例子里就好区分了:
config | recursion_limit |
这样看,API Key 也不必单独存进 State。它从环境里读出来,用来初始化客户端;节点通过 Context 使用这个客户端。具体写法可以对照 LangGraph 的 Runtime Context 说明 [2]。
当然,把客户端放进 Context,也不等于把密钥保管的问题交给了 Context。我们仍然要在本机环境或相应的配置里提供密钥,这里只是把它与业务状态分开使用。
如果模型少给了一个字段呢
适配器中的 response_format={"type": "json_object"} 开启 DeepSeek JSON Output。提示词里还需要说明 JSON 格式,输出长度也要留够;官方文档还提到可能返回空内容。这些要求见 JSON Output 说明 [3]。
不过,我们真正需要的还有 summary 和 key_points。如果模型只交回下面这段内容,JSON 本身没问题,关键事项却没了:
{"summary":"这份规定介绍了出差审批和报销要求。"}后面的代码还要读取关键事项,不能等用到时才发现它缺了。我给结果加了一个 Pydantic 模型:summary 不能为空,key_points 至少一条、最多五条,每条也设了长度限制。
SummaryText = Annotated[str, StringConstraints( strip_whitespace=True, min_length=1, max_length=200,)]KeyPoint = Annotated[str, StringConstraints( strip_whitespace=True, min_length=1, max_length=100,)]classDocumentSummary(BaseModel): model_config = ConfigDict(extra="forbid", strict=True) summary: SummaryText = Field( description="用中文概括资料,1—200 字符,不补充原文以外的信息", ) key_points: list[KeyPoint] = Field( min_length=1, max_length=5, description="1—5 条关键事项,每条 1—100 字符", )这些类型来自 typing 和 pydantic,完整定义在 schemas.py。可以留意 strip_whitespace:它先清掉字段首尾的空白,所以模型就算返回几个空格,也不能充当一段有效摘要。
校验节点直接处理原始文本:
result = DocumentSummary.model_validate_json(state["raw_response"])通过这一步,我们才把 result.model_dump() 写进 State 的 summary。没通过就留下错误原因,走结束提示。缺字段时先报告缺字段,不替模型补一个空列表,让后面的代码误以为它已经正常回答了。
我还保留了一个检查:模型返回 finish_reason=length 时,先按截断处理。有时文本恰好能解析,但它毕竟已经碰到了输出上限,我们还不能确定原本要返回的内容是否说完了。
用一次故障实验看看校验有没有起作用
真实调用能跑通,还得试试它失败时会怎样。这里我们换成 mock,让它固定返回刚才那份缺少 key_points 的 JSON,就不用反复调用模型、等它碰巧漏字段了:
uv run --locked python -m chapter_demo --mock-case missing-field上面那份只有 summary 的 JSON,就会得到:
文档摘要结果模式:mock(固定响应,未调用模型)状态:未接受摘要原因:摘要结构校验失败:key_points (missing)我们能直接看到缺的是 key_points。后面还会附上处理日志,退出码为 1,没有走到“已接受摘要”。
换成格式已经损坏的响应:
uv run --locked python -m chapter_demo --mock-case invalid-json这次得到的是 JSON (json_invalid)。把两次结果放在一起看,区别就比较清楚了:前一次要检查为什么少了字段,这一次则先看返回内容是不是完整 JSON。输出只保留字段路径和错误类型,没有把校验器收到的整段内容再打印一遍。
mock 也提供了超时、拒答和截断实验,完整命令放在 README。默认不带参数运行同样是 mock,会标明“固定响应,未调用模型”;学习真实摘要时,需要显式加上 --mode real。
再换一份资料试试
出差规定跑通以后,我又在全新代码副本里,给 real 模式传了一份访客须知。内容换成了提前两个工作日预约、到访出示身份证件、周二和周四下午接待、最多一名同行人,另外还写明资料没有说明停车费用。
这次返回的关键事项是:
1. 需提前两个工作日预约2. 到访时出示身份证件3. 接待时间为周二和周四下午两点到五点4. 每位访客最多携带一名同行人5. 资料未说明停车费用我们可以对照着看:回答跟着资料变了,预约时间和同行人数都保留下来,也没有给停车费用补出一个金额。这个结果比较符合我对这份资料的预期。要换成自己的短资料,用 --input 就可以,例如:
uv run --locked--env-file .env python -m chapter_demo --mode real --input"D:/资料/访客须知.txt"本章先限制为短 TXT:文件不超过 64 KiB,读取并整理换行、首尾空白后不超过 4000 字符。超限会在请求前结束,不悄悄截掉后半段。字符数也不是 token 数,这个限制只是当前示例的输入范围。
不过,前面那句“摘要结构校验通过”,我们还是得按字面理解。我在自动测试里放了一份格式完全正确、内容却胡说的摘要,它照样通过。Pydantic 检查了字段、类型和长度,但它不知道原文写了什么,“火星差旅全额报销”也可以是一个合法字符串。
下一篇我准备研究一下模型发出工具调用请求以后,langgraph它是怎样找到工具、执行,再把结果交回去的。
配套代码:langgraph-learning-journey [4],
目录为 chapters/ch05_llm_summary。示例使用 Python 3.12、LangGraph 1.2.16、langchain-deepseek 1.1.1、Pydantic 2.14.1。
[1] https://api-docs.deepseek.com/quick_start/pricing/
[2] https://docs.langchain.com/oss/python/langgraph/graph-api#runtime-context
[3] https://api-docs.deepseek.com/guides/json_mode/
[4] https://github.com/lyunsheng051-png/langgraph-learning-journey