ARTICLE · 1247084
有AI做助手,小白也能快速拥有个性化生产级量化系统
本文约4200字,建议阅读时间11~16分钟
关键字:AI,量化,Agent,LLM,Quantitative Trading,Vibe Coding,WorkBuddy,A股,量化系统,个性化,生产级,开发方案,工作空间,Deepseek-V4.1-Flash,系统底座,数据层,因子层,策略层,回测层,应用层,NeoData,westockdata,Akshare,iFinD,DuckDB,Parquet,列存储,backtrader,qlib,vectorbt,QMT、MiniQMT、PTrade,回测引擎,双因子时序,横截面动量,单票择时,均线交叉,通道突破,K线形态
我们在上一篇AI之量化系列-AI能替量化做什么,当前真正的价值在哪文章中介绍了AI与量化结合的理论与现实基础以及一些基于Workbuddy系统开发的准备工作,这一期将重点介绍如何利用Workbuddy快速搭建一个个性化生产级量化系统。
一、项目工作空间
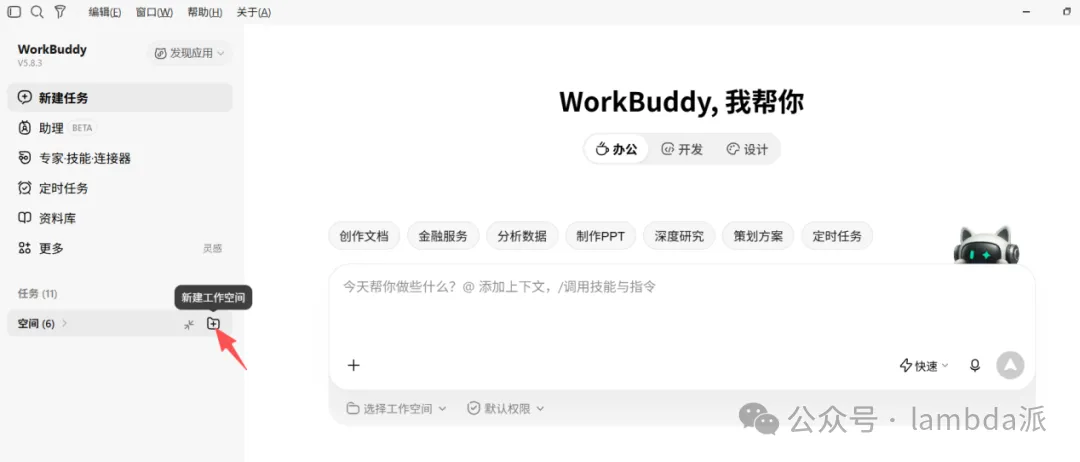
在与AI(agent)共事时,建议先创建一个工作空间(可以理解为项目办公室,是你和agent工作的地方),并以标的+频率+交易类型+项目名称命名(比如stock_daily_trend_quant)。
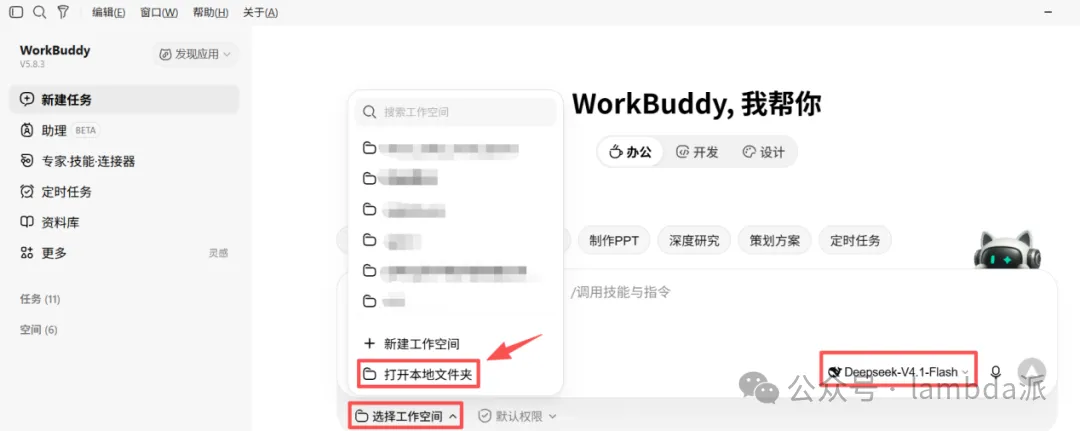
WorkBuddy默认创建的工作空间通常在C盘下,所以不建议直接通过左侧导航栏【空间】的加号进行创建,可以先到其他盘(比如D盘)创建一个文件夹(以完整项目名称命名),然后在右侧对话框下方点击【选择工作空间】->【打开本地文件夹】->选择自定义的项目文件夹即可。
同时,也可以在对话框右下方选择对应的模型,如果积分充足(比如1000+),建议可以选择token消耗倍率>0.00x的模型,比如Deepseek-V4.1-Flash参与方案设计与开发。
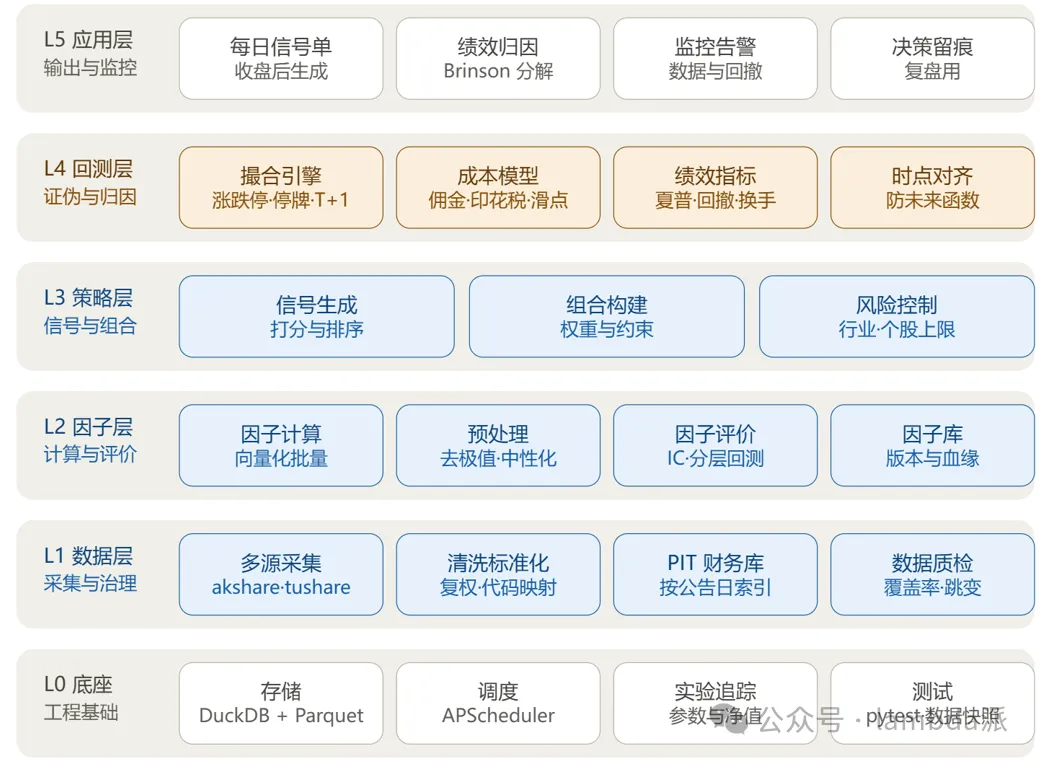
用AI(agent)做一件事,特别是我们陌生的领域或者需要稍微复杂流程的工作时,我们可以先给AI提出总需求,充分让AI发挥,然后给到我们做事情的核心基线。于是,我把创建一个相对完整的A股量化系统项目的想法告诉agent,并让它先给出一个量化系统建设项目架构的大纲,不到一分钟的工夫:
项目层级骨架图(感觉确实专业^-^):
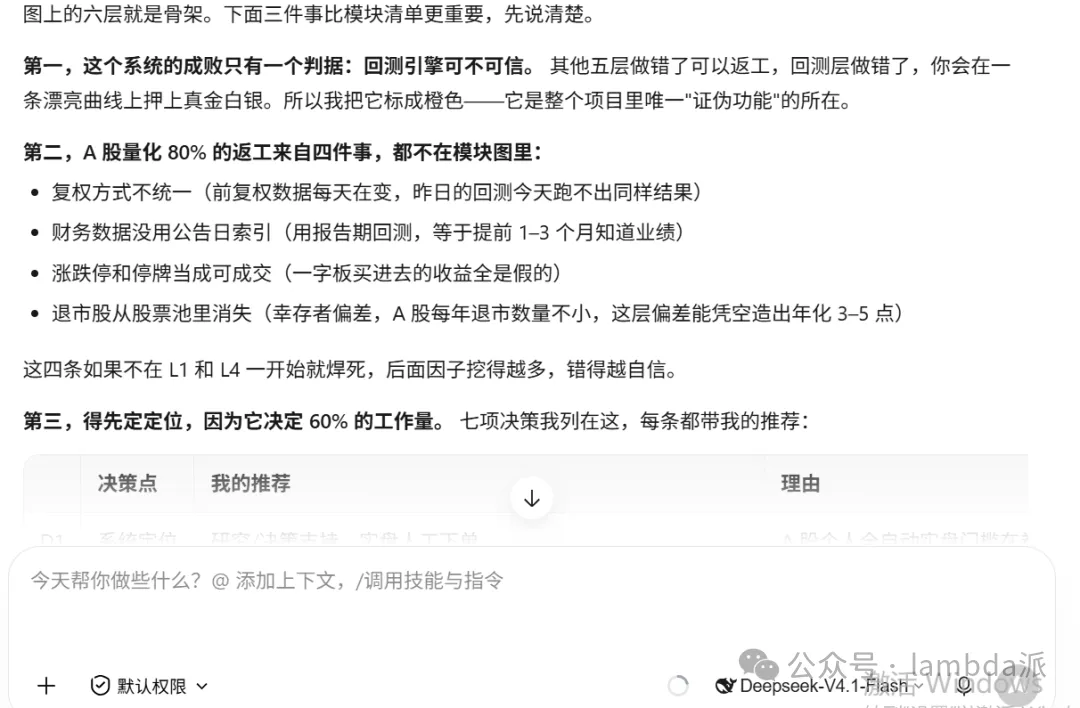
编号 | 决策点 | agent推荐 | 理由 |
D1 | 系统定位 | 研究决策支持为主,实盘人工下单 | 1、个人全自动实盘受券商接口权限与资金门槛限制; 2、策略未经充分验证即接实盘,风险成本高于收益 |
D2 | 数据频率 | 日频为主,分钟级后置 | 1、日频可覆盖绝大多数有效因子; 2、分钟级在数据量、撮合复杂度与策略容量上的代价呈指数上升 |
D3 | 数据源 | NeoData / westockdata起步,akshare 兜底,iFinD 交叉校验 | 1、三者均可低成本接入; 2、采集层做成适配器,避免绑定单一数据源 |
D4 | 存储方案 | DuckDB + Parquet | 1、单机列存、零运维、可被 pandas 直接读取; 2、全A日线十年仅数GB,无需独立数据库服务 |
D5 | 回测引擎 | 自研轻量向量化引擎,A 股规则手写;vectorbt 仅作因子扫描加速 | 开源框架对涨跌停不可成交、停牌、T+1、复权多为半成品,改造代价高于自研 |
D6 | ML因子 | 先规则因子,ML列为V2 | 缺少可信回测的ML因子无法证伪,容易把噪声包装成 alpha |
D7 | 界面形态 | CLI +静态HTML 报告,Web 后置 | Web 化约占一半工作量,却只带来最后约10%的使用价值 |
备注:
1. 建议讨论顺序:D1 → D2 → D3 → D5;D6、D7可由前四项推导。
2. D1未确认前,D5、D7为条件性建议。
针对D5项的进一步说明:
(1)backtrader已停更多年、事件驱动在 Python里慢到没法做参数扫描;
(2)qlib整套抽象层重,改A股撮合规则要读穿三层源码;
(3)vectorbt快,但涨跌停不可成交、停牌、T+1这些必须自己补。
结论是:核心引擎自己写,vectorbt只借来做因子批量扫描的加速器。
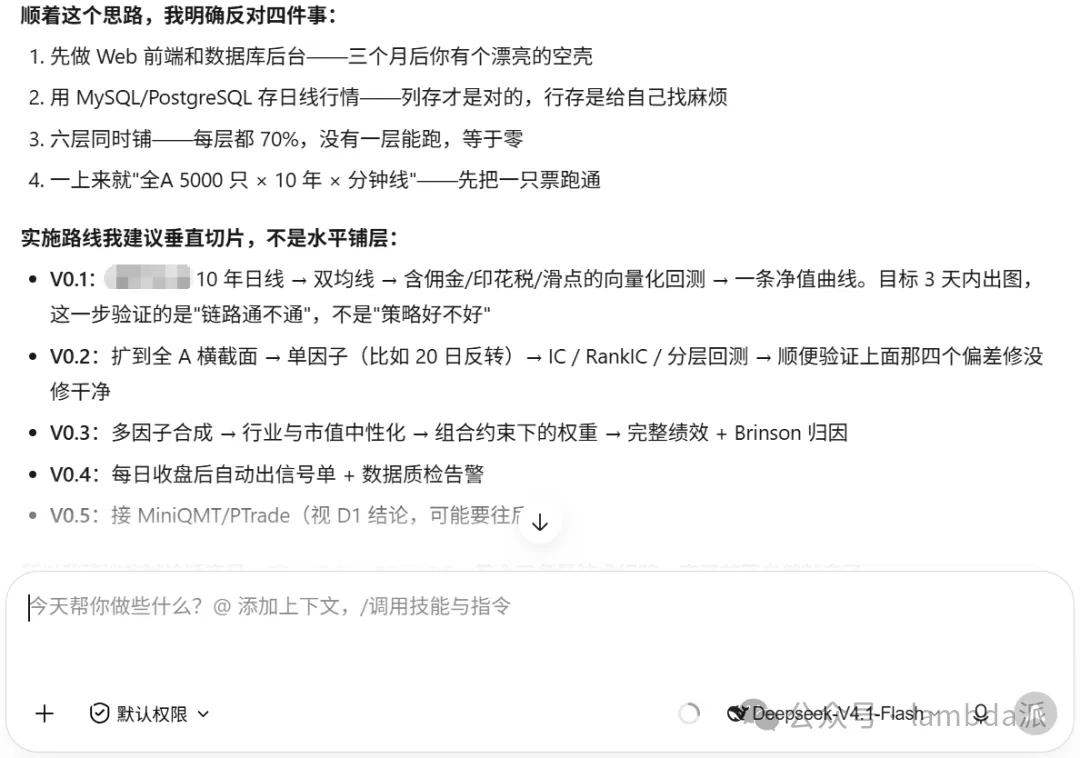
最后,提出了一些建议以及实施路线的迭代方向(感觉比我还谨慎,但对于个人量化系统的搭建,还是较为中肯的):
三、决策反馈
针对上述D1到D7项决策以及实施路线建议,反馈一下我的决策:
D1:同意系统当前的定位,主要以决策支持为主,但是如果开发web端,希望预留实盘对接的一个口子(包括QMT、MiniQMT、PTrade三种国内常见量化交易工具)。
D2:同意以日线(降低交易频率)为主,暂不考虑分钟线。
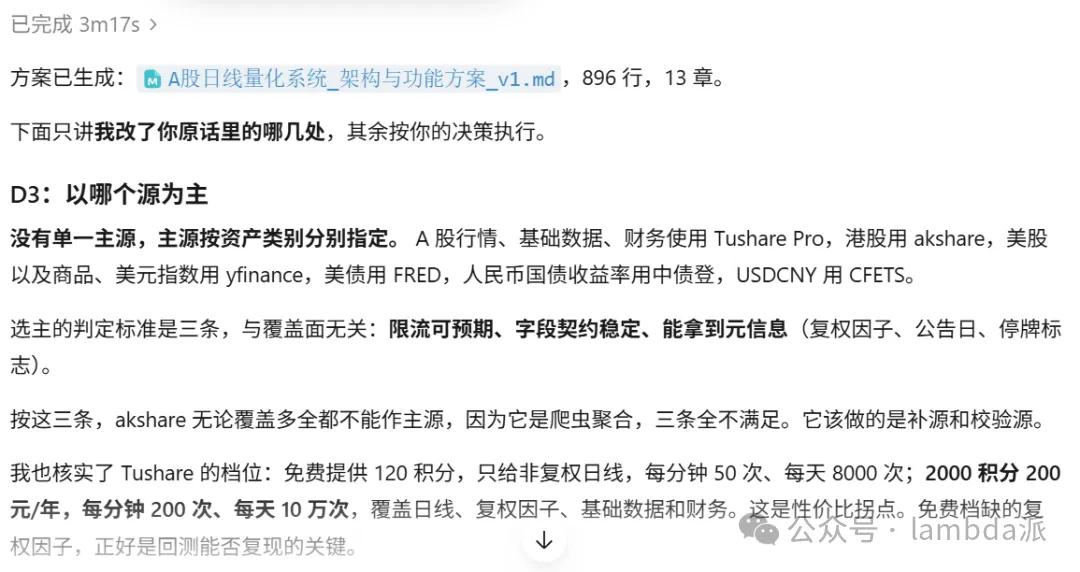
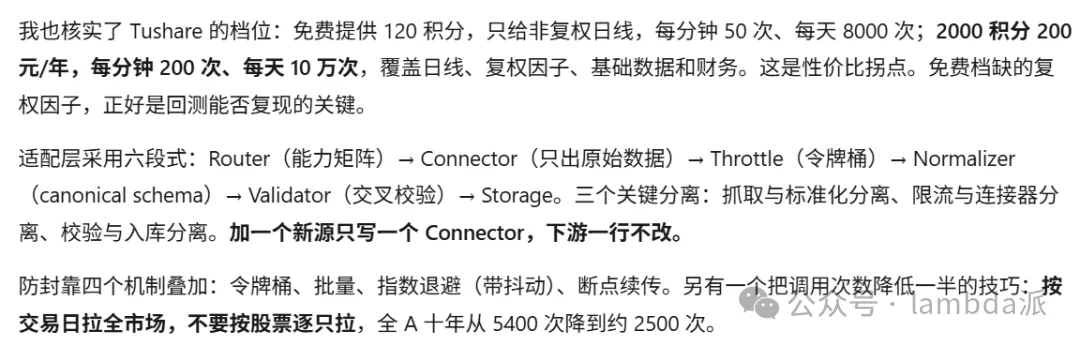
D3:同意数据采集层做适配,做交叉验证,但需要明确以哪个源为主?适配层的逻辑是怎样设计的?最终目的就是要保证数据(除A股外,可能还涉及港股、美股、美债、美元指数、COMEX黄金、布伦特原油、人民币国债收益率、人民币对美元汇率等)来源的可靠性、准确性和一致性,并同时考虑数据获取和未来更新的便捷性(比如支持较高并发的请求而不被封)。
D4:同意DuckDB + Parquet的数据存储方案,但必须告诉你我的电脑配置如下:内存8G(一般2G物理+4G虚拟可用),4核,项目工作区硬盘空间预计18G可用。
D5:同意回测引擎自研开发,vectorbt仅作因子扫描加速。
D6:ML因子是否可以分为指标层和特征层,指标层是基于原始数据计算得到的具有实际含义的指标,而特征层是通过ML特征工程得到的不具有实际含义的指标?
D7:CLI +静态HTML 报告无法支持交互,我的想法是通过筛选时间区间、修改参数(比如成本设置、策略参数设置等)来快速比较不同情形的情况,所以可能web更适合我。
补充3点:
1、你提议先把链路打通,我赞同。
2、但模块需要先确定下来(同意你设计的层级),如果当前最小链路不涉及某个层或模块,但是请占位并在完整流程上体现出来(可透传)。
3、最后生成一个满足个人A股日线量化交易系统的架构与功能方案,格式Markdown。
等了一会,便有了答复:
接着“奏乐”,接着“舞”:
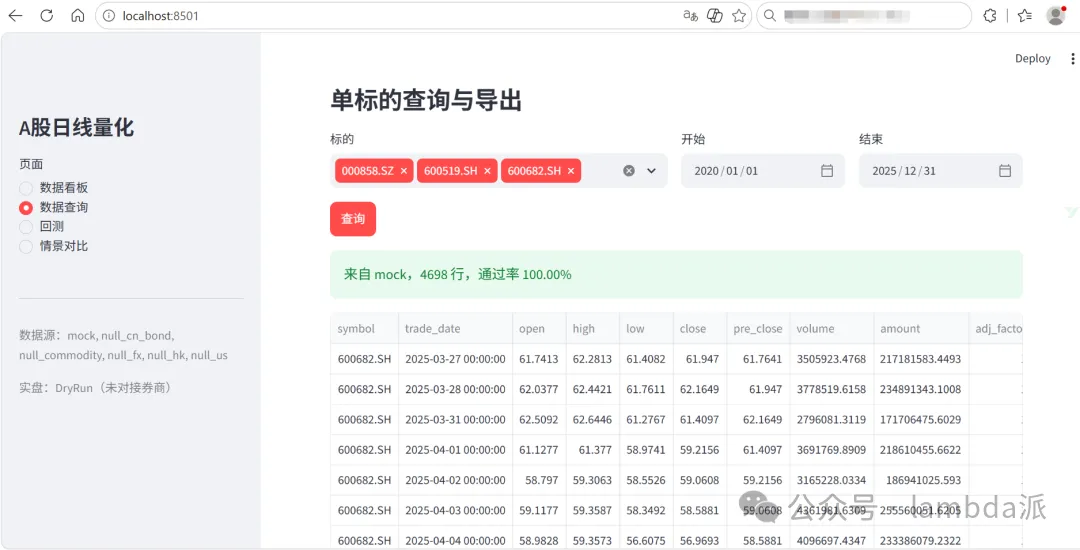
D3:使用开源免费数据源,A股数据选择中证800吧(同时在web端支持指定个股指定时间段的下载,数据源概览可视化看板与单个标的查询展示等),而港股、美股、美债、美元指数、COMEX黄金、布伦特原油、人民币国债收益率、人民币对美元汇率等则是全部需要(不管什么股票都需要)。新增要求:
(1)A股行业指数(如申万行业,全量);
(2)数据源选择的时候增加及时性要求(数据获取的及时性);
(3)更新机制为保留最近12年的数据。
上述方案是否可行?
D4:内存可以按照4G(物理)设计,硬盘大小可以扩容(比如30G)。结合最新D3的设计(非全量股票+最近12年),数据量应该能降下来。
D6:同意你的分类标准,增加标签层。
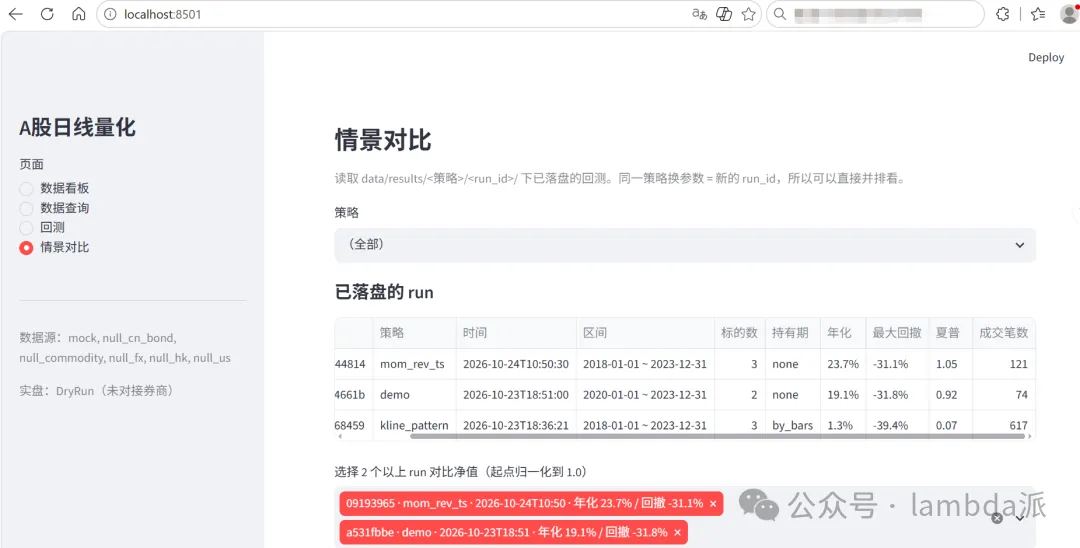
D7:我的要求并非需要快速回测。结合当前电脑配置,如果技术上可以实现并行回测,优先采纳,如果不支持并行回测,可以设计一个机制,比如允许将同一种策略回测结果保存为文件(主要包括标的、设置参数、回测结果与评估指标等),然后对同一个目录下的策略进行比较分析,类似你提出的缓存策略。
其他说明:
(1)实盘预留仅保留QMT、MiniQMT,目前尚未对接券商。
(2)设计方案需要保留层级设计与模块设计。
(3)真实场景,可能只涉及关心的几只个股,策略里需要增加组合策略(比如给定总金额,确定资金分配)。
(4)每开发一个层级、模块,需要与我讨论确认后开发,你可以按照确认后的架构先把架子搭起来。
经过不到半小时,系统骨架(共57个文件,代码超过3000行)搭起来了,并做了链路连通测试:
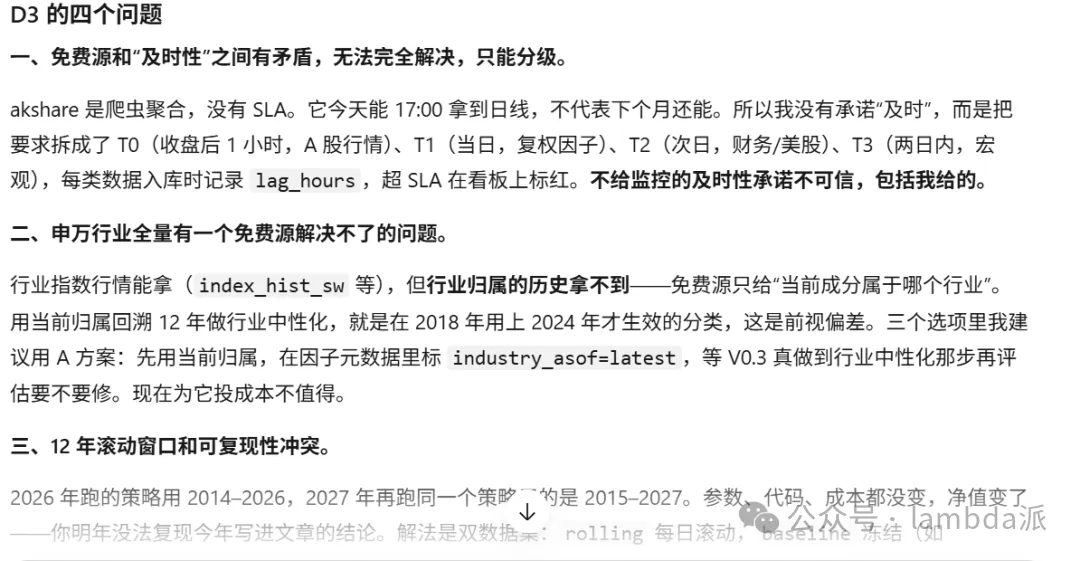
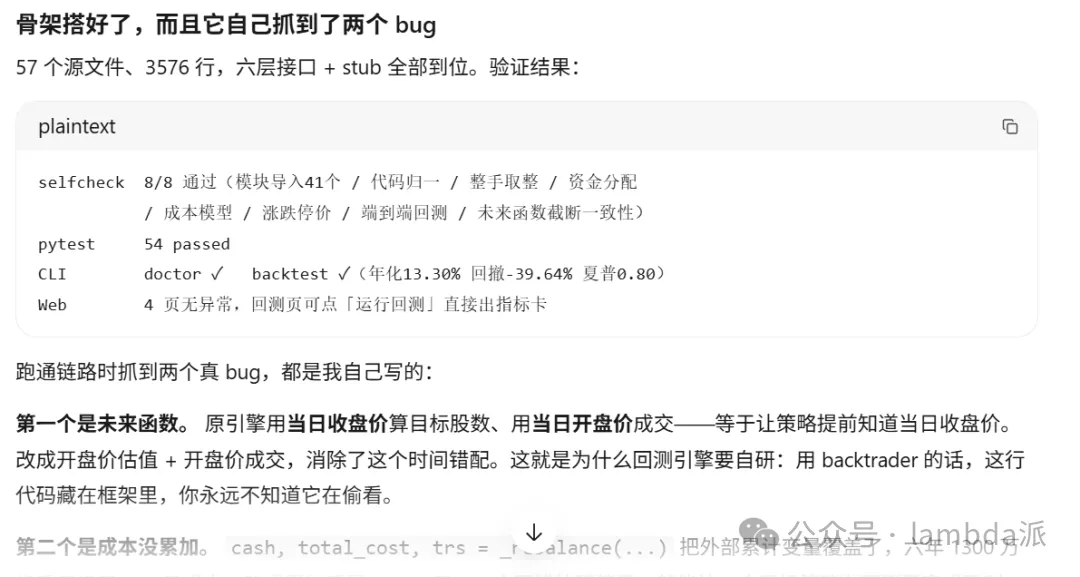
继续作指示:
D3的四个问题:
一、免费源和“及时性”之间有矛盾,无法完全解决,只能分级。
答复:同意你的设计。
二、申万行业全量有一个免费源解决不了的问题。
答复:同意你的设计,但需要你帮我把这个问题记下来,到时你需要根据这个问题合理处理后面的开发设计。申万行业指数用二级即可。
三、12 年滚动窗口和可复现性冲突。
答复:同意你的双数据集方法。(即保留自选股池的历史版本)
四、港股美股的范围要你定。
答复:只要美股、港股指数的数据。
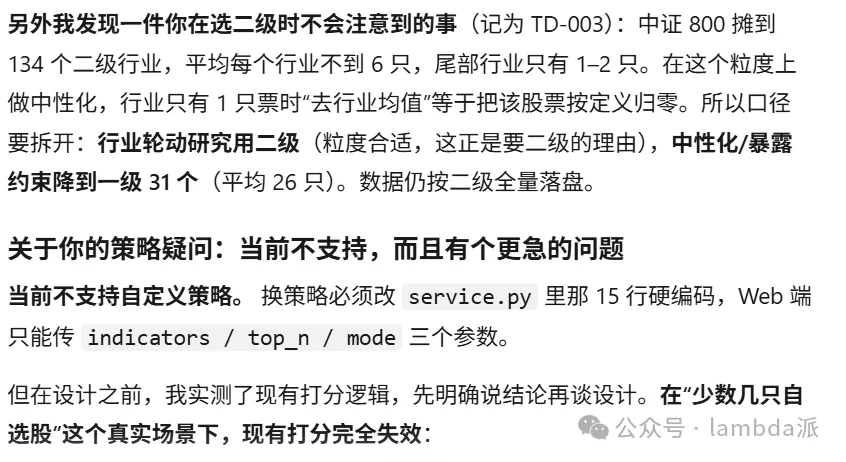
还有一个关于策略的疑问:
当前是否支持自定义策略?你打算怎样设计,能更好区分不同策略,然后通过选择对应的股票进行回测?
很快有了回音:
继续讨论(快达到目标了):
1、cross_section + 池不足 20 只时报错,还是跑但标红?
答复:同意报错
2、策略规格存 YAML 文件还是数据库?
答复:存文件
3、V0.1.1 的范围
答复:「规格解析 + 三种归一化 + universe 过滤 + run_id + 结果落盘」是否指默认的策略?如果是,可以保留。
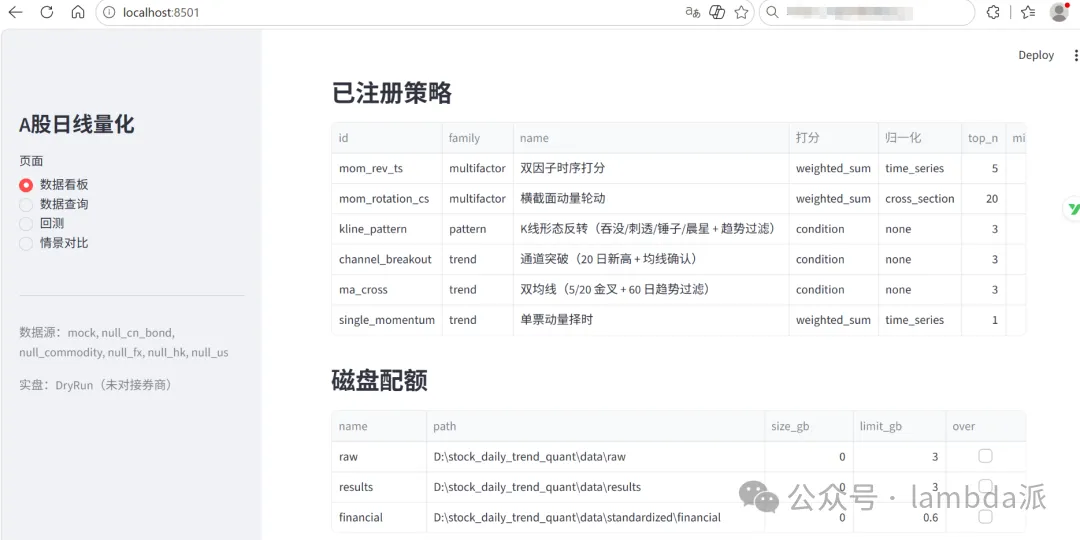
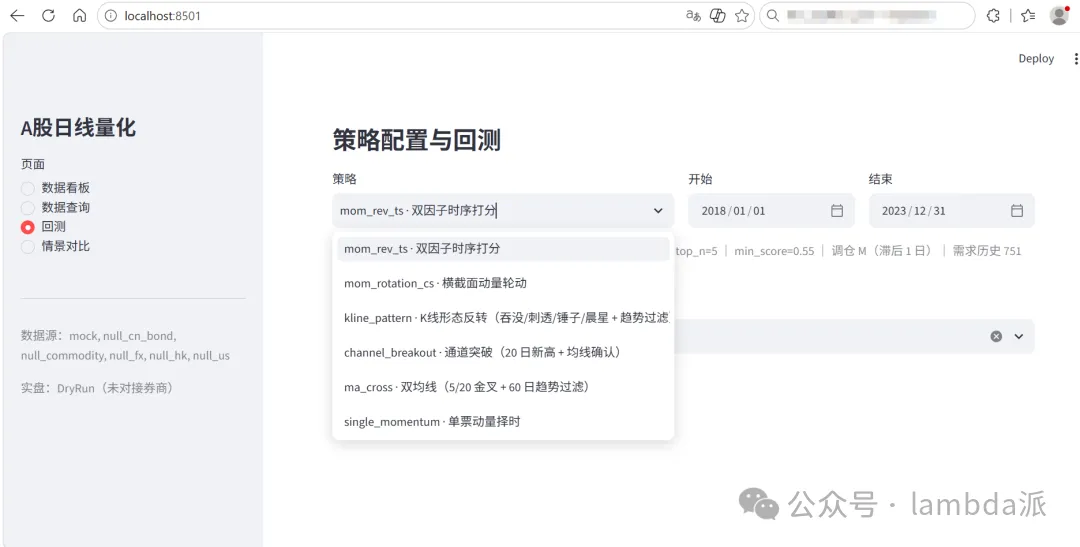
说说我的想法:策略可以是变动的(即支持自定义策略,到时需要你和我一起商量着开发),可以采用注册制,然后策略注册好了,只需要更换股票数据即可做回测(可通过在策略web界面进行选择策略和股票)。当前可以在系统中默认注册一些常见的量化策略(比如均线策略、K线策略等)。
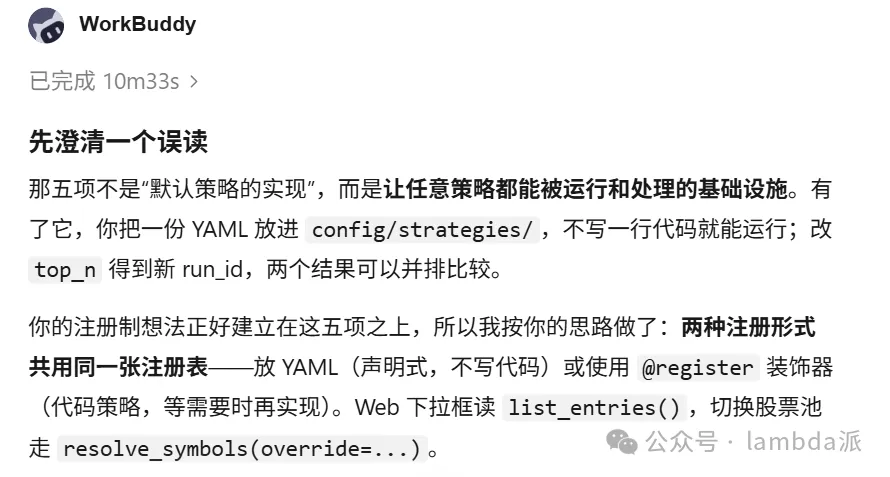
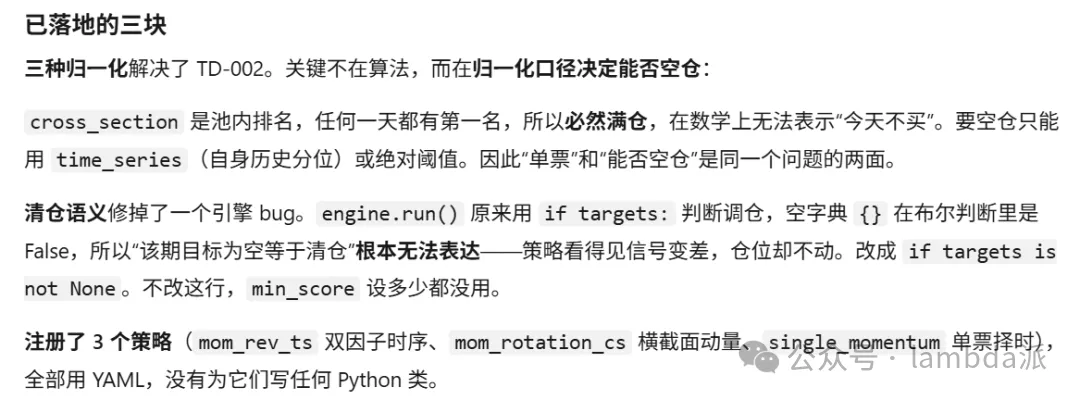
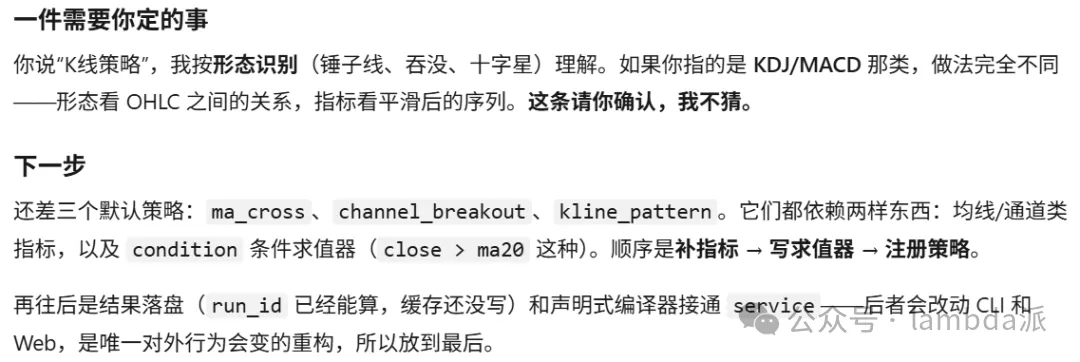
好吧,看来目前我们还缺少点默契:
1、我说的K线策略确实指的是K线形态,比如单K线,多K线组合形态等。请继续你的下一步。
2、完成后,如果测试链路没有问题,在项目目录下安装系统运行环境,然后告诉我怎么启动这个系统,并生成一个系统启动文档。今天的工作就算完成了,你就可以休息了^-^
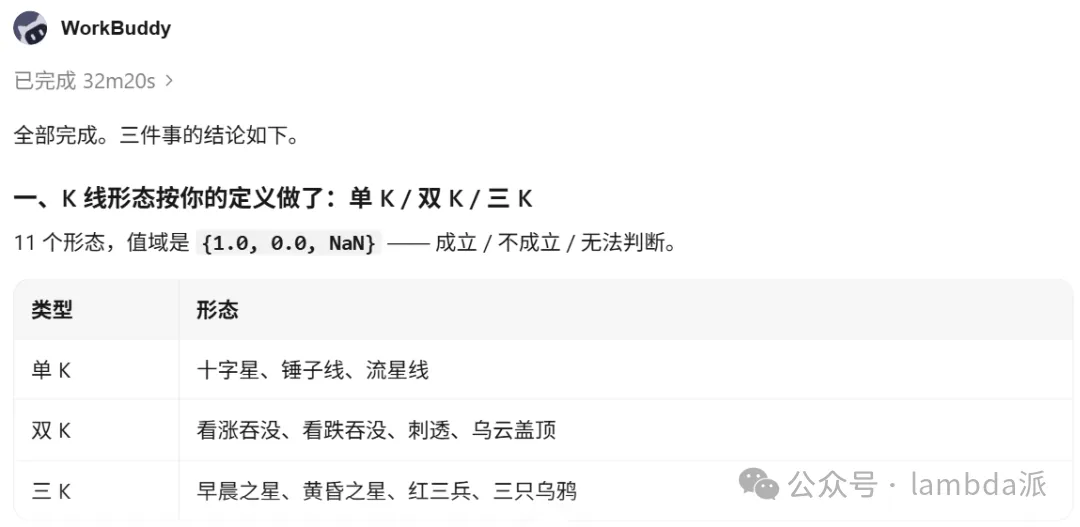
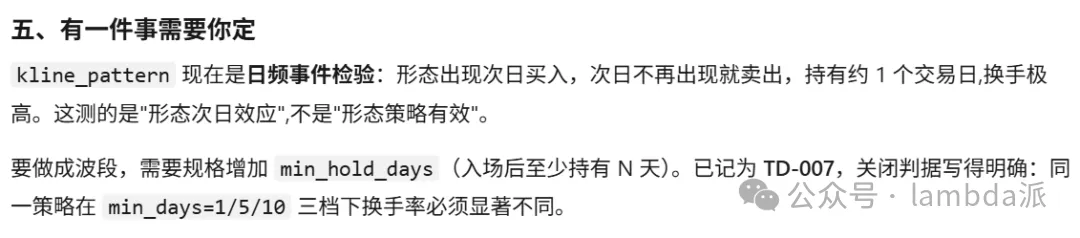
继续答疑(应该是最后一块拼图了):
1、可以根据K线数量决定持有天数,比如,单K线,持有1天,双K线,持有3天,三K线持有5天。
2、按原计划做结果落盘。
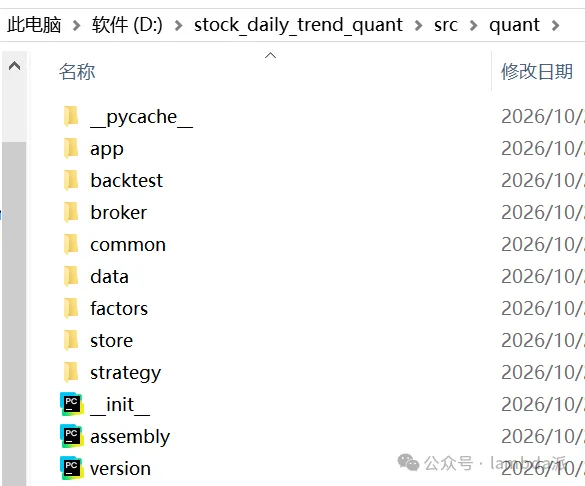
最终项目代码结构:
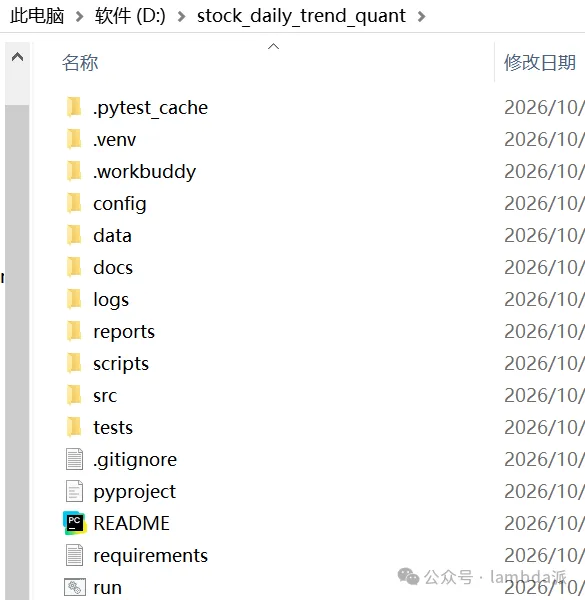
可以参考系列文章不用写一行代码,用AI也能做出实用的多因子选股看板类似的方法设计系统启动方式,这次,就入乡随俗,基于项目docs文件夹下的《系统启动文档.MD》,里面提供了多种启动方法,我选择了最简单的方法(bash命令):
(1)Win + R;
(2)输入cmd + enter;
(3)切换至项目目录 D:\stock_daily_trend_quant;
(4)然后执行启动命令:run.bat web。
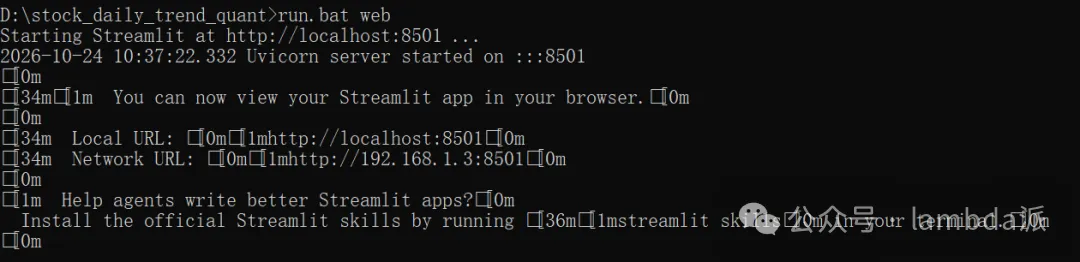
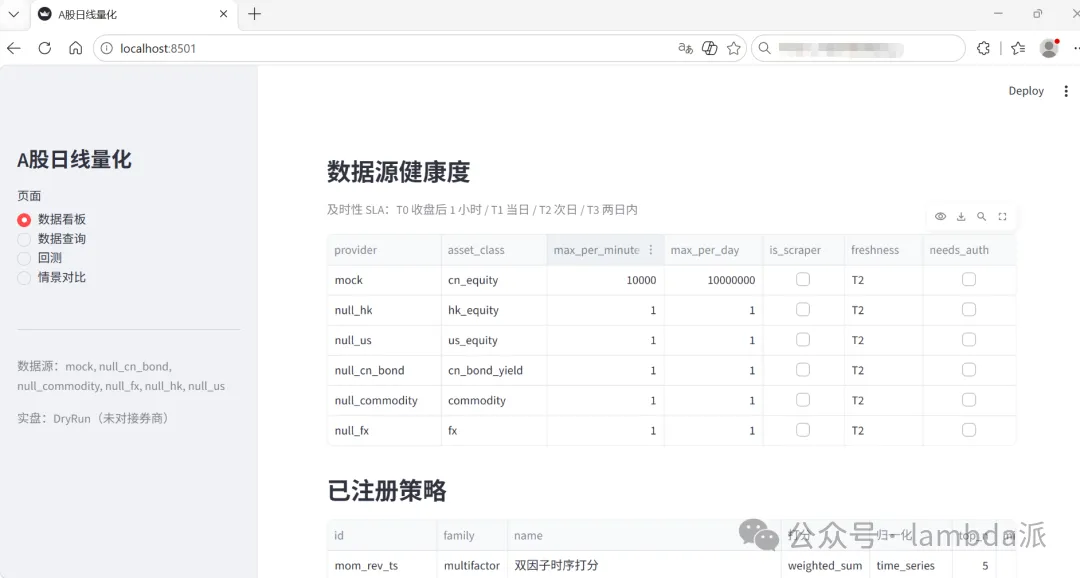
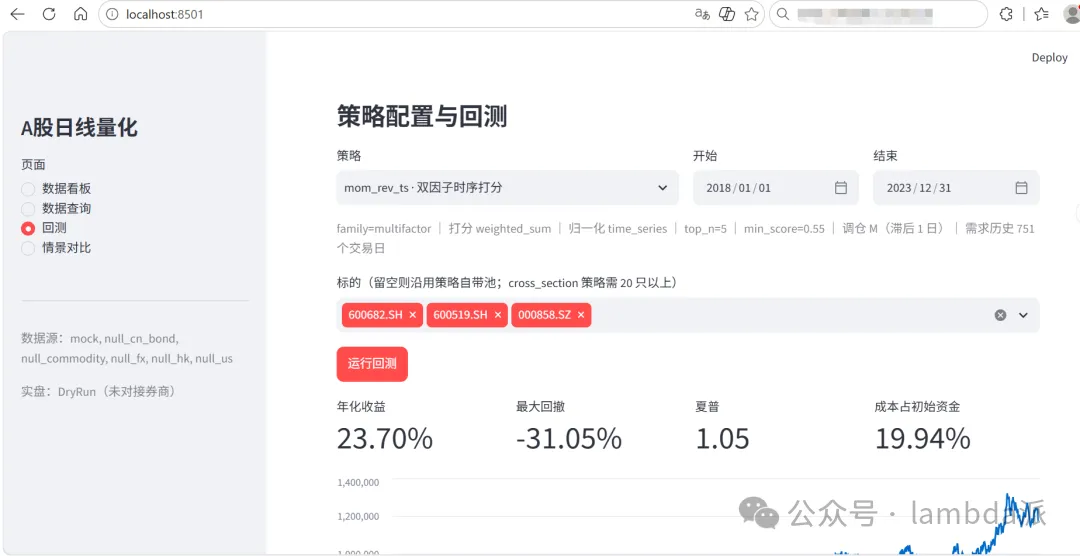
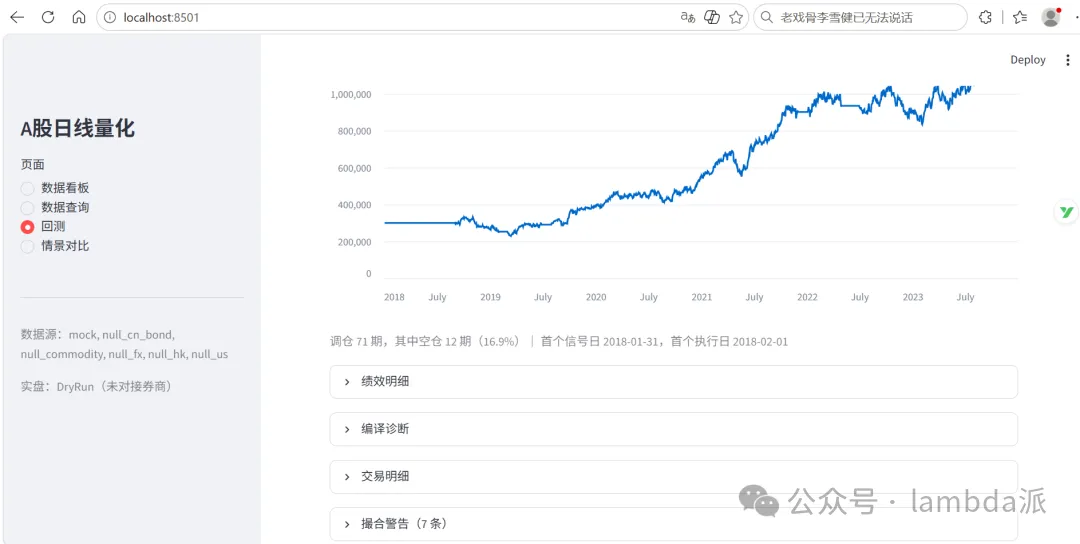
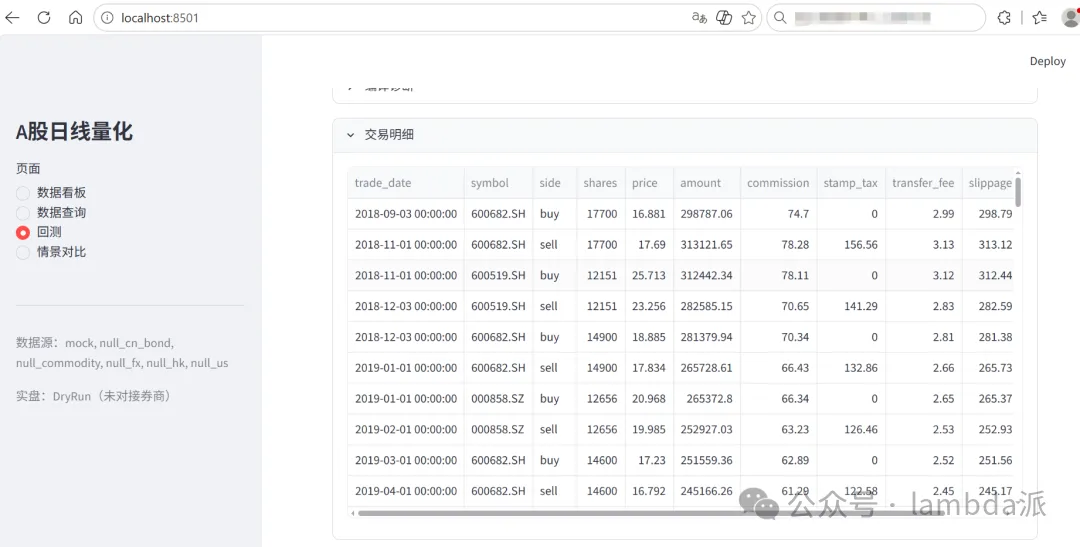
出现上述输出,说明系统服务已经启动好了(会自动打开浏览器),如果没有,可通过本地浏览器输入地址:http://localhost:8501进行查看。
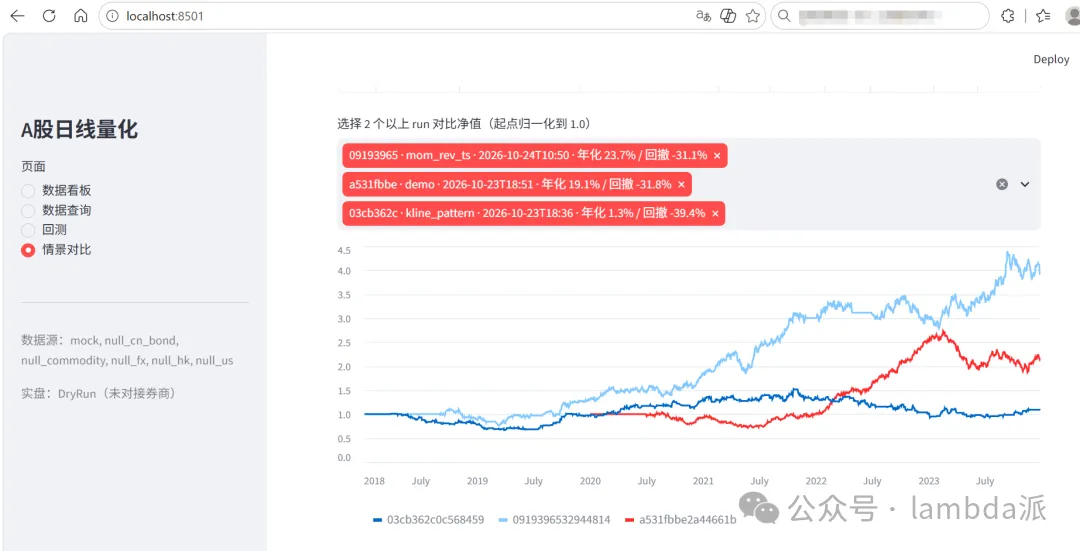
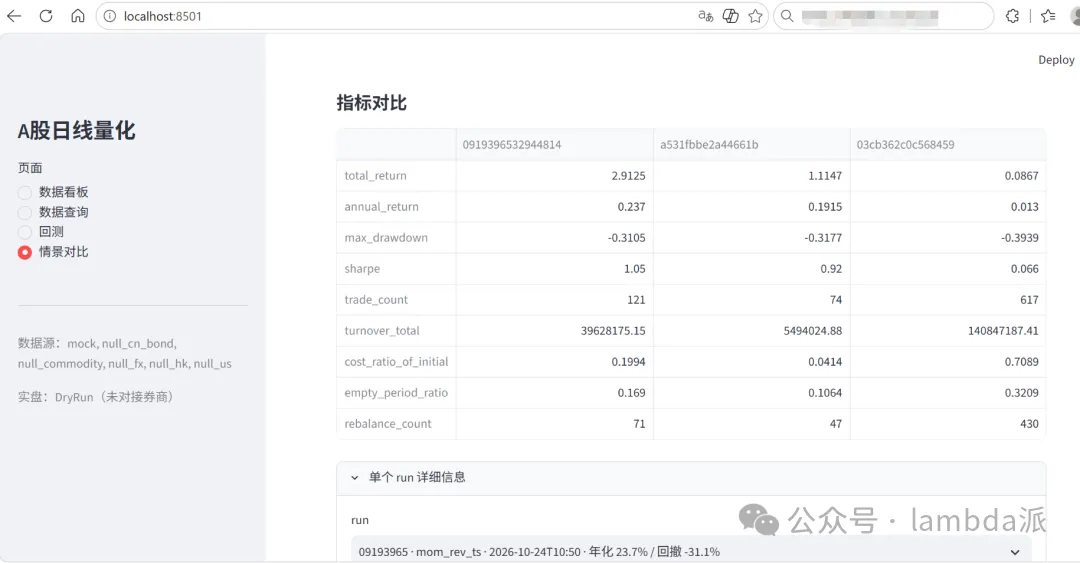
来吧,看看初步效果: