ARTICLE · 1249617
一行行读透 Transformer 源码:Decoder-Only 经典实现完全拆解
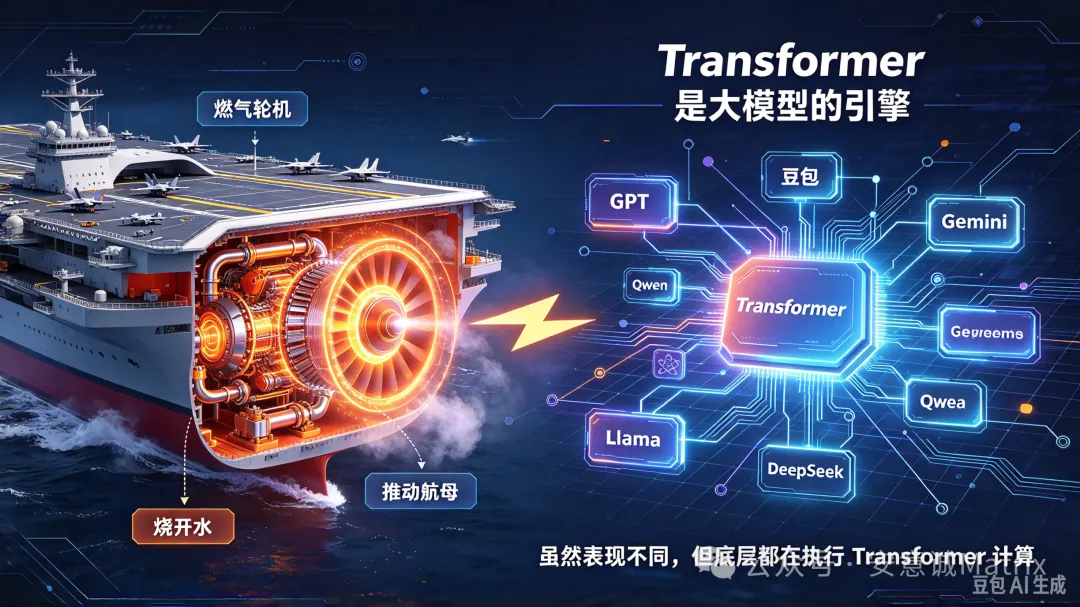
Transformer 从 2017 年论文发表到现在,已经快十年了。这十年里大模型百花齐放,架构层出不穷——有 MoE、有 MQA/GQA、有 RoPE、有 RMSNorm、有 SwiGLU……但剥开所有优化和魔改的外衣,最核心的骨架从来没变过。
很多人觉得 Transformer 高深莫测,其实核心代码量并不大。今天我们就用一份最经典、最干净的 Decoder-Only 结构(也就是 GPT 系列沿用至今的架构)源码,从头拆到尾,把每一个模块的作用、原理、代码实现一次性讲透。只要你有基础的 PyTorch 编程背景,就能完全看懂。
整体架构先览
一个标准的 Decoder-Only Transformer,从上到下其实就六大件:
| Token Embedding | |
| Positional Encoding | |
| Multi-Head Attention | |
| Feed Forward Network | |
| Decoder Layer | |
| LM Head |
下面我们顺着代码,从底往上逐个拆解。
一、位置编码:让模型知道"谁在前谁在后"
classPositionalEncoding(nn.Module):def__init__(self, d_model: int, max_len: int = 5000, dropout: float = 0.1): super().__init__() self.dropout = nn.Dropout(p=dropout) position = torch.arange(max_len).unsqueeze(1) div_term = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model)) pe = torch.zeros(max_len, d_model) pe[:, 0::2] = torch.sin(position * div_term) pe[:, 1::2] = torch.cos(position * div_term) pe = pe.unsqueeze(0) self.register_buffer('pe', pe)defforward(self, x: torch.Tensor) -> torch.Tensor: seq_len = x.size(1) x = x + self.pe[:, :seq_len, :]return self.dropout(x)讲明白这几点:
为什么需要它?注意力运算本身是"无序"的——你把句子里的词打乱顺序,注意力计算结果是一样的。但语言是有顺序的,"我打他"和"他打我"意思完全不同。位置编码就是给每个位置的向量打上独一无二的"位置烙印",直接加在词向量上。
正弦编码的巧妙之处:用 sin 和 cos 函数生成位置编码,不是随便选的。它有个非常好的性质:任意位置 k 的编码,可以由位置 0 的编码线性变换得到,这让模型能自然地学习到相对位置关系。
实现细节
偶数维度用 sin,奇数维度用 cos 不同维度有不同的频率,低频对应全局位置,高频对应局部位置 用 register_buffer注册,说明它不是参数,不需要梯度更新
注:现在的大模型大多改用 RoPE(旋转位置编码),但核心思想一致:给向量注入位置信息。正弦编码是最经典的入门版本。
二、缩放点积注意力 + 因果掩码:Decoder 的灵魂
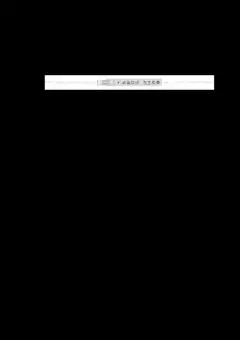
defscaled_dot_product_attention( q: torch.Tensor, k: torch.Tensor, v: torch.Tensor, mask: torch.Tensor = None) -> tuple[torch.Tensor, torch.Tensor]: d_k = q.size(-1) scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(d_k)if mask isnotNone: scores = scores.masked_fill(mask == 0, -1e9) attn_weights = F.softmax(scores, dim=-1) output = torch.matmul(attn_weights, v)return output, attn_weights这就是 Transformer 最核心的公式:
逐行解释:
Q、K、V 是什么?可以通俗理解为:Q 是"我在找什么",K 是"我有什么",V 是"我的内容是什么"。每个词都会产出这三个向量。
为什么要除以 √d_k?这就是"缩放"的意义。当维度 d_k 很大时,Q 和 K 的点积结果会非常大,把 softmax 函数推到梯度几乎为 0 的饱和区。除以 √d_k 把方差拉回 1,保证训练稳定。
因果掩码:Decoder Only 的核心这是生成式模型最关键的设计:每个词只能看到自己和它之前的词,绝对不能看到未来的词。
实现方式就是一个下三角矩阵
mask,把未来位置的分数设为负无穷,softmax 之后概率就变成 0,相当于"看不见"。
三、多头注意力:让模型同时"关注不同角度"
classMultiHeadAttention(nn.Module):def__init__(self, d_model: int, n_heads: int, dropout: float = 0.1): super().__init__() self.d_k = d_model // n_heads self.w_q = nn.Linear(d_model, d_model) self.w_k = nn.Linear(d_model, d_model) self.w_v = nn.Linear(d_model, d_model) self.w_o = nn.Linear(d_model, d_model) self.dropout = nn.Dropout(dropout)defforward(self, x: torch.Tensor, mask: torch.Tensor = None): batch_size = x.size(0) q = self.w_q(x).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2) k = self.w_k(x).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2) v = self.w_v(x).view(batch_size, -1, self.n_heads, self.d_k).transpose(1, 2) attn_output, attn_weights = scaled_dot_product_attention(q, k, v, mask) attn_output = attn_output.transpose(1, 2).contiguous().view(batch_size, -1, self.d_model) output = self.w_o(attn_output)return output, attn_weights为什么要"多头"?
单头注意力只能做一种"关联模式"。多头就像同时有好几副眼镜:
有的头关注语法关系(主语-谓语) 有的头关注指代关系(它指的是谁) 有的头关注远距离依赖
每个头在不同的子空间里独立计算注意力,最后把结果拼起来。这样模型的表达能力大大增强。
代码关键步骤:
输入 x 通过三个线性层分别投影出 Q、K、V 把 QKV 沿通道维度拆成 n_heads 份 每一份独立做缩放点积注意力 把所有头的结果拼接回来 再过一个输出投影层 w_o
四、前馈网络:每个位置独立"思考"
classFeedForward(nn.Module):def__init__(self, d_model: int, d_ff: int, dropout: float = 0.1): super().__init__() self.fc1 = nn.Linear(d_model, d_ff) self.fc2 = nn.Linear(d_ff, d_model) self.activation = nn.GELU() self.dropout = nn.Dropout(dropout)defforward(self, x: torch.Tensor) -> torch.Tensor:return self.fc2(self.dropout(self.activation(self.fc1(x))))这个模块很直白:
先升维(d_model → d_ff,通常是 4 倍) 过一个非线性激活函数(GELU 是 GPT 标准,比 ReLU 平滑) 再降维回原来的尺寸
注意力负责"在词与词之间交换信息",前馈网络负责"在每个位置内部加工信息"。 两者一外一内,构成了 Transformer 层的完整计算。
五、Decoder 层:打包成一个可堆叠的单元
classDecoderLayer(nn.Module):def__init__(self, d_model: int, n_heads: int, d_ff: int, dropout: float = 0.1): super().__init__() self.self_attn = MultiHeadAttention(d_model, n_heads, dropout) self.ffn = FeedForward(d_model, d_ff, dropout) self.norm1 = nn.LayerNorm(d_model) self.norm2 = nn.LayerNorm(d_model) self.dropout = nn.Dropout(dropout)defforward(self, x: torch.Tensor, mask: torch.Tensor = None): attn_out, _ = self.self_attn(self.norm1(x), mask) x = x + self.dropout(attn_out) ffn_out = self.ffn(self.norm2(x)) x = x + self.dropout(ffn_out)return x这里有两个非常重要的设计:
1. Pre-LayerNorm(前置归一化)
注意看:先做 LayerNorm,再过注意力/前馈网络。这叫 Pre-LN 结构。
原始 Transformer 论文用的是 Post-LN(先运算再归一化),但实际训练中 Pre-LN 稳定得多,不需要复杂的学习率预热。现在几乎所有大模型(GPT、Llama、Qwen 等)全都是 Pre-LN。
2. 残差连接(Residual Connection)
x = x + dropout(...) 就是残差。输入直接抄近路加到输出上,梯度可以直接回传,解决了深层网络退化的问题。Transformer 能堆几十上百层,全靠残差连接。
一个 Decoder Layer = 注意力子层 + 前馈子层,每个子层都遵循「归一化 → 运算 → dropout → 残差相加」的模式。
六、完整模型:把所有模块串起来
classDecoderOnlyTransformer(nn.Module):def__init__(self, vocab_size, d_model, n_layers, n_heads, d_ff, max_len=5000, dropout=0.1): super().__init__() self.token_embedding = nn.Embedding(vocab_size, d_model) self.pos_encoding = PositionalEncoding(d_model, max_len, dropout) self.layers = nn.ModuleList([ DecoderLayer(d_model, n_heads, d_ff, dropout)for _ in range(n_layers) ]) self.final_norm = nn.LayerNorm(d_model) self.lm_head = nn.Linear(d_model, vocab_size, bias=False)数据流全程:
输入是一串 token id(整数),形状 [batch, seq_len]过 Embedding 层,变成词向量 [batch, seq_len, d_model]加上位置编码 依次通过 N 层 Decoder Layer,每一层都用同一个因果掩码 最后过一次 LayerNorm(Pre-LN 结构的标准收尾) 通过 lm_head 线性层映射到词表大小,输出 logits
因果掩码的生成
defgenerate_causal_mask(self, seq_len: int) -> torch.Tensor: mask = torch.tril(torch.ones(seq_len, seq_len)).unsqueeze(0).unsqueeze(0)return mask就是一个简单的下三角矩阵,对角线及以下为 1,以上为 0。就这一个矩阵,保证了自回归生成的正确性。
七、运行测试:验证我们的模型
if __name__ == "__main__": config = {"vocab_size": 50257, # GPT-2 词表大小"d_model": 512, # 隐藏维度"n_layers": 6, # 6 层"n_heads": 8, # 8 个注意力头"d_ff": 2048, # 前馈网络维度"max_len": 1024, # 最大序列长度"dropout": 0.1 } model = DecoderOnlyTransformer(**config) input_ids = torch.randint(0, 50257, (2, 10)) # batch=2, 长度=10 logits = model(input_ids) print(f"输出形状: {logits.shape}") # [2, 10, 50257] print(f"参数量: {sum(p.numel() for p in model.parameters()) / 1e6:.2f} M")运行后你会看到:
输入 2 句话,每句 10 个词 输出每个位置对应词表中每个词的概率 这个小模型大约 3000 多万参数
总结:万变不离其宗
读到这里你应该发现了,Transformer 的核心逻辑其实非常朴素。我们再把主线收一收:
本质是一个序列到序列的映射:输入一串向量,输出一串向量,每个位置维度不变。 注意力是唯一的"跨位置"操作:除此之外,所有运算都是每个位置独立做的。 Decoder Only 的核心是因果掩码:没有它就不能做自回归生成。 堆叠是力量的来源:单层能力有限,堆几十层之后就涌现出强大能力。 Pre-LN + 残差是训练稳定的基石:没有这两个设计,深层 Transformer 根本训不起来。
这份代码和真实大模型的差距在哪?
今天工业界的 Llama、Qwen、DeepSeek 等模型,本质上还是这个架构,只是做了一系列工程优化:
位置编码换成了 RoPE LayerNorm 换成了更轻的 RMSNorm 激活函数换成了 SwiGLU 注意力用 FlashAttention 加速 增加了分组查询注意力(GQA) 更大的规模、更多的数据、更好的训练技巧
但核心骨架、数据流、设计思想,和我们今天拆解的这份经典代码,没有任何区别。
理解了这份不到 200 行的代码,你就理解了所有大模型的底层。
(没有合适的GPU,没有自己跑过,代码是网上的。仅供学习)