ARTICLE · 1259239
MiniMax H3本地部署安装包:原生支持6G显存,AI漫剧,不限Token出片
MiniMax H3本地部署安装包:原生支持6G显存,AI漫剧,不限Token出片做AI视频的朋友,大概率都卡在把模型搬回自己电脑这一关: 这两天MiniMax H3的原生标题还在密集刷屏——本地部署安装包来啦,不限Token,本地生成免费AI视频,零基础实战教程,说的都是同一件事:把H3搬到自己电脑上。而GitHub上已经有人把这事做完了——WanGP,本地跑H3不限Token。 (资源链接在文末!!!) 
看完这篇,你能拿捏三个核心能力: 
核心亮点:凭什么这么多开发者盯着它? H3是写进支持列表的一等公民,不是第三方插件;6GB显存是README里写到的下限;一键装是真一键——Windows双击bat、Linux跑sh;量化格式给到int8、fp8、gguf、NVFP4、Nunchaku五档;作者每天发一版,10月25日刚到v18.81。 
三大核心能力,覆盖全场景需求 H3原生支持 视频、图像、语音一次装齐 支持矩阵里,H3在视频一栏,H3 Voice Clone在音频/TTS一栏,量化后的pruned 20B同样能跑。 显存不够能降档 从25GB压到11GB 作者自测:15秒1080p的H3视频,早期要25GB显存,现在11GB;再降到480p,5-6GB也能跑。 出片能接业务 浏览器、命令行、API三头通 浏览器界面给你看图改参数,headless模式批量跑,API接入自己的服务。 
三大落地场景,普通人也能上手 场景一:想做AI短剧的分镜师 人物参考丢进去,H3的Ref2VA能吃3段参考视频和3段音频参考,还能从参考片里截3段原声和画面,角色一致性自己会稳。 场景二:想接AI视频私某的技术型副某玩家 本地跑不按秒计费,一单反复改稿不心疼;能不能接需求,取决于个人执行和市场需求变化。 场景三:想把生成接进自家系统的开发者 headless批量加API,生成队列排上号就走人;Profile 4作者自测快25%、省50%显存。 
横向对比:和主流方案差在哪 
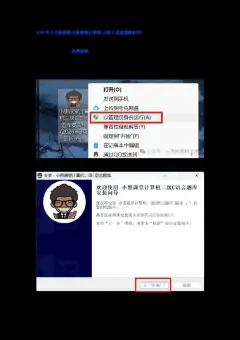
30分钟极速上手指南(零基础可用) 第一步 装: Windows双击install.bat,Linux和macOS跑scripts/install.sh,选Auto Install 第二步 起: run.bat或run.sh,浏览器打开界面 第三步 出片: 选H3,选FL2VA或Ref2VA,填提示词,先用默认参数跑一条 第四步 调显存: 不够就开Profile 4,Attention Head Split调Medium还能再省20%显存,速度掉10%以内 
适合人群 GitHub开源地址,直接自取
几十G的权重下到一半断流,续传还得自己找脚本 显存不够就只能排队上云端,按秒计费的账越看越慌 想把生成结果接进自己的业务系统,多半得先啃一遍ComfyUI的节点连线
不用连节点一个浏览器界面直接出片 自动降档按你的显卡挑int8/fp8/gguf版本 能接业务自带命令行批量和API
VS ComfyUI:ComfyUI是节点图,自由但连线累;WanGP是一体界面,出片不用先画线 VS官方H3权重:官方给的是权重和论文,跑起来环境还得自己拼 VS ComfyUI的H3节点包:节点包要在ComfyUI里装,WanGP是独立程序,浏览器直接开 VS云端API:本地跑不计费、不限Token,代价是要自己有显卡 VSAI原生IDE:AI原生IDE抢的是写代码的入口,这类本地AI视频工作台抢的是出片的入口 VS xDiT这类自研推理引擎:xDiT更底层更可控,多卡多机并行,门槛高得多 VS VideoX-Fun:VideoX-Fun是官方权重的训练框架,跑推理用不上它
想做AI视频、卡在本地部署这一步的朋友 想接AI视频私某的技术型副某玩家 要把生成接进自己系统的开发者 想读懂H3工程化落地细节的学习者
https://github.com/deepbeepmeep/WanGP