ARTICLE · 1266754
我们真的会搭建材料智能体吗(七):从 PDF 到带出处的文本块
本篇要点
· 前六篇的"材料"都是手写的;这一篇,让它从一篇真 PDF 里长出来
· PDF 里没有"文字",只有"在坐标处画这个字形"——顺序和分栏,全得自己重建
· 每个文本块领一张身份证:页码 + 字符区间,凭它能把原文逐字切回来
· 真跑一遍:11 页的论文切成 30 块,没有一块切不回原文
第 5 篇,材料是你手写的三段;第 6 篇,样品库是你手写的三条。它们都在替你干活,但都依赖同一件事:原文已经整整齐齐地摆在那儿了。
现实里没有这种好事。你手里有的是 PDF。这一篇,就把它拆开。
拆开之后你会发现一件有点意外的事:让机器"读"一篇文章,最难的不是读懂——恰恰相反,第一道坎是让它先把字认对、把顺序排对。这一步过不去,后面所有的检索、答题、引用,全是假的。
一、打开就能读?PDF 不是文本文件
很多人以为读 PDF 就是把它当 txt 打开。不是。
PDF 里存的不是"一段段的话",而是一条条绘图指令:在坐标 (x, y) 这个位置,画这个字形。一页纸上有几百个这样的坐标,而"谁先谁后、哪一栏接哪一栏",在文件里根本不存在——它藏在坐标里,得你自己排。
再加几样日常的干扰:页边竖排的下载水印、每页都变着页码出现的期刊页眉、双栏排版里被劈成两截的单词。直接把它们和正文拼在一起,垃圾便跟着进了下游。
所以"把 PDF 变成文本"这件事,压根不是 pdf.read() 一行。它是一道独立的工序——这一篇要亲手做的,就是这道工序。
二、先看一眼:不重建会得到什么
我们拿一篇真论文来试:Advanced Functional Materials 上的一篇锂硫电池单原子催化剂论文,11 页。先看它的第 8 页长什么样:
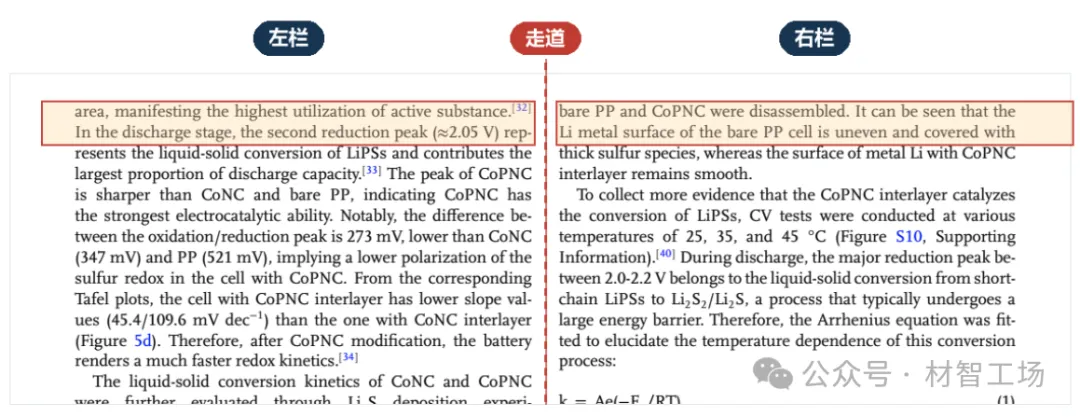
第 8 页顶部局部 · 原文:Adv. Funct. Mater. 2024, 35, 2412279
再用 pdfplumber 打开它,顺手调一下它自带的文本提取,看它吐出来什么:
www.advancedsciencenews.com www.afm-journal.dearea,manifestingthehighestutilizationofactivesubstance.[32] barePPandCoPNCweredisassembled.ItcanbeseenthattheInthedischargestage,thesecondreductionpeak(2.05V)rep- LimetalsurfaceofthebarePPcellisunevenandcoveredwith
看出来了吗?上图里,左栏的头两行和右栏的头两行,到了下面这份输出里被两两焊在了一起:rep- Limetalsurface 就是把左栏行尾和右栏行头拼到了一起,单词之间的空格也丢了。
(这段是原样输出,我一个字没改。)它不是坏了,它是老老实实按它以为的顺序把字吐了出来。谁让 PDF 里本来就没有"顺序"这个属性呢。
三、第一层:把行重建出来
重建这一步,说穿了只有三个动作:
· 聚行:先扔掉"躺倒"的字(页边 90° 的水印),再按纵坐标把字符聚成一行一行;
· 找走道:双栏排版的两栏之间,有一条竖直的"走道"——绝大多数行都不往那儿放字。找到它,把每行切成左右两半;横跨走道的,就是通栏行(标题、图表题注);
· 排顺序:通栏行把页面切成上下几段,每一段里先左栏、后右栏。
页眉页脚则分两层清。明显是网址、版权、DOI、纯页码的,用一组正则直接干掉;没见过的,靠一个更聪明的线索——"跨页重复":页边那种每页都出现、只有页码在变的短行,归一化之后数一数它出现在多少页上,够多就清掉。这样哪怕换一家出版社,也不用再加规则。
下面是这一步的前半段:最上面的准备(常量、"补空格"、找走道):
"""最小解析:把一篇 PDF 切成"带出处的文本块"。只依赖 pdfplumber 和标准库。"""import hashlibimport reimport sysfrom bisect import bisect_rightfrom collections import Counterimport pdfplumberMAX_CHARS = 1500 # 单块字符上限WORD_GAP = 0.8 # 相邻两字间隙超过它 → 中间本该有个空格MIN_GUTTER = 6 # 页宽中段最宽的"空带"比它还宽 → 认定这页分栏# 已知的页眉页脚模样:网址、版权、DOI、文章类型行、纯页码NOISE = re.compile(r"www\.|https?://|[©\u00a9]|^doi\b|\b10\.\d{4,}/"r"|^\s*(research article|review|communication|full paper)\s*$"r"|^\s*\d{1,4}\s*$", re.I)# ---------- 第一层:把 PDF 读成"按阅读顺序排列、去掉页眉页脚的行" ----------def _text_of(chars):"""相邻两字间隙够大就补一个空格——PDF 里本来并没有"空格"这个字符。"""out = ""for i, c in enumerate(chars):if i and c["x0"] - chars[i - 1]["x1"] > WORD_GAP:out += " "out += c["text"]return out.strip()def _seg(chars, col):return {"text": _text_of(chars), "col": col, "top": sum(c["top"] for c in chars) / len(chars)}def _gutter(lines, width):"""找"走道":两栏之间那条绝大多数行都不放字符的竖直空带;找不到就是单栏。"""lo, hi, total = int(0.25 * width), int(0.75 * width), len(lines)empty = [0] * (hi - lo)for cs in lines:cov = bytearray(int(width) + 1)for c in cs:for x in range(int(c["x0"]), min(int(c["x1"]) + 1, len(cov))):cov[x] = 1for k, x in enumerate(range(lo, hi)):if not cov[x]:empty[k] += 1best, i = (0, None, None), 0while i < len(empty):if empty[i] >= 0.8 * total: # 八成以上的行,这里都空着j = iwhile j < len(empty) and empty[j] >= 0.8 * total:j += 1if j - i > best[0]:best = (j - i, lo + i, lo + j)i = jelse:i += 1return (best[1] + best[2]) / 2 if best[0] >= MIN_GUTTER else None
接着是后半段:按走道切栏、排阅读顺序;再把全文拼起来,顺手清掉页眉页脚:
def _segments(chars, width):"""字符 → 行段:先按纵坐标聚成行;整行横跨走道的算通栏行(S),其余按走道切成左栏(L) / 右栏(R)。"""chars = sorted(chars, key=lambda c: (c["top"], c["x0"]))lines, cur = [], []for c in chars:if cur and c["top"] - cur[0]["top"] > 4:lines.append(cur)cur = []cur.append(c)if cur:lines.append(cur)gutter = _gutter(lines, width)segs = []for cs in lines:if gutter is None or any(abs(c["x0"] - gutter) <= 6 for c in cs):segs.append(_seg(cs, "S")) # 通栏行:标题、题注、宽公式continueleft = [c for c in cs if c["x0"] < gutter]right = [c for c in cs if c["x0"] >= gutter]if left:segs.append(_seg(left, "L"))if right:segs.append(_seg(right, "R"))return segsdef _order(segs):"""阅读顺序:通栏行把页面切成上下几段,每段里先左栏、后右栏。"""slot = {"S": 0, "L": 1, "R": 2}spans = [s for s in segs if s["col"] == "S"]return sorted(segs, key=lambda s: (sum(1 for w in spans if w["top"] < s["top"]),slot[s["col"]], s["top"]))def _norm(text):"""小写、空白折叠、任意数字串→#:这样逐页变化的页码也不影响比对。"""return re.sub(r"\s+", " ", re.sub(r"\d+", "#", text.lower())).strip()def read_pdf(path):with pdfplumber.open(path) as pdf:pages = [{"height": pg.height,"segs": _order(_segments([c for c in pg.chars if c["upright"]], pg.width))}for pg in pdf.pages]with open(path, "rb") as fh:doc_id = hashlib.sha1(fh.read()).hexdigest()[:12] # 身份证:文件内容哈希# 跨页重复的页眉页脚:页边区域(上 25% / 下 20%)的短行,归一化后数出现页数seen = Counter()for p in pages:for s in p["segs"]:if len(s["text"]) <= 100 and (s["top"] < 0.25 * p["height"]or s["top"] > 0.80 * p["height"]):seen[_norm(s["text"])] += 1running = {k for k, n in seen.items() if n >= 3} # 出现在 3 页以上 → 判为页眉页脚lines, dropped = [], 0for i, p in enumerate(pages, 1):for s in p["segs"]:if NOISE.search(s["text"]) or (len(s["text"]) <= 100 and _norm(s["text"]) in running):dropped += 1 # 已知模样或跨页重复 → 丢掉continuelines.append({"page": i, "text": s["text"]})pos = 0for ln in lines: # 拼全文,同时记下每行的字符区间ln["start"] = pospos += len(ln["text"]) + 1 # +1 是行间那个换行符return doc_id, "\n".join(ln["text"] for ln in lines), lines, dropped
四、第二层:切块,给每块发一张身份证
行重建好,全文就是一串字符了。接下来切块,有两个讲究。
第一,按句子边界切,不按字数硬切。最省事的做法是"攒够字数就封块",但那样切出来的块,十有八九是从半句话开始的——对人工抽查、对后面要抽取的内容,都是灾难。
第二,每块都要领一张身份证。身份证上有两样东西:起始页码,和在全文里的字符区间(start, end)。块文本为full_text[start:end]原样切出来的,一个字符都不改、空白也不"美化"。
这就是这张身份证的全部意义:把块文本和原文的那一段钉死在一起。凭它,任何时候都能从原文逐字切回这一块。这一步的行话叫 roundtrip(回切),它是整个溯源链条的第一环。
第二层的代码:
# ---------- 第二层:按句子边界切块,给每块发"身份证" ----------ABBR = {"fig", "figs", "no", "eq", "vs", "approx", "cf", "ref", "al", "i.e", "e.g", "etc"}def _last_sentence_end(text):"""缓冲里最后一个可靠的句子边界;宁可块大一点,也绝不切错。"""best = Nonefor m in re.finditer(r"[.!?]", text):tail = text[m.end():]ref = re.match(r"\s*\[[0-9,\s\-]+\]", tail) # 句点紧跟或被空白隔开的引用if ref is None and tail and not tail[0].isspace():continue # 0.92 这种小数点,不是句边界rest = (tail[ref.end():] if ref else tail).lstrip()if not (rest and (rest[0].isupper() or rest[0].isdigit() or rest[0] in "\"'([")):continue # 后面不像新句子的开头,不算word = re.findall(r"([A-Za-z.]+)$", text[:m.start()])if word and word[0].strip(".").lower() in ABBR:continue # Fig. / et al. 这种缩写,不算if word and len(word[0].strip(".")) == 1:continue # 孤零零一个首字母(G. Cai),不算best = m.end() + (ref.end() if ref else 0)return bestdef chunk(full_text, lines, limit=MAX_CHARS):starts = [ln["start"] for ln in lines] # 每行起点:用于把位置换算成页码pages = [ln["page"] for ln in lines]chunks, pos, n = [], 0, len(full_text)while pos < n:end = min(pos + limit, n)if end < n:cut = _last_sentence_end(full_text[pos:end])if cut is not None and cut < end:end = pos + cut # 缓冲超限 → 在最后一个句边界封块else:nl = full_text.rfind("\n", pos, end) # 找不到句点 → 退到行边界end = nl + 1 if nl > pos else end # 连行边界都没有 → 硬切上限chunks.append({"index": len(chunks), "page": pages[bisect_right(starts, pos) - 1],"span": (pos, end), "text": full_text[pos:end]})pos = endwhile pos < n and full_text[pos].isspace():pos += 1 # 句间空白不进任何一块return chunks
五、跑一遍
把论文路径传进去,跑:
python parse.py "你的某篇论文.pdf"
真实的输出,一个字没改:
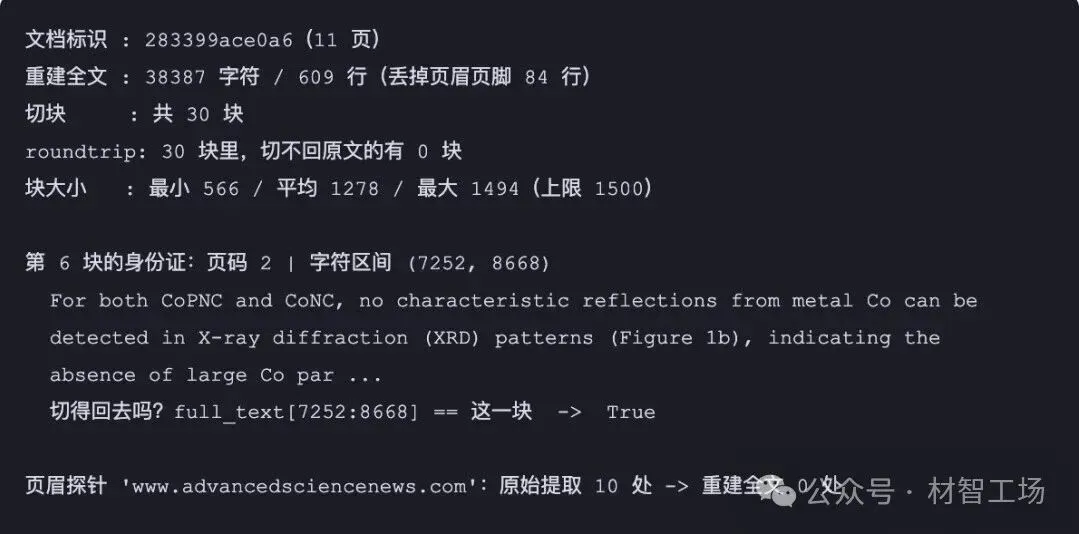
11 页的论文,重建出 38387 个字符、609 行;切成 30 块,没有一块切不回原文。第 6 块的身份证是"页码 2、区间 (7252, 8668)",把它拿回全文里切一刀,得到的正是这一块本身。
页眉探针那行也值得看:www.advancedsciencenews.com 这种页眉,原始提取里出现了 10 次,重建之后一次都不剩——它们没进任何一块。
六、为什么不能"攒够字数就切"
句边界这一关,看着简单,其实要放一组"守卫",宁可块大一点,也绝不切错。下面这几行,就是守卫们在干活(输出为实跑结果):
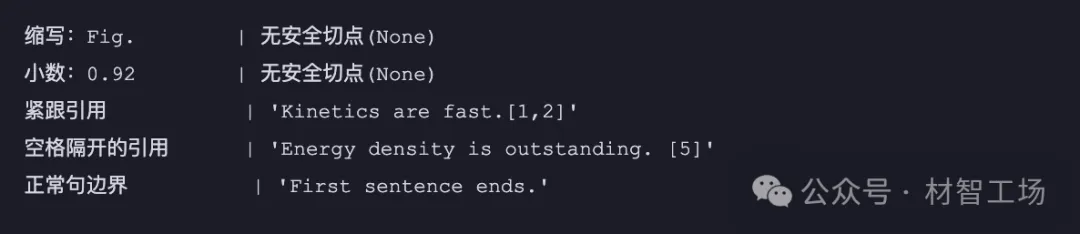
拆开看就两句话:
· 句点后面得跟着"新句子真的开始了"的证据(大写字母、数字、引号、括号)。所以 0.92 这种小数点不算边界。
· 句点前面那个词不能是缩写(Fig.、et al.),也不能是孤零零一个首字母(作者的 G. Cai)。句点紧跟的引用括号(.[1,2])则要随句子一起收尾。
万一整段文本一个可靠的句点都找不到(公式区、表格残片就是这样),就逐级往后退:先退到行边界,连行边界都没有,才按上限硬切。三级退路都落在上限之内,所以块大小永远不超限。
七、这一步做到了什么,还差什么
· 做到了:不可信的外部 PDF,变成带身份证的内部文本块;每一块都能逐字符切回原文。溯源的链条,从这儿才算真正扣上。
· 还差一点:PDF 里的上下标本就是独立定位的字,所以 mAh g−1 常被拆成几截。这一层先原样保留,交给后面的归一化去修。
· 还差一点:这一版没做章节过滤,参考文献、支持信息也跟着进了块。正式项目里只保留摘要、引言、实验、结果、结论这些目标章节。
· 还差一大块:块还只是"原料"——它不知道哪句话重要、哪个数字才是结论。让大模型登场,从块里抽出"断言 + 证据",是第 8 篇的事。
但请记住这一篇真正立起来的那条规矩:看见,和理解,要分开。这一层只管"这段文字在原文哪个位置",一个字都不解释;"哪句话重要"是下一层的事。分得越干净,后面越不敢乱来。
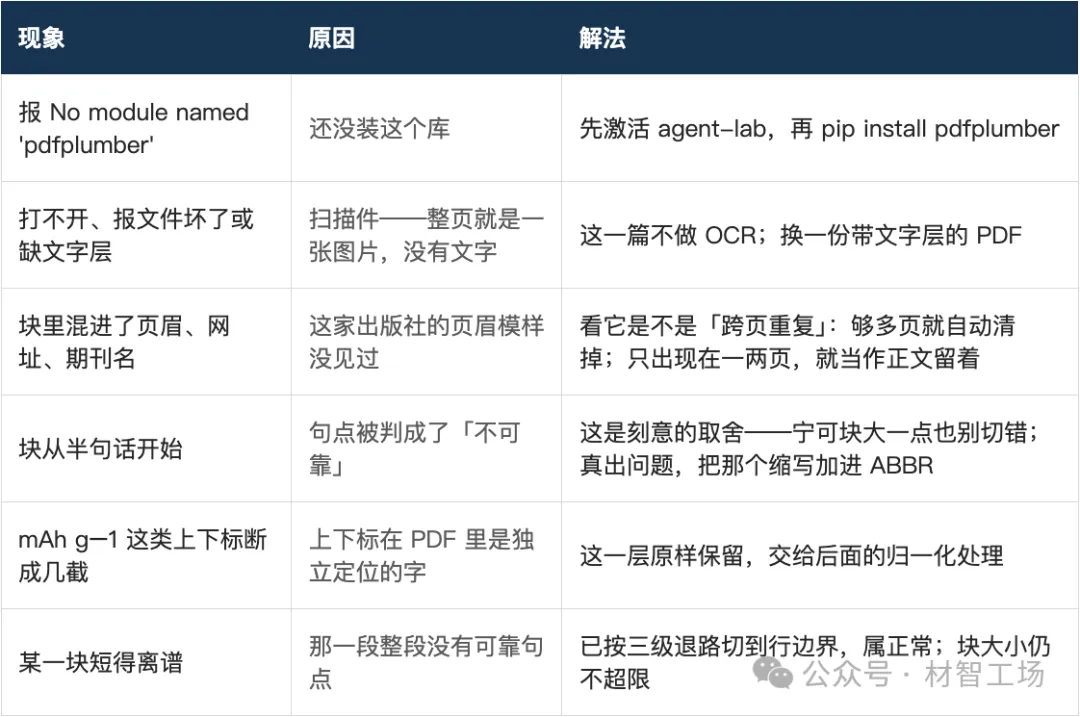
排错清单:撞上问题先查这里
它不知道哪句话重要,它只知道这句话在第几页、哪个位置。
把"出处"钉死在每一步,后面盖起来的东西才站得住。
下一篇:第 8 篇 · 概念、证据、数值——知识分三本账来存,让大模型从这些块里抽出"断言 + 证据"。
关注 材智工场,我们从零开始,把这个智能体一层一层搭出来。
END
欢迎加入AI4S学习交流群
对文章内容有疑问或没看懂的地方
欢迎进群讨论反馈
也欢迎一起交流AI for Science新方向新技术