ARTICLE · 1269118
文档更新迭代,RAG 库如何管理:一次实践与思考
上一篇,我们在 RHEL 10 和 NVIDIA L40S 上,用 OGX(Llama Stack)、vLLM 和 pgvector 搭起了一套 RAG 知识库,走通了文件上传、后台解析、分块入库和引用问答。这个系列会沿着同一套基础环境继续往下做。
基础链路跑通之后,最先撞上的是一个很实际的问题:文档更新了,知识库该用哪一版来回答?
企业里的文档几乎一直在变。规章改版、流程调整、价格表更新、产品手册换代,今天发一份新的,明天补一个通知,旧的那份往往还留在共享盘里,没人记得去删。
知识库跟着这些文档一起长。大多数 RAG 系统上线时都做对了一件事:把文档切块、向量化、存进库里。但很少有人在同一个地方想清楚另一件事——文档更新之后,旧的那一版该怎么办?
如果只是不断往里加,库里的新旧内容会同时被检索到。同一个问题,模型可能翻出三年前的报销标准,也可能同时引用两份互相矛盾的条款,然后给你一个看起来很自信的答案。它不是在编,它只是不知道哪一版作数。
本篇写的就是我们在这个环节上的做法:给文档一个稳定的身份,给每次修改一个版本,给版本一个生效区间,让检索先确定"这一次该用哪一版",再进对应的向量库。规则先定,模型后答。
先说清楚边界。多份文档同时适用于同一个问题时,系统不会替你选,而是要求你指定;正文里也不会出现"自动语义冲突检测"这种说法,那件事我们没做。
先看这张图。绿色部分是本篇新增的版本管理逻辑,蓝色部分沿用上一篇的 OGX、Embedding、pgvector 和 vLLM。 模型继续负责根据资料回答,我们在它前面加一道规则:先确定这次该用哪一版资料。
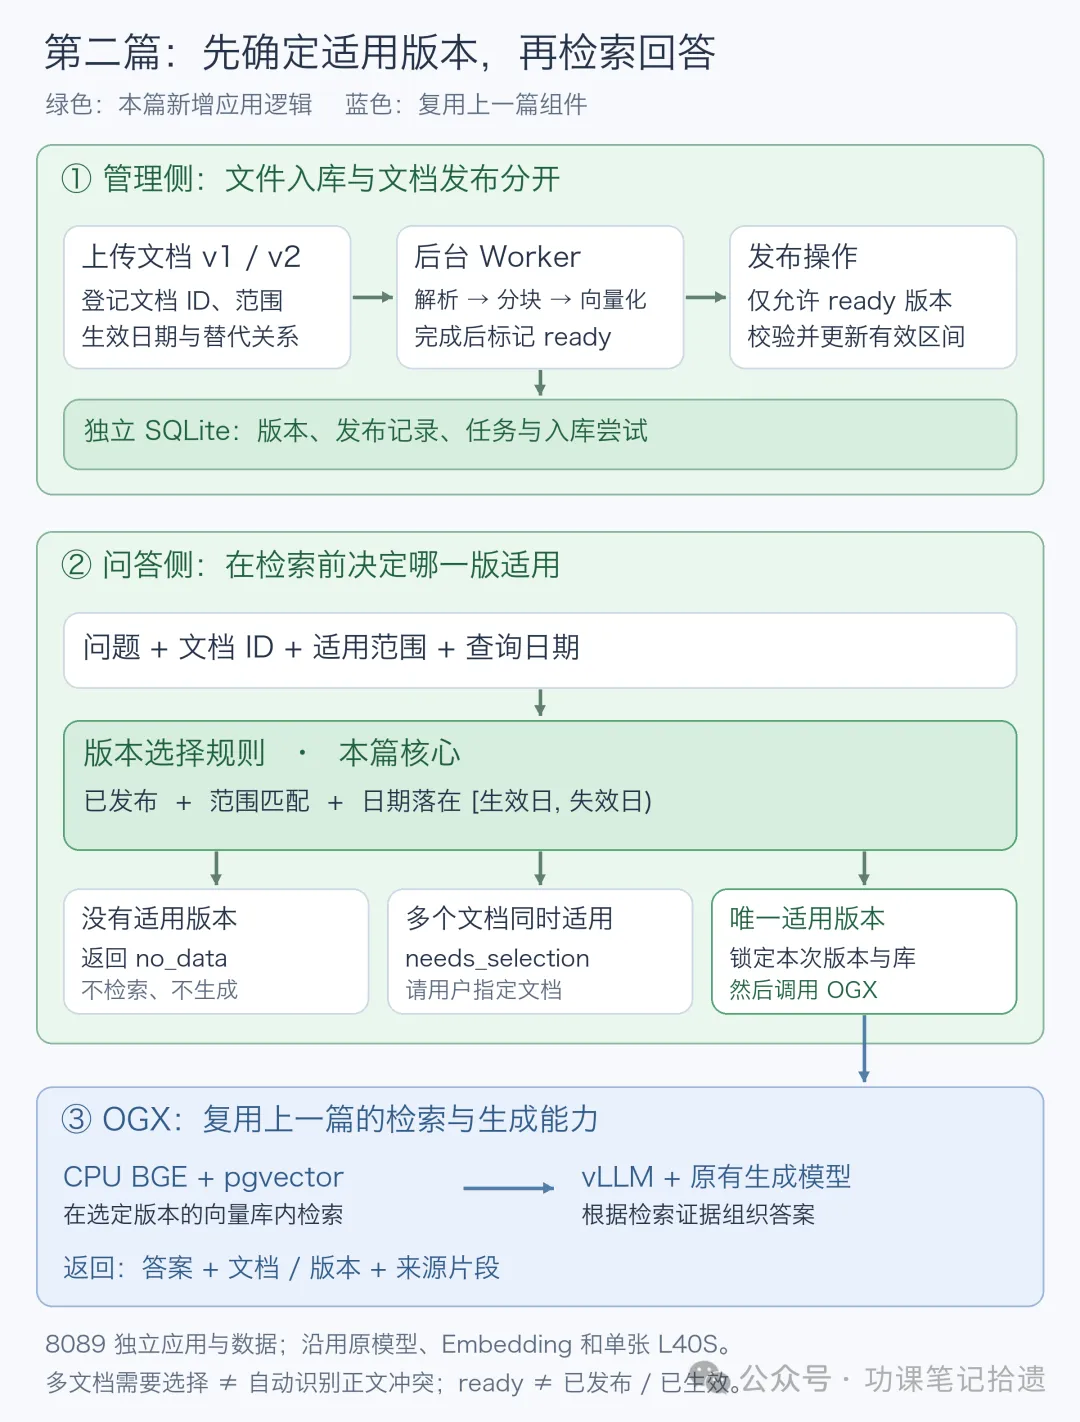
图里有两个关键变化:文件处理完成,只代表可以发布;提问时选定适用版本,才进入对应向量库检索。入库时的向量化也继续通过 OGX 使用原有组件。整套实验仍在单张 L40S 上完成,不需要再加一张显卡。
一、版本到底要记哪几件事
先明确一个词:文档身份。同一份《员工电脑使用规范》不管改了几版、文件名怎么变,都属于同一个 policy_id。版本是这个身份下面的一次具体发布。
真正需要记的只有四组:
其中最容易忽略的是两个状态要分开:
job_status是入库状态: queued → parsing → chunking → embedding → ready,失败是failed;publication_status是发布状态: draft → published,也可以withdrawn。
ready 只说明这份文件能被检索到,不说明它已经生效。 这一点是整篇文章的地基。如果这两个状态混在一起,后面所有的日期规则都无从谈起。
举个具体的坏结果:一份明年才生效的文档,如果解析完就自动算数,那么现在问出来的答案会提前变成新规。反过来,如果只有"发布"没有"入库",一份解析失败的文件也可能被当成有效依据。两个状态分开记,这两种错都不会发生。
生效区间按左闭右开处理:[valid_from, valid_to)。2026-11-01 这一天属于新版,不属于旧版。日期一律用 YYYY-MM-DD,按业务时区 Asia/Shanghai 取"今天"。
还有一个反直觉但很重要的限制:新旧版本的交替必须显式声明,不能靠推断。 上传得晚不等于生效得晚,文件名带"2026"也不等于它就是新版。所以替代关系是单独一个字段(supersedes),发布时由它把旧版本的失效时间对上。这样做的好处是,出问题时能一眼看出"谁替代了谁",而不是回头去猜上传时间的先后。
二、把版本管理放进独立的一套服务
为了不碰已经在跑的那套库,这次单独放三个东西:独立目录、独立数据、独立端口。
/root/rag-lab/rag-version-lab/ 应用代码 /root/rag-lab/rag-version-lab/data/ 独立的 version.db、原件、片段 127.0.0.1:8089 API 端口(原来的问答服务是 8088)三个 systemd 单元:rag-version-api、rag-version-worker,加一个 rag-version.target 统一启停。它和原来那套 rag-stack.target 互不隶属。
分开不是洁癖。原来那套库里装着演示用的文档,这套要改数据结构、要反复上传同一份文档的不同版本,两者混在一起,一次误操作就可能把旧数据改掉。独立目录、独立数据库、独立端口,代价是两边都要启停,换来的是改坏了也只坏一边。
它复用的是原有的解析、分块和 OGX 客户端,以及同一个 .venv-ingest、同一套模型和 Embedding。没有新增显卡,也没有换模型。
装服务和确认起来:
# 把代码放到 /root/rag-lab/rag-version-lab 后 cp deploy/rag-version-*.service deploy/rag-version.target /etc/systemd/system/ systemd-analyze verify /etc/systemd/system/rag-version.target systemctl daemon-reload systemctl enable --now rag-version.target curl --fail-with-body -sS http://127.0.0.1:8089/api/health预期看到:
{"api":"ok","worker_alive":true,"pending_versions":0}worker_alive 是 Worker 的心跳,超过 15 秒没更新就是 false。这一条比"进程还活着"有用:入库是异步的,API 活着但 Worker 死了,任务会一直躺在队列里,而你看不到任何报错。
8089 同时托管一个浏览器界面。打开 http://127.0.0.1:8089/ 就是上传、发布和提问的页面,/ui.js 是它的脚本,两者都由这个 API 自己发出去,不需要另装 Node,也不用单独起前端服务。填错字段会被拦在提交前,比如失效日期不晚于生效日期;替代下拉只列同一份文档、同一个范围的已发布版本。
源码和部署配置都在仓库的 rag-version-lab/ 目录下,对应提交 86ba3c0,链接放在文末。
三、上传两份文档,走一遍真实流程
用最典型的场景:旧版满四年,新版满三年,新版从 11 月 1 日起生效。
格式支持 PDF、Markdown、UTF-8 TXT 和 DOCX。旧版 .doc 会在提交时就被挡下来,提示先另存为 DOCX,而不是等传到后台解析时才失败——错误要出现在离操作最近的地方。
先造两份原件:
printf '%s\n' '员工电脑使用满4年可以申请换新。' > it-policy-v1.md printf '%s\n' '员工电脑使用满3年可以申请换新。' > it-policy-v2.md上传 v1,指定文档、版本号和生效日期:
curl -sS -X POST http://127.0.0.1:8089/api/versions \ -F file=@it-policy-v1.md \ -F policy_id=it-device-policy \ -F version_label=v1 \ -F scope=all \ -F valid_from=2026-01-01同一件事在页面上做,就是把这几个字段填进去。这是第一版,所以「替代旧版本」留空:
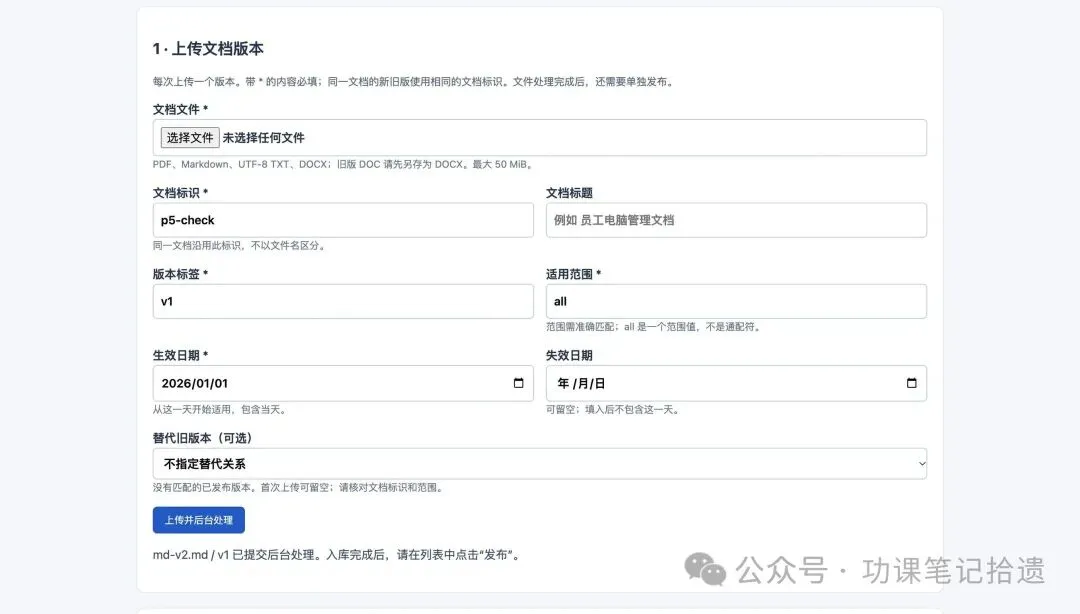
返回里有 version_id,此时状态是 queued、draft。等它入库:
curl -sS http://127.0.0.1:8089/api/versions/<v1的version_id>job_status 变成 ready 才允许发布。没 ready 直接发布会返回 409,这是故意的:不能拿一份还没解析完的文件去生成答案。
发布:
curl -sS -X POST http://127.0.0.1:8089/api/versions/<v1的version_id>/publish现在 v1 覆盖 2026-01-01 起,没有结束日期。
上传 v2 并替代 v1。关键在于多传一个 supersedes:
curl -sS -X POST http://127.0.0.1:8089/api/versions \ -F file=@it-policy-v2.md \ -F policy_id=it-device-policy \ -F version_label=v2 \ -F scope=all \ -F valid_from=2026-11-01 \ -F supersedes=<v1的version_id>等它 ready 再发布。发布成功后,v1 的失效时间会自动补成 2026-11-01:新版生效的那一刻,旧版正好退出,中间不留空档,也不允许新版的生效日期反过来把旧版的有效期往后拉长。
版本列表把这几件事摊开显示,一眼能分清三种状态:
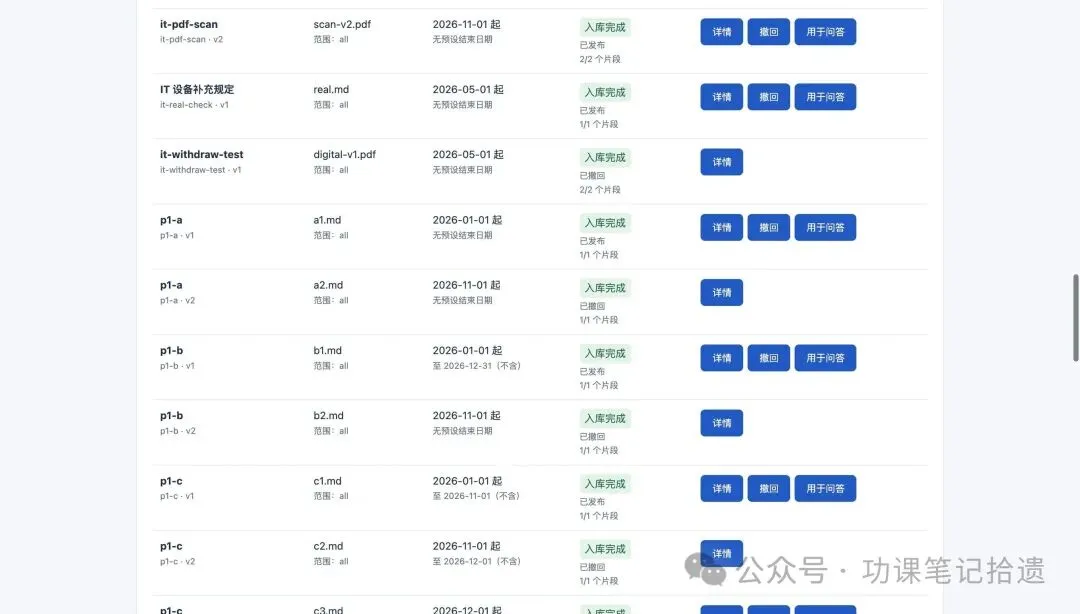
图里能看出三个层次:「入库完成」不等于「已发布」;已发布的行才显示有效日期;被撤回的那些行(比如 p1-a / v2)按钮只剩「详情」,问答入口自动收掉了。「已发布」也不等于「今天生效」——有效期到了才算,这要看下一节的日期查询。
入库中途出问题也不用重传。任务会被重新排队,下次处理时新开一个独立的向量库,只把这一次的片段写进去,上一次写了一半的库不会被继续使用,也不会混进答案里。每次尝试都会留一条记录,事后能查到用过哪几个库。
另外,如果冻结的片段缓存结构不对,比如缺了 OGX 要求的字段,任务会直接判失败,不会去建库,也不会调用 Embedding。这类失败在日志里能直接看到原因,不会变成"上传成功了但查不到内容"这种难查的状态。
四、同一句话,两个日期,两个答案
这才是这套东西真正起作用的地方。
问 10 月 27 日:
curl -sS -X POST http://127.0.0.1:8089/api/ask \ -H 'Content-Type: application/json' \ -d '{"question":"电脑使用3年能申请换新吗?","policy_id":"it-device-policy","scope":"all","as_of":"2026-10-27"}'返回里的 version 是 v1,答案是未达到四年,不能申请:
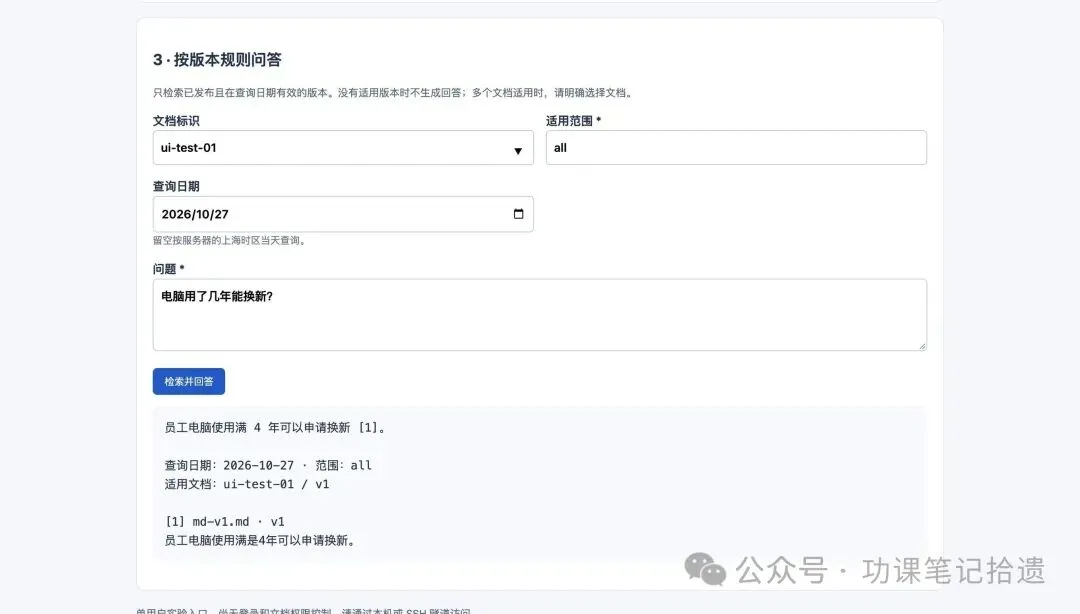
{"status":"ok", "as_of":"2026-10-27", "version":{"policy_id":"it-device-policy","version_label":"v1", "valid_from":"2026-01-01","valid_to":"2026-11-01"}, "answer":"……员工电脑使用满 4 年才可以申请换新,3 年未达到门槛……"}下面两张页面截图来自另一组实测文档 ui-test-01:旧版要求满 4 年,新版要求满 6 年,与上面的接口示例(4 年改为 3 年)不同。这里看的是同一条选版逻辑:查询日期改变后,答案和引用是否一起切换。
先查询 2026-10-27,页面显示命中旧版,并列出引用文件:
再把 as_of 换成 2026-11-01:
返回的 version 变成 v2,答案是满三年可以申请:
{"status":"ok", "as_of":"2026-11-01", "version":{"policy_id":"it-device-policy","version_label":"v2", "valid_from":"2026-11-01","valid_to":null}, "answer":"……员工电脑使用满 3 年可以申请换新……"}在页面这组测试里,把日期改成 2026-11-01,答案变为新版规定的满 6 年,引用也切换到 v2:
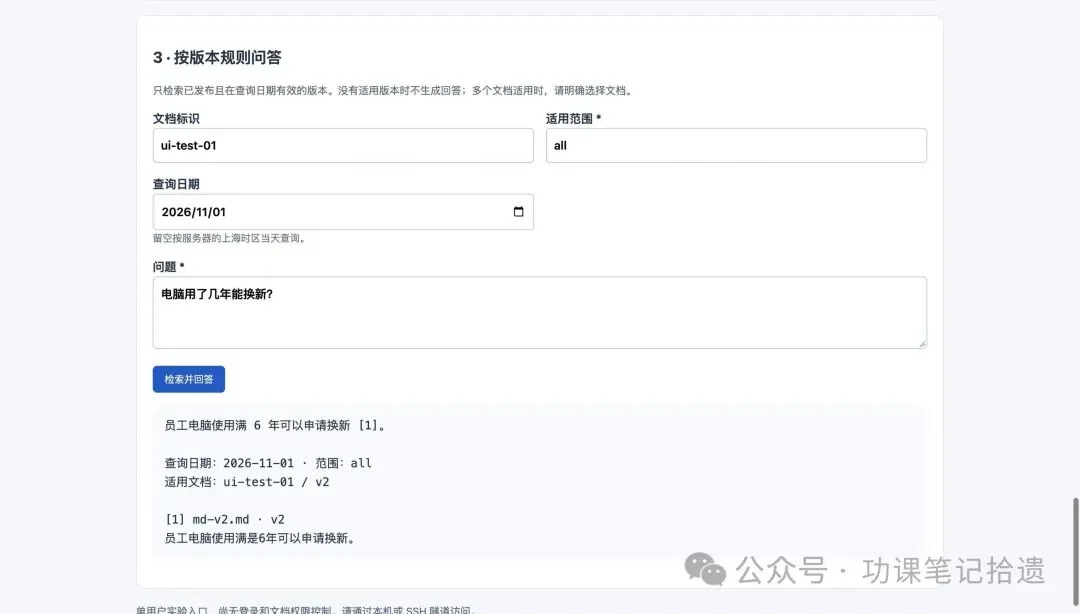
两次请求的模型、Embedding、检索参数完全一样,唯一变化的是日期。 这正是我们想要的:结论的差异来自规则,而不是来自模型当天的发挥。
日期是显式传的,不传就取业务当天。除了 as_of,返回里还会带上命中的 policy_id、version_label、valid_from、valid_to,以及每条来源的 chunk_id。答完之后要能倒推回去,看到底引的是哪一版。
如果引用的那条来自扫描件,页面上会标出「OCR识别」和页码,和数字文本、表格块分得开。这一点在核对时有用:OCR 出来的字认得准不准,和原文本来就写的是什么,是两种不同的问题,标出来才好分辨该查哪一头。
如果这个日期上确实没有已发布的版本,返回的是 no_data,而不是"把库里所有 ready 的都翻一遍"。这一点值得强调:它宁可说没有,也不愿意拿一个日期不对的版本凑一个答案。
五、几种"不唯一"的情况,要分清楚
版本规则落地之后,会遇到三种容易混淆的情形。
第一种:新版还没发布,或者入库失败。
draft 和 failed 都不参与检索,问答继续用当前生效的旧版。上传了不等于生效,入库失败也不影响旧版继续服务,这是设计的默认行为,不需要额外操作。
第二种:多份文档同时在有效期内。
比如《员工电脑使用规范》和《IT 设备管理规定》都覆盖同一个范围,这时查询会返回 needs_selection,并把候选列出来:
{"status":"needs_selection", "answer":"存在多个适用文档,请从候选中指定 policy_id 后再查询;这不表示正文存在冲突。"}这里要说明白:它只是在说"我不知道该用哪一份",不是在做内容冲突检测。 系统没有比对两段文字是否矛盾,也没有判断谁优先。指定 policy_id 之后,答案就正常了。
第三种:同一份文档、同一个范围,两个版本的有效区间重叠了。
这是版本配置冲突,不是语义冲突。发布时就会被拒绝,提示 overlap:<版本ID>。要跨过它,只能显式声明 supersedes,由新版本结束旧版本,不能靠"上传得晚"自动覆盖。
还有两个边界值得知道:
- 历史查询不会因为新版生效而消失。
新版发布之后回头问 10 月 27 日,仍然返回 v1。 - 撤回会把被它替代的旧版还回来。
撤回一个替代过旧版的新版时,系统会把旧版被截短的失效日期还原成原来的值,那段空档重新补上。这个还原需要两样东西:一是有当时截断留下的记录,二是旧版必须仍是已发布、截止日没被别人改过、期间没有更晚的版本接替、还原后也不能和别的已发布版本重叠。没有截断记录的老数据不会被猜着恢复——宁可留着空档,也不凭推测改历史。任何一条不满足就跳过还原,并直接告诉你原因——比如「恢复会与其他已发布版本重叠,请检查是否存在适用空档」。 - 被撤回的那一版,不会自动重新参与检索。
撤回之后再问那个日期,不会再返回这一版。如果正好有别的已发布版本覆盖那一天——比如刚被恢复的前一版——返回的就是那一版;只有当确实没有任何版本覆盖时,才是"没有适用版本"。版本记录和发布日志照旧保留,状态回到可以再发布的样子。也就是说:被它替代的旧版能回来,它自己不会自动回来。
恢复被跳过时,页面会直接说清楚是哪一条挡住了:
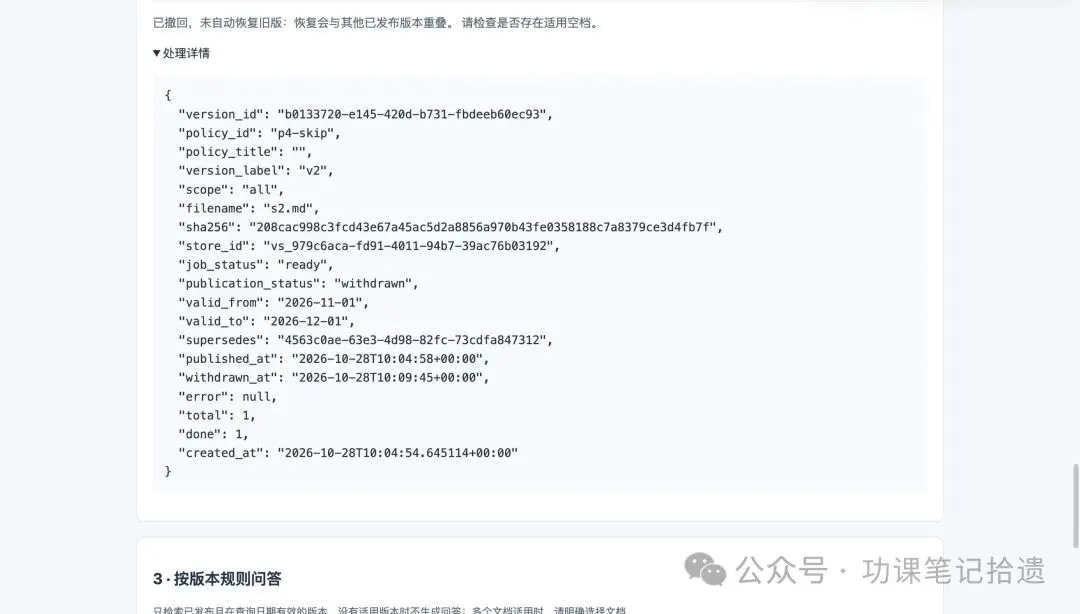
别把这套动作当成可靠的回滚手段。它只做一件事——把被截短的那个有效期还回去,而且只在条件全部成立时才还。版本本身撤回后不会自动回到检索里;条件不成立时,空档照样留着。它是补空档,不是撤销操作。
六、下一步
先说清现在的边界。文档有身份,版本有生效区间,入库和发布分开,问答先定版本再检索,答完能追到具体版本和片段。文件格式这次实测了四类:数字 PDF、DOCX、没有文字层的扫描 PDF,以及一页文本一页扫描的混合 PDF,每类都走完上传、解析、分块、真实向量化、发布、按两个日期问答,并核对了片段里的页码、表格数字和引用;空白样本则如期判失败,不会建库。撤回的两种结果分开验证过:成功恢复前一版是在接口层逐条核对的;因重叠被拒绝恢复是在浏览器里实际点过的。本地和服务器上各跑了 68 项自动化测试。
没测的同样列出来:扫描件只测了合成出来的清晰样本,倾斜、模糊、低分辨率和手写都没试;XLSX、PPTX、图片直传也没试;完整系统的备份恢复演练、并发和性能没有测(数据库迁移前的副本回退单独验过)。多用户、登录和文档权限一直没有做,scope 只决定检索范围,不是权限。
上一篇把 RAG 的基础链路跑通,本篇在同一套环境上补上了文档版本和生效规则。接下来,这个系列会继续用真实业务问题集检查检索与回答质量:适用版本选定之后,能不能找到正确的片段,回答是否有依据,引用是否准确。版本管理解决了资料该怎么选,评估则帮助我们判断这些改动到底有没有让回答变好。
---
附:关于 CUDA Toolkit 的一个常见说法
正文之外补一段,因为踩过,也因为它容易被一句话带偏。
有一个说法流传得挺广:用预编译的 pip 包装 vLLM,就不需要额外安装 CUDA Toolkit。
这句话只对了一半。pip 装的是预编译 wheel,确实省掉了源码构建 vLLM 本体这一步;但这不代表运行时一定用不到编译工具。 我们这次实际跑下来,vLLM 走的 FlashInfer 路径会在首次运行时编译一部分算子,所以宿主机上必须能找到 nvcc 和 ninja。缺了会依次报两个错:
RuntimeError: Could not find nvcc and default cuda_home='/usr/local/cuda' doesn't exist FileNotFoundError: [Errno 2] No such file or directory: 'ninja'我们的做法是沿用基础安装脚本里那条 Toolkit 13.3 路线,然后在服务里把工具位置显式指出来:
Environment=CUDA_HOME=/usr/local/cuda-13.3 Environment=PATH=/root/rag-lab/.venv-vllm/bin:/usr/local/cuda-13.3/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin这里要区分三个容易混的东西:nvidia-smi 显示的 13.3 是驱动侧的版本;Toolkit 13.3 是编译工具链;PyTorch 报告的 CUDA runtime 是 13.0。它们是三件事,数字不同不代表装错了。
也不必过度推广:不是所有用 pip 装 vLLM 的人都要装完整 Toolkit 13.3。只有走运行时编译、且编译工具不可发现时,才需要补齐。 至于数据库容器,它本来就不用 GPU,也不需要 GPU 工具包。
参考资料
vLLM GPU 安装说明:源码构建与预编译 wheel 的区别 NVIDIA RHEL 驱动与 Toolkit 指南:驱动、Toolkit 与 runtime 的关系
源码与部署说明:ogx-rag-lab / rag-version-lab,对应提交:86ba3c0。