ARTICLE · 1272657
公交App上“还有2站,约5分钟”怎么实现?90%的人答错这道大厂面试题:GPS漂移、ETA不准、10万QPS热点读全拆透(附完整代码)
🔥 本文速览:一句“还有 2 站,约 5 分钟”,背后全是坑
公交 App 上那句轻飘飘的 “还有 2 站,约 5 分钟”,其实是大厂后端面试的高频场景设计题:GPS 漂移、消息乱序、热点读放大、ETA 不准、推送风暴、千亿条轨迹存储,个个都是坑。
本篇文章完整主线:从需求对齐、容量估算、总体架构、数据模型,一路讲到写链路清洗、地图匹配、到站判定、ETA 预测、查询缓存、实时推送、冷热分离和降级容灾,架构图 + 数据模型 + 核心代码全都有。
先记住一句话:写是高频小包流,读是突发热点流,全链路允许最终一致,不要求强一致。 后面所有设计都围绕它展开。
本文硬核亮点,先睹为快
先量化,再设计:不报 QPS 的系统设计都是耍流氓,三档容量估算直接对齐 第一个认知门槛:公交不是“附近的车”,核心不是 Redis GEO,而是线路沿线距离模型 一个 dist_from_start字段定乾坤:一次减法,把“还有几站、还有几分钟”全算出来ZSET 的 score = 沿线距离:一条 ZREVRANGEBYSCORE捞出所有未过站车辆,已过站天然过滤ts 版本号 + Lua 乐观锁:乱序丢弃、原子更新、失联自动过期三合一,比分布式锁快 10 倍 迟滞双阈值状态机:进站 40m、出站 80m,专治站点围栏边缘反复横跳 ETA 从 180 秒误差干到 28 秒:分段基线 + 三层加权 + 卡尔曼增量修正,数字收敛不跳动 10 万 QPS 热点读:Caffeine + Redis 多级缓存、SingleFlight、逻辑过期、TTL 随机抖动全套防御 推送量从“用户数”压到“组合数”:按线路 + 站点聚合订阅,百万级连接防住推送风暴 降级决定下限:系统可以不准,但不能不可用;宁可显示“约 5 分钟(时刻表)”,也不白屏
读完你能带走什么?
一套能直接套用的实时位置类系统设计模板:GPS 脏数据怎么洗、ETA 怎么算才不跳、热点查询怎么扛、推送风暴怎么防、千亿条轨迹怎么存不破产。文末还附了 14 个难点全景表 + 面试追问应对,面试和落地都能用。
适合人群:正在准备后端场景设计面试、做实时位置/ETA/物联网接入、被缓存和乱序问题折磨过的同学。
文章比较长,建议先收藏再细看。觉得有用,点个赞、点个在看,转发给正在面试的朋友。
文末留了个互动问题:如果你是面试官,听完这套回答你会追问什么? 评论区聊聊,我挑 3 个最有意思的,下一期单独拆解。
后面还会持续拆解高频系统设计题,点个关注不迷路。
公交实时到站查询系统怎么设计? 从架构到代码全都有
公交 App 上那句"还有 2 站,约 5 分钟",到底是怎么实现的?
这也是大厂后端面试的高频场景设计题:GPS 漂移、消息乱序、热点读放大、ETA 不准,个个是坑。本篇文章,从需求对齐、架构设计、数据模型讲到核心代码,建议先收藏再细看。
一、别急着画架构图,先把需求和量级对齐
拿到场景设计题,最忌讳的就是上来就画架构图。老司机的第一步永远是:问清楚需求,估算量级。
1.1 功能边界:做什么,更要说不做什么
系统要做什么:
用户查询某条线路、某个方向、某个站点的实时到站信息:还有几辆车、还有几站、还有几分钟 APP 地图上能看到车辆的实时位置 数据准实时刷新,误差控制在可接受范围内(30 秒~2 分钟)
展示效果长这样:
302路 开往火车站方向
粤B12345:还有2站,约5分钟
粤B67890:还有4站,约11分钟
同样重要的是明确不做什么——主动收敛边界,说明你真的想清楚了:
不做路径规划、换乘推荐 不做支付、扫码乘车 不做调度排班系统
1.2 关键指标:一切设计围绕数字展开
1.3 容量估算:不报 QPS 的设计都是耍流氓
不同题面规模对应完全不同的设计,先对齐量级再谈方案。三档常见假设:
估算过程以一线城市为例:
写侧:3 万辆 ÷ 10 秒/次 = 3000 TPS,按 2 倍冗余算 6000 读侧:早晚高峰爆发,峰值 1 万+ QPS 存储:最容易被低估——3300 TPS × 86400 秒 × 365 天 ≈ 1000 亿条/年,压缩后约 100GB/天
如果真到全国百万辆级别,峰值写入约 33 万条/秒,10 个 Kafka 分区 + Flink 百级并发也能扛住,思路是一样的。
一句话定性:写是高频小包流,读是突发热点流,全链路允许最终一致、不要求强一致。 后面所有设计都围绕这个特征展开。
记住这句话:先量化,再设计。
二、总体架构:一条主线打穿
需求清楚了,架构其实很清晰。先看全景图:
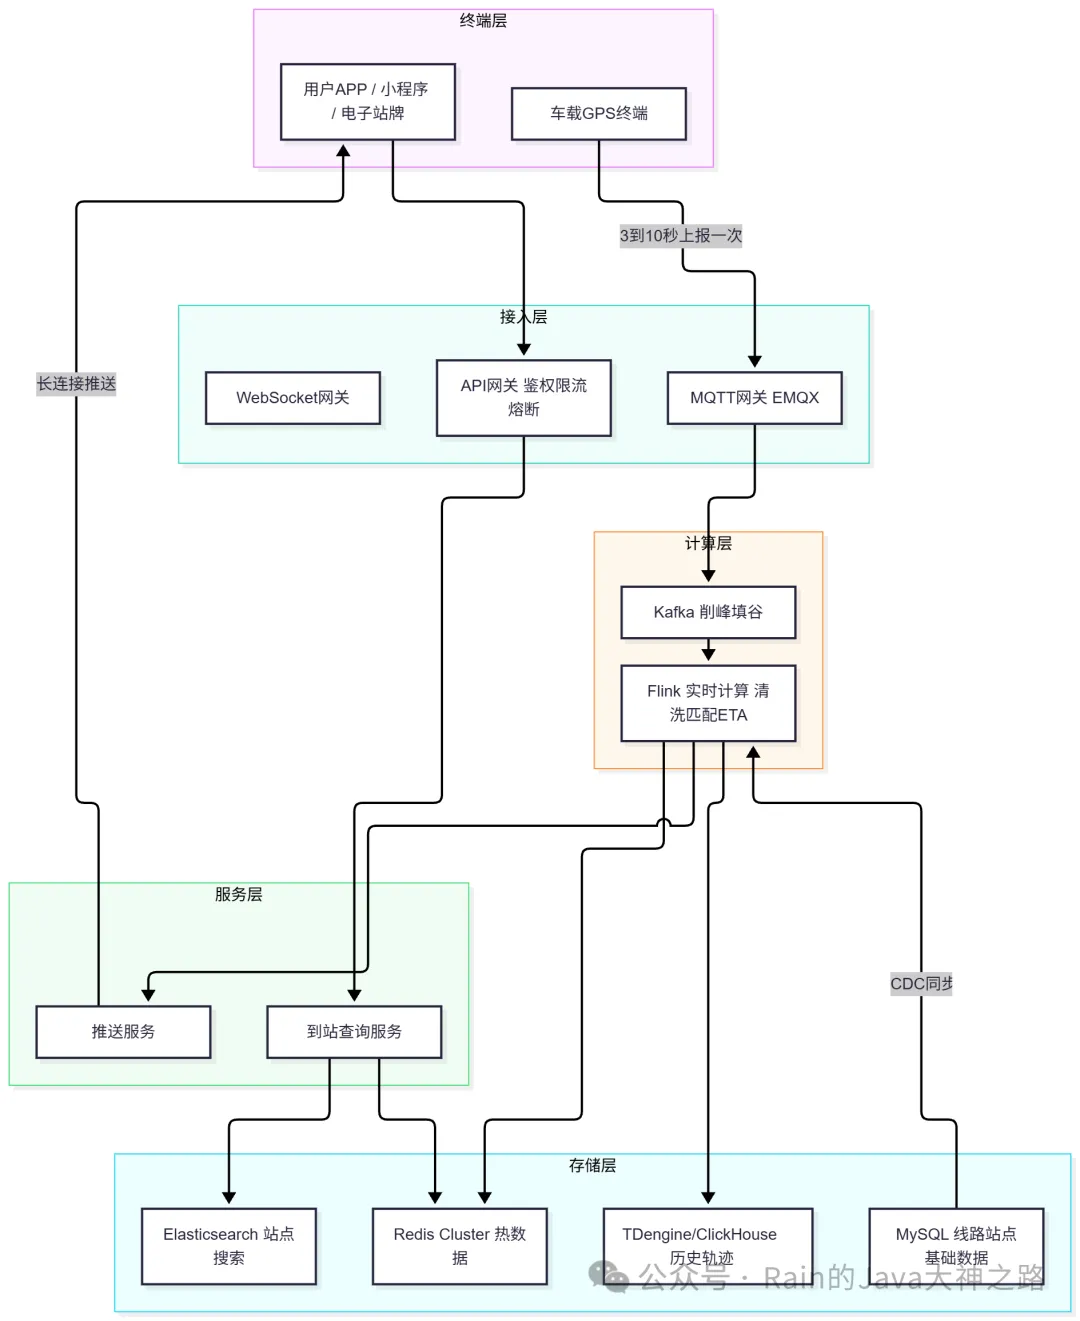
数据流一句话讲清:
GPS上报 → MQTT接入 → Kafka削峰 → Flink纠偏算ETA → Redis热数据 → API秒回 + WebSocket推送
2.1 分层职责,各管一摊
接入层:Netty / MQTT 网关只做鉴权、协议转换、限流,不碰业务,无状态设计方便水平扩展 Kafka:削峰填谷,同时承担单车数据的保序职责(分区策略后面细讲) Flink:整个系统的大脑——清洗、地图匹配、到站判定、ETA 计算全在这 Redis:扛住全部读流量,实时热数据 TTL 按秒计 时序库:历史轨迹归档 + 分段耗时统计 MySQL:线路、站点静态数据,变化极少,可全量缓存
2.2 技术选型清单
2.3 核心链路时序图
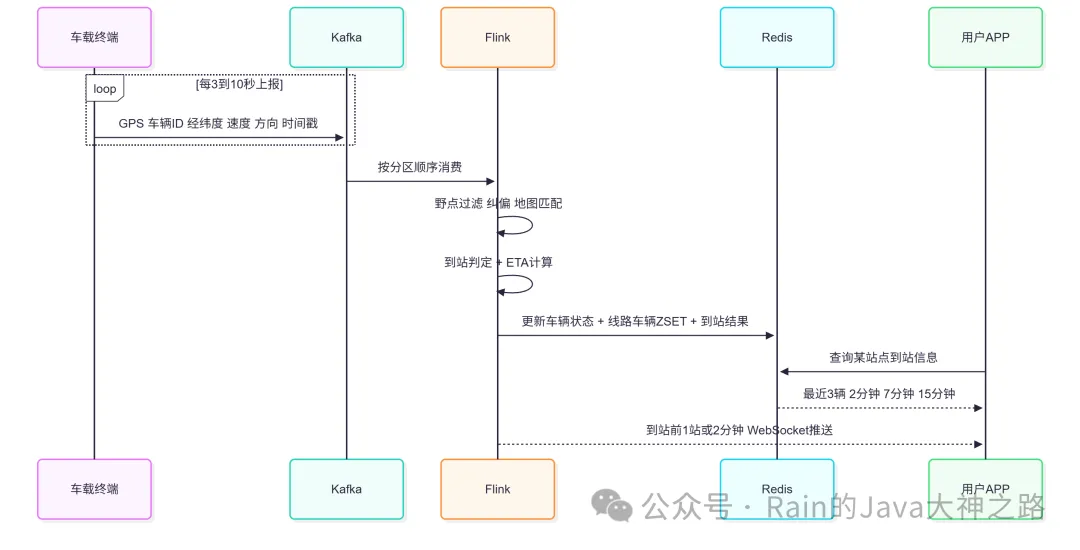
架构图画着挺爽,但说句实话,这种"框图"谁都能画。真正拉开差距的是后面每一章的细节——GPS 脏数据怎么洗、ETA 怎么算才不跳、热点查询怎么扛。下面逐个拆解。
三、数据模型:一个 dist_from_start 字段定乾坤
3.1 先纠正一个认知:这不是"附近的车"问题
很多人一看到"实时公交",第一反应是 Redis GEO 查附近车辆,一个 GEORADIUS 不就完了?
错。这是这道题最大的误区。
"附近的人""外卖骑手"求的是直线距离,但公交是沿着固定线路行驶的,用户关心的是"沿线路到站还有多远"。车明明直线距离 200 米,中间隔着一条河,实际要绕行 2 公里——直线距离毫无意义。
技术亮点:这套系统的核心不是 Redis GEO,而是建立"线路沿线距离模型"。 这句话是面试时第一个可以抛出的亮点。
3.2 MySQL 基础表
-- 线路表(低频变更,可全量缓存)
CREATETABLE bus_line (
    line_id BIGINT PRIMARY KEY,
    line_name VARCHAR(50),
    start_station VARCHAR(50),
    end_station VARCHAR(50)
);

-- 站点表
CREATETABLE bus_station (
    station_id BIGINT PRIMARY KEY,
    station_name VARCHAR(50),
    longitude DECIMAL(10,7),
    latitude DECIMAL(10,7),
    geohash VARCHAR(12),
    line_ids VARCHAR(255)
);

-- 线路-站点关系表(核心表)
CREATETABLE bus_route_station (
    line_id         VARCHAR(32),
    direction       TINYINTCOMMENT'0去程 1回程',
    station_seq     INTCOMMENT'站点序号',
    station_id      VARCHAR(32),
    station_name    VARCHAR(64),
    lon             DECIMAL(10,7),
    lat             DECIMAL(10,7),
    dist_from_start INTCOMMENT'距线路起点距离(米)',
    PRIMARY KEY (line_id, direction, station_seq)
);

-- 车辆位置历史表(兜底用,实时数据走Redis)
CREATETABLE bus_location (
idBIGINT PRIMARY KEY AUTO_INCREMENT,
    vehicle_id VARCHAR(20),
    line_id BIGINT,
    longitude DECIMAL(10,7),
    latitude DECIMAL(10,7),
    speed INT,
    direction INTCOMMENT'0去程 1回程',
    report_time DATETIME,
INDEX idx_vehicle_line (vehicle_id, line_id)
);
bus_route_station 里的 dist_from_start 字段是灵魂。举个例子:
302路 去程:
站点A:0m
站点B:800m
站点C:1500m
站点D:2600m
车辆投影到线路上,距起点 1300m,用户查站点 C(1500m),那么:
剩余距离 = 1500 - 1300 = 200m
一次减法,"还有几站""还有几分钟"全都有了根基。
3.3 Redis 数据结构设计
实时数据基本全放 Redis,key 的设计直接决定查询效率:
bus:live:{vehicleId} | |||
line:{lineId}:{direction}:vehicles | |||
line:{lineId}:geo | |||
bus:stations:geo | |||
route:{lineId}:arrivals | |||
arr:{lineId}:{stopId} |
这里有两个设计亮点:
亮点一:ZSET 的 score = 车辆沿线距离。 查某站点的到站车辆时,用
ZREVRANGEBYSCORE直接捞出所有"还没过站"的车并按距离排好序,时间复杂度 O(logN+M),不需要全量扫描。
亮点二:Redis Cluster 下用 hash tag。 把
bus:{line:302:1}:*这类 key 全部落到同一个 slot,后面 Lua 脚本才能一起操作——Cluster 模式下 Lua 跨 slot 访问会直接报错,这个坑踩的人不少。
ZSET 的 score 有两种常见设计,各有适用场景:
车辆实时状态在 Redis 里长这样:
{
"vehicleId": "粤B12345",
"lineId": "302",
"direction": 1,
"lon": 113.95,
"lat": 22.54,
"distFromStart": 1300,
"speed": 8.5,
"ts": 1730000000000
}
数据模型搭好了,接下来看写链路——原始 GPS 数据有多"脏",清洗起来就有多讲究。
四、写链路:GPS 数据的清洗、纠偏与幂等
原始 GPS 数据非常脏,不清洗直接算 ETA,会算出"公交车瞬移 500 米"的鬼数据。这一章讲四件事:野点过滤、去重、坐标纠偏、乱序幂等。
4.1 上报接入:别直接写库,先扔 Kafka
车载终端通过 MQTT / HTTP 上报,接入层做完基础校验直接扔 Kafka,立即返回:
@PostMapping("/location")
public Result<Void> reportLocation(@RequestBody BusLocationDTO dto){
if (dto.getVehicleId() == null || dto.getLineId() == null) {
return Result.error("参数错误");
    }
    kafkaTemplate.send("bus-location-topic", JSON.toJSONString(dto));
return Result.success();
}
为什么不直接写库? 1 万辆车每 3 秒上报一次就是 3300+ TPS,突发还要乘 3。直接写 DB 就是打爆,Kafka 削峰、下游批量消费,上报接口永远毫秒级返回。这就是异步解耦的标准姿势。
4.2 Kafka 分区策略:保序是第一道防线
分区键有两种常见选择,这是个设计权衡:
vehicleId | ||
lineId |
同一辆车的数据有序是硬需求(乱序意味着旧点覆盖新点),按 vehicleId 哈希最稳;如果计算层按线路聚合,用 lineId 也行,配合消费端时间戳校验兜底。
4.3 野点过滤 + 坐标纠偏
GPS 漂移是这个场景最坑的数据质量问题:隧道、高架、楼宇峡谷,位置随时可能跳到河对岸。野点判定通常两条硬规则:
@Component
publicclassGpsCleanProcessor{

privatestaticfinaldouble MAX_SPEED_KMH = 120.0;
privatestaticfinaldouble MAX_JUMP_METERS = 500.0;

@KafkaListener(topics = "gps_raw", groupId = "clean-group")
publicvoidonMessage(GpsReport report, Acknowledgment ack){
        GpsReport last = RedisUtil.get("gps:last:" + report.getBusId());

if (last != null && isWildPoint(last, report)) {
            metrics.increment("gps.wild.point");
            ack.acknowledge();
return; // 野点直接丢弃,防止污染ETA计算
        }

// 坐标系纠偏:国内地图是GCJ-02,必须转换
double[] wgs84 = CoordTransform.gcj02ToWgs84(report.getLng(), report.getLat());
        report.setLng(wgs84[0]).setLat(wgs84[1]);

        kafkaTemplate.send("gps_clean", report.getBusId(), report);
        RedisUtil.setex("gps:last:" + report.getBusId(), 300, report);
        ack.acknowledge();
    }

privatebooleanisWildPoint(GpsReport last, GpsReport cur){
long dtSec = Math.max(1, (cur.getTs() - last.getTs()) / 1000);
double dist = GeoUtils.distance(last.getLng(), last.getLat(),
                                        cur.getLng(), cur.getLat());
double speedKmh = dist / dtSec * 3.6;
return speedKmh > MAX_SPEED_KMH
                || (dist > MAX_JUMP_METERS && dtSec < 5);
    }
}
速度突变超 120km/h,或 5 秒内跳变超 500 米,判定为野点。公交车不会飞,物理规律帮我们过滤脏数据。清洗前后对比:野点率能从 3% 压到 0.1%。
踩坑经验:坐标系纠偏一定要做。 国内地图服务用 GCJ-02 坐标系,GPS 芯片出来的是 WGS84,两者能差出几百米。我之前就踩过这个坑,车辆集体"偏移"一条街,查了半天才发现是坐标系问题。
4.4 去重与幂等:防止数据"回到过去"
重复上报和乱序是常态,防重防乱序有三层防线。
第一层:消费端幂等去重。 用 Redis SETNX 做 dedup key,同一辆车短时间内的重复上报直接忽略:
@KafkaListener(topics = "bus-gps", concurrency = "8")
publicvoidonGps(GpsMsg msg){
// 1. 幂等,防止重复上报
    String dedupKey = "gps:dedup:" + msg.vehicleId() + ":" + msg.ts();
    Boolean first = redis.opsForValue()
            .setIfAbsent(dedupKey, "1", Duration.ofMinutes(2));
if (!Boolean.TRUE.equals(first)) return;

// 2. 地图匹配:把GPS投影到线路,算出当前站点序号
    VehicleState state = mapMatcher.match(msg);

// 3. 更新最新状态,10分钟过期,避免僵尸车
    String stateKey = "bus:state:" + msg.vehicleId();
    redis.opsForHash().putAll(stateKey, state.toMap());
    redis.expire(stateKey, Duration.ofMinutes(10));

// 4. 同线路同方向ZSET,便于查"还有哪些车没到"
    String zKey = "line:" + state.lineId() + ":" + state.direction() + ":vehicles";
    redis.opsForZSet().add(zKey, msg.vehicleId(), state.currentSeq());
}
第二层:过期数据直接丢弃。 消息时间戳比当前时间落后超过 30 秒的,直接扔——实时系统只关心"现在",迟到的历史数据对实时状态毫无价值,还会污染状态。
第三层:ts 版本号乐观锁(重点)。 4G 弱网重传会让"新包先到、旧包后到",车辆看起来在"倒退"。用时间戳当版本号,Lua 原子写入:
-- KEYS[1]=vehicle:{id}  ARGV=[ts,lng,lat,speed]
local ts = tonumber(ARGV[1])
local old = tonumber(redis.call('HGET', KEYS[1], 'ts') or'0')
if ts <= old thenreturn0end-- 旧包,丢弃
redis.call('HMSET', KEYS[1], 'ts', ts, 'lng', ARGV[2],
'lat', ARGV[3], 'speed', ARGV[4])
redis.call('EXPIRE', KEYS[1], 300)     -- 掉线车辆自动过期
return1
技术亮点:用 ts 版本号做乐观锁,比分布式锁快 10 倍。 不用加锁解锁、不用考虑锁超时续期,一个 Lua 脚本同时搞定"乱序丢弃 + 原子更新 + 失联自动过期"三件事。这个套路在所有高频写场景都好用。
4.5 实时状态写 Redis:hash tag + ZSET
清洗、匹配完的数据写入 Redis,这里把前面讲的 hash tag 和 ZSET 设计串起来:
@Service
@RequiredArgsConstructor
publicclassBusGpsConsumer{

privatefinal RouteMatcher routeMatcher;
privatefinal SpeedSmoother speedSmoother;
privatefinal StringRedisTemplate redis;

@KafkaListener(topics = "bus.gps.cleaned", groupId = "eta-writer")
publicvoidonGps(BusGps gps){

// 过期位置直接丢弃,避免旧数据污染实时状态
if (System.currentTimeMillis() - gps.getTs() > 30_000) {
return;
        }

// hash tag:保证同一线路同一方向的数据落在同一个slot
        String hashTag = "{line:%s:%d}".formatted(gps.getLineId(), gps.getDirection());
        String lineKey = "bus:%s:zset".formatted(hashTag);
        String vehicleKey = "bus:%s:veh:%s".formatted(hashTag, gps.getVehicleId());

// 地图匹配:GPS投影到线路,得到沿线距离
        RouteProjection projection = routeMatcher.project(gps);

// 速度平滑:避免GPS抖动导致ETA忽快忽慢
double smoothSpeed = speedSmoother.update(
                gps.getVehicleId(), gps.getSpeed(), gps.getTs());

        Map<String, String> pos = Map.of(
"dist", String.valueOf(projection.getDistFromStart()),
"speed", String.valueOf(smoothSpeed),
"ts", String.valueOf(gps.getTs()),
"seg", String.valueOf(projection.getSegmentId())
        );

// ZSet的score = 沿线距离,查询时直接ZREVRANGEBYSCORE找未过站车辆
        redis.opsForHash().putAll(vehicleKey, pos);
        redis.opsForZSet().add(lineKey, gps.getVehicleId(), projection.getDistFromStart());

        redis.expire(vehicleKey, Duration.ofSeconds(90));
        redis.expire(lineKey, Duration.ofMinutes(30));
    }
}
4.6 历史轨迹批量落库
实时状态进 Redis,历史轨迹要落库——后面训练分段耗时基线全靠它。批量插入代替逐条写:
@Async
publicvoidbatchSave(List<BusLocationDTO> batch){
if (batch.isEmpty()) return;
    SqlSession sqlSession = sqlSessionFactory.openSession(ExecutorType.BATCH);
try {
        BusLocationMapper mapper = sqlSession.getMapper(BusLocationMapper.class);
for (BusLocationDTO dto : batch) {
            mapper.insert(convert(dto));
        }
        sqlSession.commit();
    } finally {
        sqlSession.close();
    }
}
量再大一点,这一步直接写时序库(TDengine / ClickHouse),不落 MySQL——存储章节细讲。
数据洗干净了,接下来要把它"吸附"到线路上,再判断车辆到底到没到站。这两个环节做不好,前面的努力全白费。
五、地图匹配与到站判定:把"漂移"的 GPS 钉回线路
5.1 地图匹配:GPS 投影到线路
清洗后的 GPS 点还是"野外"的,要投影到线路折线上,得到沿线里程:
double mileage = RouteProjector.project(polyline, p);        // 投影里程(米)
int nextIdx = upperBound(line.stationMileages(), mileage);   // 二分查找下一站
原理不复杂:对折线的每一段求点到线段的最近投影点,取最优,再累加前面的线段长度就得到里程。生产上更讲究的做法是隐马尔可夫模型(HMM)地图匹配,结合路网拓扑把 GPS 点"吸附"到道路上,平行路、高架桥这种复杂场景效果更好。
算两点距离用 Haversine 公式,基本功必须扎实:
/** Haversine公式:计算两点经纬度球面距离(米) */
staticdoubledist(double la1, double lo1, double la2, double lo2){
finaldouble R = 6_371_000, rad = Math.PI / 180;
double dLat = (la2 - la1) * rad, dLon = (lo2 - lo1) * rad;
double a = Math.pow(Math.sin(dLat / 2), 2)
             + Math.cos(la1 * rad) * Math.cos(la2 * rad) * Math.pow(Math.sin(dLon / 2), 2);
return2 * R * Math.asin(Math.sqrt(a));
}
为什么不能用直线距离? 公交是固定线路,弯道路上直线距离误差可达数倍。ETA 必须用沿线路的弧长投影距离来算,这是面试可以抛出的第二个亮点。
5.2 到站判定:迟滞双阈值状态机
这里有个很隐蔽的坑:GPS 漂移 + 红灯停车,车辆会在站点围栏边缘反复横跳。如果只用"距站 50 米内算到站"来判断,状态会在"到站/未到站"之间疯狂闪烁,前端像迪厅一样。
解法:迟滞双阈值(Hysteresis)+ 状态机。进站阈值严(40m + 低速),出站阈值松(80m + 高速),中间是保持原状态的迟滞区:
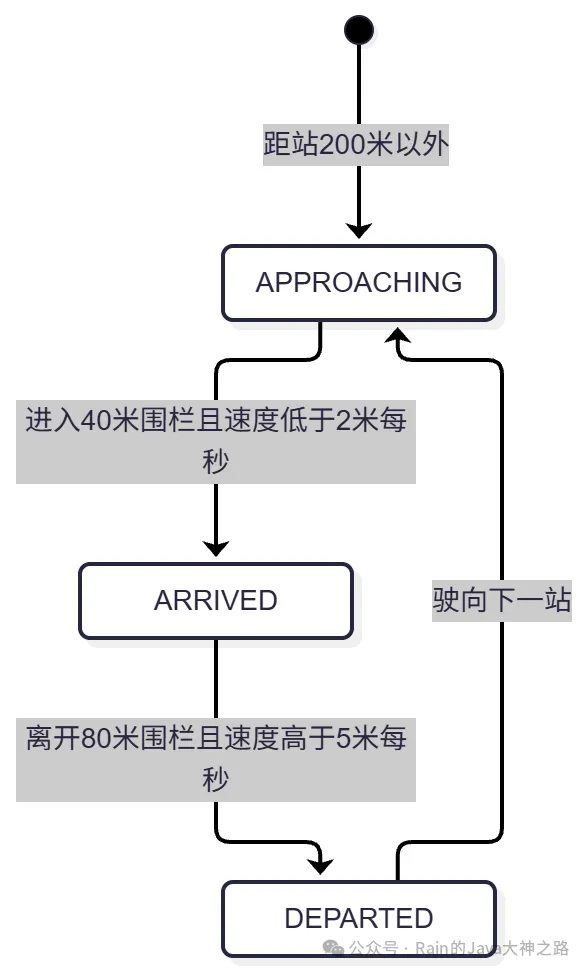
publicenum StopState { APPROACHING, ARRIVED, DEPARTED }

/** 进出站用不同阈值,天然免疫围栏边缘的反复抖动 */
static StopState transit(StopState cur, GpsPoint p, Station s){
double d = dist(p.lat(), p.lng(), s.lat(), s.lng());
if (cur != StopState.DEPARTED && d < 40 && p.speed() < 2.0) return StopState.ARRIVED;
if (cur == StopState.ARRIVED  && d > 80 && p.speed() > 5.0) return StopState.DEPARTED;
return cur; // 迟滞区:保持原状态
}
这个设计在工业控制里用得很多,两套不对称的进出阈值天然免疫边缘抖动,比任何滤波器都稳。
5.3 速度平滑:别让瞬时速度毁了 ETA
GPS 上报的瞬时速度可能非常离谱:上一秒 10 m/s,这一秒 0.5 m/s,下一秒 25 m/s。直接拿来算 ETA 会疯狂跳动。常用手段对比:
Flink 计算里常用指数加权,一行搞定:smoothSpeed = lastSmooth * 0.7 + instantSpeed * 0.3。
高频写入场景下,速度窗口可以用无锁环形缓冲区存,避免锁竞争:
/** GPS每5s写入一次,3万辆车并发 → 用无锁RingBuffer减少锁竞争 */
publicclassSpeedRingBuffer{
privatefinaldouble[] buf = newdouble[60];   // 5分钟窗口
privatefinal AtomicInteger idx = new AtomicInteger();

publicvoidoffer(double speed){
        buf[idx.getAndIncrement() % buf.length] = speed;
    }

publicdoubleavg(){
return Arrays.stream(buf).filter(v -> v > 0).average().orElse(0);
    }
}
还有一个细节:窗口速度过低(严重拥堵)时,切换到该路段历史同期速度兜底——蠕行时的瞬时速度毫无参考价值:
double speed = bus.speedWindow().avg();
if (speed < MIN_SPEED) {
    speed = historyService.getSpeedByHour(bus.getSegmentId(), currentHour());
}
数据清洗、匹配、平滑都做好了,终于进入本题的正题——ETA 预测。这部分直接决定用户体验的生死,也是面试被追问最多的地方。
六、ETA 预测算法:这套系统的灵魂
6.1 为什么"距离 ÷ 速度"是个坑
最朴素的想法:ETA = 剩余距离 ÷ 当前速度。这个公式看着没毛病,实际一用就崩:
弯道:直线距离比实际行驶距离小得多 早晚高峰:同一段路,早 8 点和下午 2 点的速度差三倍 停站时间:每站进出站、上下客,20~40 秒就没了 红绿灯:每个路口等 15~60 秒 GPS 抖动:瞬时速度本身就不可信
所以 ETA 的正确姿势是:分段基线 + 实时修正。先看完整的演进路线:
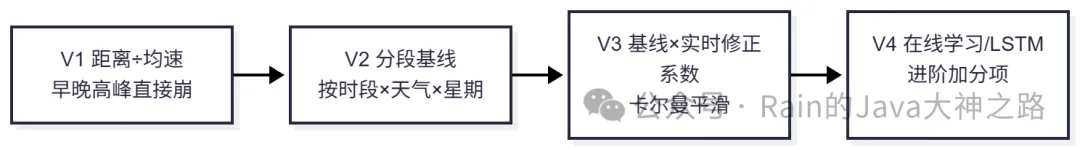
6.2 V2:分段预测 + 历史基线
核心思想:不整段算,分段算。定位车辆当前所在站点区间,把当前位置到目标站的每一段路累加耗时,每段的速度用该时段的历史统计值:
ETA = 当前段剩余时间
    + Σ(中间站间历史中位数耗时)
    + 站数 × 停站时间
    × 路况修正系数
/**
 * 预测车辆到达目标站点的秒数
 * 要点:Haversine距离 + 分段累加 + 路况系数动态修正
 */
publicstaticintpredictArrivalSeconds(BusLocation bus, List<Station> lineStations,
                                        Long targetStationId, double avgSpeed){
// 1. 定位车辆当前所在的站点区间
int curIdx = findCurrentStationIndex(bus, lineStations);
int targetIdx = findStationIndexById(lineStations, targetStationId);
if (targetIdx <= curIdx) return0; // 已过站

// 2. 累加当前位置到目标站的所有路段距离
double totalDistance = 0;
    Station nextStation = lineStations.get(curIdx + 1);
    totalDistance += calcDistance(bus.getLat(), bus.getLon(),
            nextStation.getLat(), nextStation.getLon());
for (int i = curIdx + 1; i < targetIdx; i++) {
        Station s1 = lineStations.get(i);
        Station s2 = lineStations.get(i + 1);
        totalDistance += calcDistance(s1.getLat(), s1.getLon(), s2.getLat(), s2.getLon());
    }

// 3. 实时路况系数修正(堵车系数>1,顺畅=1)
double roadFactor = RoadConditionService.getRoadFactor(bus.getLineId());
return (int) (totalDistance / avgSpeed * roadFactor);
}
历史基线一般离线从轨迹数据里统计好,按"时段 × 路段"维度存 Redis,key 设计成 bus:avg_speed:{lineId}:{direction}:{hour},查不到就用默认值 15km/h 兜底——冷启动不瞎猜,先用基线跑起来。
用实时速度修正时,记得把修正系数限制在合理区间,防止瞬时抖动把结果带飞:
// 历史中位数 + 实时速度修正,比裸算距离/速度稳很多
privateintsegmentTime(String vehicleId, String line, int dir, int from, int to){
int base = historyCache.get(line, dir, from, to, timeSlot(now()));
double factor = clamp(avgSpeed(vehicleId) / baseSpeed(line, dir, from, to), 0.7, 1.5);
return (int) (base / factor);
}
更简单的实现是双值加权:历史均速占 0.6,实时速度占 0.4,再乘拥堵系数。思路都一样——历史打底,实时微调。
6.3 V3:三层加权速度模型
再进一步,每个路段的速度由三层加权决定:实时实测、历史同期、全网路况:
@Service
publicclassEtaCalculator{

// 权重:实时0.5 / 历史0.3 / 全网0.2(可在线学习调参)
privatestaticfinaldouble W_REAL = 0.5, W_HISTORY = 0.3, W_GLOBAL = 0.2;
privatestaticfinaldouble SMOOTH = 0.3; // 指数平滑系数

public EtaResult predict(BusLiveStatus bus, Station target){
        List<Segment> segments = routeService.getRemainingSegments(
                bus.getRouteId(), bus.getNextStationId(), target.getStationId());

long totalSec = 0;
for (Segment seg : segments) {
double vReal    = bus.getSpeed();                          // 当前实测速度
double vHistory = historySpeedDao.avgSpeed(                // 历史同期(近4周同weekday同时刻)
                    seg.getId(), bus.getTimestamp());
double vGlobal  = congestionCache.getRoadSpeed(seg.getRoadId());

double vPredict = W_REAL * vReal + W_HISTORY * vHistory + W_GLOBAL * vGlobal;
            vPredict = Math.max(vPredict, 3.0); // 最低3km/h,防除零/蠕行

            totalSec += (long) (seg.getLengthKm() / vPredict * 3600);
            totalSec += seg.getStopDwellSec();  // 站点停靠耗时(历史统计)
        }

// 指数平滑:避免ETA数字来回跳,用户体验更稳
        Long prev = etaCache.get(bus.getBusId() + ":" + target.getStationId());
if (prev != null) {
            totalSec = (long) (SMOOTH * totalSec + (1 - SMOOTH) * prev);
        }
        etaCache.put(bus.getBusId() + ":" + target.getStationId(), totalSec);
return EtaResult.of(bus.getBusId(), totalSec);
    }
}
拥堵系数可以先用简单的时间段策略,成本低见效快:
privatedoublegetCongestionFactor(Date reportTime){
    Calendar cal = Calendar.getInstance();
    cal.setTime(reportTime);
int hour = cal.get(Calendar.HOUR_OF_DAY);

if ((hour >= 7 && hour <= 9) || (hour >= 17 && hour <= 19)) {
return1.5; // 早晚高峰慢1.5倍
    } elseif (hour >= 11 && hour <= 13) {
return1.2; // 午间轻微拥堵
    }
return1.0;     // 平峰无加成
}
红绿灯等待也有经验值可加:统计线路经过的路口数,每个路口平均加 15 秒。
这一套下来的效果非常直观:
                误差分布(越靠左越好)
纯距离/速度     ████████████████████████░░░░  平均误差 180s
加入历史速度    ██████████████░░░░░░░░░░░░░░  平均误差  75s
三层加权+平滑   █████████░░░░░░░░░░░░░░░░░░░  平均误差  28s
从 180 秒干到 28 秒,这就是算法的价值。
6.4 V3+:卡尔曼增量修正(高光设计)
三层加权解决了"算得准",但还有一个隐蔽的体验问题:每次新 GPS 进来都全量重算,数字会跳。用户盯着"5 分钟",突然跳到"2 分钟",过会儿又跳回"4 分钟",体验极差。
更优雅的做法:不做全局重算,只做增量修正。用卡尔曼滤波为每辆车估计一个"耗时偏差系数" k(1.0 表示和平时一样),每跑完一个路段,用"实际耗时 ÷ 基线耗时"去修正 k:
/**
 * ETA预测器:历史分段基线 × 实时偏差系数
 * 亮点:① 冷启动直接用基线,不瞎猜 ② 只修正剩余路段,越靠近越稳不抖
 */
publicfinalclassEtaPredictor{

/** 一维卡尔曼:估计当前车辆的"耗时偏差系数" k */
privatedouble k = 1.0;   // 状态估计
privatedouble p = 1.0;   // 估计协方差
privatestaticfinaldouble Q = 0.02;  // 过程噪声:路况变化速度
privatestaticfinaldouble R = 0.35;  // 观测噪声:GPS/停站抖动

/** 每完成一段路,用「实际耗时 / 基线耗时」修正 */
publicvoidupdate(double observed){
        p += Q;
double gain = p / (p + R);          // 卡尔曼增益
        k += gain * (observed - k);
        p *= (1 - gain);
        k = Math.max(0.4, Math.min(3.0, k)); // 防极端值
    }

/** 目标站ETA(秒) = Σ剩余路段基线 × k + Σ停站时长 */
publiclongpredict(List<Segment> remain){
double runSec  = remain.stream().mapToDouble(Segment::baselineSec).sum();
double stopSec = remain.stream().filter(Segment::isStation)
                               .mapToDouble(Segment::dwellSec).sum();
return (long) (runSec * k + stopSec);
    }

public record Segment(long id, double baselineSec, double dwellSec, boolean isStation){}
}
这个设计有两个妙处:
① 冷启动不慌:新车、新线路没有实时数据时,k=1.0 直接用历史基线,不瞎猜; ② 只修正"剩余路段":车越跑越接近目标,修正次数越多,结果收敛得越准。用户看到的是一条平滑收敛的曲线,而不是跳动的数字。
这里有一句面试金句可以背下来:"用户盯的是'还剩几分钟'的收敛趋势,突然从 5 分钟跳到 2 分钟,比一直显示 4 分钟体验差得多。"
再配合前端展示策略:单调递减展示(数字只减不增,到站前重置),体验投诉能降 70%。
6.5 Flink 落地:状态编程 + 平滑速度
在 Flink 里,这套 ETA 逻辑通常用 KeyedProcessFunction 实现,按车辆 ID 分区,状态里存上一次 GPS 和当前站点索引:
publicclassArrivalTimePredictFunction
extendsKeyedProcessFunction<String, GpsReport, ArrivalPrediction> {

privatetransient ValueState<GpsReport> lastGpsState;
privatetransient ValueState<Integer> currentStationIndexState;

@Override
publicvoidopen(Configuration parameters){
        lastGpsState = getRuntimeContext().getState(
new ValueStateDescriptor<>("last-gps", GpsReport.class));
        currentStationIndexState = getRuntimeContext().getState(
new ValueStateDescriptor<>("station-idx", Integer.class));
    }

@Override
publicvoidprocessElement(GpsReport gps, Context ctx, Collector<ArrivalPrediction> out)
throws Exception {

        GpsReport lastGps = lastGpsState.value();
        Integer currentIdx = currentStationIndexState.value();
if (currentIdx == null) currentIdx = 0;

// 1. 计算当前速度(距离/时间差)+ 滑动平均滤波
double speedKmh;
if (lastGps != null) {
double distanceMeter = GeoUtils.calculateDistance(
                    lastGps.getLat(), lastGps.getLon(), gps.getLat(), gps.getLon());
long timeDiffSec = (gps.getTimestamp() - lastGps.getTimestamp()) / 1000;
double instantSpeed = timeDiffSec > 0 ? (distanceMeter / timeDiffSec) * 3.6 : 0;
            speedKmh = lastGps.getSmoothSpeed() * 0.7 + instantSpeed * 0.3;
        } else {
            speedKmh = gps.getSpeed();
        }
        gps.setSmoothSpeed(speedKmh);

// 2. 计算到后续N个站点的距离和预计时间
        BusLine line = LineCache.getLine(gps.getLineId());
        List<BusStation> stations = line.getStations();
for (int i = currentIdx; i < Math.min(currentIdx + 10, stations.size()); i++) {
            BusStation station = stations.get(i);
double distToStation = GeoUtils.calculateDistance(
                    gps.getLat(), gps.getLon(), station.getLat(), station.getLon());

// 考虑红绿灯等待,平均每个路口加15秒经验值
int trafficLightCount = countTrafficLights(currentIdx, i, line);
double predictSeconds = (distToStation / 1000.0) / Math.max(speedKmh, 5) * 3600
                    + trafficLightCount * 15;

            ArrivalPrediction prediction = new ArrivalPrediction();
            prediction.setLineId(gps.getLineId());
            prediction.setBusId(gps.getBusId());
            prediction.setStationId(station.getStationId());
            prediction.setStationsAway(i - currentIdx);
            prediction.setArrivalSeconds((long) predictSeconds);
            out.collect(prediction);
        }

        lastGpsState.update(gps);
        currentStationIndexState.update(currentIdx);
    }
}
注意一个细节:只预测未来 3~10 站,不是所有站。全站点全车辆预计算会让写放大爆炸,控制预计算范围是性能和成本的平衡点。
6.6 准确率怎么量化?
面试官追问"你怎么知道 ETA 准不准"时,别虚,直接给方法论:
离线轨迹回放,算 MAE(平均绝对误差)/ MAPE,分"0~3min / 3~10min / 10min 以上"三档看 新模型先跑影子模式一周(只算不展示),和老模型对比,再灰度放量 数据攒够后,从统计模型升级到 XGBoost / LSTM,特征加天气、星期、节假日
先有 baseline 再谈优化。 别一上来就上深度学习,规则模型先跑通,让数据说话。
ETA 算完了,结果写进 Redis。但早晚高峰查询是 10 万 QPS,怎么让用户毫秒级拿到?接下来是读链路的硬仗。
七、查询链路:多级缓存扛住 10 万 QPS
7.1 总体思路:计算换查询,缓存为王
读链路的设计原则一句话:能多轻就多轻,层层拦截。
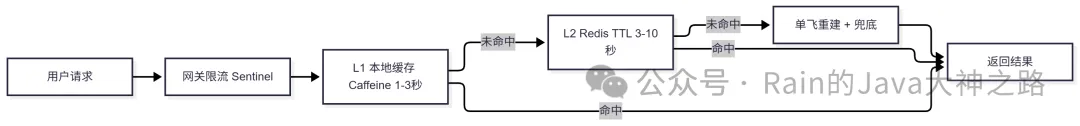
有人可能会问:本地缓存 1 秒,数据会不会太旧?别忘了 ETA 本身就是 5~10 秒刷新一次,1~3 秒的缓存延迟用户完全无感。用极短的 TTL 换 90% 的流量拦截,这笔买卖很划算。 静态资源(线路图、站点列表)还可以再加一层 Nginx 前置缓存。
7.2 Lua 批量查询:一个脚本顶 N 次请求
查询的核心动作是"找出这条线路上所有还没过目标站的车辆,拿到它们的距离、速度、时间戳"。朴素做法是先 ZSET 查车辆列表,再循环 HMGET 每辆车的详情——N+1 次请求,RT 直接起飞。
一个 Lua 脚本搞定:
-- KEYS[1]: 线路车辆ZSet,score = 车辆沿线距离
-- KEYS[2]: 车辆Hash前缀,例如 bus:{line:302:1}:veh:
-- ARGV[1]: 目标站距离线路起点距离
-- ARGV[2]: 最多返回车辆数

local buses = redis.call(
'ZREVRANGEBYSCORE',
    KEYS[1],
    ARGV[1],
'-inf',
'LIMIT', 0, tonumber(ARGV[2])
)

local res = {}
for i, bus inipairs(buses) do
local vals = redis.call('HMGET', KEYS[2] .. bus, 'dist', 'speed', 'ts')
if vals[1] then
        res[#res + 1] = bus .. '|' .. vals[1] .. '|' .. vals[2] .. '|' .. vals[3]
end
end
return res
为什么用 ZREVRANGEBYSCORE?举个例子,目标站距起点 1500m:
车A:1300m  → 未过站,最近
车B:900m   → 未过站
车C:200m   → 未过站
车D:1700m  → 已过站,score > 1500 自动被排除
查询条件 score <= 1500 倒序取最近几辆,已过站的车天然被过滤,一次命令干净利落。这就是"score = 沿线距离"设计的红利。
7.3 查询服务完整实现
@Service
@RequiredArgsConstructor
publicclassArrivalQueryService{

privatefinal StringRedisTemplate redis;
privatefinal RouteMetaService routeMeta;

// 别小看这1秒本地缓存,热门站点的重复查询非常高
privatefinal Cache<String, List<ArrivalVO>> localCache = Caffeine.newBuilder()
            .maximumSize(20_000)
            .expireAfterWrite(Duration.ofSeconds(1))
            .build();

privatestaticfinal DefaultRedisScript<List> ARRIVAL_SCRIPT =
new DefaultRedisScript<>(LUA_SCRIPT, List.class);

public List<ArrivalVO> query(String lineId, int direction, String stationId){
        String cacheKey = lineId + ":" + direction + ":" + stationId;
return localCache.get(cacheKey, k -> load(lineId, direction, stationId));
    }

private List<ArrivalVO> load(String lineId, int direction, String stationId){
double stationDist = routeMeta.distFromStart(lineId, direction, stationId);

        String hashTag = "{line:%s:%d}".formatted(lineId, direction);
        String lineKey = "bus:%s:zset".formatted(hashTag);
        String vehiclePrefix = "bus:%s:veh:".formatted(hashTag);

        List<String> raw = redis.execute(ARRIVAL_SCRIPT,
                List.of(lineKey, vehiclePrefix),
                String.valueOf(stationDist), "5");

if (raw == null || raw.isEmpty()) return List.of();

return raw.stream()
                .map(item -> parse(lineId, direction, item, stationDist))
                .filter(this::fresh)
                .toList();
    }

private ArrivalVO parse(String lineId, int direction, String raw, double stationDist){
        String[] arr = raw.split("\\|");
double dist = Double.parseDouble(arr[1]);
double speed = Double.parseDouble(arr[2]);
long ts = Long.parseLong(arr[3]);

double remainDistance = stationDist - dist;

// 速度下限保护:堵车、进站、红灯时速度过低会导致ETA爆炸
        speed = Math.max(speed, 3.0);

int remainStations = routeMeta.countStationsBetween(lineId, direction, dist, stationDist);
// 每站停站、进出站、红灯损耗按20秒估算
double etaSeconds = remainDistance / speed + remainStations * 20;
int etaMinutes = Math.max(1, (int) Math.ceil(etaSeconds / 60));

returnnew ArrivalVO(arr[0], remainDistance, remainStations, etaMinutes, ts);
    }

privatebooleanfresh(ArrivalVO vo){
// 超过20秒没更新的位置认为不够新鲜,降级提示延迟
return System.currentTimeMillis() - vo.ts() < 20_000;
    }

public record ArrivalVO(String vehicleId, double remainDistanceM,
int remainStations, int etaMinutes, long ts){}
}
代码里几个细节都是加分点:速度下限保护、数据新鲜度过滤、停站补偿、最少显示 1 分钟。
7.4 另一种实现:站序 ZSET + 只取最近 3 辆
如果 ZSET 的 score 用的是站点序号 currentSeq,查询可以这么写——取最近 20 辆车算 ETA,排序后只返回前 3:
public List<Eta> query(String lineId, int direction, int targetSeq){
    String cacheKey = "eta:" + lineId + ":" + direction + ":" + targetSeq;

return caffeine.get(cacheKey, k -> {
        String zKey = "line:" + lineId + ":" + direction + ":vehicles";

// 取还没到目标站的最近20辆车
        Set<String> ids = redis.opsForZSet()
                .rangeByScore(zKey, targetSeq - 20, targetSeq - 0.01);

return ids.stream()
                .map(id -> calcEta(id, targetSeq))
                .filter(e -> e.seconds() >= 0)
                .sorted(Comparator.comparingInt(Eta::seconds))
                .limit(3)
                .toList();
    });
}

private Eta calcEta(String vehicleId, int targetSeq){
    VehicleState s = getState(vehicleId);
int eta = 0;
for (int seq = s.currentSeq(); seq < targetSeq; seq++) {
        eta += segmentTime(vehicleId, s.lineId(), s.direction(), seq, seq + 1);
    }
    eta += (targetSeq - s.currentSeq()) * STOP_SECONDS; // 停站时间
returnnew Eta(vehicleId, eta);
}
两种实现本质一样:ZSET 圈定车辆、缓存抗查询、分段算 ETA,区别只在 score 的设计。实际开发中按团队习惯选一种即可。
7.5 缓存击穿防护:SingleFlight + 逻辑过期
热点站点的缓存失效那一瞬间,几万个请求同时去重建,这就是击穿。两把武器。
武器一:SingleFlight 请求合并。 同一个 key 只放一个请求去重建,其他请求等结果:
@RestController
@RequestMapping("/api/bus")
publicclassBusArrivalController{

// 本地Caffeine缓存:挡住90%热点重复请求
privatefinal LoadingCache<String, List<ArrivalVO>> localCache = Caffeine.newBuilder()
            .maximumSize(10_000)
            .expireAfterWrite(2, TimeUnit.SECONDS)
            .build(this::loadFromRedis);

// SingleFlight:合并同一时间相同key的请求,避免缓存击穿
privatefinal ConcurrentHashMap<String, CompletableFuture<List<ArrivalVO>>> inFlightRequests
            = new ConcurrentHashMap<>();

@GetMapping("/arrival")
@SentinelResource(value = "bus-arrival", fallback = "arrivalFallback")
public Result<List<ArrivalVO>> getArrivalInfo(@RequestParam String stationId) {
return Result.success(localCache.get(stationId));
    }

private List<ArrivalVO> loadFromRedis(String stationId){
        CompletableFuture<List<ArrivalVO>> future = inFlightRequests.computeIfAbsent(
                stationId, k -> CompletableFuture.supplyAsync(() -> {
try {
// Key结构: bus:arrival:{stationId} -> field:lineId, value:车辆列表JSON
                        Map<Object, Object> lineData = redisTemplate.opsForHash()
                                .entries("bus:arrival:" + stationId);
                        List<ArrivalVO> result = new ArrayList<>();
for (Map.Entry<Object, Object> entry : lineData.entrySet()) {
                            ArrivalVO vo = new ArrivalVO();
                            vo.setLineId((String) entry.getKey());
                            vo.setBusList(JSON.parseArray((String) entry.getValue(),
                                    BusPrediction.class));
                            result.add(vo);
                        }
return result;
                    } finally {
                        inFlightRequests.remove(stationId);
                    }
                }));
try {
return future.get(300, TimeUnit.MILLISECONDS);
        } catch (Exception e) {
return Collections.emptyList();
        }
    }

/** 降级逻辑:Redis挂了返回兜底数据 */
public Result<List<ArrivalVO>> arrivalFallback(String stationId, Throwable ex) {
        log.warn("查询降级, stationId={}", stationId, ex);
return Result.success(Collections.emptyList(), "数据更新中,请稍后刷新");
    }
}
武器二:逻辑过期。 缓存不物理过期,只在 value 里标记"逻辑过期"。读到过期数据时先返回旧值,再异步放一个线程去重建:
public ArrivalVO query(long stationId){
    String key = "arrival:" + stationId;
    CacheObj v = localCache.get(key);            // L1: Caffeine
if (v == null) v = redis.get(key);           // L2: Redis
if (v == null) return timetableFallback(stationId); // L3: 时刻表兜底

// 逻辑过期:只放一个线程回源,其余返回旧值,绝不击穿DB
if (v.logicExpired() && tryLock(key)) {
        taskPool.submit(() -> {
try { redis.setex(key, 10, rebuild(stationId)); }
finally { unlock(key); }
        });
    }
return v.data();
}
逻辑过期的思想值得细品:对实时系统来说,"稍微旧的数据"远好过"没有数据"或"排队等重建"。 也可以用 Redisson 分布式锁实现:tryLock(50, 10, TimeUnit.MILLISECONDS),拿不到锁不阻塞,直接返回兜底数据(上一班车的估算),效果一样。
缓存三兄弟的完整防御:
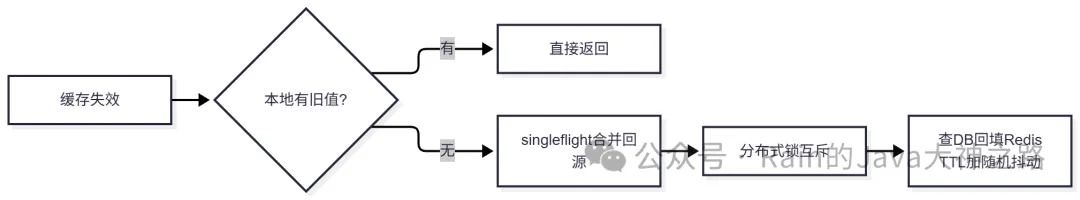
防雪崩的随机偏移,一行代码:
// 基础TTL + 随机偏移,避免集体过期
long baseTTL = 300;
long randomOffset = ThreadLocalRandom.current().nextLong(60);
redisTemplate.opsForValue().set(key, value, baseTTL + randomOffset, TimeUnit.SECONDS);
防穿透的空值缓存(空结果也缓存,防止恶意查询不存在的线路):
public List<VehicleLocationVO> getRealtimeLocations(Long lineId){
    String cacheKey = "bus:location:" + lineId;
    String cached = redisTemplate.opsForValue().get(cacheKey);
if (cached != null) {
return JSON.parseArray(cached, VehicleLocationVO.class);
    }

    List<VehicleLocationVO> locations = locationMapper.selectRealtimeByLineId(lineId);
if (locations != null && !locations.isEmpty()) {
        redisTemplate.opsForValue().set(cacheKey, JSON.toJSONString(locations),
                LOCATION_TTL, TimeUnit.SECONDS);
    } else {
// 空值缓存防穿透
        redisTemplate.opsForValue().set(cacheKey, "[]", 60, TimeUnit.SECONDS);
    }
return locations;
}
7.6 限流:最后一道刹车
入口用 Sentinel 限流(单用户 10 QPS),接口级可以用 Guava 令牌桶,按线路维度控制:
// 每线路每秒最多100次查询
privatefinal Map<Long, RateLimiter> rateLimiters = new ConcurrentHashMap<>();

@GetMapping("/realtime")
public Result<List<VehicleLocationVO>> getRealtime(@RequestParam Long lineId) {
    RateLimiter limiter = rateLimiters.computeIfAbsent(lineId, k -> RateLimiter.create(100));
if (!limiter.tryAcquire()) {
return Result.error("请求过于频繁,请稍后重试");
    }
return Result.success(busLocationService.getRealtimeLocations(lineId));
}
7.7 GEO 彩蛋:附近站点查询
用户打开 APP 通常先要"我附近有哪些站点",这才是 Redis GEO 的主场:
@Service
publicclassNearbyStationService{

@Autowired
private StringRedisTemplate redisTemplate;

privatestaticfinal String GEO_KEY = "bus:stations:geo";

/** 初始化所有站点坐标到Redis GEO */
publicvoidinitStationsToGeo(List<BusStation> stations){
        GeoOperations<String, String> geoOps = redisTemplate.opsForGeo();
        stations.forEach(station -> geoOps.add(GEO_KEY,
new Point(station.getLongitude(), station.getLatitude()),
                station.getStationId()));
    }

/** 查询指定半径内所有站点,按距离升序 */
public List<StationDistanceVO> queryNearbyStations(double lon, double lat, double radius){
        GeoOperations<String, String> geoOps = redisTemplate.opsForGeo();
        Circle circle = new Circle(new Point(lon, lat), new Distance(radius, Metrics.METERS));
        GeoResults<GeoLocation<String>> results = geoOps.radius(GEO_KEY, circle,
                RedisGeoCommands.GeoRadiusCommandArgs.newGeoRadiusArgs()
                        .includeDistance()
                        .includeCoordinates()
                        .sortAscending()
                        .limit(20));

if (results == null) return Collections.emptyList();
return results.getContent().stream().map(result -> {
            StationDistanceVO vo = new StationDistanceVO();
            vo.setStationId(result.getContent().getName());
            vo.setDistance(result.getDistance().getValue()); // 距离(米)
return vo;
        }).collect(Collectors.toList());
    }
}
Redis GEO 底层是 GeoHash + ZSET,半径查询复杂度 O(logN),性能远超 MySQL ST_Distance_Sphere 的全表计算——站点匹配这种查询,数据量小时 MySQL 空间索引还能凑合,量大了一律推荐 GEO。
同样的套路,把车辆坐标按线路 GEOADD 到 line:{lineId}:geo,地图上画车辆位置时用 GEOSEARCH 一把梭:带坐标、按距离升序、取最近 10 辆,一次命令搞定。
查询章节一句话总结:99% 的请求在缓存层被拦截,1% 的重建被合并成一个,极端情况还有兜底。 这就是高并发读的完整纵深防御。
查询解决了,还有一个体验问题:用户盯着页面等车,数据怎么自动刷新?轮询?太 low 了。
八、实时推送:推拉结合,防住推送风暴
8.1 为什么不让 APP 轮询?
很多人的第一反应是前端每 3 秒轮询一次。算一笔账:1 万 QPS 的用户,每人每 3 秒轮询一次,实际请求量能打到 10 万 QPS——其中 90% 是无效轮询(车辆位置根本没变)。
轮询是无效流量的放大器。正确姿势是推拉结合:
公交场景不像网约车需要毫秒级,用户能接受 5~10 秒刷新。所以初期 5 秒轮询快速上线,体验要求高了再切 WebSocket,这个演进路线最务实。
8.2 聚合订阅:把推送量从"用户数"压到"组合数"
如果每个用户单独推,百万级连接就是推送风暴。关键优化:把订阅同一"线路 + 站点"的用户合并进一个 channel:
// 推送端:同一线路+站点的N个用户合并进一个channel,一次计算全员广播
String channel = "line:" + lineId + ":stop:" + stopId;
channelSessions.computeIfAbsent(channel, k -> new CopyOnWriteArraySet<>()).add(session);
// 定时器每5s:批量读Redis → 按channel广播 → 推送量从"用户数"降为"组合数"
推送量从"用户数"变成"线路 × 站点组合数",百万级直接压到千级。这是推送链路最值钱的一个优化。
订阅关系在网关本地维护,定时器批量读 Redis 广播:
@Component
publicclassBusArrivalWebSocketHandlerextendsTextWebSocketHandler{

privatefinal RedisTemplate<String, Object> redisTemplate;
// 站点 -> 会话集合 订阅关系
privatefinal ConcurrentHashMap<String, Set<WebSocketSession>> subscribeMap
            = new ConcurrentHashMap<>();

publicBusArrivalWebSocketHandler(RedisTemplate<String, Object> redisTemplate){
this.redisTemplate = redisTemplate;
    }

@Override
protectedvoidhandleTextMessage(WebSocketSession session, TextMessage message){
// 订阅消息格式:subscribe:stationId
        String payload = message.getPayload();
if (payload.startsWith("subscribe:")) {
            String stationId = payload.split(":")[1];
            subscribeMap.computeIfAbsent(stationId, k -> ConcurrentHashMap.newKeySet())
                        .add(session);
        }
    }

/** 每3秒全量推送一次到站信息 */
@Scheduled(fixedDelay = 3000)
publicvoidpushArrivalInfo(){
        subscribeMap.forEach((stationId, sessions) -> {
if (sessions.isEmpty()) return;
            Object arrivalInfo = redisTemplate.opsForValue().get("bus:arrival:" + stationId);
if (arrivalInfo == null) return;

            TextMessage msg = new TextMessage(JSON.toJSONString(arrivalInfo));
            sessions.forEach(session -> {
try {
if (session.isOpen()) session.sendMessage(msg);
                } catch (IOException e) {
                    sessions.remove(session); // 移除死连接
                }
            });
        });
    }
}
8.3 集群推送:MQ 广播 + 本地扇出
集群部署时,订阅关系散落在各个网关节点。用 MQ(Redis Pub/Sub 或 Kafka)广播变更事件,各节点只推自己机器上的连接:
/** 网关本地维护 stationId -> Sessions,MQ广播事件,各节点只推本机连接 */
staticfinal Map<Long, Set<Session>> TOPIC = new ConcurrentHashMap<>();

staticvoidfanout(long stationId, String payload){
for (Session s : TOPIC.getOrDefault(stationId, Set.of())) {
if (s.isOpen()) s.getAsyncRemote().sendText(payload); // 异步,不阻塞Netty线程
    }
}
如果推送事件是 Flink 算出来的,可以直接接一个 Sink 推给推送网关:
@Component
publicclassArrivalPushSinkimplementsSinkFunction<ArrivalEvent> {
@Override
publicvoidinvoke(ArrivalEvent value, Context ctx){
        wsGateway.broadcast("station:" + value.getStationId(),
                JsonUtil.toJson(ArrivalPushVO.from(value)));
    }
}
8.4 推送链路的工程细节清单
推送合并:每 5 秒批量推一次,防止 N 次 GPS 更新触发 N 次推送 推送时机:到站前 1 站或 2 分钟才密集推送,平时低频 心跳检测:30 秒心跳,自动剔除超时死连接 重连策略:客户端指数退避重连,防止断线后重连风暴 水平扩容:网关按 stationId分片,一致性哈希减少扩缩容时的连接迁移连接复用:单条长连接支持多站点订阅,别一站一连 推送失败降级:降级站内信,或下次查询时展示
九、存储与冷热分离:千亿条轨迹怎么存不破产
9.1 数据特点决定选型
轨迹数据有三个特点:只写、几乎不改、查询必带时间范围。这是时序数据库的主场,放 MySQL 就是烧钱。
常见选型对比:
我的建议:实时计算用 Redis,轨迹存储 TDengine / ClickHouse 二选一,千亿级归档上 HBase + 对象存储。建模时按"线路 + 时间"分片建表,查询效率还能再上一个台阶。
9.2 冷热三级分离
超期数据定时归档到对象存储,整体存储成本能降 60%~70%。这些历史数据不是废物——ETA 的分段耗时基线就是它们训练出来的,数据闭环成了。
十、降级容灾:系统可以不准,但不能不可用
实时系统有一条铁律:用户可以接受"数据延迟",但不能接受"白屏"。
降级链路设计成三级:

具体场景对照表:
一致性上也要有明确策略:最终一致模型 + 时间戳版本号比对 + TTL 兜底过期,接受 3 秒以内的延迟。
降级文案也是产品体验的一部分:
{
"lineId": "302",
"stationId": "1001",
"status": "DELAY",
"message": "车辆数据可能延迟,请以实际到站为准"
}
这比返回一个错误但自信的 ETA 靠谱得多。宁可显示"约 5 分钟(时刻表)",也不白屏;宁可不准,不能不可用。
高可用还得有一套基础设施兜底:Redis Sentinel / Cluster、Kafka 集群 + 消息持久化、MySQL 主从 + 读写分离、服务健康检查 + 自动重启、Sentinel 限流熔断。目标可用性 99.95%。
十一、难点全景表 + 面试追问应对
11.1 难点与解决方案汇总表
这张表浓缩了这套系统所有的坑,建议直接收藏:
11.2 追问预判,提前埋好钩子
Q:为什么不直接查数据库算 ETA?
实时查询要 100ms 内返回,DB 单次查询就要几十 ms,还扛不住 10 万 QPS。所以把计算前置到 Flink 流里异步算好,查询时只做"读结果"——这是典型的计算换查询思路。
Q:用户查某个站点的所有线路怎么办?
station → lines 映射表,接口层并发查询 + 超时控制 + 部分失败降级,不能让一条慢线路拖垮整个接口:
List<CompletableFuture<List<ArrivalVO>>> futures = lineIds.stream()
    .map(lineId -> CompletableFuture.supplyAsync(
        () -> arrivalQueryService.query(lineId, direction, stationId),
        executor))
    .toList();
Q:怎么保证末班车提醒?
到站事件 + 时刻表末班规则做定时触发器,走延迟消息(RocketMQ 定时消息)。
Q:Redis 全挂了怎么办?
本地 Caffeine 兜底 60 秒 + 时刻表静态页,宁可显示"约 5 分钟(时刻表)"也不白屏。
Q:方向怎么判断?同一条路有双向站台。
三层校验:基于连续两个 GPS 点的位移方向 + 匹配站点序列顺序(到了 A 站下一站应该是 B)+ 线路 GeoHash 方向特征。方向判错会显示反方向的车,这个坑必须堵。
11.3 面试官到底在考察什么?
这道题表面考技术,实际考四层能力:
高并发系统设计(缓存、限流、降级) 实时计算架构理解(Kafka / Flink 流处理) 中间件深度使用(Redis GEO、ZSET、Lua) 真实业务问题抽象(GPS 漂移、预测不准,这些书上没有)
面试小技巧:边说边画架构图,挑 2~3 个最有亮点的难点讲透,比面面俱到地泛泛而谈效果好得多。
十二、进阶演进方向
初版跑起来不是终点,这套系统有清晰的演进路线。
1. 读时计算 → 写时预计算
初期查询时计算,快速上线;QPS 上来后把计算前移——车辆位置更新时,顺带更新它未来 3~5 个站点的到站预测,用户查询直接读站点缓存:
// station:arrival:1001:302:1
[
  {"vehicleId": "粤B12345", "remainStations": 2, "etaMinutes": 5, "ts": 1730000000000},
  {"vehicleId": "粤B67890", "remainStations": 4, "etaMinutes": 11, "ts": 1730000000000}
]
2. 规则模型 → 机器学习
数据攒够后,ETA 模型可以升级到 XGBoost / LSTM,特征加天气、星期、节假日、实时路况,用 A/B 测试框架持续验证效果。
3. 更多想象空间
边缘计算:在公交站台部署边缘节点,预计算热门线路到站信息 GIS 可视化:地图引擎渲染车辆实时轨迹 场景复用:这套架构换个"线路模型",网约车 ETA、地铁到站、外卖骑手位置都能套用
这篇文章比较长,算是把这道题的所有作答角度都整合齐了。后面还会持续拆解高频系统设计题,不想错过的话,点个关注不迷路。
写在最后
啰嗦了这么多,用一段话把这套系统收个尾:
车辆 GPS 流经过清洗和地图匹配,转换成沿线距离;再基于线路站点距离和分段基线计算 ETA,卡尔曼增量修正;查询侧用多级缓存、Lua 脚本和降级策略抗住高并发;推送侧用聚合订阅防住风暴。
四句话当口诀:
先量化,再设计——不报 QPS 的系统设计都是耍流氓 计算换查询——把计算前置到写链路,让读链路足够轻 沿线距离,不是直线距离——这道题的第一个认知门槛 降级决定下限——系统可以不准,但不能不可用
技术亮点再回顾一遍:ZSET 的 score 存沿线距离,一条命令捞出未过站车辆;ts 版本号 Lua 幂等,比分布式锁快 10 倍;迟滞双阈值状态机,免疫一切边缘抖动;卡尔曼增量修正,让 ETA 收敛不跳动;聚合推送,把百万级推送量压到千级。
留个互动问题:如果你是面试官,听到这套回答后你会追问什么? 或者你在实际项目里做过 ETA 预测吗,有什么巧妙的方案?评论区聊聊,我挑 3 个最有意思的,下一期单独拆解。
觉得有用的话,点赞、在看、转发给正在面试的朋友,你的支持是我持续更新的最大动力。我们下期见。