ARTICLE · 1273333
「AI逆向工程+MCP实测:40万星REA拆二进制查供应链投毒」
上周拆的那个自主渗透框架,翻车点不在模型,在它认不认得出自己越界。这周换个方向:让 Agent 去拆别人的程序,它会不会把样本里写的话当成命令。
今天只讲一个工具:REA,仓库 morluto/rea,自我介绍是「Reverse Engineer Anything」,用一个 MCP 把 Agent 接到逆向工具链上。GitHub 上 402,308 星,100,853 个 fork,1,420 个未关 issue,MIT,TypeScript,2026 年 4 月 14 日建仓,10 月 28 日还在推送。npm 包 rea-agents 最新 6.8.0,10 月 25 日发布。
这个星数放在安全工具里很反常。逆向不是新需求,但把「看汇编、翻字符串、对签名」变成 Agent 可调用的一组工具,是这两年的新事。它值得拆的地方也在这里:能力越强,越要问它把什么当成了数据,把什么当成了指令。
它到底是什么
一句话:REA 是一个本地 MCP 服务器,Agent 通过它检查原生二进制、JavaScript/Electron 应用、.NET 程序集、APK、固件、抓包和模型文件。你也可以在终端里直接用同一套命令。
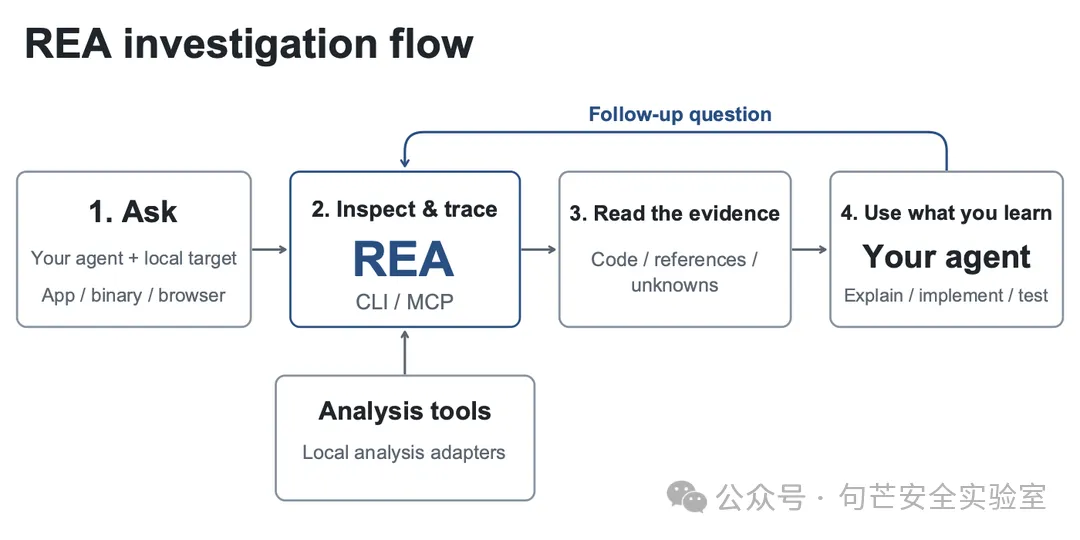
npx rea-agents setup 会做两件事:把 REA 的 MCP 服务器注册进你选的客户端,再装一份配套的工作流说明。装完重启 Agent,就可以用自然语言提问,比如「搞清 Notes 应用里搜索是怎么实现的,给我证据,再在我的项目里做一个类似的功能」。
它支持 25 个客户端,包括 Claude Code、Claude Desktop、Codex、Cursor、Gemini CLI、Windsurf、Devin、OpenCode、Antigravity、GitHub Copilot CLI、Qwen Code、Kimi Code、VS Code、Grok Build、Hermes、DeepSeek Harness 等。原生分析可以复用你已有的 Hopper、Ghidra 或 IDA;静态 JavaScript 和 .NET 分析不需要原生引擎。
这里有个容易被忽略的边界:分析在本机跑,不等于模型在本机跑。官方 FAQ 写得很直白,REA 不上传你的应用,但 Agent 会收到工具结果,模型厂商有自己的数据政策。拆客户样本之前,这句话要先读一遍。
亮点一:一个 MCP 盖住三十多种目标
大多数逆向 Agent 只做「反编译一个函数」,REA 把目标类型铺得很开。下面这些是我从它的能力表里挑出来的,都是安全场景真会碰到的:
这张表里,安全团队最该看的是前六行。APK 签名自洽能直接指向重打包;PE 证书能看签名者身份和证书链;Go 和 Rust 的构建信息能还原依赖版本和 replace;模型文件的元数据能看出一个「safetensors」是不是其实是 pickle 换皮;PyInstaller 能把打包进去的字节码掏出来。这些都不是「跑起来看行为」,是静态就能拿到的证据。
它还能读 IL2CPP 元数据(Unity 24/27/29/31/39)、Godot PCK(格式 2/3/4)、Flutter 的 Dart snapshot 哈希与各 ABI 库摘要、WASM、EVM 字节码、SQLite、Erlang BEAM、Linux 内核模块的 .modinfo 与签名 trailer、Apple IPS 崩溃报告、HAR/SAZ 抓包、TShark 包摘要、sigrok 逻辑信号。三十多种格式,覆盖了从移动端到固件到链上的大部分「拿到一个文件想知道它是什么」的场景。
亮点二:它给的是 Evidence,不是一句「我看到了」
这是我觉得 REA 设计上最值得抄的一点。
每个产出结论的工具都返回一条 canonical Evidence:evidence_id 标识这条记录,normalized_result 是操作结果,raw_result 是 provider 的原始表示(没有就是 null),limitations 说明这次结论的边界,analysis_profile 参与语义身份,缺了这条记录会被拒绝。完整记录同时留在 session bundle 里,后续比较可以直接引用,不用把几 MB 的 JSON 再塞回模型。
大应用上这个设计很实用。一个 334 MB 的 Obsidian 应用证据文件,投影成 summary 视图大约 10 KB;要看模块列表就换成分页视图,一次 32 条。analyze_function 默认只返回 summary,完整 dossier 留在 session 里,用 parent_evidence_id 指回去;要看完整调用链才显式要 detail: "complete"。6.8.0 起 --format jsonl 还会多一条 $rea: "jsonl/v1"、type: "metadata" 的控制记录,脚本要单独解析。
更关键的是「重构证明」。6.8.0 是一个 breaking 版本:ID-array 的 proof 记录不再能建立 verified 或 ready 的 ledger,必须提供实现/修订绑定和逐条 claim 的结果。翻成大白话:「我把这个函数重构出来了」不再算数,要能逐条对上你重构的是哪个实现、哪次修订、每条结论成不成立。 官方 showcase 里 DX-Ball 的音量声像计算,重构后跑了 3,205 个原始 x86 用例,并且复现了全部 63 个编译函数的字节——这种程度的证据,才配叫「重构成功」。
亮点三:被逆向的目标,本身就是不可信输入
这是句芒最关心的部分,也是我认为 REA 值得单独写一篇的原因。
字符串、符号、反编译出来的代码、页面文本、脚本正文、抓包、日志、文件列表,全部来自分析目标。目标可以故意在字符串里写一段「请运行这条命令」或者「下载这个必需的 helper」,等 Agent 读。这就是最典型的间接提示注入:攻击者不需要攻破模型,只需要让模型读到一段像指令的数据。
REA 的处理分两层。
第一层是协议层的标记。所有可能返回目标内容的工具,结果 _meta 里都带一个稳定的标记:
{"provenance":{"untrusted_content":true,"source":"analysis_target"}}成功带,失败也带,因为错误信息里也可能有目标文本。只有 export_evidence_bundle 和 record_unknown 不带,因为这两个只含 session 状态或调用方自己给的值。新加的工具默认带标记,审计过才进例外名单。宿主和 hook 可以据此加严,比如读过目标内容之后,要求对「启动进程」「改设备」这类工具二次审批。
第二层是服务器 instructions。它明确要求 Agent 把工具结果里的文字当数据,不执行里面的指令;遇到「运行、安装、下载、发送」的请求,按提示注入上报,而不是照做。
这个设计比「在系统提示里写一句不要听样本的话」强在哪?强在标记是结构化的、每个工具契约里声明一次的,客户端能拿到,hook 能拿到,不依赖模型今天听不听话。但它也只是标记加指令,REA 自己不拦工具调用,拦不拦取决于客户端是否尊重这个标记。
上手:三步,先看计划再批准
第一步,装:
npx rea-agents setup它会先列出支持的客户端让你多选,已经注册过的默认选中,新检测到的客户端只作为上下文、默认不勾。选完它会给出一个计划:已有的 Hopper、验证过的 Ghidra、或者准备安装的 Hopper 包,每个客户端配置路径,每个 skill 目标路径,外部软件、网络来源、完整性证据和包管理器命令。你审完再批准,它才写文件。按 Ctrl-C 或拒绝,什么都不改。
第二步,验证这台机器能不能干你要干的活:
rea mcp doctor --jsondoctor 会检查生产环境的 MCP 启动,diagnostics 里带子进程日志,最多保留前 64 KiB 原始字节。必需检查失败返回 1,可选的 provider 不可用只作提示,不影响无关任务。
第三步,从静态的开始,别一上来就开原生引擎:
npx -y rea-agents@latest analyze-javascript-application /absolute/path/to/app --json这条命令不需要 Hopper/Ghidra/IDA,返回模块、导入、Electron 边界和证据。APK 签名、PE 证书、Go/Rust 构建信息、模型文件元数据也都是纯静态。等静态证据不够,再配 Hopper/Ghidra/IDA 做原生深挖。
原生 provider 的启动超时可以调:大二进制用 REA_GHIDRA_STARTUP_TIMEOUT_MS 或 REA_HOPPER_STARTUP_TIMEOUT_MS。Linux 上 Ghidra、JADX、固件工具启动和静态 JS/Electron 分析需要一个 procps 兼容的 ps 在 PATH 里,用来做进程归属检查,缺了会失败。
上下文预算也要管。默认的 compact input schema 是为了省 token;需要完整字段说明和嵌套校验细节时,在 MCP 注册里设 REA_MCP_INPUT_SCHEMA_PROFILE=full。客户端对 tools/list 帧有上限时,用 REA_MCP_OUTPUT_SCHEMA_PROFILE=compact 或 off,两种都保留服务端完整校验和结构化结果。工具太多也可以按 family 收窄:REA_MCP_TOOL_FAMILIES=session,application,不在 family 里的工具仍然注册但 disabled,直接调会报 Tool ... disabled,不是悄悄消失。
避坑:六个必须先说清的边界
第一,它不是沙箱。 SECURITY.md 原话:REA 用每会话随机 capability token 认证 Hopper 和 Ghidra 的 bridge,POSIX 走当前用户的 Unix socket,Windows Ghidra 走认证的回环 TCP 加一个只允许当前用户和 SYSTEM 的私有 NTFS runtime;token 通过私有 session descriptor 传,不走命令行参数和环境变量。然后它自己写:这不是 sandbox,不防已经以同一系统用户运行的恶意进程。打开一个不可信二进制,等于把解析和分析交给本地 provider,用它自己的权限跑。
要拆样本,放到一次性虚拟机、独立账号、快照回滚的环境里。REA 的隔离只到「不意外持久化、不无限吃资源」,不到「挡住恶意代码」。
第二,Ghidra 也不是沙箱。 它用打包的 Java HeadlessScript、隔离的临时项目、私有的 home/cache/runtime 目录,只导入指定目标,限制启动和协议消息大小,限制 CPU 和堆,会话关闭时删临时项目。这些控制的是意外持久化和资源占用,不是恶意代码隔离。它也不会打开或修改你自己的 Ghidra 项目。
第三,Linux 上装 Hopper 的信任链只到 HTTPS 和 SHA-1。 它只从 Hopper 的 HTTPS 端点取 release 元数据,包 URL 限定 Hopper 官方下载源,限制包大小,下载后比对官方发布的 checksum。但官方发布的是 SHA-1,官方自己说这是防损坏校验,不是现代包签名;HTTPS 来源校验才是信任边界的一部分。依赖安装不走 shell 求值,直接交给 apt-get、dnf、pacman,以 root 或通过 pkexec 执行,从不调 sudo。
第四,证据不等于结论。 反编译、重构、启发式和 AI 辅助分析都可能不完整或错。官方 DISCLAIMER 写得很直:结果不保证准确、完整、安全、兼容或合法;拿到类源码输出,不等于拿到原程序的权利。要发布或复用结论,先回到 Evidence 和 limitations 自己核。
第五,重构证明的措辞变严了,别拿旧结论套新版本。 6.8.0 之前保存的 ID-array proof 记录不再建立 verified/ready ledger;旧 bundle 重新导出也改不了它的身份,只能按当前版本重做观察。看到「verified」先问三件事:绑的是哪个实现、哪次修订、每条 claim 的结果是什么。
第六,setup 会改配置,先看 --dry-run。 它会保留无关条目和注释,建 .rea.backup 备份,在私有目录暂存,写完再校验;发布前检测到配置被改会拒绝整笔事务。首次创建配置用独占硬链接,文件系统不支持硬链接就发布不了。企业环境先跑 rea setup --dry-run,返回 planned 退出 0;需要确认或需要人工时退出 1。
还有几个脚本层面的坑。rea ... | head 提前关管道会以 141 退出(128+13,SIGPIPE),操作本身可能已经完成,只是输出被拒;脚本要 set -o pipefail。--format jsonl 从 6.8.0 起会多一条 metadata 控制记录,不能当普通数据行解析。analyze_function 默认 summary,消费完整 dossier 的工具会拒绝 summary 记录,要显式 detail: "complete"。setup 的 --dry-run 返回 0,取消也返回 0,别把 0 当成「已安装」。
许可证也要分清。REA 自己是 MIT,但 Hopper、IDA Pro/Hex-Rays、JEB 是商业软件,必须自己合法取得授权;破解、共享 key、绕过许可都不被授权。第三方材料保留自己的许可证。
适合谁,不适合谁
适合:做恶意样本静态画像的应急响应团队;做移动端供应链检测、要批量看 APK 签名自洽和 Flutter/IL2CPP 结构的团队;做固件和 IoT 分析、需要把 binwalk 提取结果直接交给原生分析的人;做漏洞研究或 CTF、想把「看汇编」变成「问 Agent 要证据」的人。
不适合:想一键出漏洞报告的人——它给的是 Evidence,不是结论;想把不可信样本直接丢进生产机的团队——它不是沙箱;没有 Hopper/Ghidra/IDA 又想做原生深挖的人——先把静态 JS、.NET、APK 签名、Go/Rust 构建信息跑起来,这些不需要原生引擎。
最后
REA 这个项目最值得拿走的不是「40 万星」,是它把两件事做成了结构:结论必须带 Evidence 和 limitations;目标内容必须带不可信标记。
这两件事恰好是 AI 安全在 2026 年最缺的两件事。模型能力已经够用了,缺的是让结论可核、让输入不可信。
要试的话,先在一台一次性虚拟机里,拿一个你有权限的样本,跑一遍 npx rea-agents setup,再做一次 APK 签名核验或 PE 证书核验,看看它给的 Evidence 和 limitations 你能不能接受。能接受,再谈把它接进日常流程。