ARTICLE · 1273345
AI 助手不收你的钱,它收的是你的思考方式
9月8日之后,所有人都在吵同一件事:OpenAI 到底有没有偷。吵了两周没结果,因为这个问题本来就答不了。
我倒是觉得,真正该看的不是那句指控,是 OpenAI 自己写进声明里的一句话——他们不能完全排除,两位数学家使用自家产品留下的去标识化数据,帮助改进了他们的模型。
翻译过来就六个字:有可能,说不准。
很多人把这句当成脸皮厚。可它是整件事里最老实的一句话——它承认的不是某一次偷窃,是一门生意的默认条款:你把思考搬进我的工具,你的思考就可能变成我的训练材料。
这才是当下所有 AI 助手最普遍、也最少写进合同的收费方式——它不收钱,它收的是思考方式。
事情发生在谁身上,先要说清楚。纽约大学的巴克马斯特,和 Anthropic 的研究员阿尔波格,围绕那条方程啃了差不多一年,9月7日午夜前把结果挂了出去。
不到 12 小时,OpenAI 官宣:约一万个智能体,跑了 88 小时,交换 490 万条消息,烧掉 3000 亿个输出 token,交出 166 页证明,还附了 Lean 形式化验证代码。
那条方程叫纳维-斯托克斯,写的是水怎么流、风怎么吹、机翼上方的气流会不会突然断掉。它在是否总有光滑解这件事上悬了快一百年,克雷数学研究所为它挂着一百万美元。
时间线确实扎人。可 OpenAI 的说法是:9月1日听到传闻才立项,9月6日验证做完后主动找上门,提议两边同期发布,并且承认对方优先。
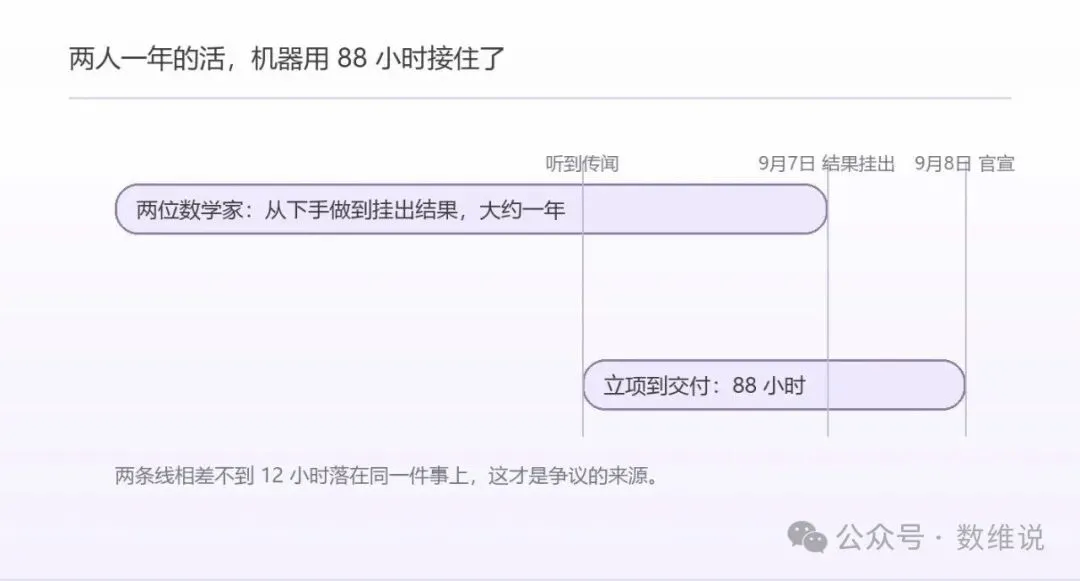
一年对 88 小时:两条线落在同一件事上(示意图)
注意后半句。是 OpenAI 先去找他们的。偷完东西的人一般不这么做。
真正让事情变味的,是巴克马斯特自己说的那句:他用 OpenAI 的 Codex 处理过没发表的草稿和推导。
他把最新鲜、最没公开、也最值钱的那部分思考,敲进了一个不属于自己的编辑器里。
这不是被人偷了。这是他自己把门打开,把东西搬上了桌。
话不好听,但这是整件事里最值得记住的一句。
而 OpenAI 那句"有可能,说不准",也就从公司的一句免责,变成了一个人自己的两难。
更有意思的是,这条船上不止两个人。9月7日同一天,加州理工的阿南德库马尔和合作者,也放出了同一道题在无黏度条件下的结果,靠的是物理信息神经网络,不是通用大模型。
一周之内,三组人,撞同一道题。
这反而说明一件事:在 2026 年,同时到达已经不是意外,是常态。既然是常态,那么"谁先想到"这个从牛顿时代用到今天的排序办法,齿轮就开始咬不上了。
数学之所以第一个炸,是因为它最好验。公式写在纸上,干净到一眼能看出谁跟谁撞了。
换成一份没发出去的方案、一段测试用例、一页病历分析,模型吸收进去再吐回来,连比对的地方都找不到。
所以这事不是"数学家被偷"这么简单。是数学家替所有人先做了一次体检——他们的成果足够干净,干净到能把平时看不见的东西显影出来。
还有一条被广泛忽略的事实:OpenAI 攻的,并不是那道题最原始的样子。
千禧年难题的官方题面本来拆成了几种情形,他们钻的是其中允许施加光滑外力的那个入口。这既合规也聪明,但它意味着那句"我们解决了",含金量得打个折。
数学界到现在没给正式认可。克雷研究所的规矩更硬:论文发表满两年后才受理,还必须是同行评议过的。
比这条更值得记的,是普林斯顿高等研究院后来的表态。
他们担心的不是某一次抄袭,是"两层制":少数实验室握着不对学界开放的前端模型,用算力在一周里跑完整整一个学科几年才爬完的山,最后把数学家从自己的领域里隔开。
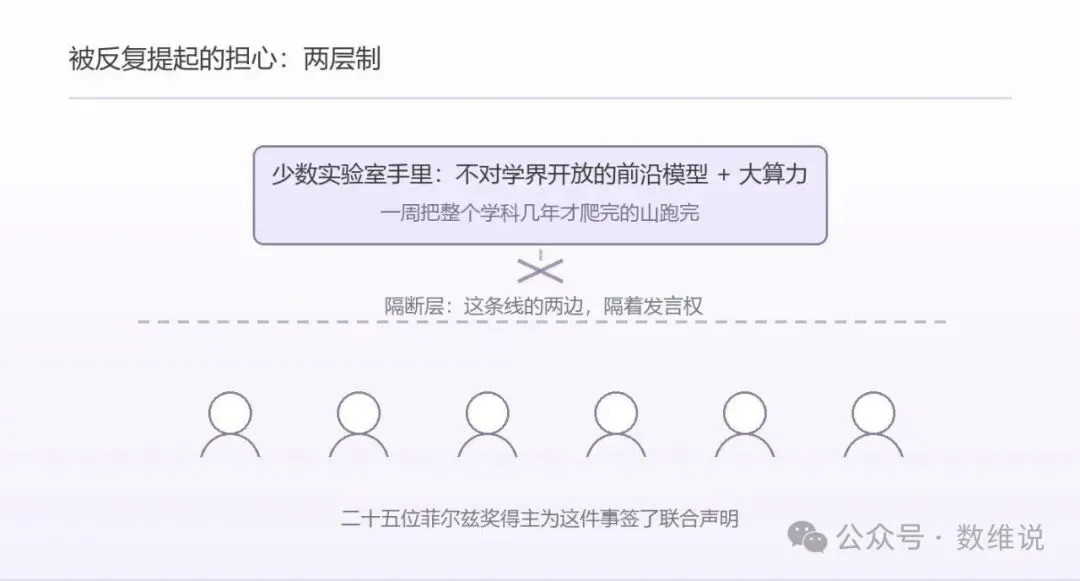
被反复提起的担心:两层制(示意图)
二十五位菲尔兹奖得主为此签了联合声明。其中一位的形容很重,说这是对人类知识的一次背弃。另一位则叹惜,那些本该用来练出一整代数学家的好题目,被一次性烧成了几篇新闻稿。这句说到根上了。
回到那六个字:有可能,说不准。
可怕的不是 OpenAI 说不准,而是这已经是行业能给的最好答案。
后来 OpenAI 补了一次内部调查,确认巴克马斯特两个月里发过的那些提示词,不可能通过任何途径影响那个模型,包括通过训练。
听着像辟谣。你再往下品一层——清白是需要动用一次专门的内部调查,才给得出来的东西。
它不是默认状态。它得由公司的资源、专门的流程、逐案的翻查来兜底。
于是每个把没发表的想法敲进对话框的人,都落在同一个位置上:没人能证明自己的东西没被拿走,对方也没法自证清白。
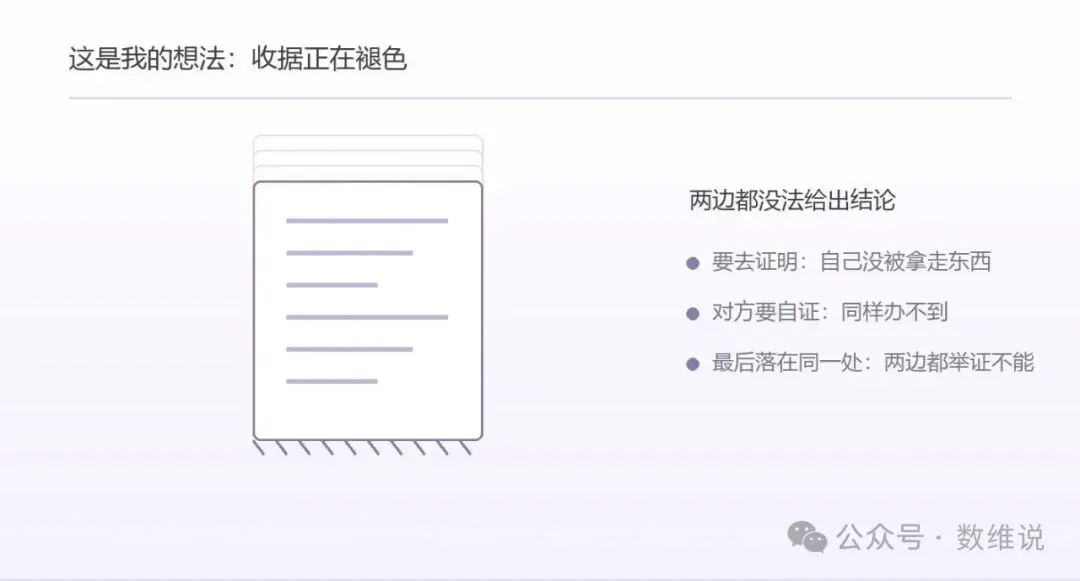
两边都举证不能,收据正在褪色(示意图)
到最后,这就不再是偷不偷的问题。是"这是我的想法"这句话,正在失去它的收据。
而任何一门靠"能证明我先想到"来排序的学问——包括数学,也包括你桌上那份还没写完的东西——都得学着习惯没有收据的日子。