适合读者:用过 JMeter写过接口压测脚本的测试同学。文中所运行都是本机小并发调试(JMeter 5.6.3,被压的是一个 Python 写的示例下单接口,源码见文末附录),用来说明脚本和团队约定在执行时的效果。一、我们的做法
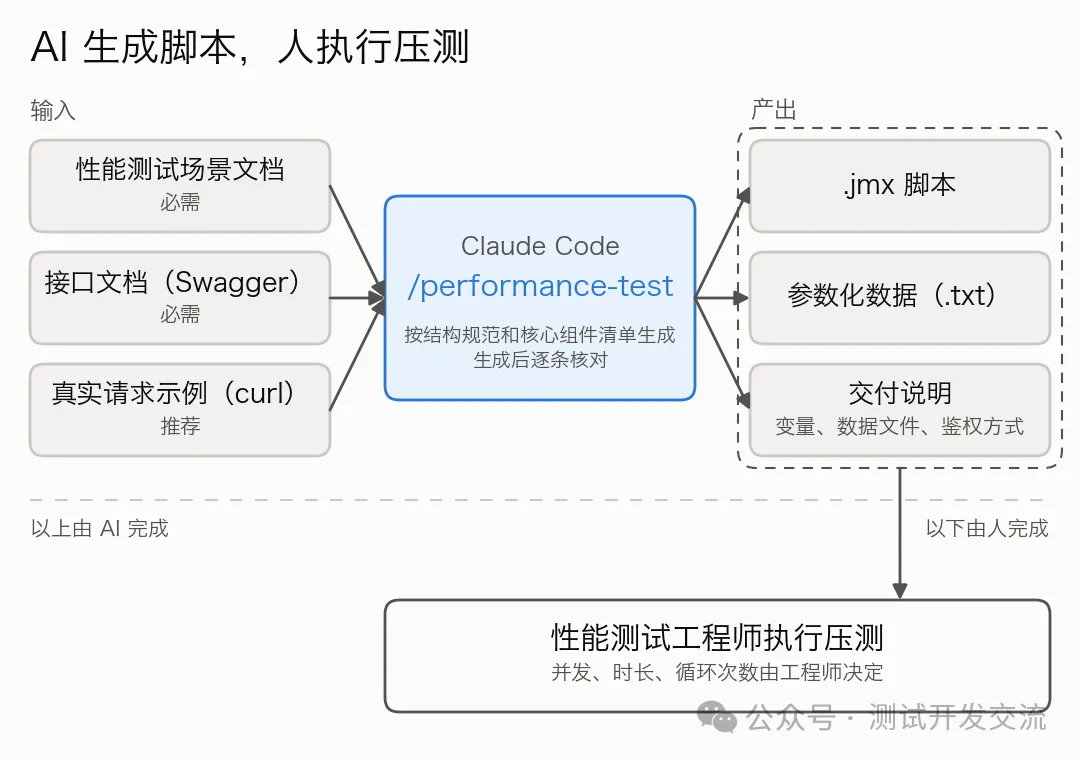
交给 AI 来做:把接口路径、请求方法、请求体字段从接口文档抄进 JMeter,每个请求挂断言、配请求头。最早我们用 Cursor,配一份规则文件(jmeter-generation-rules.mdc)和一个模板脚本(test.jmx)让 AI 照着生成。后来把规则收进了 Claude Code 的 skill /performance-test。
skill 需要这几样输入:
| | |
|---|
| | 写清每个场景调哪些接口、并发多少、跑多久、目标指标、哪些参数要换着用。由写测试用例那一步产出 |
| | Swagger/OpenAPI 的 JSON 地址(如 /v2/api-docs)或导出文件,Claude Code 会自己下载读取 |
| | 从浏览器或微信开发者工具复制的 curl。接口文档只有字段结构,没有能用的值,AI 照着示例填 |
| | |
| | |
skill 不执行压测,并发、时长、循环次数怎么组合,由性能测试工程师执行时决定。
场景文档大致是这样(示意):
## 场景 1:下单流程- 涉及接口:GET /api/products → POST /api/orders → GET /api/orders/{id}- 并发用户数:20;Ramp-up:5 秒;持续时间:60 秒- 性能指标:下单 P99 ≤ 500ms,成功率 ≥ 99%- 参数传递:商品列表取 productId 传给下单;下单取 orderId 传给订单详情- 参数化:username、password(data/users.txt);quantity(data/orders.txt)调用时把三样输入给到 skill:
/performance-test 场景文档 test/testcases/下单-性能测试场景-01.md,接口文档 openapi.json,请求示例 order_request.txtskill 里的规则沿用了最早那份规则文件的四部分:脚本模板(现在写成了结构规范)、核心组件清单、脚本要求、输出格式。
二、脚本模板
最早给 AI 一个能跑的模板 test.jmx 照着写。用 skill 后不再读模板文件,而是把模板的结构直接写成规范:测试计划由哪些组件组成、线程组参数怎么写、事务控制器怎么勾。线程组和事务控制器这几项是这样规定的:
ThreadGroup.num_threads ${__P(NumberofThreads,场景并发数)}ThreadGroup.ramp_time ${__P(Ramp-Up,场景加压时间)}ThreadGroup.duration ${__P(Duration,场景持续时间)}LoopController.loops ${__P(Loop,1)}TransactionController.parent true(勾选 Generate parent sample)事务控制器勾选 Generate parent sample 后,一个事务里的几个请求合并成一行统计,报告里能直接看到“下单流程”整体的耗时。
三、核心组件清单
skill 要求每个生成的脚本必须满足这些组件约束:
| | | |
|---|
| | 线程数、Ramp-Up、持续时间、循环次数都用 __P 读,默认值取场景文档 | |
| | 协议、域名、端口取自接口文档,禁止编造;单个请求上不再填服务器名称或 IP | |
| | Content-Type、Accept-Encoding、Authorization(值为 ${token}) | |
| | 每个业务事务一个,勾选 Generate parent sample | |
| | 用到 ${变量} 就必须加;数据文件用 .txt,变量名和表头一致;token 不放进数据文件 | |
| | 前后接口传参必须用,禁止写死;提取不到时给默认值 -1 | |
| | 每个请求挂响应断言(校验 HTTP 状态码)和 JSR223 断言(校验业务成功标识,只记日志,不判失败) | |
| | 聚合报告启用;察看结果树、Graphite 后端监听器加上但默认禁用 | |
(「CSV 数据文件设置」是 JMeter 组件的名字,它读 .txt 也一样。)
AI 生成时容易漏组件,列成清单逐项打勾,漏掉的概率小很多。
约定 1:业务失败只记日志,报告错误率不含业务失败
响应断言只看 HTTP 状态码,业务码由 JSR223 断言检查但只打日志、不判失败,方便排查。压测时有些业务失败是并发下的正常结果(库存不足、已领取、未中奖),算成错误反而会让错误率失真。
接口返回 HTTP 200、但业务码报错时,报告里会统计成成功。 示例服务里,下单数量超过 5 件会返回 HTTP 200 + {"code": 1001, "msg": "单笔限购 5 件"},测试数据里每 10 笔有 1 笔超限:
| | |
|---|
| | 只在 jmeter.log 里(20 笔里的 2 笔) |
| | 报告里直接显示 业务失败: {"code": 1001, ...} |
按这个约定执行,看完报告还要去 jmeter.log 统计 JSR223 断言记下的业务失败。按断言脚本里 log.info 打的关键字统计就行,比如:
grep -c "业务未按预期成功" jmeter.log再按业务码分类,区分哪些是正常的业务拒绝、哪些是真出错。
另外,JSR223 断言里的业务成功标识要按每个接口的实际返回写,比如本文的 '"code": 0'。如果写成“响应里出现 data 就算成功”这种宽松判断,报错响应带 "data": null 时,日志里也不会记下来。检查生成结果时要确认这一点。
约定 2:每个环境一份脚本
HTTP 请求默认值,让 AI 把接口文档里的协议、域名、端口直接写。
<stringProp name="HTTPSampler.domain">127.0.0.1</stringProp><stringProp name="HTTPSampler.port">8080</stringProp>补充 1:token 不能写死
HTTP 信息头管理器: Authorization 用 ${token},token 通过登录请求获取。
在skill 里补了一句:真实请求示例里的 token、Cookie 只作参考,禁止写进脚本。
补充 2:察看结果树和 Graphite 后端监听器默认禁用
- Graphite 后端监听器:最早的规则要求必须加。如果本机没有 Graphite 服务,压测时
jmeter.log 每秒报一次 Error writing to Graphite: Connection refused,不影响结果,但会把真正的错误淹没。现在生成时加上、默认禁用,有 Graphite 服务再启用。 - 察看结果树:调试时有用,正式压测时会占用大量内存,JMeter 官方也建议压测时不要开。现在生成时加上、默认禁用。
四、脚本要求
skill 对生成内容的要求(节选):
- 目标版本:JMeter 5.6.3- 脚本中的域名必须来自接口文档,禁止臆造- 请求体字段必须基于接口文档的 DTO 定义,禁止凭空发明字段;必填字段必须赋值- 有真实请求示例时,字段值优先照示例填;示例里没有的字段按接口文档的类型给默认值- 示例请求头里的 token / Cookie 只作参考,禁止写进脚本- JSON 请求体写在 Body Data 中,参数化字段用 ${变量名}- 需要唯一的数据用 __UUID、__RandomString 生成接口文档和请求示例要一起给。DTO 是接口文档里定义的请求数据结构,只看 curl 示例,AI 会漏掉示例里恰好没传的必填字段;只看接口文档,又没有能用的字段值。
五、输出格式
skill 规定的产出:
test/performance-test/{需求名称}/├── {需求名称}-性能测试.jmx└── data/ ├── users.txt └── {场景名}_data.txt场景较多时,可以按场景拆成多个 .jmx,放在同一目录。合并交给人在 GUI 里做。生成后检查与交付。 脚本由 AI 生成,由性能测试工程师执行,中间要有一次交接。skill 在生成后做三步:
- XML 完整性:
xmllint --noout 生成的脚本.jmx,没有 xmllint 就用 JMeter 打开确认不报错。 - 组件清单核对:对照第三节的清单逐条列出满足情况,不满足的写明原因。
- 交付说明
- 脚本文件清单(按事务拆分时,每个事务对应哪个
.jmx); - 脚本里所有
__P 变量及默认值(NumberofThreads、Ramp-Up、Loop、Duration 等); - 鉴权方式(登录接口、token 从哪个响应字段提取);
- 已禁用的监听器(察看结果树、Graphite),需要时手动启用。
六、正式压测前还要准备什么
脚本调通只是第一步。正式执行性能测试,还要另外准备这些,本文不展开:
- 独立的性能测试环境:配置接近生产,和功能测试环境隔开,避免压测影响别人测功能,也避免别人的操作干扰压测数据。压测机和被压服务分开部署。
- 专门准备的测试数据:账号数量够用,数据量级接近生产,压完能清理。不要直接从生产导数据,里面有用户隐私。
- 外部依赖用挡板:短信、支付、第三方开放平台这类接口,先跟后端确认用假接口替代,否则会产生真实费用,或者触发对方限流封号。
附录:示例服务源码
order_api.py,只用 Python 标准库,python3 order_api.py 8080 启动。下单接口里模拟了一个 20 连接的数据库连接池,本文的调试并发用不满,可以忽略。
import jsonimport randomimport sysimport threadingimport timeimport uuidfrom http.server import BaseHTTPRequestHandler, ThreadingHTTPServerfrom urllib.parse import parse_qs, urlparseUSERS = {f"user{i:03d}": "Test@123" for i in range(1, 201)}PRODUCTS = [{"id": i, "name": f"商品{i}", "price": 10 * i} for i in range(1, 21)]TOKENS, ORDERS = {}, {}lock = threading.Lock()# 模拟数据库连接池只有 20 个连接,下单要拿到连接才能写库db_pool = threading.BoundedSemaphore(20)class Handler(BaseHTTPRequestHandler): protocol_version = "HTTP/1.1" def log_message(self, *args): pass def reply(self, status, body): data = json.dumps(body, ensure_ascii=False).encode() self.send_response(status) self.send_header("Content-Type", "application/json;charset=UTF-8") self.send_header("Content-Length", str(len(data))) self.end_headers() self.wfile.write(data) def read_json(self): n = int(self.headers.get("Content-Length", 0)) return json.loads(self.rfile.read(n) or b"{}") def current_user(self): token = self.headers.get("Authorization", "").removeprefix("Bearer ") return TOKENS.get(token) def do_POST(self): path = urlparse(self.path).path if path == "/api/login": time.sleep(random.uniform(0.02, 0.06)) body = self.read_json() if USERS.get(body.get("username")) != body.get("password"): return self.reply(200, {"code": 1002, "msg": "用户名或密码错误"}) token = uuid.uuid4().hex TOKENS[token] = body["username"] return self.reply(200, {"code": 0, "data": {"token": token}}) if path == "/api/orders": # 先读完请求体再判鉴权,否则 keep-alive 连接里残留的 body 会被当成下一个请求 body = self.read_json() if not self.current_user(): return self.reply(401, {"code": 401, "msg": "未登录"}) # 业务失败照样回 HTTP 200,不少项目是这么设计的 if body.get("quantity", 0) > 5: return self.reply(200, {"code": 1001, "msg": "单笔限购 5 件"}) order = {"id": uuid.uuid4().hex[:12], "productId": body["productId"], "quantity": body["quantity"], "status": "CREATED"} with db_pool: time.sleep(random.uniform(0.02, 0.06)) with lock: ORDERS[order["id"]] = order return self.reply(200, {"code": 0, "data": order}) self.reply(404, {"code": 404, "msg": "not found"}) def do_GET(self): time.sleep(random.uniform(0.01, 0.03)) url = urlparse(self.path) if not self.current_user(): return self.reply(401, {"code": 401, "msg": "未登录"}) if url.path == "/api/products": q = parse_qs(url.query) page, size = int(q.get("page", [1])[0]), int(q.get("pageSize", [10])[0]) items = PRODUCTS[(page - 1) * size: page * size] return self.reply(200, {"code": 0, "data": {"list": items, "total": len(PRODUCTS)}}) if url.path.startswith("/api/orders/"): order = ORDERS.get(url.path.rsplit("/", 1)[1]) if not order: return self.reply(200, {"code": 1004, "msg": "订单不存在"}) return self.reply(200, {"code": 0, "data": order}) self.reply(404, {"code": 404, "msg": "not found"})class Server(ThreadingHTTPServer): request_queue_size = 256 daemon_threads = Trueif __name__ == "__main__": port = int(sys.argv[1]) if len(sys.argv) > 1 else 8080 print(f"order api listening on 127.0.0.1:{port}") Server(("127.0.0.1", port), Handler).serve_forever()