ARTICLE · 1277084
AI 技术面试题・大模型篇(二)|幻觉 / 微调 / 上下文 / Token|校招 / 社招/背这篇
AI 技术面试题・大模型篇(二)|幻觉 / 微调 / 上下文 / Token|校招 / 社招/背这篇🔥大模型面试续集来啦!LLM 工程落地向考题 校招|社招|AI 应用开发|提示词工程师直接背 偏工程实操,面试官超爱深挖这部分💻 幻觉:大模型一本正经编造不存在的事实、数据、文献、结论,输出内容看似通顺,但和真实信息不符。 提示工程控制方法: ✅ 增加约束 prompt:明确要求 “不知道就说不知道,禁止编造” ✅ 引用溯源要求:回答必须标注信息来源,无来源不输出结论 ✅ Few-shot 给正反样例:给正确回答 + 幻觉错误案例让模型参考 ✅ 分步提问:先判断有没有把握,再输出答案 ✅ 要求输出边界:区分【确定事实】和【推测观点】 主流 3 种定制路线: 👉流程:数据清洗→标注→格式转换→训练→评估→上线测试 核心看:模型参数量、是否 LoRA 全参数微调、序列长度、batch size、epoch、精度(FP16/BF16/4bit 量化) 估算要点: 简单思路:先确定方案(优先 LoRA)→ 选序列长度→ 计算单样本显存→ 乘以 batch,预留冗余 上下文窗口:模型一次能同时读取 + 处理的最大 token 总量(用户提问 + 历史对话 + 参考资料 + 输出)。 限制带来的问题: 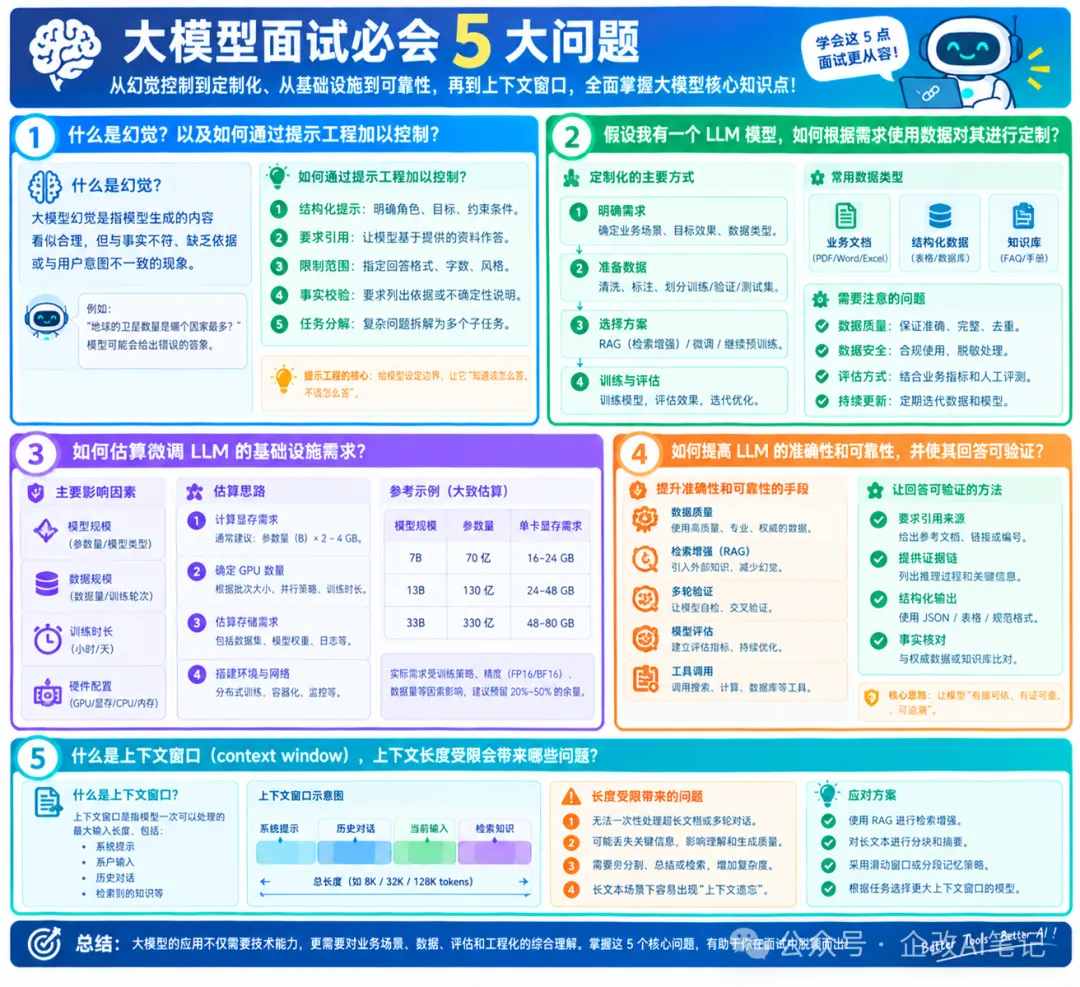
一句话:OpenAI 是模型原生能力;LangChain 是上层通用框架方案。 Token 是模型处理文本的最小单元,不是字 / 词,会拆成词根、字、标点、子词。 换算参考(中文):1token ≈ 1.5~2 个汉字 英文:1token ≈ 0.75 个英文单词 ⚠️ 标点、空格、生僻字、长单词都会单独拆 token,换算只是粗略估算,计费、上下文都按 token 算。 自回归:按顺序逐个生成下一个 token,生成第 n 个 token,只依赖前面已经生成的 token,不能看未来内容。 优势: 缺点:不能并行生成输出,长文本推理速度慢 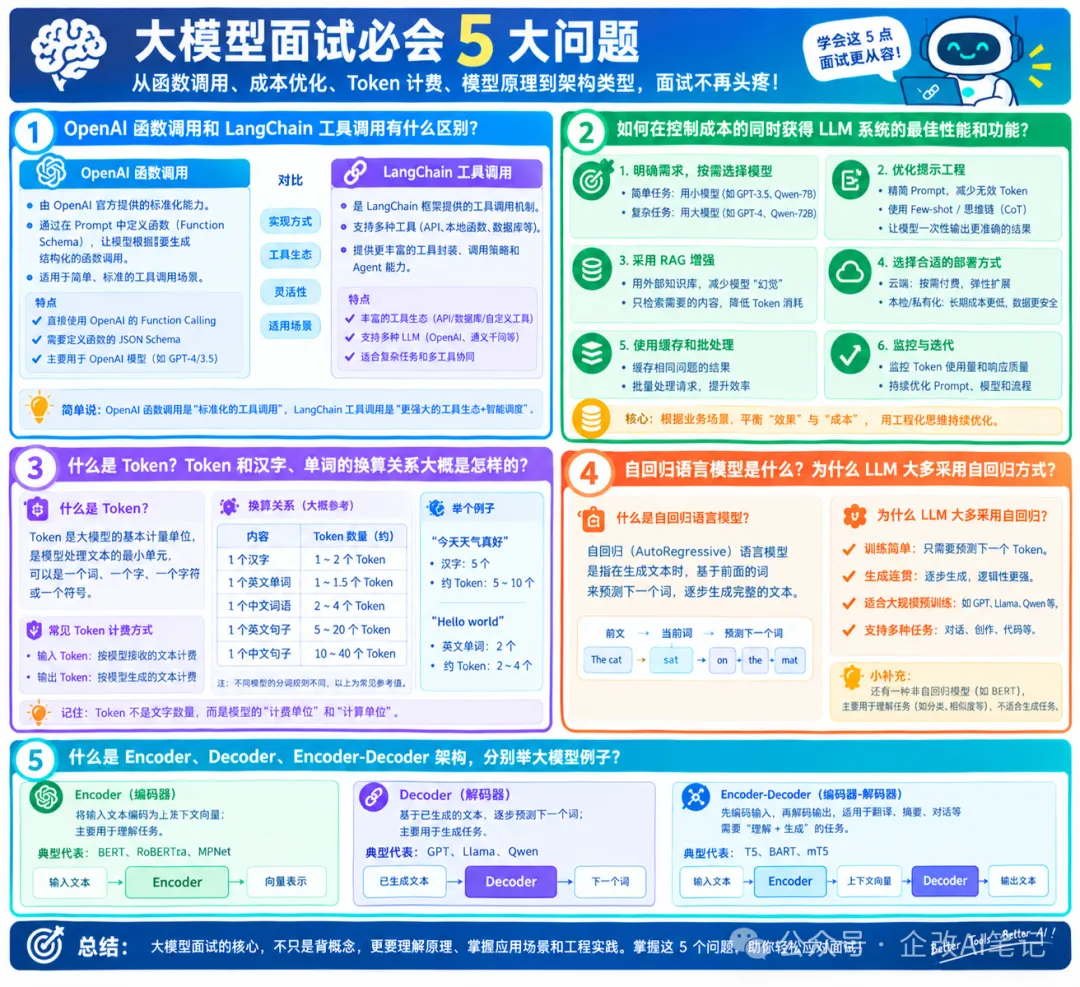
💡小 tips 前面 Agent 篇 + LLM 基础篇 + 这篇工程落地篇,三套放一起,面试基本全覆盖! 收藏⭐面试前快速复盘,避免踩坑
1️⃣ 什么是幻觉,以及如何通过提示工程加以控制?
2️⃣ 假设我有一个 LLM 模型如何根据我的需求使用数据对其进行定制?
RAG 检索增强:不改动模型权重,私有文档入库,提问时检索相关内容喂给模型,适合知识更新快、不想重训模型 SFT 有监督微调:标注问答 / 指令数据,微调模型参数(常用 LoRA 低秩适配,低成本),让模型对齐你的输出风格、指令格式 DPO/RLHF 偏好对齐:基于人类偏好对比数据,优化模型输出偏好,适合对齐回答风格、价值观
3️⃣ 如何估算微调 LLM 的基础设施需求?
全参微调:显存压力极大,7B 全参一般需要 80G + 卡;LoRA 只训练少量参数,显存需求大幅下降 量化:4bit/8bit 量化可以降低显存占用,牺牲少量精度 计算量:看总 token 数量;token 越多,训练时长越长 配套:还要考虑数据集存储、验证推理卡、日志、 checkpoint 存储
4️⃣ 如何提高 LLM 的准确性和可靠性,并使其回答可验证?
RAG 接入可信知识库,答案从检索片段生成 强制引用原文片段,输出溯源链接 / 段落编号 增加校验 Agent:生成答案后再调用检索、计算器二次核验 拒绝回答无依据内容,设置拒绝话术 分阶段输出:先给出证据,再总结结论 增加评估集,持续自动化测试幻觉、错误率
5️⃣ 什么是上下文窗口(context window),上下文长度受限会带来哪些问题?
长文档、长对话被截断,丢失关键信息 长任务无法一次性读完,容易遗忘前文要求 RAG 单次可放入的参考文档变少,信息不足更容易幻觉 多轮对话越长,能留给新问题的 token 空间越小
6️⃣ OpenAI 函数调用和 LangChain 工具调用有什么区别?
OpenAI 函数调用:原生能力,模型内置函数 schema 理解,输出规范 function call 格式,稳定性强,但绑定 OpenAI 模型,能力由官方定义 LangChain 工具调用:框架层封装,兼容各类开源 LLM(不一定原生支持函数调用),靠 prompt 引导模型输出工具指令;优势是跨模型、工具编排、记忆、Agent 链路一站式;缺点是依赖 prompt 质量,更容易格式出错
7️⃣ 如何在控制成本的同时获得 LLM 系统的最佳性能和功能?
分层路由:简单问题用小模型,复杂推理、长任务才上大模型 缓存高频 query 结果,避免重复调用 优化 prompt,精简 token,减少冗余上下文 优先 RAG,少用昂贵全参微调,能用 LoRA 就不用全量微调 开启量化,推理侧用 4bit/8bit,满足精度前提下降成本 限制 Agent 工具调用次数,防止无限循环调用 分环境:测试环境用低成本模型,生产环境按需选择
8️⃣ 什么是 Token?Token 和汉字、单词的换算关系大概是怎样的?
9️⃣ 自回归语言模型是什么?为什么 LLM 大多采用自回归方式?
训练和推理逻辑一致,简单好实现 生成流式输出,边生成边返回,用户体验好 适合文本续写、对话、写作这类顺序生成任务 扩展性强,容易做大参数量模型
🔟 什么是 Encoder、Decoder、Encoder-Decoder 架构,分别举大模型例子?
Encoder 编码器:双向注意力,同时看上下文,主打理解、分类、语义向量。例子:BERT Decoder 解码器:单向注意力(自回归),只能看前面内容,主打生成对话文本。例子:GPT 系列、Llama、Qwen Encoder-Decoder 编解码:编码器理解输入,解码器生成输出,适合翻译、摘要。例子:T5、BART