ARTICLE · 1277163
PDF 拆成单页:24 页 0.7 秒拆完,自动起名
你是不是也这样:月底报销,财务在群里扔来一个 24 页的 PDF,让你把它拆成单页,一张票一个文件、文件名还得写清楚是什么票。
我写了个 39 行的脚本跑了一遍:24 页变成 24 个文件,0.70 秒,其中 20 个文件名是它自己看着票面起好的。
照着做,五分钟跑通,以后任何 PDF 拆成单页都能直接扔给它。
先看效果
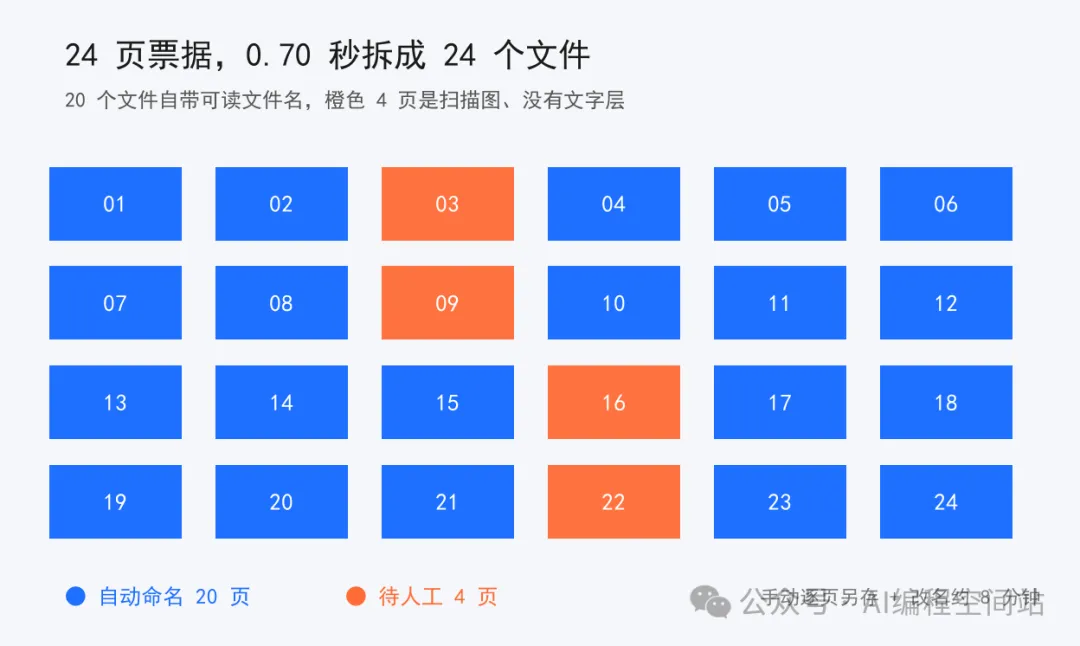
24 个方块就是 24 个文件。蓝色那 20 个,打开文件夹就知道哪张是哪张——名字长这样:01_出租车发票_58.00元.pdf。
橙色那 4 页是手机拍的纸质票,PDF 里根本没有文字层,脚本读不到一个字,只能存成 03_扫描件_需人工确认.pdf。
这个 4 不是 bug,是这套方法的天花板,也是它最诚实的地方:能自动的自动,不能自动的老实标出来让你看。
手动做同样的事,24 页等于 24 次右键「另存为」加 24 次按 F2 改名。按一页 20 秒算,一轮下来少说 8 分钟,而且下个月报销还得再来一遍。
准备工作:装 1 个库,准备 1 份 PDF
Python 3.8 以上, pip install pypdf——整篇只依赖这一个库一份多页 PDF,放在脚本同一个文件夹里 把脚本第 7 行的 SRC改成你的文件名不用装 Office,不用联网,不用注册任何账号
上代码
# -*- coding: utf-8 -*-"""把一份多页 PDF 拆成单页,并按每页抬头自动命名。依赖:pip install pypdf"""import re, timefrom pathlib import Pathfrom pypdf import PdfReader, PdfWriterSRC = Path("10月报销票据汇总.pdf") # ← 换成你的 PDFOUT = Path("拆分结果")defmake_name(text, idx):"""把一页的文字变成 Windows 合法文件名""" lines = [l.strip() for l in text.splitlines() if l.strip()] title = lines[0] if lines else"扫描件_需人工确认" money = next((l for l in lines if"金额(小写)"in l), "") money = re.sub(r".*?¥", "", money) # 只留数字部分 raw = f"{idx:02d}_{title}_{money}元"if money elsef"{idx:02d}_{title}"return re.sub(r'[\\/:*?"<>|\s]+', "_", raw)[:60] + ".pdf"OUT.mkdir(exist_ok=True)reader = PdfReader(SRC)t0 = time.perf_counter()auto = scan = 0for idx, page inenumerate(reader.pages, 1): text = page.extract_text() or""# 没有文字层就是空串 writer = PdfWriter() # 一页一个 writer writer.add_page(page) writer.write(OUT / make_name(text, idx))if text.strip(): auto += 1else: scan += 1cost = time.perf_counter() - t0files = list(OUT.glob("*.pdf"))total_mb = sum(f.stat().st_size for f in files) / 1024 / 1024print(f"原文件 {len(reader.pages)} 页 → 拆出 {len(files)} 个文件")print(f"自动命名 {auto} 页 / 扫描件待人工 {scan} 页")print(f"总耗时 {cost:.2f} 秒,输出总体积 {total_mb:.2f} MB")跑出来的结果
真实终端输出,Windows + Python 3.13,24 页的报销 PDF:
原文件 24 页 → 拆出 24 个文件自动命名 20 页 / 扫描件待人工 4 页总耗时 0.70 秒,输出总体积 5.54 MB打开「拆分结果」文件夹,长这样:
01_出租车发票_58.00元.pdf02_出租车发票_41.50元.pdf03_扫描件_需人工确认.pdf04_酒店住宿发票_380.00元.pdf11_高铁票_南宁→玉林_118.00元.pdf第 11 个文件名里那个「→」被完整保留了下来,因为它不在 Windows 的禁用名单里——禁用名单一共九个字符,其余符号都能用。同一台机器上多跑几次,耗时会落在 0.66–0.72 秒之间,取决于磁盘缓存,不影响结论。
但等一下——原文件才 0.25 MB,拆完怎么变成 5.54 MB 了?
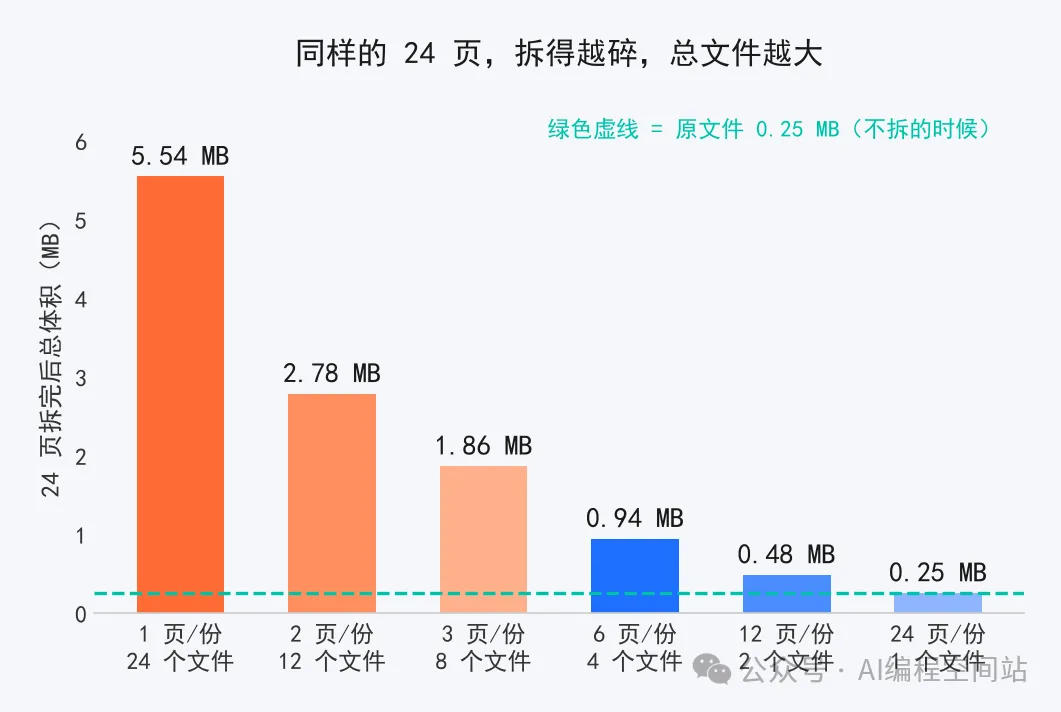
因为每拆出一个新文件,都得把原 PDF 里的字体带走一份。拆成 24 个文件,就是 24 份字体。这份 24 页的样本里,字体占了绝大部分体积,所以拆得越碎,总占用越大,几乎是正比关系。
为什么这么写
一、Reader 是借来的书,Writer 是你的新本子。PdfReader 只能看不能改,想落盘必须新建 PdfWriter。很多人图省事把 writer 写在循环外面,第 2 页就把第 1 页顶掉了,最后本子里只剩一页。每页一个 writer,谁也不欠谁。
二、extract_text() 拿的是 PDF 里藏的「隐形字幕」。 电子发票导出时自带文字层,所以能读出「出租车发票」;手机拍的纸质票本质是一张照片,字幕是空的,读出来就是空串。所以 text.strip() 为假,基本可以断定这页是扫描件。
三、文件名要先过一遍正则,像给行李箱贴标签前先擦干净箱面。 Windows 不允许 \ / : * ? " < > | 这九个字符,而发票抬头里偏偏总有「¥」和空格。re.sub 把它们全换成下划线,写入时才不会抛 OSError。
踩坑提示
坑 1:只拿抬头当文件名,24 页只剩 14 个文件。 我第一版写的是 name = 抬头 + ".pdf",跑完还挺得意。一数文件只有 14 个——「出租车发票」有 7 张,同名 write() 直接静默覆盖,连个警告都不给。后来按修改时间排序才看出来,同一分钟内被覆盖了 6 次。所以文件名前面必须带 01_ 这种序号。
坑 2:加密 PDF 直接报 FileNotDecryptedError。 银行流水、部分电子发票是加密的,一读就抛 FileNotDecryptedError: File has not been decrypted。解法是加一行 reader.decrypt("密码"),返回 2 表示你是用「所有者密码」打开的。
坑 3:拆完体积翻 22 倍,微信发不出去。 就是上面那张图。如果目的是发给不同的人,5.54 MB 无所谓;如果只是归档,把「每份装几页」调成 6,同样的 24 页只要 0.94 MB。
一页速查:PDF 拆页的五条命令
pip install pypdf | ||
PdfWriter().add_page(page) | ||
page.extract_text() or "" | ||
f"{idx:02d}_" | ||
明天见
明天周五回到钱与账单:把你微信账单导出的 CSV 丢进去,自动揪出所有「每月自动续费」,算算一年到底白交多少——我自己的账单里翻出 4 笔,一年 1248 元。
顺带交代一句,上周预告的「PDF 转 Word 为什么表格线全丢」,我试了 pdf2docx,光依赖就 200 多 MB,不符合这个号「20 分钟跑通」的标准,先欠着,找到轻量方案再补。
如果这篇帮你省下了一个下午,点个关注,这个号周一到周日只写一件事:用一段能跑的代码,解决上班族今天真实遇到的小麻烦。
转给那个每次报销都在右键「提取页面」的同事,他大概率正在一页一页手动拆 PDF。