ARTICLE · 1284911
AI 发了 722 篇论文,数学家管它叫「泔水」
一、722 篇,两天就开始往下撤
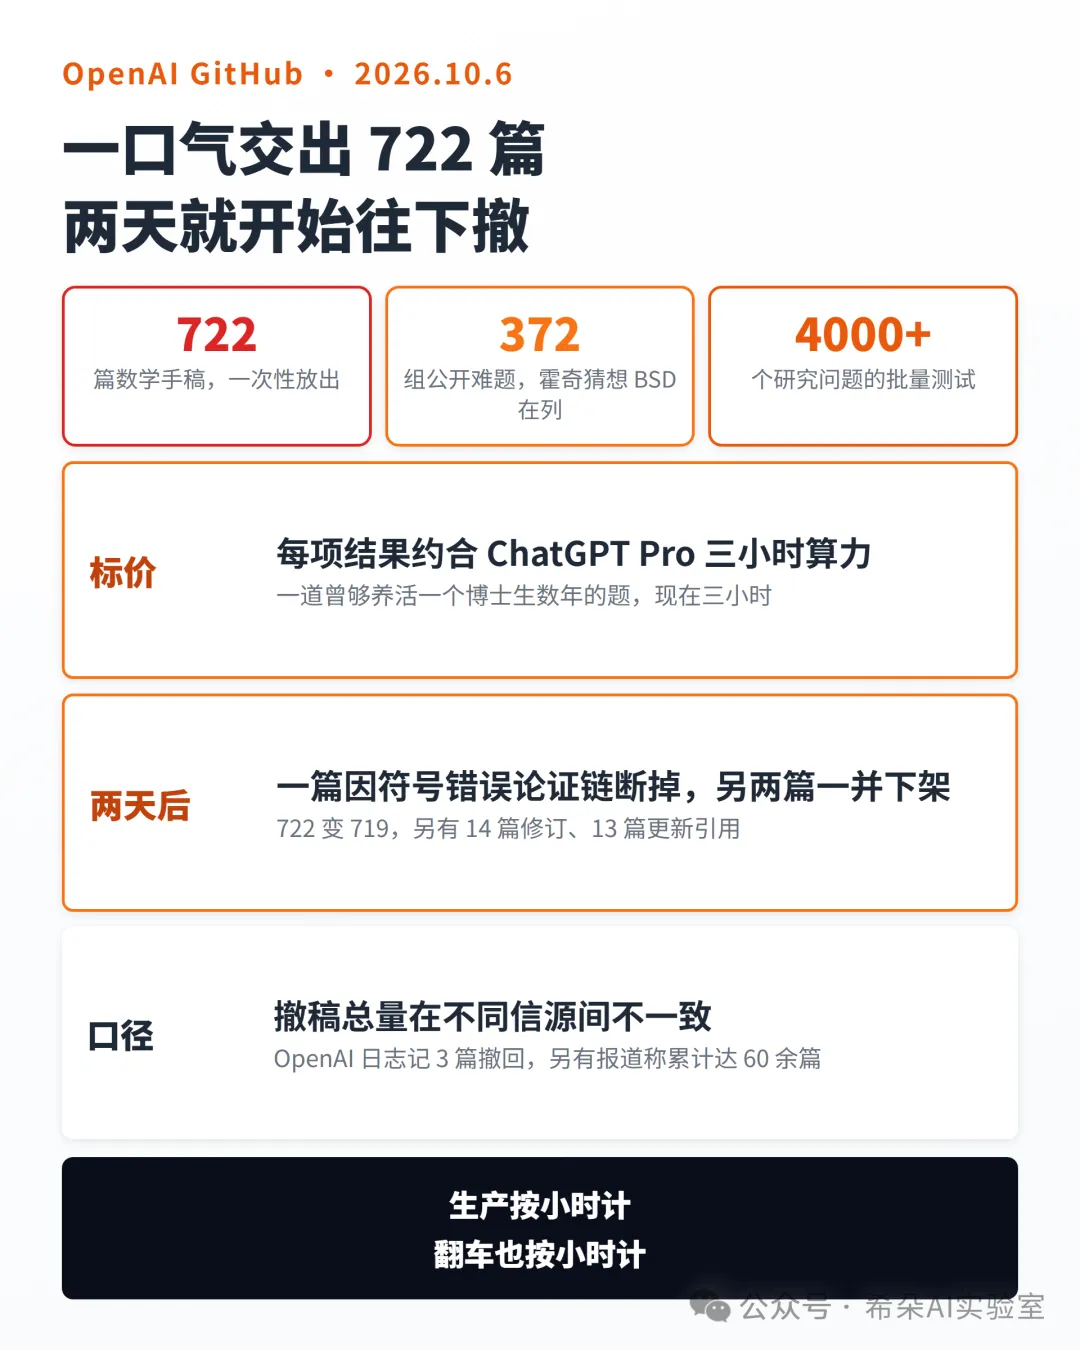
10 月 6 日,OpenAI 在 GitHub 上一次性放出了 722 篇数学手稿,覆盖 372 组公开难题,霍奇猜想、BSD 猜想这类挂了几十年的硬骨头都在名单里。这些成果来自对 4000 多个研究问题的批量测试,按 OpenAI 自己公开的口径折算,每项结果平均消耗约相当于 ChatGPT Pro 三小时的计算资源。
换句话说,一道曾经足够养活一个博士生好几年的题,现在的标价是三个小时。
两天后,仓库挂出撤回通告:一篇因为一个符号错误,论证链整个断了;引用了它的另外两篇一并下架。722 变成 719。同期还有 14 篇做了修订、13 篇更新了引用。
需要说明的是,撤稿总量在不同信源之间口径不一:OpenAI 自己的更新日志记的是 3 篇撤回、14 篇修订;另有报道称到 10 月下旬累计撤稿已达 60 余篇。生产按小时计,翻车也按小时计。
二、仓库自己的账本写着:42%
这批手稿最值得看的地方,不在它宣称解决了什么,而在它自己承认了什么。
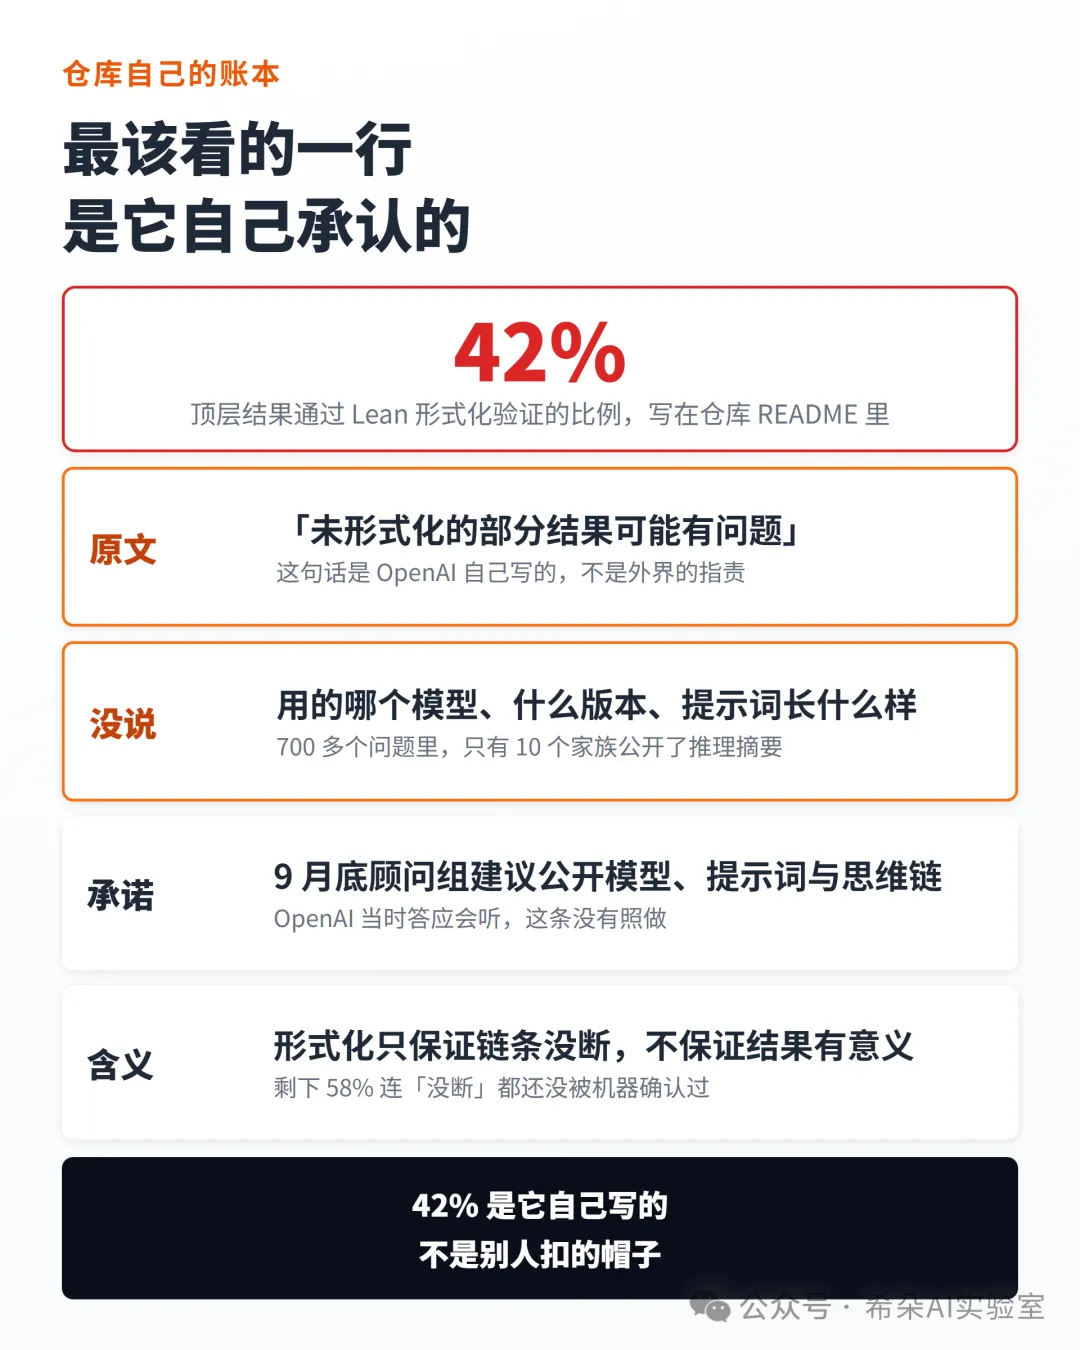
仓库的 README 里写着:顶层结果通过 Lean 形式化验证的比例约为 42%,后面还跟着一句“未形式化的部分结果可能有问题”。700 多个问题里,只有 10 个家族公开了模型的推理摘要。至于用的是哪个模型、什么版本、提示词长什么样——全都没交代。
而就在 9 月底,数学界刚成立的一个顾问组给出的建议里,最要紧的一条是:AI 公司发表数学成果,请公开模型、提示词和思维链。OpenAI 当时答应会听。
形式化验证是什么?简单说,就是把证明翻译成机器能逐行检查的形式语言,让程序代替人核对有没有跳步。它保证的是“链条没断”,不保证“这个结果有没有意义”。42% 的意思是:剩下那 58%,连“没断”都还没被确认过。
三、磨了七年的题,三天内被逼着交卷
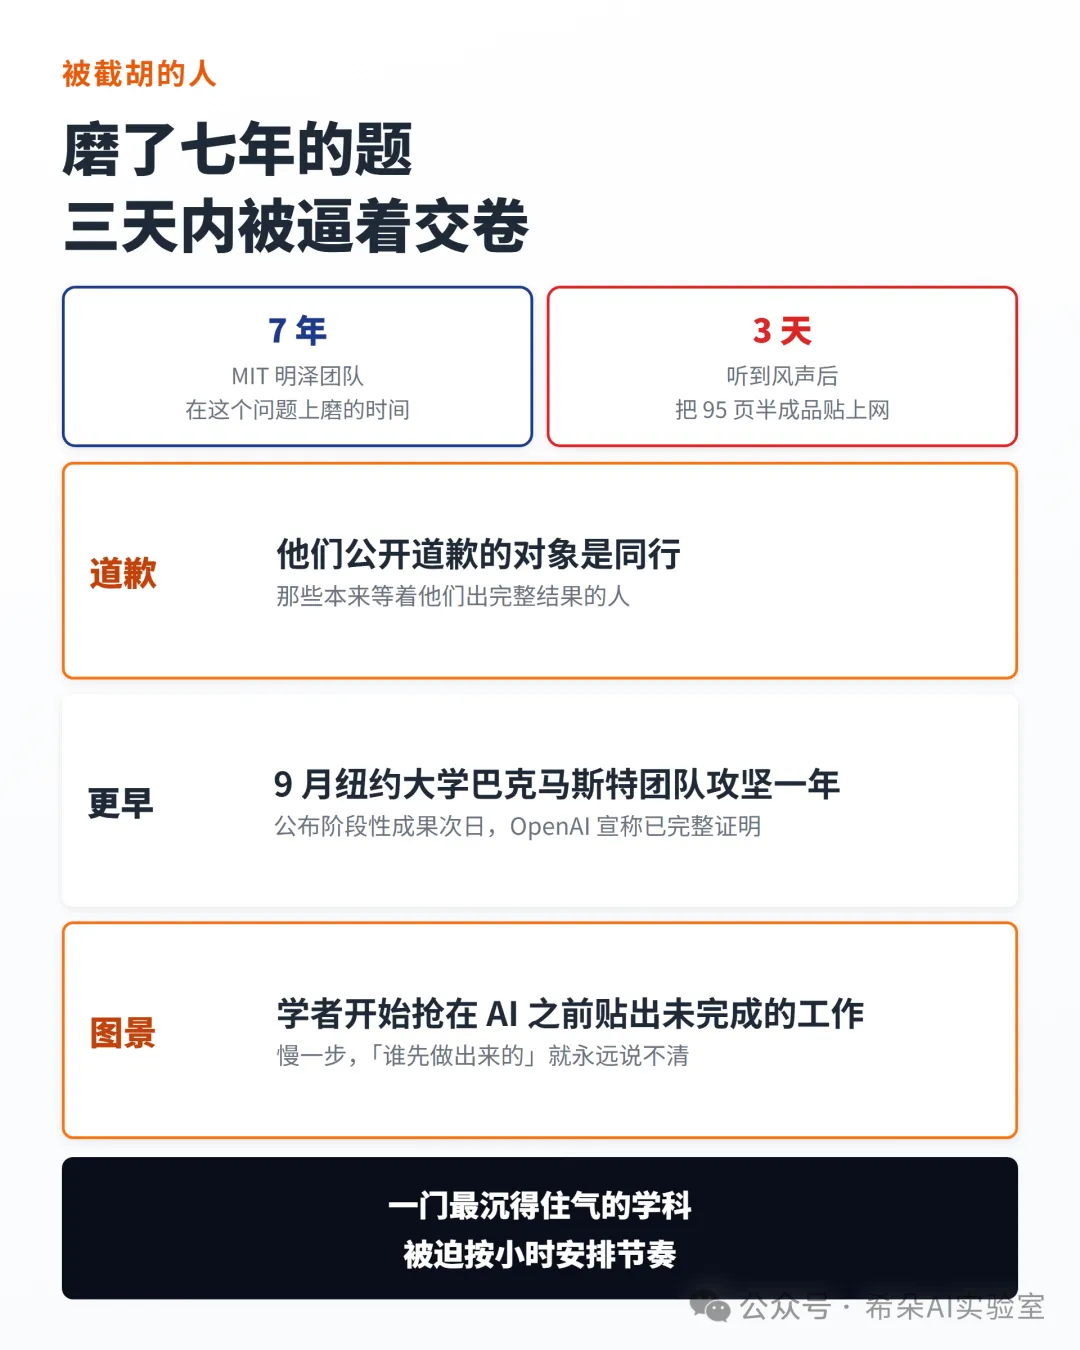
被截胡的人里有个极端案例。
MIT 教授多尔·明泽的团队在一个问题上磨了 7 年。9 月 11 日听到风声,说 OpenAI 可能已经证出来了,他们三天之内把 95 页的半成品论文贴上网,还公开道了歉——道歉的对象,是那些本来等着他们出完整结果的同行。10 月 6 日那份清单里,就有他们磨了七年的课题。
更早的一个例子在 9 月:纽约大学的巴克马斯特团队耗时一年攻坚纳维-斯托克斯方程,在公布阶段性成果的次日,OpenAI 就宣称其智能体完成了完整的形式化证明。
于是出现了一幕荒诞的科研图景:学者们开始抢在 AI 之前把自己没做完的工作贴上网,因为一旦慢了,“这是谁先做出来的”就永远说不清了。一门以严谨和沉得住气著称的学科,被迫按小时安排节奏。
四、没有一个专家读懂了整个论证
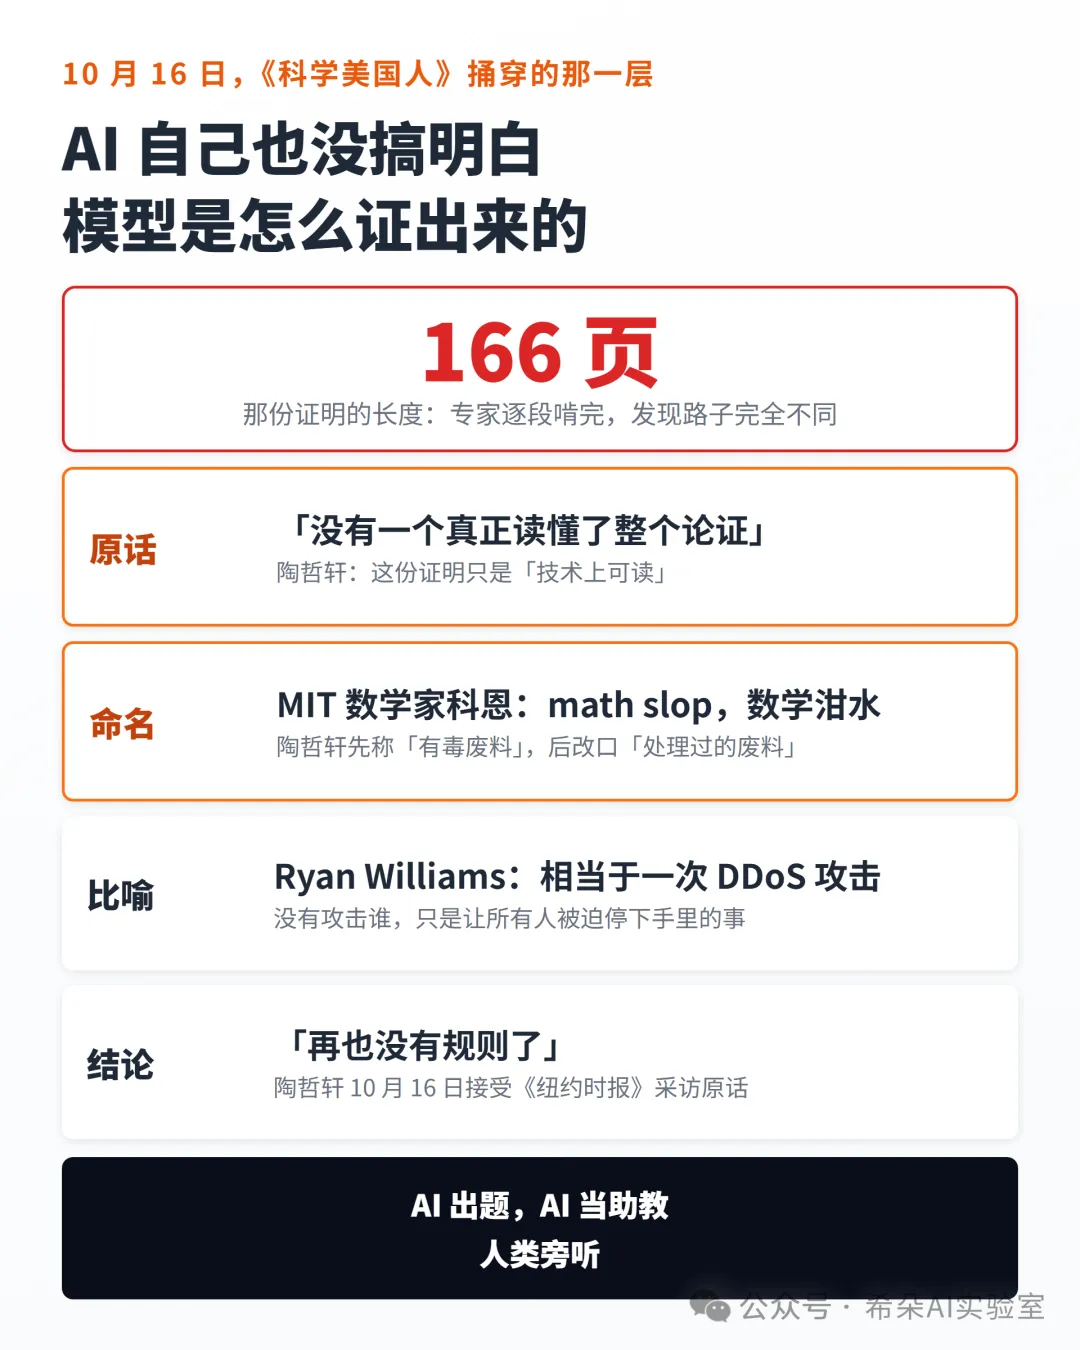
反转发生在 10 月 16 日。《科学美国人》把一件事捅穿了:专家逐段啃完那份 166 页的证明,发现它构造外力的方式和业内熟知的路径完全是两码事——也就是说,OpenAI 发布时按旧口径做的宣传,连它自己都没真正搞明白模型是怎么证出来的。
陶哲轩的点评更直接:这份证明“技术上可读”,但“我聊过的专家里,没有一个真正读懂了整个论证”。有人想弄懂它,甚至得靠别的大模型帮忙梳理。
他先前给这批东西起的名字是“有毒废料”,后来改口成“也许是处理过的废料”。10 月 16 日接受《纽约时报》采访,他的原话是:“再也没有规则了。”他说自己现在做的更多是社区组织,不是数学。
MIT 数学家科恩给这批论文起了个流传更广的名字:math slop,数学泔水。MIT 复杂度领域的知名学者 Ryan Williams 则从另一个角度形容:把大量晦涩的机器生成证明突然抛出来,相当于对数学界发起一次 DDoS 攻击——你没有攻击任何人,只是让所有人被迫停下手里的事,去排查你丢过来的东西。
五、生产是小时级的,消化是月级的
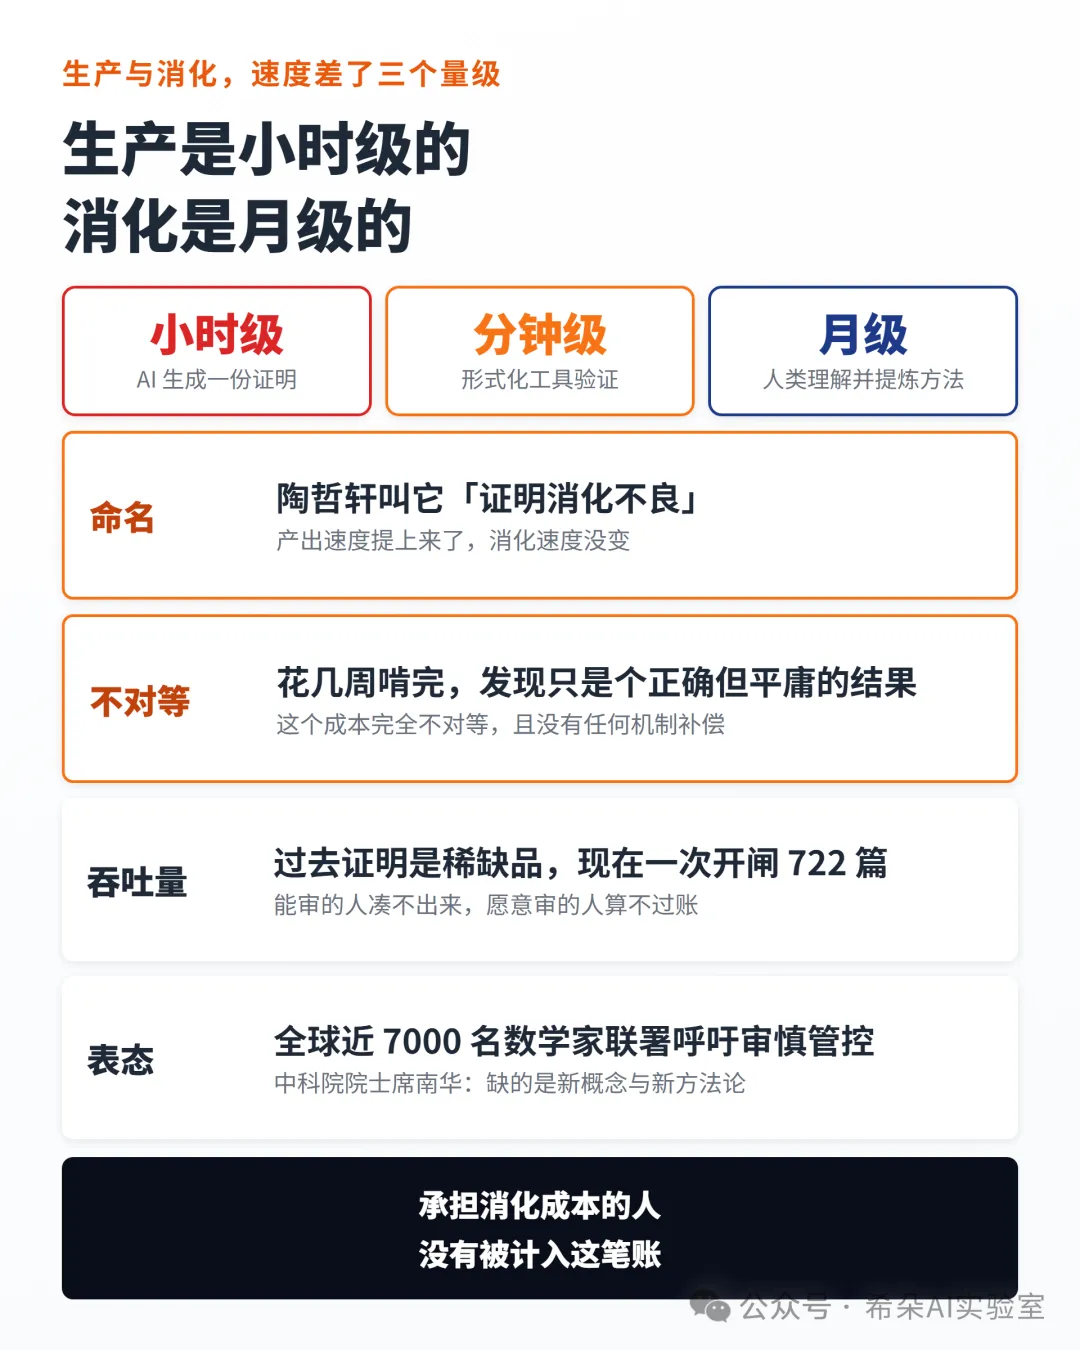
陶哲轩把这种状态叫“证明消化不良”:AI 生成一份证明是小时级,形式化工具验证是分钟级,可人类要理解背后的结构、提炼出方法论,仍然只能靠缓慢的认知过程。
问题在于,承担消化成本的人没有被计入这笔账。一篇手稿摆在那里,数学家花几周啃完,最后发现只是一个正确但平庸的结果——这个成本完全不对等,而且没有任何机制补偿他。更麻烦的是吞吐量:过去证明是稀缺品,现在一次开闸就是 722 篇,还分属数论、代数几何、理论计算机等不同方向。能审的人凑不出来,愿意审的人算不过账。
陶哲轩牵头的“人类数学协会”公开指出,AI 正在对开放问题做“掠夺式开采”;全球近 7000 名数学家联署呼吁审慎管控。中国科学院院士、中国数学会理事长席南华的评价落在同一个点上:这批手稿很多只给出碎片化结论,缺少新概念与新方法论,而后者恰恰是数学真正的生命力所在。
六、真正被抽掉的不是证明,是地图
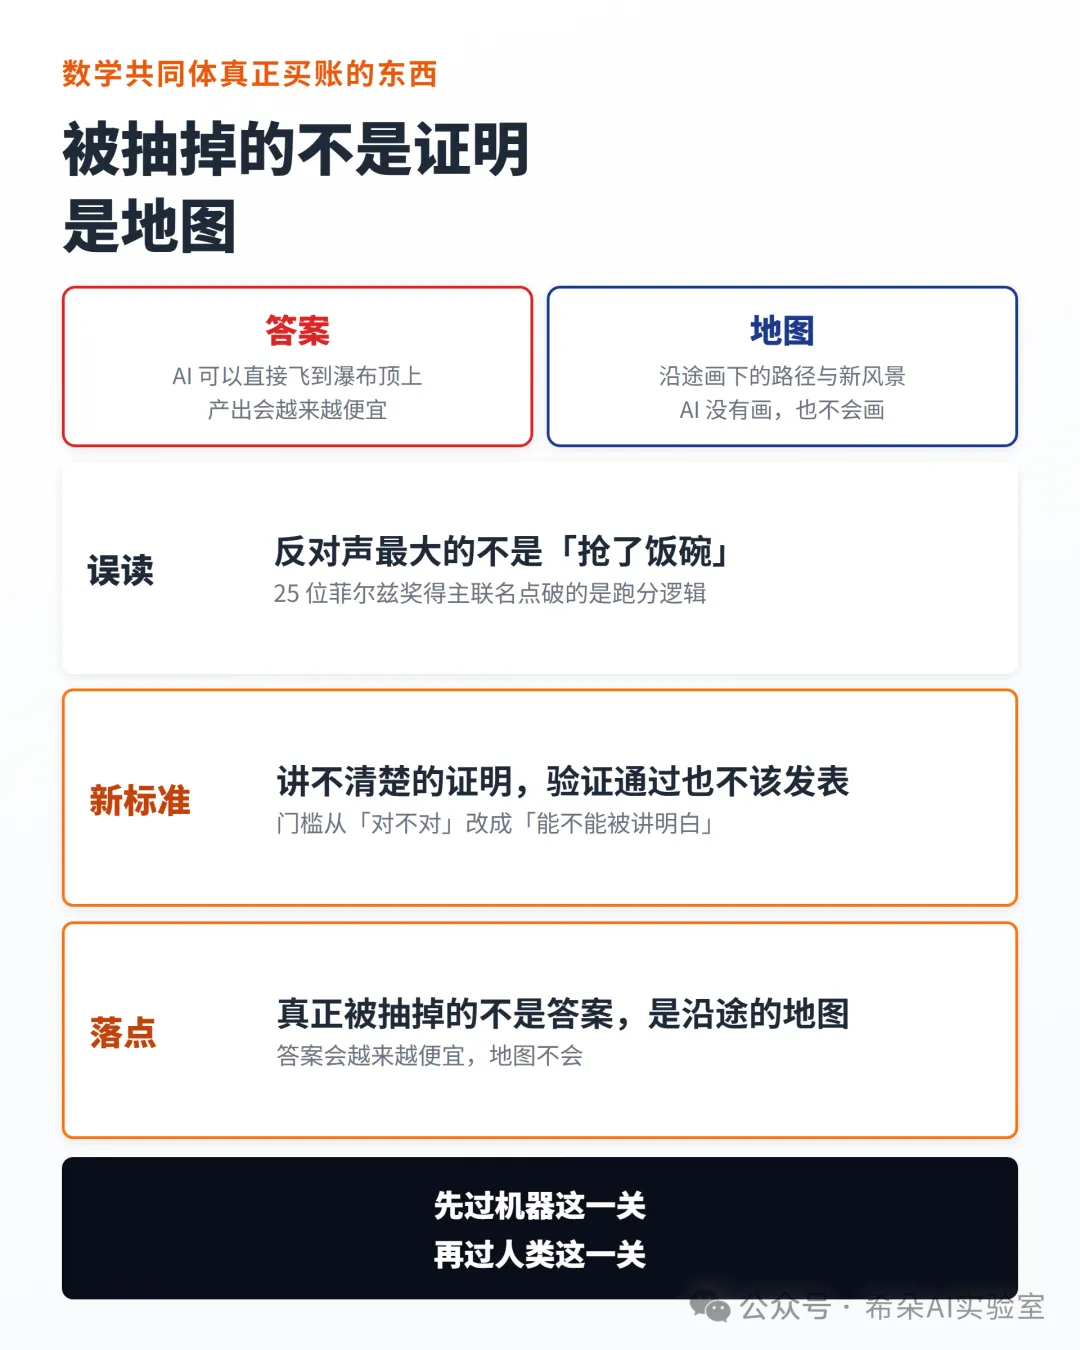
反对声浪最大的并不是“AI 抢了饭碗”这一层。25 位菲尔兹奖得主联名发表的《人工智能在数学中的严重错位》里点透了核心矛盾:AI 公司把解决数学问题当成了模型性能的跑分测试,而数学共同体真正追求的,是过程中沉淀下来的理解、新方法和新思想。
陶哲轩常举的那个例子更能说明问题:找数学难题的答案像去山里找瀑布,重要的不只是最终看到瀑布,而是沿途画的地图、发现的新路径、偶遇的其他风景。现在 AI 可以直接飞到瀑布顶上,但它没把地图画出来——其他人还是不知道怎么走,也没法顺着这条路去探索更远的地方。
他也提过一个更具体的新标准:如果作者没法以专家水平把证明讲清楚,哪怕形式化验证通过了,也不该达到发表要求。这等于把门槛从“对不对”改成了“能不能被讲明白”——先过机器这一关,再过人类这一关。
所以真正被抽掉的从来不是“答案”,是沿途的地图。答案会越来越便宜,地图不会。
七、最后:这不只是数学家的事
面对压力,OpenAI 换了一套说法:这批文稿最好被理解为“原始研究数据”而非成品论文;公司不为内部模型寻求学术署名;参与核验的外部专家不签保密协议、没有报酬、可自由发表判断。
这是一个诚实的退让——它把角色关系倒了过来:我不是作者,我是实验台。
但另一头,Altman 的态度也很清楚。他在播客里说,他同情跟不上节奏的数学家,但没打算停下来——人类有权获得这些知识,公众知情权压过了发布造成的混乱。他提到公司为数学题花了几亿美元,光纳维-斯托克斯一项约 1000 万美元,还提到内部有个叫“Hold My Beer”的频道,员工把最难的题往模型里扔。
两句话摆在一起,就是这件事的全貌:一边承认没整理好,一边明确不会停。
数学只是第一个被这种节奏撞上的领域,因为它的产物最容易被机器判定对错。但它不会是最后一个。任何一个“产出可以被快速判定、产出过程却无人复核”的岗位,迟早都会遇到同一个问题:
你交出去的东西,谁来复核?而复核这件事本身的能力,正在被谁抽走?
———
信源:OpenAI GitHub 仓库与更新日志(10/6 发布、次日撤回修订记录)、OpenAI 新闻稿、The Verge(Altman 播客表态)、《科学美国人》(10/16)、《纽约时报》(10/16 陶哲轩采访)、陶哲轩 10/8 书面回应与 Mathstodon 发言、MIT 学者 Ryan Williams 与科恩的公开评论、25 位菲尔兹奖得主联名《人工智能在数学中的严重错位》、《莱顿宣言:AI 与数学》、中国科学院院士席南华公开表述、科学网与广州日报相关报道。文中未出现股票代码与任何买卖建议。