ARTICLE · 1284912
大模型一直“碰不到”Excel 的单元格,被他给解决了
让 AI 改一段文案,改错了重写一遍,成本几秒。让它改一张生产报表的 B 列,它回你一段脚本——脚本在你机器上跑,覆盖了公式、条件格式、同事刚填的数据,而表看起来还是正常的。
你现在就能试一件事:找一张带合并单元格和公式的表,发给任何一个模型,让它“把 B 列数值统一上调 10%”。它不会问你公式引用链,不会管合并格,更不知道 C 列上有人挂了条件格式——因为在它眼里,那张表是一段被压扁的文本。
这不是聪明不聪明的问题。公式、格式、校验、图表,都要先被“翻译”成文本才能递到模型面前,每翻译一次丢一层。模型缺的不是理解力,是一个能直接下指令的操作面。它一直在替你改 Excel 的影子。
主流的两条路,试过的人都知道洞在哪。一条是让 AI 写代码,pandas、openpyxl 一把梭:代码要你自己审、自己跑,覆盖了公式和条件格式也不报错,出了事没有回滚。另一条是等模型更强:可这从来是接口问题,不是智力问题——隔着毛玻璃,换再聪明的人看,看到的还是影子。
标题里那个“他”,把第三条路走通了。Luckysheet 团队用 TypeScript 全量重写的 Office 运行时 Univer——GitHub 上 22.7K star,Apache-2.0 开源,官网给自己的定位一句话:The Office Harness for AI Agents。
它值得现在看,是因为官方文档已经把整条链路写死了:有 API、有权限边界、有标准流程。不再是一个 Demo,是可以进工程评审的形态。
Univer 用一套内核承载六类内容:表格、文档、幻灯片、关系表、画布、PDF,浏览器和 Node.js 同构。它的 AI SDK 是给 Agent 用的 Node.js 入口,官方原话:让 Agent 能够加载、理解、修改、检查一份文档。
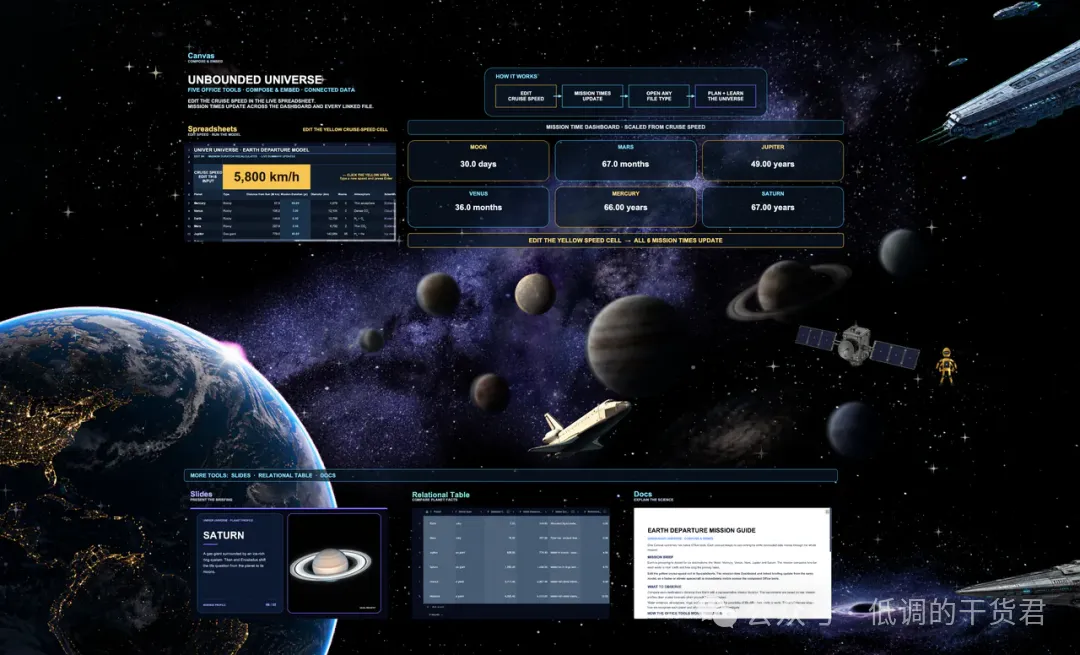
图 1:一套运行时承载六类内容(来源:univer.ai 官网)
Agent 操作一份表格,官方给出的最小循环是:load → pull → inspect → execute → commit。五个词,每个都在拆一个老问题。
inspect 让 Agent 先看结构——工作表标识、已用区域、有多少规则和图表,一次拿全,不用在文本里翻找。api find 是本地 API 索引,Agent 不确定该调哪个方法时直接查,不用联网翻文档。
execute 跑的是引擎自己的 Facade 代码,改的是真实单元格。文档里专门强调一句:执行成功只代表代码运行了,不代表改动已提交,要等 commit 确认——它把“改”当成可核对的事务,不是拿返回值就当成了。
文档里有个判断很实在:结构化输出无法完整描述页面布局。表格值改对没有,数据层面能核对;排版乱不乱、图表挡没挡住数据,读 JSON 是看不出来的。
所以 AI SDK 配了两个东西:Screenshot 把渲染后的页面截给 Agent 看,Layout Lint 直接输出结构化的布局诊断。Agent 改完一版,自己截个图、跑一遍 lint,有问题就再改一轮——这套闭环现在有官方代码和文档了。
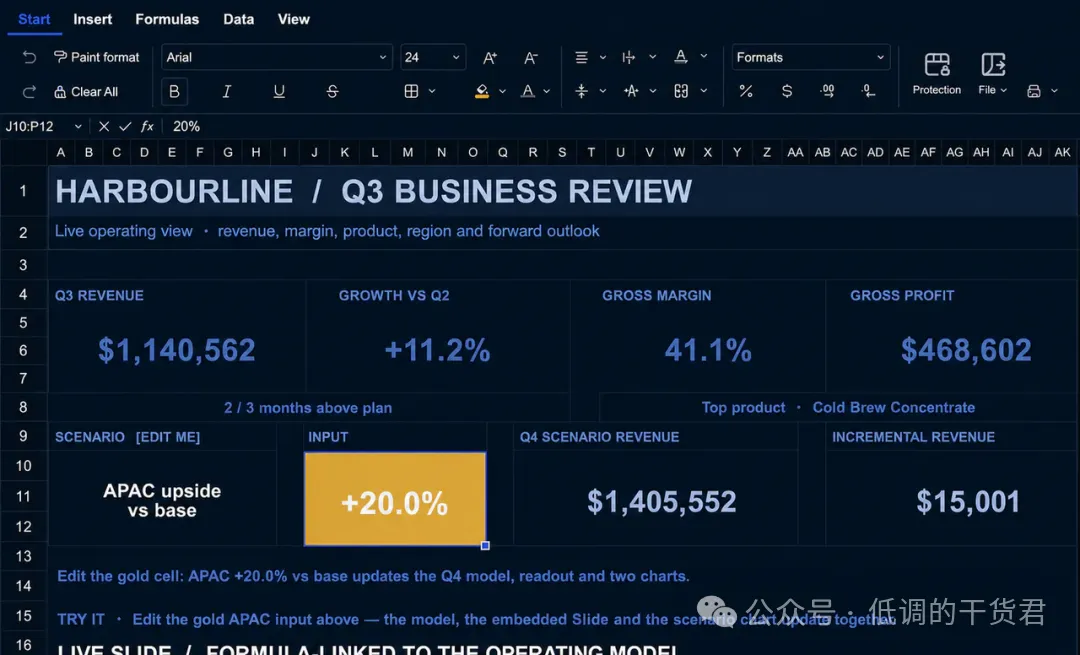
图 2:Agent 自查时看到的,就是这种渲染后的页面,不是一串 JSON(来源:univer.ai 官网)
性能上官方给的口径是百万级单元格加载、六百万单元格 50–60 FPS 滚动,这个数字我没法在本机复测,你按官方说法听。倒是官网首页把 Claude Code、Codex 这些 Agent 客户端的 logo 摆在显眼位置——它对标的从来不是 Excel,是那些会动手的客户端。
敢让 AI 直接写生产表格吗?出错谁负责?
这个担心不多余——表格不是文案,写错一格就是数据事故。所以官方在这套设计里把权限切成了两半:读和写是不同模式,read 模式禁止任何改动;write 只产生 mutations,提交要单独确认;改完还能截图自查。多数表格需求是读——统计、核对、汇总,把它放在只读通道里,风险就低一个量级。
另一半答案是 Worktree。Agent 的改动先落在一个隔离的草稿里,有独立的快照、独立的版本历史,和主干互不影响。它可以在草稿里改很多轮,改到满意后标记 Ready,再由人在 Web 界面里看渲染好的页面,选 Merge 合进主干,或者 Reopen 打回重改。
它特意声明这个 Worktree 不是 Git 的 worktree,但思路是同一个——代码世界的“Agent 提 PR、人来 Review”,被搬到了文档世界。而且 Merge 仍要走主干的授权和提交边界,Agent 的权限到草稿为止。
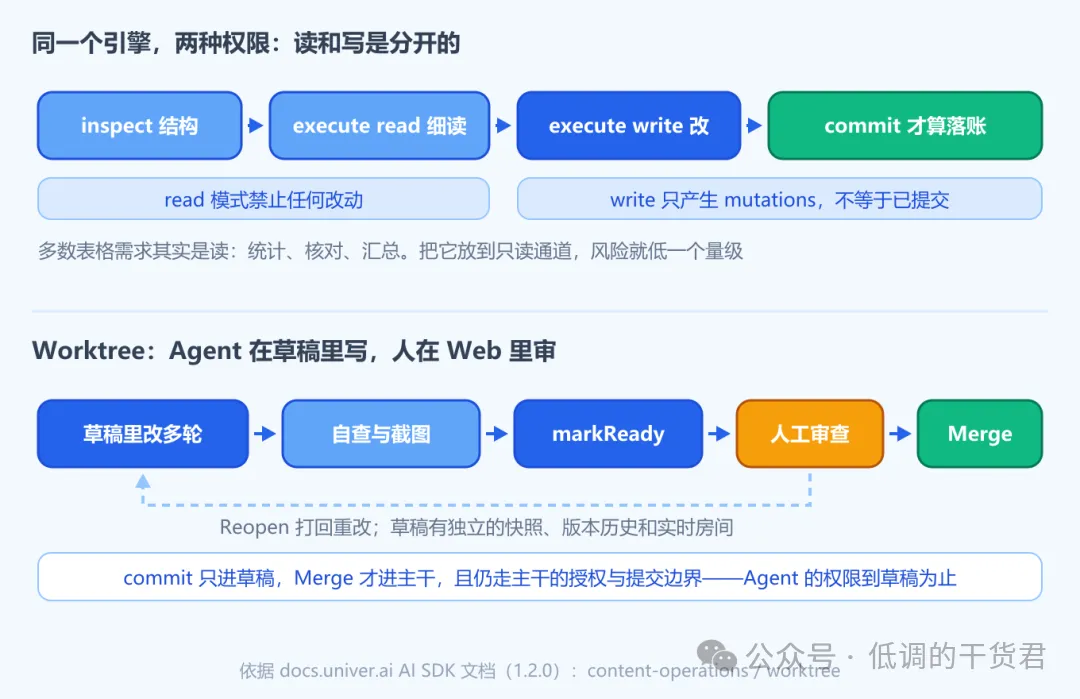
图 3:读写的权限切分,与 Worktree 的审查闭环(依据官方文档自绘)
适合的:脏数据清洗、批量报表、跨表核对——尤其先用只读通道做统计和差异比对,AI 给你一份结论,你看完再决定要不要让它落笔。别碰的:核心结算、资金口径、审计留痕这类错了要追责的数据,哪怕它在草稿里跑得再顺。
回到开头的实验。以前的答案是模型回你一段脚本,你审、你跑、你兜底;现在的答案是:引擎收到指令,改在草稿里,截图自查,冻结待审,最后等一个人点 Merge。脚本模式把风险全留给你,引擎模式把审查焊进了流程里。
模型终于不必隔着翻译件工作。引擎等着被调用,单元格第一次成了 Agent 可以直接下指令的对象——从改影子,到改本体。