ARTICLE · 1289804
这个模型把 PDF 和图片变成 AI 能直接读的数据
AI资源夹
而且 免注册 免 Key
13 亿参数,三项基准第一。免费 API 免注册,我实测 41 秒还原一张 40 行的表。
它干的事,一句话:把文档变成 Agent 友好的数据。
这是官方原话。PDF、截图、扫描件进去,Markdown 或 JSON 出来。带版面坐标,能直接喂给 AI。
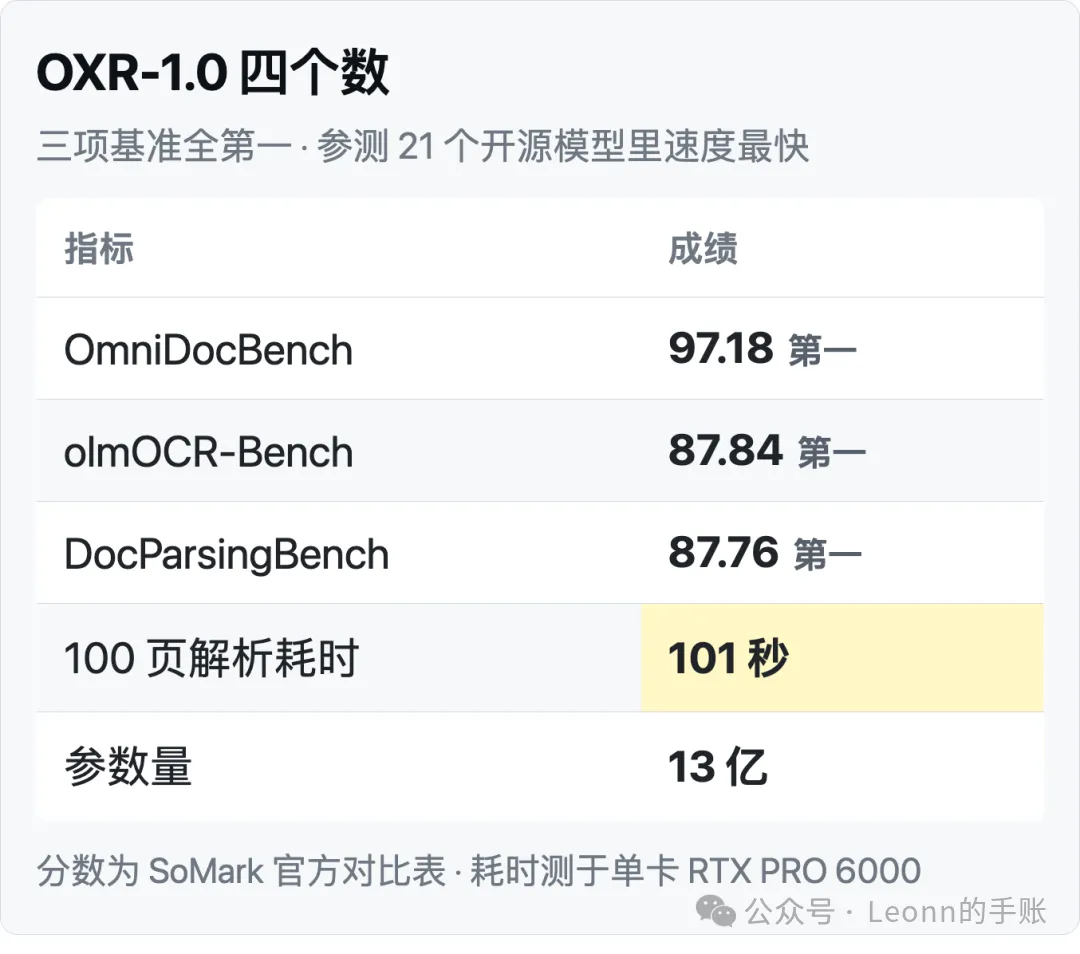
三项基准与速度
13 类元素它都认:正文、标题、表格、公式、印章、代码块、化学方程式 (・_・;)
评分4/5
今天就值得试一次。
关键信息:OXR-1.0 只有 13 亿参数,三项文档解析基准全第一;官方免费 API 免注册免 Key,单次上限 10MB / 20 页,要排队。
12个例子
官方放的,我原样搬。
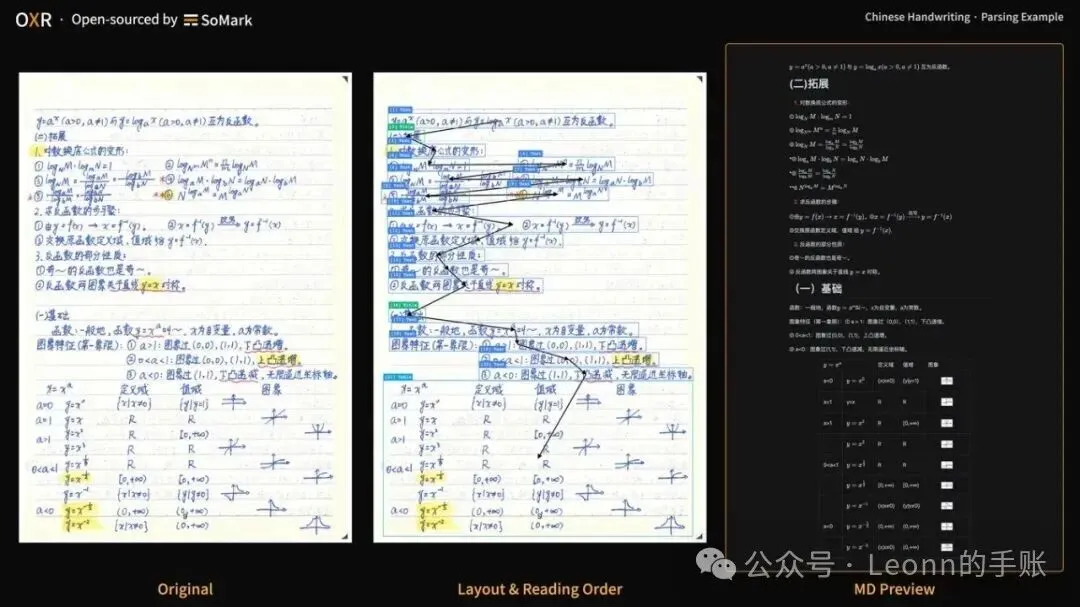
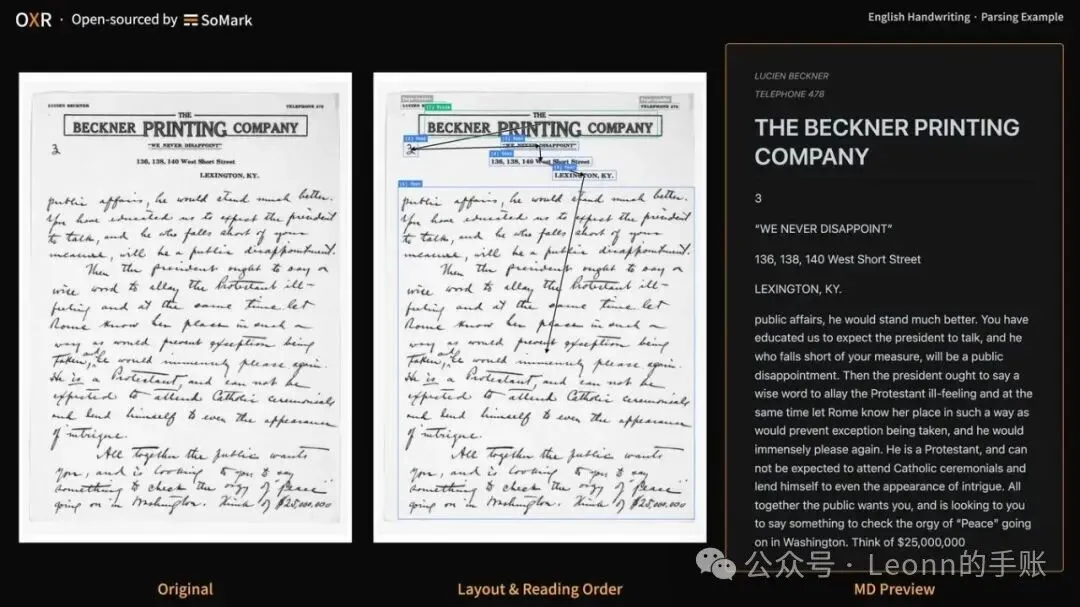
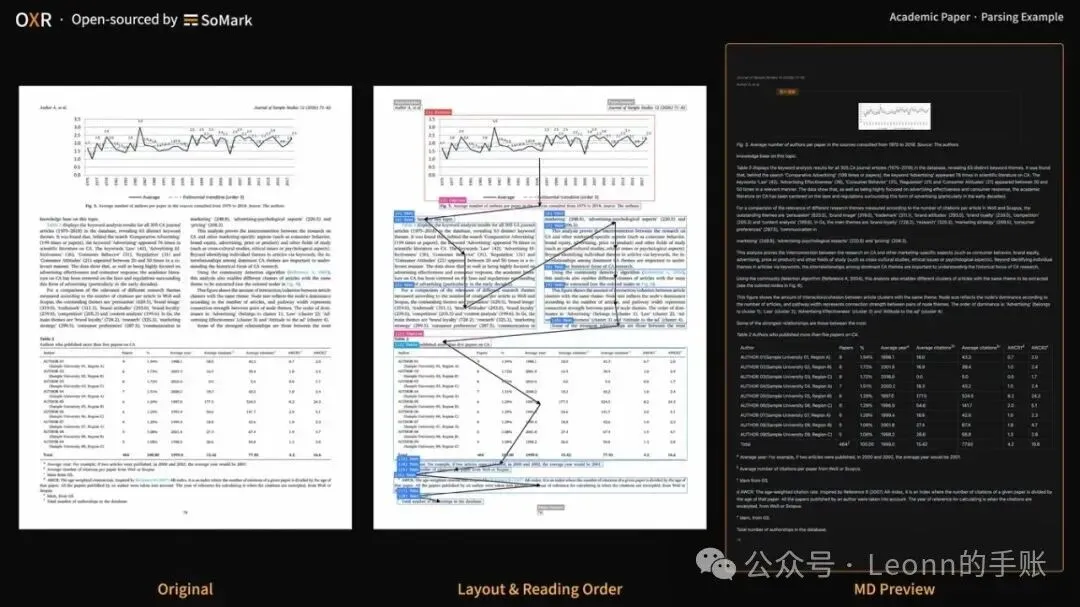
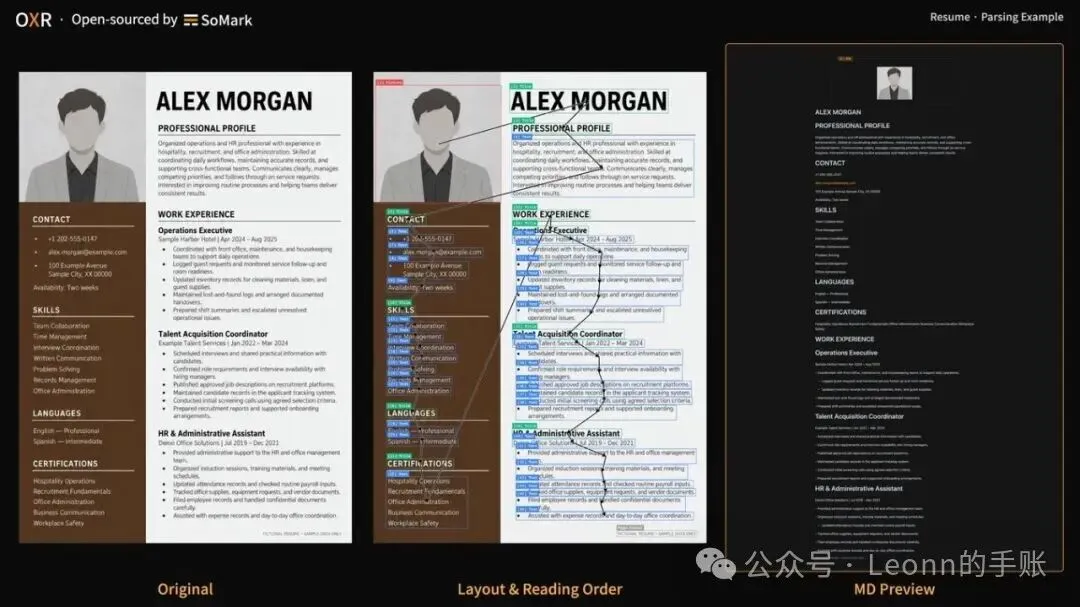
每张都是三栏:左原始文档、中间框线标注、右边转出来的代码。
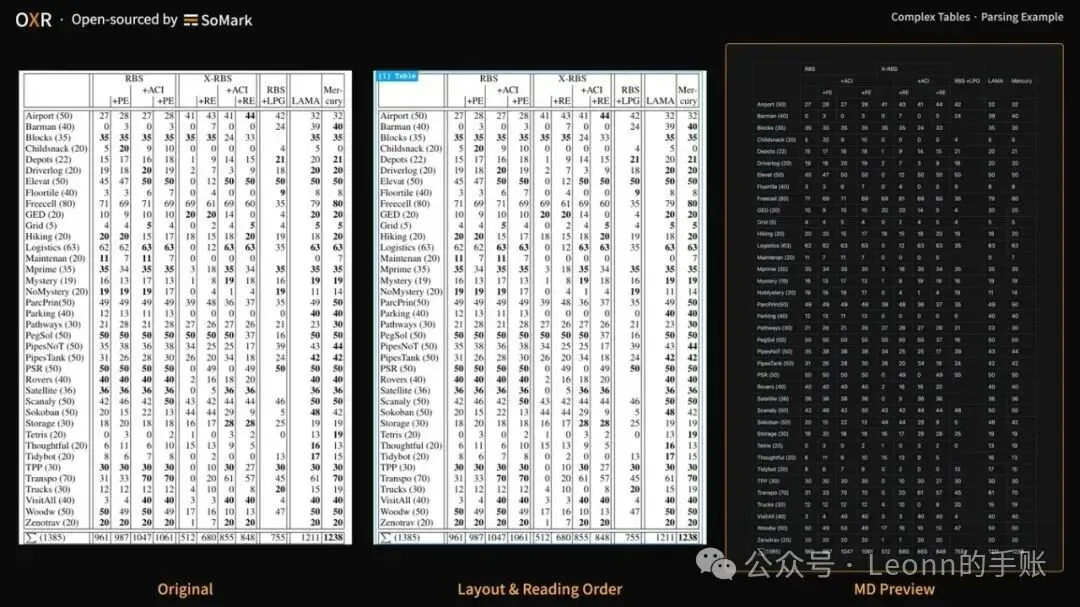
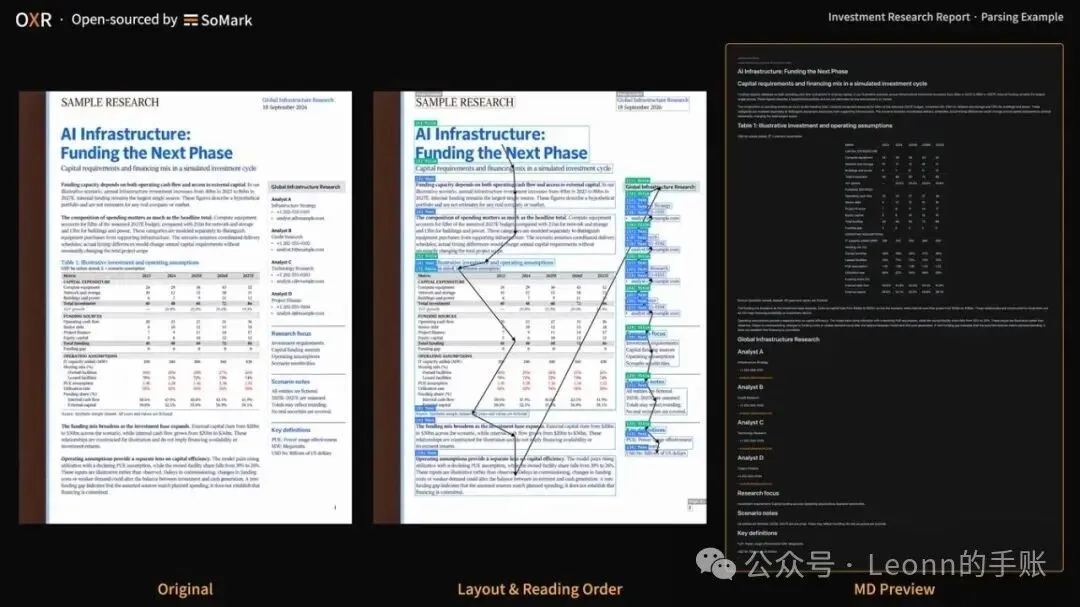
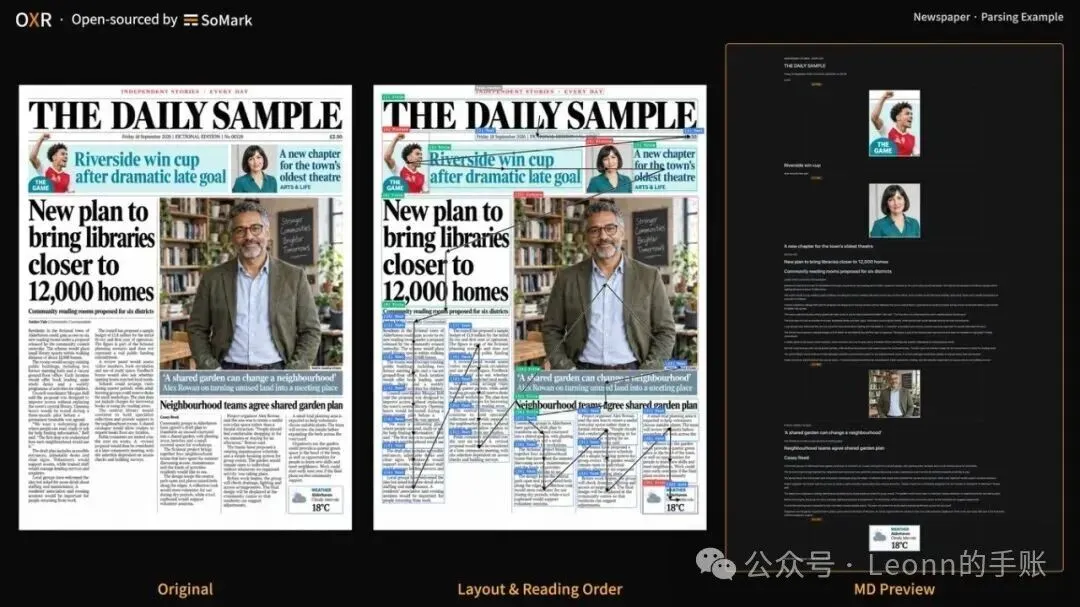
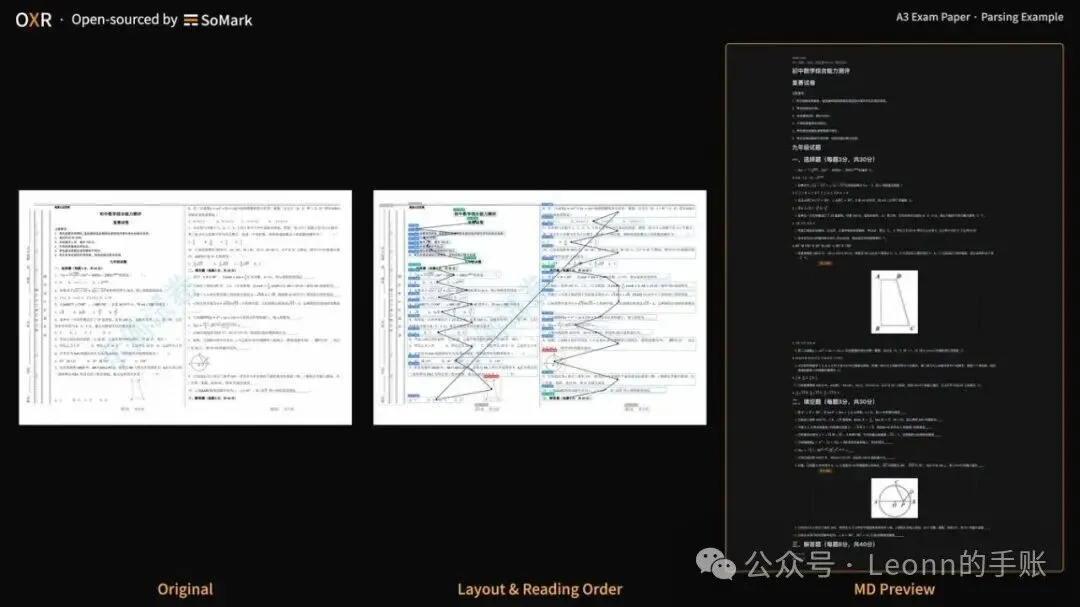
这四张是表格和版式。
复杂表格,40 行 10 列,三层表头。
研究报告,多栏 + 表格 + 脚注。
报纸,多栏、竖排标题。
A3 试卷,双栏 + 手写 + 公式。
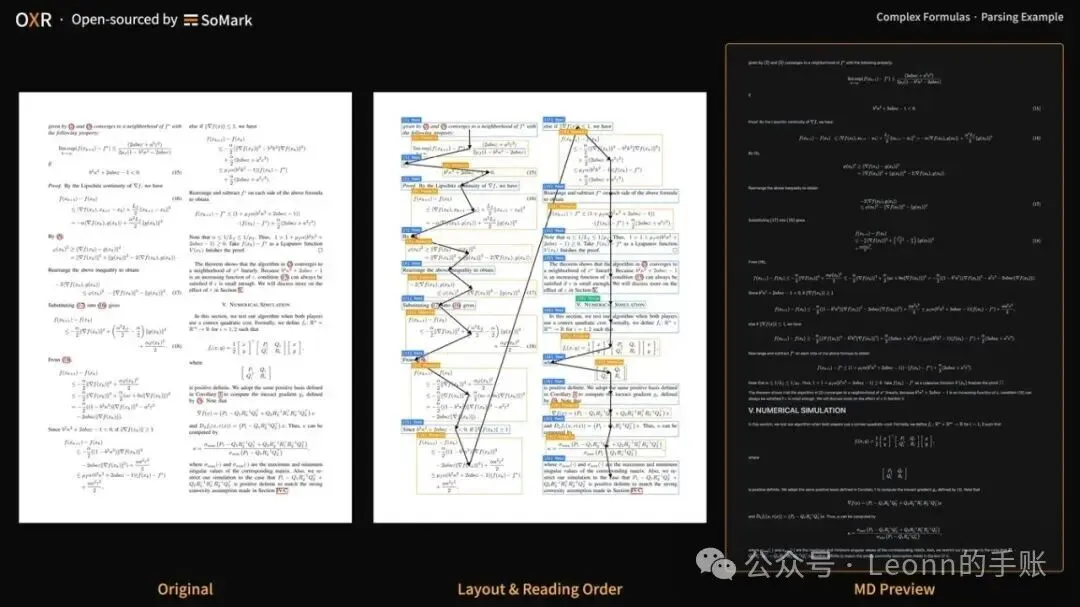
这四张是公式和代码。
复杂公式。
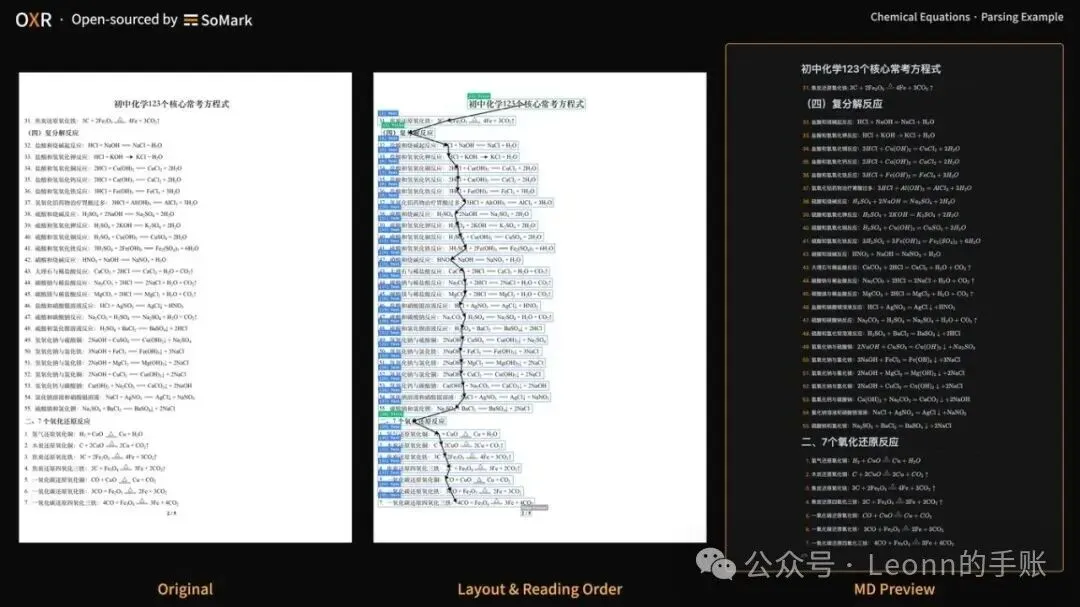
化学方程式,转 mhchem 语法。
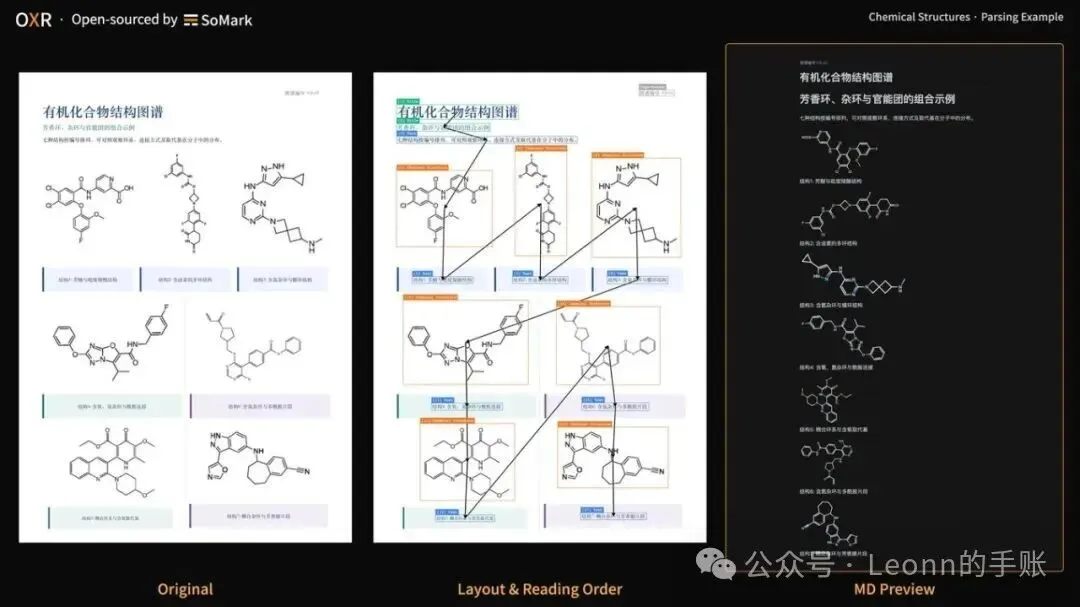
化学结构式,转 SMILES。
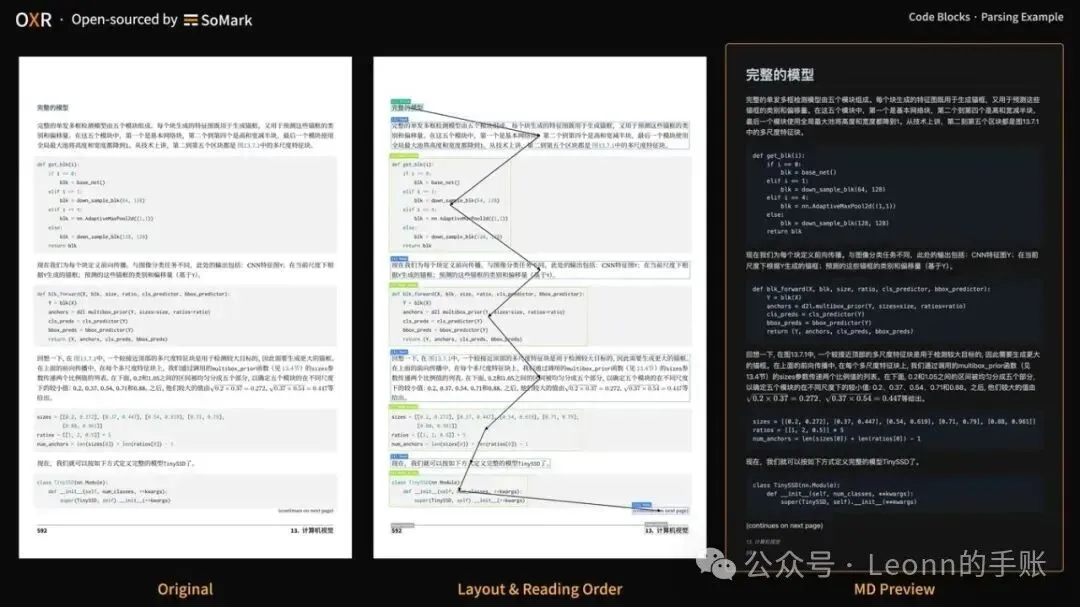
代码块,带缩进。
这四张是手写和杂项。
中文手写。
英文手写。
学术论文,双栏 + 公式。
简历,复杂分栏和小字。
为什么 13 亿就够
同场的 PaddleOCR-VL、MinerU 都是几十亿级。
它用一个零头大的模型,把三个榜都拿了 (*^▽^*)
官方说它在表格解析上领先幅度最大。
秘密在训练:后训练用了「递归自我改进」。
自己解析、外部模型判错、按错因聚类、造下一轮数据。
全程不用人工标注 (゚Д゚)
一句话:模型自己的错题本,自动变成下一轮的复习重点。
我实测
裁出它那张复杂表格,丢给免费 API。
41 秒,还我一张 42 行的表。
数字一个没错。
三层表头的合并关系也保住了:RBS 跨 4 列,X-RBS 跨 4 列,底下 +ACI 再跨 2 列。
连原图那个空白单元格都留了空 (゚Д゚)
怎么用
免注册。免 Key。Key 的位置填 dummy。
国内 https://free-oxr.somark.cn/api/v1
命令行一条:
pip install somark somark --base-url https://free-oxr.somark.cn/api/v1 --api-key dummy \ parse 你的文件.pdf --formats md,json --out ./parsed-output/不想装包,官网有在线 Demo,传图就能看结果 (๑•̀ㅂ•́)و✧
三个提醒
一、单次 10MB / 20 页。
超了自己拆 ( ̄ω ̄;)
二、快慢全看排队。
8 秒和 66 秒都是它。
官方自己写了「不保证稳定性」 ( ̄▽ ̄)ノ
三、分数是团队自测。
没见到第三方独立复现。
97.18 只代表这套固定题,它最高 (・_・;)
结尾
开源一周,GitHub 破 1000 星。
但别把它当 OCR 的升级版。
它干的活,是把纸上的文档翻译成机器能接住的结构。
网址:https://free-oxr.somark.cn/
GitHub:https://github.com/SoMarkAI/OXR
实测时间:2026 年 10 月 31 日
我是 Leonn,供应链的表格我核了三年,所以看到 13 亿参数就能把跨行跨列读对,比看到分数更来劲。