ARTICLE · 1291991
101 秒读完 100 页 PDF,全球第一竟是个 1.3B 小模型
AI 圈都在卷更大的模型时,一个做了三年文档智能的国产小团队反着来,开源了一个只有 1.3B 参数的小模型 OXR,专管一件事,让 AI 读懂你的 PDF。结果三个全球榜单全拿了第一,解析速度也是第一。开源一周,GitHub 破千星,X 上百万围观。
先说这个模型是什么来头。
OXR,全称 Optical Everything Recognition,是国产团队 SoMark(守扣科技)开源的文档解析模型。主模型只有 1.3B 参数,在 OmniDocBench、olmOCR-Bench、DocParsingBench 三个全球文档解析基准上全部第一,这三个榜单相当于文档解析界的统考。按官方公布的评测,它解析 100 页文档只要约 101 秒,速度同样排第一。
10 月 21 日团队在 X 上发帖官宣,一天破百万浏览,登上了当日科技新闻推荐位。开源一周,GitHub 星标破千。
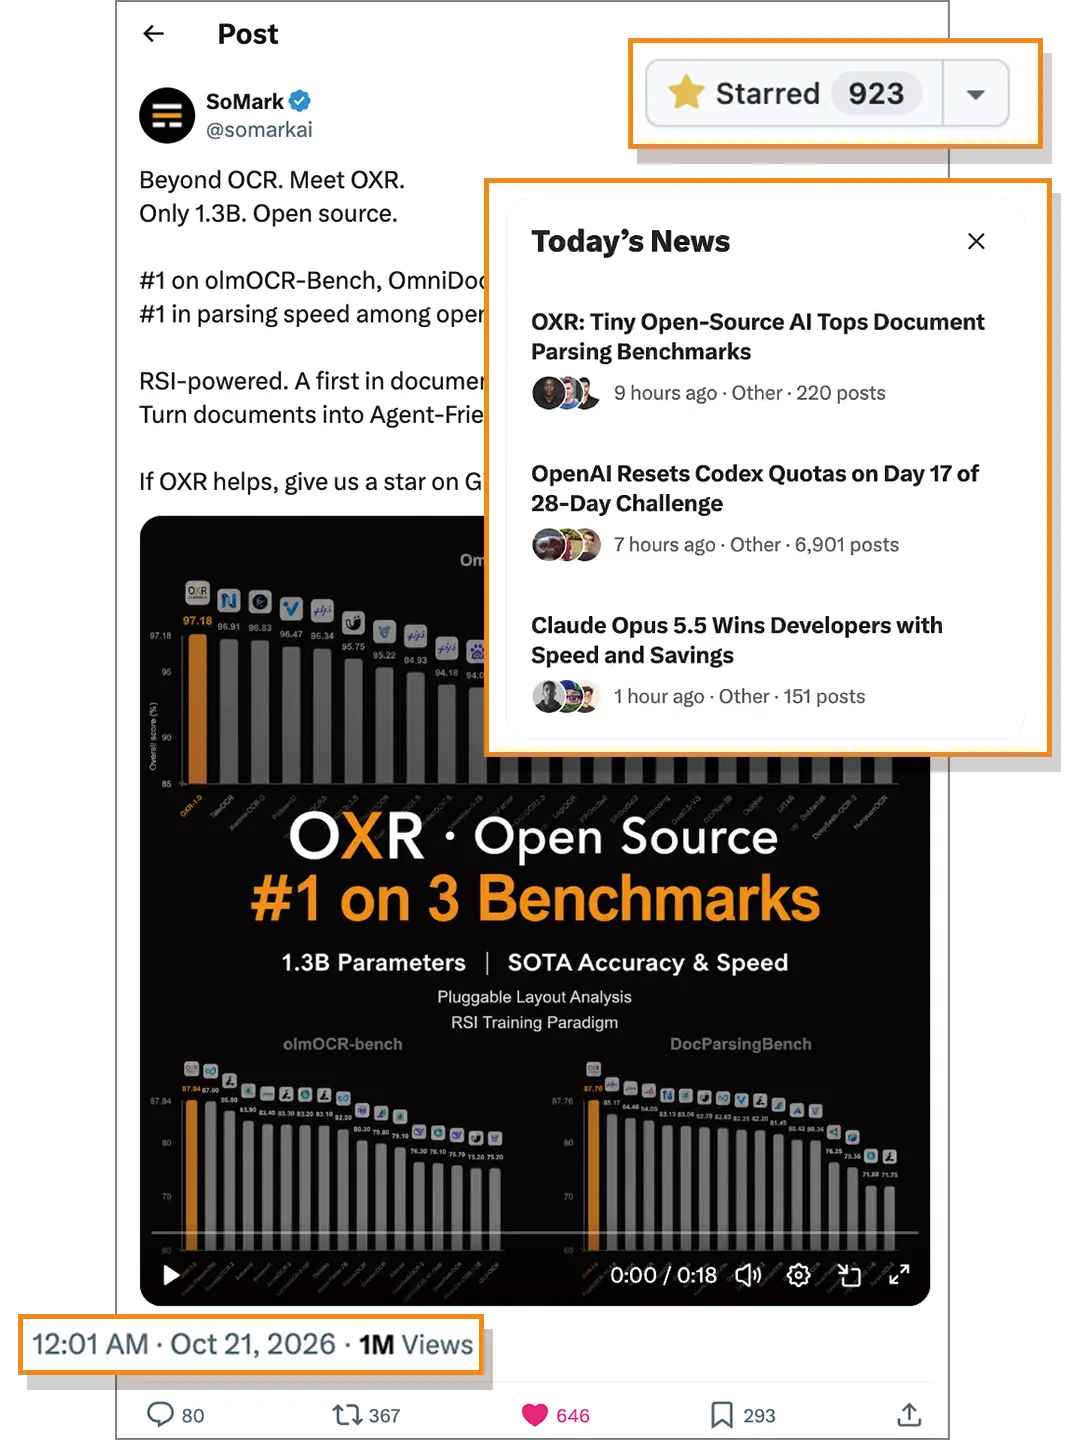
团队在 X 上的官宣战报,一天百万浏览(图源 SoMark 官方)
它解决的是个藏在幕后的问题。AI 圈这两年都在聊 Agent,聊智能体帮你干活。但智能体要干活,第一步是读懂材料,而你公司的材料,八成是 PDF。合同、研报、财报、论文、试卷,全是排版复杂的文档。AI 读不读得懂它们,直接决定了后面一切的上限。
今天这篇,讲清楚 OXR 是什么、凭什么、怎么用。
CHAPTER ONE
01
读文档,从来不只是认字
很多人以为文档解析就是 OCR,把图片上的字抠出来。真正的难点在字以外。
比如一张跨行跨列的表格,每个字都认对了,但行列关系错一格,「净利润」三个字对应的数字就张冠李戴。一份数学试卷,公式里有上下标和嵌套结构,识别完变成乱码。一页报纸有七八个栏,左右串着读,内容就全毁了。
OXR 名字里的 XR,指的就是这些文字以外的东西。官方的说法是,它能识别 13 类文档元素,文字、标题、表格、公式、化学方程式、化学结构式、代码块、印章等等,并且每一样都给出了计算机能继续处理的表达。
表格解析出来是 HTML,行列和合并单元格都在。公式输出 LaTeX。化学方程式用 mhchem 语法,分子结构图输出成 SMILES 字符串,也就是化学界的通用编码。代码块保持高亮结构。
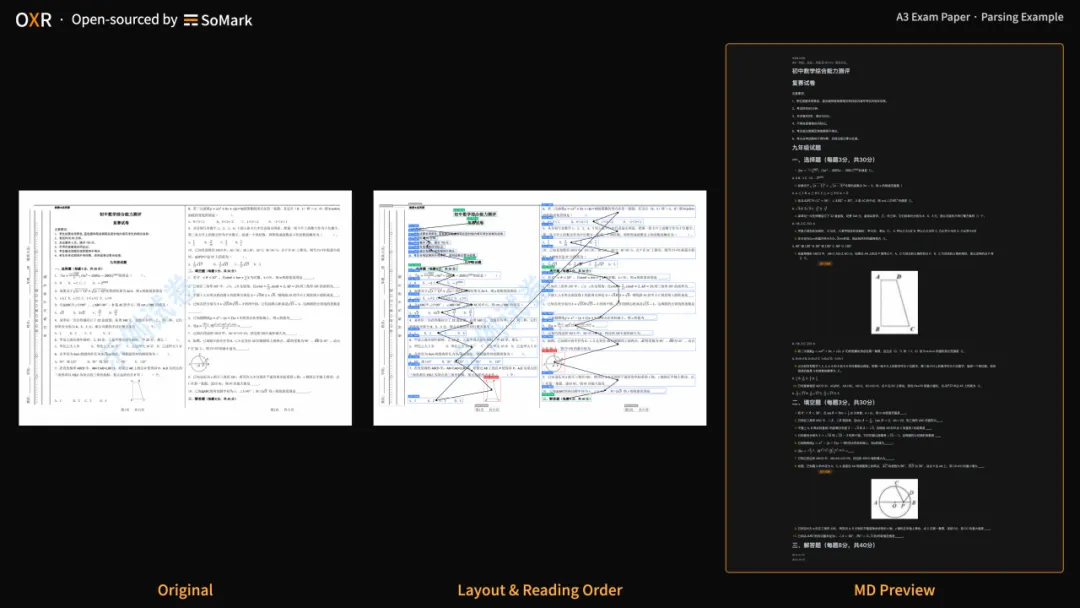
更关键的是阅读顺序。OXR 识别内容的同时判断先读哪块后读哪块,还给每个区域标上坐标。多栏论文、报纸、A3 大试卷,都能按正确顺序还原成一份 Markdown 或 JSON。
官方放了多组三联演示图,原图、版面还原、输出结果并排对比。中文手写的数学笔记、英文报纸、A3 试卷、代码教材,连手写的推导过程都能理顺。
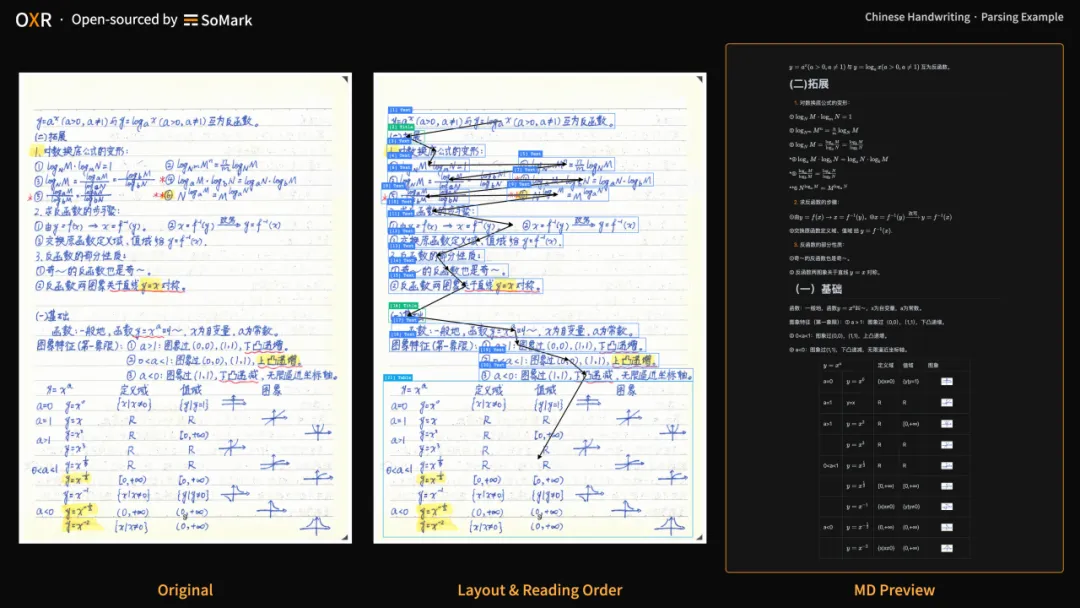
中文手写数学笔记的解析三联图,原图、版面还原、输出结果(图源 SoMark 官方)
CHAPTER TWO
02
三个第一,速度也是第一
看官方公布的评测数字。
97.18 OmniDocBench 第一 | 87.84 olmOCR-Bench 第一 | 87.76 DocParsingBench 第一 |
三个榜单都是第一名,其中表格解析子项的优势最明显。评测脚本和完整数值放在仓库的 benchmark 文档里,可以复现。
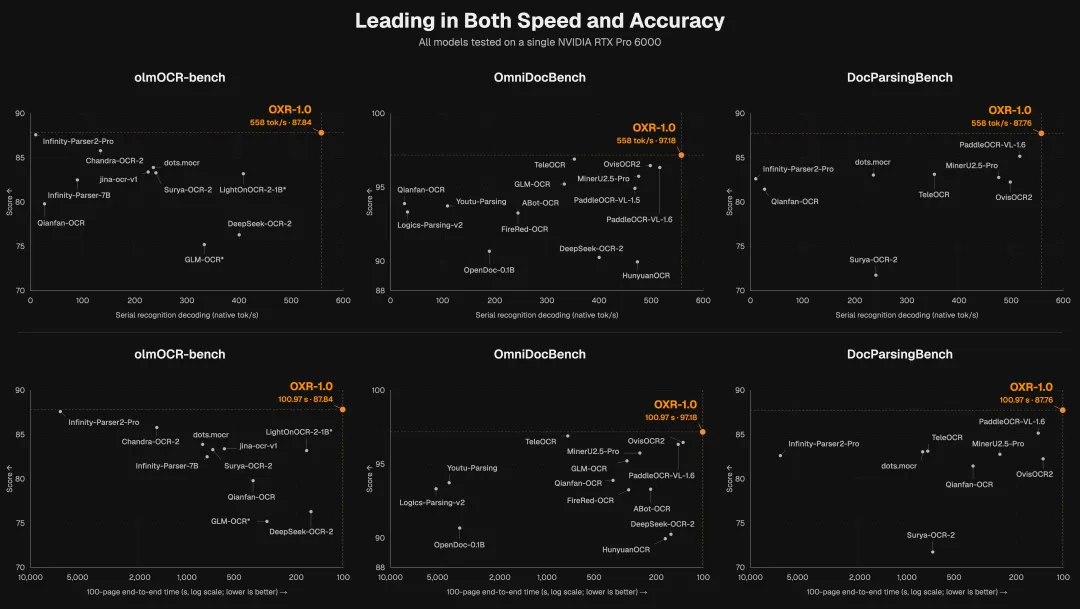
官方发布的精度与速度双 SOTA 对比图(图源 SoMark 官方)
速度更意外。1.3B 的模型,在单张 RTX PRO 6000 显卡上完整解析 100 页文档,平均 101 秒。同场对比,PaddleOCR-VL-1.6 要 145 秒,MinerU2.5-Pro 要 255 秒,都是这个赛道里响亮的名字。
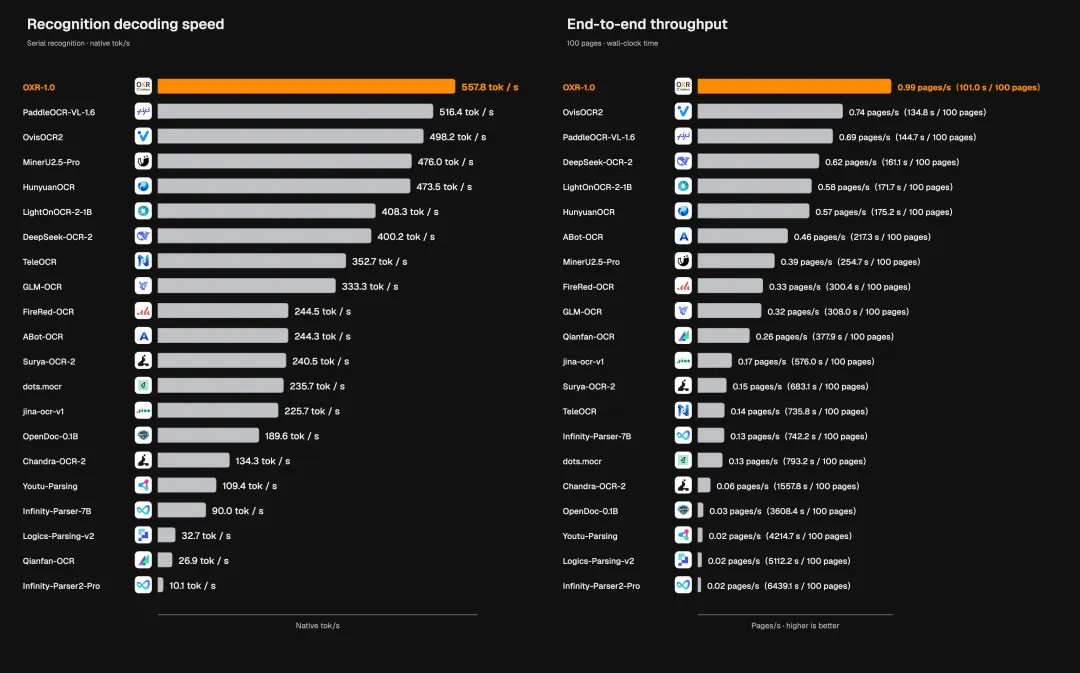
解码速度 557.8 tok/s、整册吞吐 0.99 页/秒,均排参测开源模型第一(图源 SoMark 官方)
读得最快,还读得最准。官方放了一张六联散点图,三个基准各两维度,OXR 全部在右上角,精度和速度的帕累托前沿上只有它。这里要注意一句,这些第一是官方公布的评测结果,脚本开源可复现,但榜单之外的文档,还是建议拿你自己的材料实测。
CHAPTER THREE
03
两个值得记住的设计
OXR 有两个设计,比分数更值得聊。
第一个叫 RSI,递归自我改进。传统做法里,模型解析错了,人工标注新数据,重新训练,一轮几个月。OXR 的流程是,模型先解析一批没有标注的文档,另外几个 AI 模型当裁判,找出错样本和弱样本,按错误原因聚类,再自动生成下一轮的训练数据。整条闭环不用人工标一张图。
官方称这是 RSI 范式第一次用在文档解析上。讲直白点,让 AI 自己批改自己的作业,把错题自动整理成下一轮的教材。
RSI 训练闭环示意,预测分类、归因与训练规划、数据生成(图源 SoMark 官方)
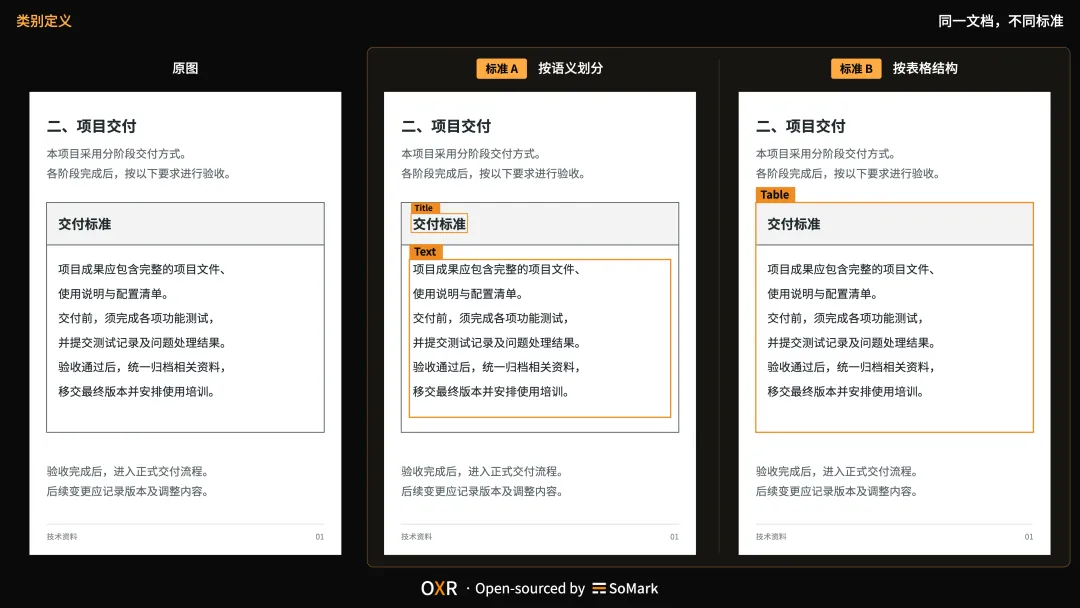
第二个是版面分析独立可插拔。同一个文本框,有的业务想拆成标题加正文,有的想整体当表格,这类差异不是模型读错了,是各家对「怎么算一块」的定义不同。OXR 把版面分析做成独立模块,你可以换成自己公司的版面模型,识别和阅读排序的能力照用。
官方给了一张「同一文档,不同标准」的对比图,一页文档,标准 A 把插图当一个整体,标准 B 把图和文字分开标注,两种都对,看业务要哪种。
同一页文档在两种版面标准下的不同切法(图源 SoMark 官方)
架构上还有个小巧思,轻量的版面模型负责定位区域,主模型在识别内容的同时顺带判断阅读顺序,省掉了单独排序的一道工序。
CHAPTER FOUR
04
怎么用
门槛不高,四条路任选。
想先看看效果,官方有在线 Demo,上传 PDF 或图片就能看 Markdown 预览、版面框和阅读顺序。
想批量处理,有免费 API,国内海外各一个地址,不用注册、不用申请 Key。官方也把丑话说在前面,免费服务有排队机制,不保证稳定性,不建议上生产。
想自己部署,模型权重在 Hugging Face 和 ModelScope 都有,1.3B 一张消费级显卡就能跑,Docker 一条命令起服务,也支持源码部署。
想上生产,同团队的 SoMark 是生产级文档解析引擎,支持更多格式,每月有 2000 页免费额度。
CHAPTER FIVE
05
冷静的几句
夸完了,说几句公道话。
榜单第一是官方公布的口径,好在评测可复现,这点比很多项目强。但 1.3B 的小模型,语义理解的深度总有上限,复杂推理类文档的表现,等更多第三方实测。免费 API 的排队和稳定性,也决定了它适合尝鲜,不适合关键业务。
另外,这个赛道并不空。PaddleOCR、MinerU 都是成熟选手,生态和使用习惯摆在那。OXR 用分数和速度把门敲开了,接下来拼的是社区和迭代速度。
背景提一句,SoMark 团队做文档智能三年,没有转过方向,拿过原子创投、奇绩创坛的天使轮。开源模型算力、数据、调优都由团队承担,他们把话写在文末,一个人的反馈,会成为更多人用得上的改进。
EPILOGUE
∞
小模型的一堂课
最后说说我觉得最有意思的地方。
这两年看多了几百亿几千亿参数的大模型军备竞赛,OXR 反着来,1.3B,小到一张游戏显卡就能跑,结果在垂直领域把一群大模型按在榜单下面。
它的启示不在参数,在方法。RSI 那套流程,本质是把「犯过的错」自动变成「下一轮的教材」,错误越多,教材越厚。这对所有做 AI 产品的人都是提醒,你的产品每天产生的失败案例,可能就是最被浪费的资产。
再往深一层说,文档是人类几千年知识的容器,Excel、PDF、试卷、研报,全是。Agent 时代最缺的不是聪明的脑子,是读文档的眼睛。眼睛越小、越便宜、越普及,AI 才越能走进普通公司的日常。
文档解析是第一步,OXR 是这第一步里的一个新选手。后面谁来领跑,看迭代。
仓库地址,GitHub 搜 SoMarkAI/OXR,在线体验 free-oxr.somark.cn。你手头有没有 AI 读不懂的文档,评论区描述一下,看看它接不接得住。
— END —
数据来源|SoMark 团队官方发布、OXR 开源仓库(GitHub、Hugging Face、ModelScope)及量子位等报道