ARTICLE · 1292456
文档解析这一层,决定了RAG的天花板
项目复盘会上,模型组把图表摊得很漂亮:检索命中、答案相似度、用户满意度。质量经理问了一句扫兴的话:「为什么图纸标题栏上的材料,助手总是答错?」
Silence. 有人去翻日志,发现扫描件OCR把「材料」栏识别飘了;有人去翻切片,发现表格结构早在解析阶段就平铺成了乱序文本;还有人发现巡检视频里的关键帧根本没进知识库。
模型没错,检索也勤快。天花板在更下面:图纸、表格、扫描件、视频巡检记录,多模态解析失败会静默降级成答不上来;多数RAG项目死在解析,不在模型。
一、静默降级比公开失败更可怕
解析失败若直接报错,团队还会修。更常见的是静默降级:解析器吐出残缺文本,管道继续跑,索引继续建,Agent继续答——只是答在残缺世界上。
对业务来说,这表现为「有时准有时不准」;对系统来说,这是质量债务被自动化放大。你很难用一次坏案例说服采购换模型,因为模型不是根因。
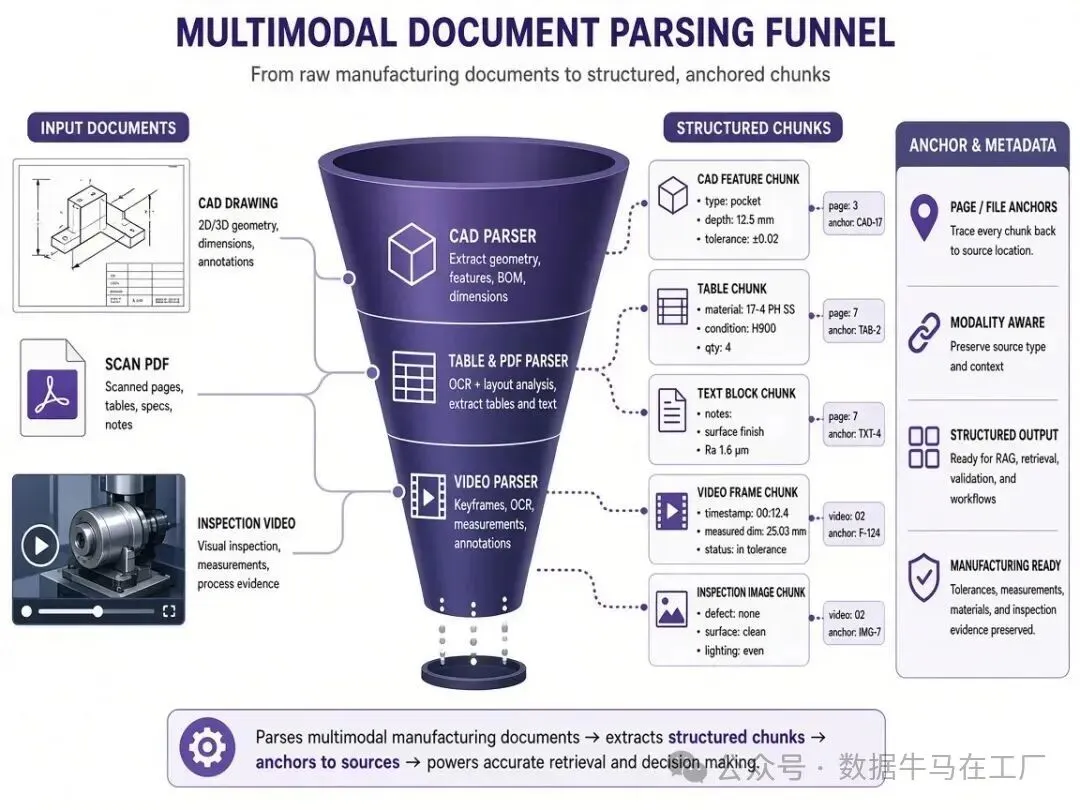
制造业文档天然多模态:CAD与PDF并存,表格嵌套,蓝图扫描,手写修订,视频与图片证据。哪一层解析偷懒,哪一层就变成天花板。
二、解析层到底要交出什么
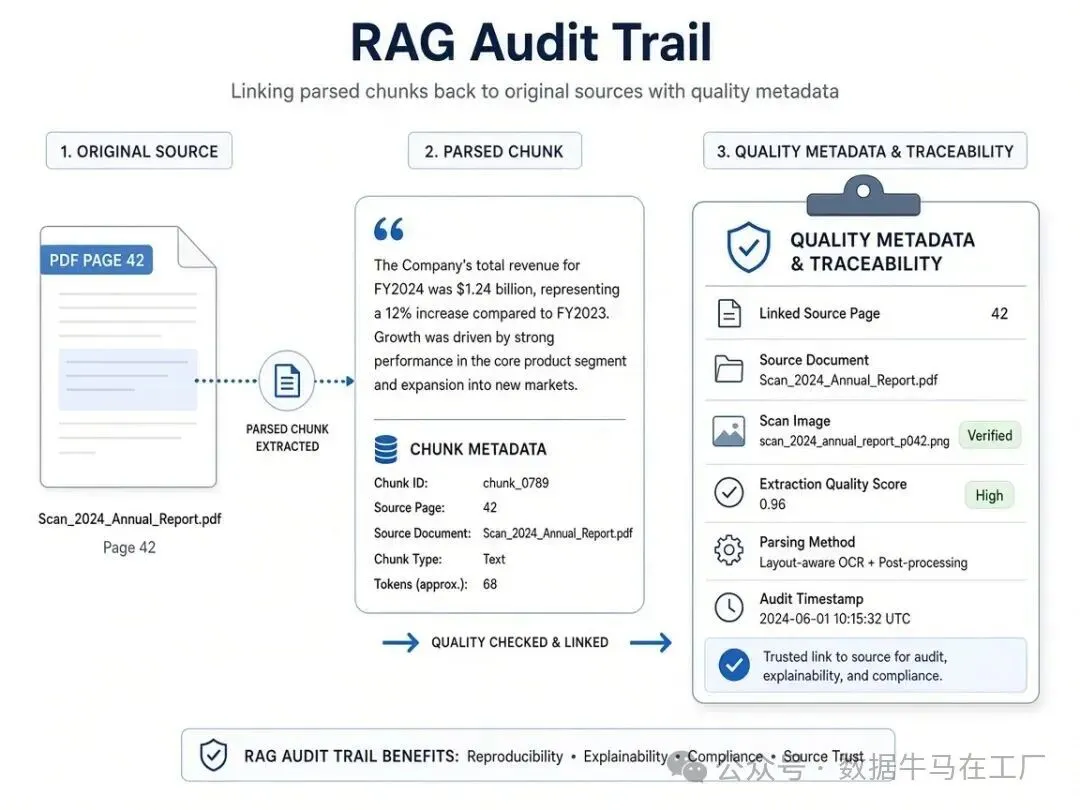
不是「有文字就行」。对RAG友好的解析结果,至少应包含:
- 结构
:标题、段落、列表、表格、视图、图注; - 锚点
:页码、坐标、图纸视图号、视频时间戳; - 类型
:正文/表格/公式/尺寸公差/警告; - 置信度
:OCR与版面分析的质量分; - 溯源
:能点回原文影像,而不是只剩一段漂浮文本。
缺锚点的知识库,像去掉页码的试卷——你能读,但无法对质。
三、坑一 / 坑二 / 坑三
坑一:把OCR当解析完成
OCR只是字符层。表格列对齐、跨页表、多栏布局、图中文字,不处理就会在后续切片里毒化上下文。字符对了,结构错了,照样害人。
坑二:解析质量不进门禁
很多管道「能跑通」就入库。应设门禁:关键栏位抽取成功率、表格完整率、低置信度页占比。不达标的文档进隔离区,而不是进生产索引。
坑三:视频与图片当附件扔着
巡检视频、缺陷图、装配短视频,往往只当下载附件。对Agent来说等于不存在。关键帧、字幕、检测框、测量读数,需要结构化后才能进RAG。否则你的多模态口号只是存储多模态。
四、核心观点
文档解析这一层,决定了RAG的天花板。模型决定文采与推理弹性,解析决定世界是否完整。世界残缺时,弹性只会让你更自信地站在坑里。
把预算从「再换一个模型」挪一点到「解析与质检」,常常是更工程师荣誉的选择。
五、怎么做:Step 1–5
Step 1:盘点文档模态与失败模式
列出知识库里的PDF扫描、原生PDF、CAD导出、Office、图片、视频占比。对每类记录Top失败:乱码、表格崩、标题栏丢、页序错、关键帧缺失。
Step 2:解析输出契约化
定义统一中间表示:块类型、锚点、置信度、父子结构。不同解析器可以换,契约不能崩。契约是治理点,也是换供应商的底气。
Step 3:质量门禁与隔离区
低置信度、关键字段缺失、页码不连续,进隔离区人工或专用修复流。隔离区要有SLA,否则会变成垃圾场。
Step 4:溯源必须可点回
Agent回答引用块时,前端要能打开原页高亮或原视频时刻。不能点回的引用,业务不会信,审计也不收。
Step 5:解析指标进运营看板
把解析成功率、隔离率、锚点缺失率、模态覆盖率做成周报。RAG运营若只看「回答点赞」,你会永远晚一步发现天花板。
六、与数据治理的关联
非结构化数据要纳入元数据与质量管理,解析结果必须可追溯回原文页码。
这是把治理从库表延伸到文件与媒体。元数据不止文件名,还要有解析器版本、质检结果、有效期、密级。质量规则不止空值率,还有结构完整率与锚点可用率。
治理团队若缺席解析层,AI团队会在下游用提示词补洞——洞会越补越大。
七、效果大概长什么样
因OCR/表格破坏导致的结构性错答下降; 业务对引用可信度上升(能点回原文); 新模态接入有契约与门禁,而不是野路子脚本; 模型升级的收益终于变得可感知——因为世界先变完整了; 审计与客户现场检查时,证据链更完整。
一句话:先把天花板抬高,再谈模型是不是够高。
我也见过团队在解析层做对之后,同一套不大的模型突然「变聪明」。聪明不是魔法,是输入不再残缺。残缺世界里的天才,仍然是残缺的天才。
八、给你的行动清单(本周就能做)
- 抽二十个错答案例,标注是否源解析问题
(表格、OCR、缺页、缺帧)。 - 给生产知识库加解析门禁字段
:置信度、锚点、隔离状态。 - 要求每个回答引用可点回原页或时间戳
:做不到就标「低可信」。
下篇预告:《从RAG到GraphRAG:质量追溯问答为什么必须走图》——当问题从「像什么」变成「连到哪」,只靠向量会不够。
我是做制造业数据治理的老兵。模型可以换,解析偷懒留下的天花板,会一直压着你的Agent抬头。
一个可立刻做的对照实验:同一份扫描工艺PDF,用「仅OCR平铺」与「版面+表格+锚点」两套解析各建库,固定模型与切片策略,比十道图纸/表格题。多数团队会在这个实验里重新理解预算该扔向哪里。
九、补充:解析器版本与合规审计
解析器也要版本化。同一份PDF,换了OCR引擎或表格模型,块内容可能变,索引却还挂着旧哈希。没有解析器版本号,出了错你无法复现「当时Agent到底看见了什么」。
对受监管行业或客户审计,建议保留「解析快照」:至少对关键质量文件,存下解析后的结构化结果与原文影像的对应关系。成本高于只存向量,但比审计现场讲不清出处便宜。
还有一个组织陷阱:解析被当成数据工程边角料,人力永远不够,预算永远后排。把它改写成「Agent世界完整度工程」后,优先级通常会上移——因为业务听得懂「世界残缺」。
最后给采购与安全的联合清单:解析链路是否出境、影像是否落库加密、锚点是否可能泄露未发布图纸。解析层既是能力层,也是风险层。能力没补齐前,先别让Agent在残缺世界上自由发挥。
实操上,我建议每周固定抽检二十页:人工点回锚点,看高亮是否落在正确栏位。抽检比再开一次模型评测会更接近真相。
附赠检查句:随机点开一条Agent引用,是否能在三秒内落到原页正确位置。不能,天花板就还压着你。
附赠检查句:随机点开一条Agent引用,是否能在三秒内落到原页正确位置。不能,天花板就还压着你。
附赠检查句:随机点开一条Agent引用,是否能在三秒内落到原页正确位置。不能,天花板就还压着你。
附赠检查句:随机点开一条Agent引用,是否能在三秒内落到原页正确位置。不能,天花板就还压着你。
解析与切片是上下游:解析残缺,切片再闭环也是闭环在废墟上;切片胡来,解析再完美也会被剁碎。两层要一起验收,不要只在模型层开庆祝会。
对于CAD,尽量保留语义导出(结构化尺寸、图层、明细),而不是只转一张扁PDF再OCR。能拿到原生结构却偏要走扫描件,是典型的自己把天花板砸低。
视频巡检建议最少做成:关键事件时间戳、画面文字OCR、检测结果结构化字段、与工单/设备的关联键。没有关联键的视频块,Agent很难在追溯问题里用上。
成本控盘上,我常见更划算的顺序是:先修表格与标题栏解析,再修低质量扫描增强,最后才是大而全的多模态大模型替换。哪里静默降级最多,钱就先砸哪里。
小组制度建议:指定「解析值班」角色,轮流处理隔离区文档,并在周会上用三张坏页讲故事。坏页故事比仪表盘更能让管理层批准人手。
一句话验收:解析层做好了,换小一号的模型也可能够用;解析层没做好,换大一号的模型也只是更贵地复述残缺世界。把这句话贴进立项评审,能挡住不少无效采购。
也别忘了人:解析质检需要懂工艺的眼睛,不只要标注员点框。关键页抽检名单里,每周至少请一位工艺或质量老师傅参加。他们指出的「这一栏才是要命」的位置,往往比通用版面模型更值钱。