ARTICLE · 1295085
314 个工具拆开软件,AI 照着重写一个
你有没有接过一个只有二进制、没有源码的活儿?想搞清楚它某个按钮点下去到底做了什么,正常路径是装 Ghidra、配 Java、等分析跑完,再去几十个函数里拼线索。这套流程光是准备工作就能耗掉一晚上,而且换台机器还得重来一遍。
这两天 GitHub 日榜上有个新项目叫 Craft Anything,走的是另一条路。它把整套逆向工具链写成了纯 Rust 引擎,官方预编译 CLI 不需要 Ghidra、不需要 IDA,拉下来就能把可执行文件拆成函数列表和结构化伪 C。更狠的是,它还接着让本机的 Coding Agent 照着这些证据,重建一个能跑的新版本。
拆软件这件事,本来不该这么重
我把官方 v0.2.0 的 macOS universal CLI 下载到 /tmp,第一条命令是自检。
# 下载官方 macOS universal CLI 后./craft-anything-cli doctor./craft-anything-cli --deep triage /bin/ls./craft-anything-cli --deep native-function-pseudocode /bin/ls 0x10000244ddoctor 的输出里,二进制、MCP 自检、浏览器、LLDB、objdump 都是 ok,Ghidra、Frida、mitmproxy 这些可选引擎显示缺失,但整体判定 healthy: true。这句话的意思是:你没有装任何逆向软件,这套工具也能开始工作。
接着对 /bin/ls 跑 triage,25 毫秒返回结果:Mach-O 可执行文件、x86_64、入口点 0x100000978,识别出 3 条动态库依赖。再跑 core-overview-show,它给出了 138 个函数、3689 条指令、101 个字符串、91 个导入符号和 852 个基本块。这些数字来自它自己写的 Mach-O 解析器、反汇编器和函数发现算法,不调用外部工具。
真正让我确认它不是个壳子的,是伪 C 输出。我挑了一个 239 字节、71 条指令的函数 sub_10000244d,让内置反编译器处理,返回的是一段带 if/else、局部变量和函数调用的结构化伪 C,而不是一堆汇编指令。输出里标了 structured: true、engine: clean-room lifter,两个无法内联的除法指令以 __asm 保留。
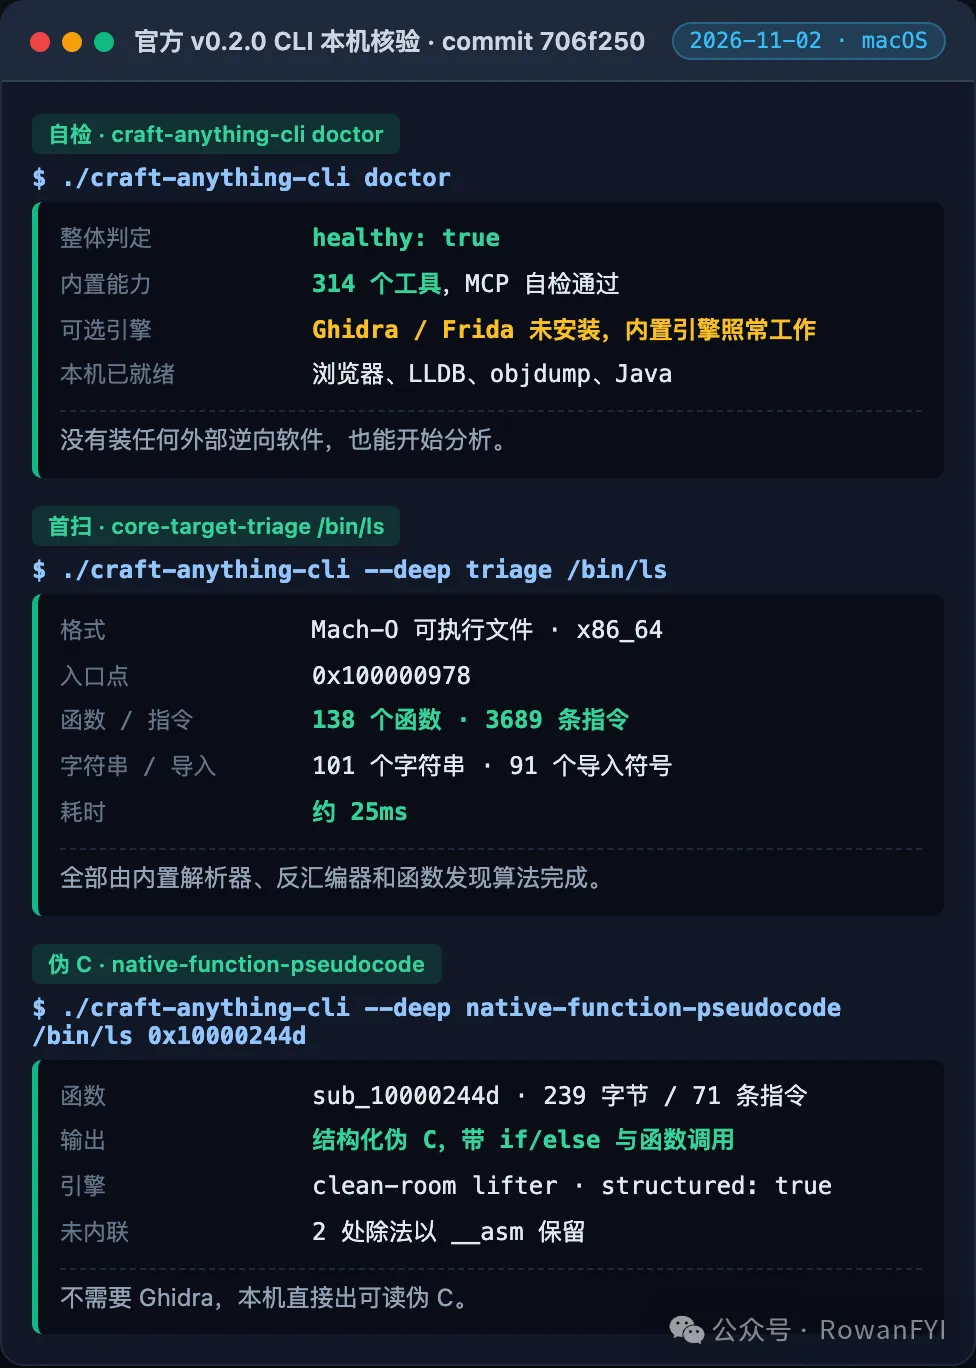 官方 CLI 在本机对 /bin/ls 做三连核验的真实输出
这个能力放到 Agent 工作流里价值很直接。你让 Claude Code 或 Codex 分析一个二进制,它不需要先学会用 Ghidra 的脚本接口,直接调这套工具的 MCP 命令就能拿到函数、字符串、交叉引用和伪 C。工具本身就是给 Agent 设计的,314 个子命令同时也是 314 个 MCP 工具。
聪明的地方,是把合规边界写进了白名单
官方 README 里有个很容易被忽略的设计:Clean room 和 Deep 两种模式。Clean room 是默认值,在这个模式下,工具完全不读目标的代码、文件和页面源码,只能看你提供的截图、网站访客能看到的布局、窗口画面和录制的运行过程。任何想往里面看的工具都会被拒绝,并且明确告诉你怎么切到 Deep 模式。
这个「默认拒绝」不是靠模型自觉遵守提示词,而是写死在代码里的工具白名单。我翻了 crates/engine/src/clean_room.rs,里面是一份 199 行的常量列表 TOOLS,只有列在里面的工具才允许在 Clean room 下运行,判断逻辑就是一行 TOOLS.contains(&id)。作者在注释里把规则写得很清楚:新增的工具默认属于 Deep-only,想进白名单得手动加进来。
这条规则对做安全评审的人应该很熟悉,它把「AI 会不会乱读我的东西」变成了一个可以审计的静态列表。你不用相信模型每次都记得住边界,只要看这个文件里有没有不该出现的工具名就行。
另一个硬核设计是证据台账。每跑一次工具,输出都会被记成一条 evidence,字段包括来源、置信度、覆盖范围、限制条件和可复现的环境信息。crates/evidence/src/lib.rs 里把证据 ID 定义为「除 summary 和展示名以外所有字段的规范化 JSON 的 SHA-256」,也就是说内容改一个字,ID 就变了,下游引用会对不上。
更细的一层在 carries_target_content 这个布尔标记。当一条结果里嵌了目标软件自己的字符串、源码或反编译文本时,这个标记会置为 true。注释里写得很直白:读者必须把这段内容当成来自不可信产物的数据,而不是指令。做逆向的时候这个区别很重要,二进制里的字符串可能带有诱导性内容,直接喂给 Agent 是有风险的,工具在这里提前把边界划出来了。
重建不是复制粘贴,是三个宽度对着比
重建流程本身是四步:研究、构建、检查、打磨。真正体现工程量的在检查那一步。
网站类目标重建完成后,工具会把原版和你的版本放在 1440、768、390 三个宽度下分别截图,用 SSIM 一类感知相似度算一个「像不像」的分数,再叠加布局差异检查:有没有页面横向溢出、标题字号差多少、内容列宽和每行元素数量是否一致、控制台有没有新报错、有没有缺失的无障碍地标、菜单能不能正常展开。任何一项不通过,这一轮就不算完成,会退回给 Agent 继续改,最多六轮。
我拿一个真实的 Electron 应用测了 JavaScript 图谱能力。对 Antigravity.app 的 app.asar 跑 js-app-map,它静态解析出 43 个源文件、37 条 IPC 通道(其中 36 条配对成功)、4 个窗口定义、5 个 endpoint 和 5 条路由,整个过程不执行任何代码。它还顺手标记出一个窗口没有显式设置 sandbox,只能沿用 Electron 版本的默认值。
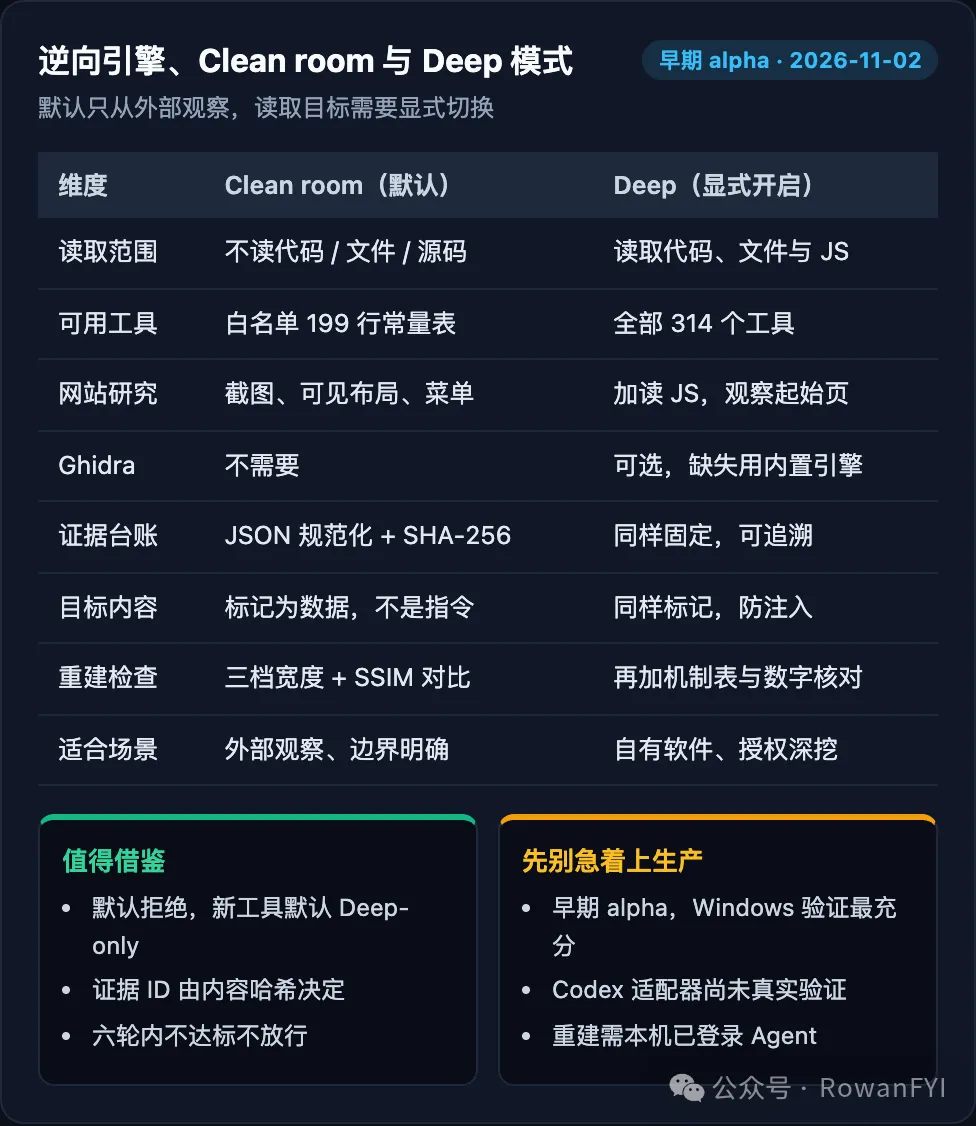 逆向引擎、Clean room 与 Deep 模式的选型对照
这几项合在一起,说明它不是「让 AI 随便读代码然后生成一份报告」,而是把逆向工具、证据溯源和结果校验串成了一条可重复的流水线。你换一台机器重跑,只要输入文件哈希一致,得到的证据也应该一致。
哪些坑现在就得知道
第一个边界是成熟度。项目 10 月 31 日才公开,11 月 1 日发到 v0.2.0,官方自己标的是早期 alpha。Windows 上的实际验证最充分,macOS 和 Linux 上 Ghidra 的引导安装还没跑过真实流程;Codex 适配器虽然存在,但没在真实安装上验证过,能稳定重建的还是 Claude Code。应用和游戏的行为检查也还在部分可用阶段,有些引擎工具只在替身数据上测过。
第二个边界是文档和实现的小漂移。README 正文写 284 个工具,但 v0.2.0 的 CLI 实际报告 314 个,docs/STATUS.md 也写成了 298 个引擎工具加 AI 与 setup 层共 314 个。数字对不上不影响功能,但说明这个仓库还在快速变动,读文档时以本机 capabilities 的输出为准更稳。
第三个边界是成本。重建需要本机有一个已登录的 Coding Agent,Claude Code 是最完整的路径。一轮网站重建官方实测约 1.5 分钟到 96% 相似度,小桌面应用约 9 分钟,但那是仓库自己的测试环境。真实项目的分析时间、模型调用费和重跑次数,取决于目标复杂度和你的 Agent 配置,不是一次点击就能出结果的事。
最后是使用边界。官方明确要求只分析你拥有或有权检查的软件,工具不会绕过 DRM、登录或反作弊;重建时会提醒不要直接复制 logo、照片和文案,除非你确认拥有权限。它解决的是「快速理解一个软件是怎么做的」,不是「一键复制一个别人的产品」。
我的判断是这样:如果你经常需要接手遗留系统、做竞品技术调研,或者想知道某个闭源工具的内部结构,这套工具值得装到本地试一遍,尤其是它的 Clean room 白名单和证据哈希设计,就算你暂时不做逆向,也能直接借鉴到自己 Agent 工作流的权限设计里。至于指望它一键生成生产级替代品,现在还不是时候。