ARTICLE · 1297691
AI十分钟写完的东西,人为什么审不过来
封面插画(AI生成,仅作情境示意,非实拍)
故事是这样的。
2026年6月,一位叫 Parthiban Rajasekaran 的工程师,在 DevOps.com 上写了他们团队的一次经历。
事情很简单。他们让一个自主编程 Agent 去接一张工单。注意,我说的不是那种你敲代码时帮你补半行的助手,是你把工单丢给它,它自己读需求、自己规划、自己动手,最后直接提交的那种,Claude Code、Codex 干的,就是这类活。
然后,它改了37个文件,动了两个数据库迁移脚本,
11分钟,交上来一个待审的改动。
11分钟。
我得先说明,这是人家团队的自述,不是我的亲历,我也没法独立核实。但读到这儿,我脑子里蹦出来的,是另一个问题。
谁来看这37个文件?
生成结束了,工作并没有结束。接下来得有人弄清楚,这些改动彼此怎么配合,两个迁移会不会碰到已有的数据,权限检查有没有漏掉,系统里是不是早就有一个一模一样的功能,被它又写了一遍。
写它花了11分钟。看懂它,你觉得要花多久?
这事儿要是只发生在程序员身上,那也就算了。
其实吧,你换到别的办公室,场景一点都不陌生。让 ChatGPT 或者 Claude 写一份20页的行业报告,几分钟,结构完整,数据翔实,图表俱全。你转给同事的时候,看起来是省下了写作的时间。
可如果同事得从头去找每一条数据的出处,把推理重新走一遍,那你省下的时间,只是换了一个人来付。
我的判断是,AI 正在把「生成」和「验证」之间的剪刀差,越拉越大。
我说的是剪刀差,不是「验证一点没变便宜」。确认结果的工具也在进步,AI 自己也能帮着查。但生成的量,可以先一步,压过一个团队消化它的能力。
软件行业,是最先把这笔账记下来的。代码有版本,有审查记录,有交付指标。所以这篇我想从软件聊起,顺着那些记录往下看,你会发现,这个问题既关乎容量,也关乎责任。
先看一组数字,我觉得挺扎眼的。
坦率的讲,我对这类调查里的数字,向来是半信半疑的,下面这些也一样,你带着这个心态看就行。
Sonar 在2026年公布过一项调查,覆盖了1100多名职业开发者。
受访者估计,自己提交的代码里,有42%是 AI 生成或者辅助的。
96%的人,不完全相信 AI 代码在功能上是正确的。
但是,只有48%的人说,自己每次提交前都会验证。
还有38%的人觉得,审 AI 写的代码,比审同事写的更费劲。
你把这几句话连起来读,会读出一种很别扭的姿态。
几乎所有人都觉得这玩意可能有问题,可是,还是在大量地用。
这块需要注意一下,48%这个数字,得仔细读。
它不代表剩下的52%,把代码免检送进了代码库。有人可能经常检查,有人偶尔检查,后面也可能还有同事审查和自动测试。这项调查能告诉我们的,只是强烈的不信任和「每次都验证」之间,有一道缺口。而且它是开发者自己报的,不是对全行业代码的逐行审计。
那为什么,一份看起来很规整的代码,反而更难审?
我编一个例子,你感受一下。设想 AI 生成了一个客户查询接口,变量名清清楚楚,注释完完整整,正常请求一跑,通了。真正的问题可能是,它默认调用者已经通过了权限校验。
这个假设,不写在这一页代码里,藏在调用链的某个地方。你得把整条链路在脑子里重新跑一遍,才发现它不对。
人写的代码,当然也会有这个问题。不一样的是,AI 一出手,量大,而且长得像成品。一份像成品的东西,特别容易让接手的人,跳过对前提的追问。
所以审查者要做的,是重新把它和真实的系统接上,再决定这个「完成」到底可不可信。
说到这儿,得聊聊代码审查,为什么一直管用。
它有一笔很划算的账。你花几个小时写一个改动,我花相对短的时间读懂它,挑出缺陷,聊聊设计,顺便也知道了系统正在往哪儿长。写的过程,通常逼着提交的人,先把一轮细节想了一遍,所以审查者接手的,不是一张白纸。
Agent 能在很短时间里,生成一整套跨文件的实现,这个前提,开始松动了。
生成的速度翻一倍,不会让「读懂依赖、评估异常后果、理解历史决定」的速度也翻一倍。AI 可以帮你搜索、解释代码,可关键的假设,还是得由懂业务、懂系统的人来拍板。
Faros 在2026年的报告,分析了大约2.2万名开发者、4000多个团队的遥测数据。在各个组织 AI 采用程度最低和最高的两个时期之间,首次审查等待时间的中位数,涨了156.6%,处于审查阶段的时间中位数,涨了441.5%。
我知道你想问,那不就是 AI 害的?
别急,这块我得泼一下冷水。这两个都是中位数,不是平均值,也不等于审查者真的盯着代码的工时。而且它不是随机实验,业务复杂度、组织调整、同期的流程变化,都可能影响结果。它不能证明这些增幅全是 AI 造成的。
但它够提醒管理者一件事了,代码产量上涨的时候,得一起看排队时间、返工和交付,别光盯着提交数。
Salesforce 的工程博客里,还有一条,我觉得更像警讯的观察。内部的代码量上去了,大改动变多了,可体积最大的那批改动,审查时间反而持平,甚至下降了。他们自己的解读是,审查者可能已经没法对每一处变化,都认真参与了。
这当然不能证明有人没读后半截。但批准得这么快,到底是工具帮了忙,还是检查正在变浅?这个问题,值得问一句。
这事儿让我想起一本很老的书,高德拉特的《目标》。
它是一本讲工厂的小说。里面有一段童子军徒步,队伍里有个走得最慢的孩子,叫赫比。整支队伍能走多快,不取决于跑在最前面的人,取决于他。
书里的道理很朴素。你把瓶颈前面的工序提得再快,系统的产出也不会多一点,只会让半成品,堆在瓶颈的门口。
代码生成这一头,被 AI 提速了。可「读懂并确认它是对的」那个环节,还是那几个人,那几双眼睛,一天24小时。
上游的生产力,到了下游,就变成了库存。
一个制度的经济基础被抽走,它不会优雅地退场,只会以很具体的方式崩坏。
代码审查研究者 Michaela Greiler,把她观察到的问题分成了两类,容量失效和责任失效。要先说一句,这是她基于工作经验提出的分析框架,不是行业发生率的统计。
◎ 第一种,容量失效,她叫它审查投降。
关键是,投降的人通常还相信审查很重要,只是跟不上了。它是渐进的,体面的,不会写进任何一份会议纪要。先是不再坚持要求作者把改动拆小,反正拆了也审不完。接着放弃追问架构上的影响。到后来,把批准的标准,收缩成了「能跑就行」。制度表面上还在转,实际检查的范围,已经缩了一圈。
这事别简单归咎于态度。一个负责的人,面对看不完的队列,也得在「耽误交付」和「降低检查强度」之间选一个。如果上游只奖励更多的产出,下游又没有时间拒收,你再强调责任心,也不会凭空多出容量。
◎ 第二种,责任失效,Greiler 叫它审查被利用,直白点讲,就是被白嫖。
提交的人,有没有理解、验证过自己交上来的东西,审查者看不出来,甚至得替他,第一次把需求弄懂。
这不一定出于恶意。提交者也可能,被生成的速度甩在了后面,把一个自己还没吃透的结果,当成了做完的工作。手写代码从来也不保证想清楚了所有问题,但 AI 把「没充分理解,也能交一份完整成品」的门槛,又压低了一截。
两种失效,还会互相喂养。认真审查的人发现,自己总在补提交者的功课,就会撤回一些投入。检查变浅,没吃透的改动就更容易过关。
所以我觉得,光加一个 AI 审查工具,可能缓解阅读的压力,却修不了责任这笔账。
审查还有一项,很难计入产量的价值,就是让第二个人,知道系统为什么这样改。如果只确认「这次能跑」,历史取舍就留在了提交者的脑子里,或者某个对话窗口里。等这个人离开,团队手里有完整的代码,却没有足够的人,理解它。
今天省掉的讨论,会变成下一次改代码时,重新摸索的时间。
瓶颈往下游挪,具体会撞到什么?
Google 发布2025年 DORA 报告的时候,特别说明了和上一年的区别。2025年,AI 采用和交付吞吐量、
产品表现,是正相关的,交付稳定性,则继续呈负相关。所以不能写成「连续两年吞吐都升、稳定性都降」,我也不会这么写。报告强调的是,AI 加速了开发,也会把测试、版本控制和反馈回路里的薄弱环节,暴露出来。
这里还有个很容易混的地方,我得单独拎出来说。
AI 写出来的普通程序,并不会因为作者是模型,就变成「概率软件」。一个运行时不调用模型的计费函数,照样可以用确定的输入、输出和回归测试来检查。旧的测试方法依然有用,真正该担心的,是检查覆盖得够不够,验证的速度跟不跟得上。
运行时里就包含大模型的系统,是另一层问题了。同一类问题,可能得到不同的回答,模型、提示词、检索资料一变,系统的行为也可能跟着变。这时除了程序测试,还得有代表性样本、质量评估、失败案例和上线后的观察。一次测试通过,不能就说所有回答都有保证。
很多文章会把这两件事混着讲,一句「传统流水线接不住 AI」就带过去了。我不太同意。前一种,要管住的是改动量和工程质量,后一种,还得验证行为的分布。把对象说清楚,团队才知道该补哪一道检查。
好,问题聊得差不多了。那怎么办?
我找到的,是四个已经有人在跑的办法。先声明一下,它们大多来自 IEEE Spectrum 对一线公司的采访,是经营者自己的说法,不是被独立验证过的最佳实践,你拿去参考可以,别当标准答案。
◎ 第一个办法,先审计划,再审成品。
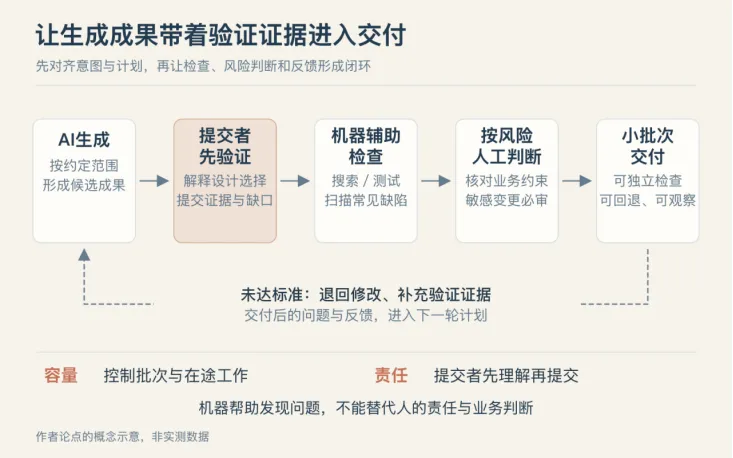
方向错了,后面每一行都可能白忙。等37个文件摆在面前,审查者得先还原需求,再判断实现。要是先交一份简明的计划,很多分歧,在生成之前就解决了。
IEEE Spectrum 的采访里,Amazon Stores 的工程师提到过,规格里缺了一项语言版本的要求,曾让 Agent 生成了一大批不适用的代码。他们的选择是,补正规格,重新生成,而不是沿着错误的版本一路修下去。
我觉得值得借鉴的,不是「重跑很便宜」,是提前把约束写清楚。改什么,不改什么,依赖哪个版本,哪些行为必须兼容,成功怎么验收。这些问题有了答案,审查者面对的,就是一份有边界的承诺。
计划不必写成另一份长文。小改动几句话就够,涉及数据迁移、权限、核心规则的,就得把关键的失败方式列出来。还有,计划不是写完就归档的,实现中发现新约束,或者 Agent 走了另一条路,要把差异带回来聊,不然一份批准过的计划,反而会制造错觉,大家以为对齐了,成品解决的却是另一个问题。
◎ 第二个办法,机器辅助阅读,人来判断风险。
让 AI 去找重复实现,整理调用关系,扫常见缺陷,当然能减轻人的负担。但风险分流,不能只看模型给的一个「高置信度」。谁来定义风险,哪些改动必须人工介入,得在生成结果出来之前,就说清楚。
Bonterra 在同一组采访里介绍,他们用 Agent 对照设计和规则做第一轮检查,涉及支付、个人数据等敏感系统的改动,仍然交给人。这是一家公司的做法,不能直接当通用的放行标准,但它保住了一个必要的区分,机器可以帮忙排序,责任的边界,得由团队来划。
打个比方,改个文案,用轻一点的复核,改权限规则,就得查真实的调用链和越权路径。哪怕模型把后者判成了低风险,也不该绕过事先约好的人工环节。分类出错,本身就是一种需要提前想到的故障。
分流以后,还得回头看漏检。被自动放行的改动,是不是总在返工,有没有出现以前没覆盖过的新类型。没有这一步,「低风险」很容易从有证据的分类,退化成队列太长时的自我安慰。
◎ 第三个办法,提交的人,先交验证证据。
Temporal 在采访里介绍的 Send Back,我觉得特别直接。工程师要用自己的话,说明 Agent 做了哪些设计选择,异常是怎么处理的。解释不清,审查者就退回。
它干的事儿,就是把一件原本隐含的事,摆到了台面上。你选择提交,就得先为提交的内容做功课。
证据可以很短,但得和决定相关。为什么选这个方案,最危险的边界在哪,试过哪些失败的输入,哪些情况还没验证。这比一句「已自测」强太多,审查者知道从哪儿接着往下查,而不是从零开始。
Agent 代写的摘要,不是完全没用,它可以做索引,但不能单独证明提交者理解了这次改动。自动列出一百条测试名,也不等于说明了关键风险。
不过退回机制,也得有节制。如果团队要求作者去猜审查者心里的标准,责任要求就成了随意加码。把最低的证据要求写明,复杂问题留给共同讨论,才可能减少摩擦。
◎ 第四个办法,控制批次,给验证留余地。
最朴素,也最容易被忽略。
多出十倍的生成能力,未必换来十个清楚的小改动,更可能是一个大到没人敢碰的改动包。任务边界,在途的工作量,审查的容量,都得有人主动去控制。
而且「小」,也不能只按文件数算。为了修一个明确的问题,跨几个文件可能很合理,把互不相关的修复、重构和新功能塞在一起,行数不多,判断也会变难。好的批次,得能说清意图,能独立检查,失败了能撤回。
对普通软件,检查包含对应的回归测试和关键业务路径。对运行时用到模型的产品,还得保留评估基线、失败样本和版本记录。这里我想强调一下,门禁能证明的,是「在约定范围内满足了标准」,没法证明系统永远不会变差,高风险的问题,上线后还是要观察,要有处置办法。
控制批次,也包括允许停下来。审查队列越来越长,那就先把手上的改动审完,别再开更多的任务。不然,《目标》里那堆库存,又得堆回门口。
管理者也得换一种计分方式。只奖励新增功能和提交数量,会让拆小任务、完善证据、清理重复实现的人,显得产出更少。得同时看返工、审查等待、故障,以及团队的理解,是不是只集中在少数几个人身上。生成提速,才有可能变成真正做完的事,而不是一份漂亮的个人周报。
审查要同时补容量与责任(流程概念图,不代表统一标准或实测效果)
看到这儿,很容易得出一个偷懒的结论,那就让 AI 去审 AI 吧。
让 AI 审 AI,有价值,这个我认,它能多补一轮检查,找到人没注意到的细节。
但是,生成者和审查者,可能接受了同一个错误的需求,也可能忽略了同一个业务约束。换一个模型,不会自动获得对真实世界的独立了解。
假如需求里压根没写「离职员工应立即失去访问权」,两个 Agent 完全可能,一致地批准一个有问题的权限方案。这时候该补的,是业务事实、权限测试,以及有权确认规则的那个人。多一张同意票,替代不了这些。
自动化的目标,应该是把有限的注意力,带到关键的地方。把「模型批准了」当成免责凭证,或者让人只为机器的结论签字,只是把旧瓶颈藏了起来,等到出故障的时候,再一起冒出来。
还有一笔账,来得更慢,但我觉得,更贵。
修个小 bug,加个字段,处理一次失败的请求,这些活儿没什么技术含量,但它们让新人在风险比较低的情况下,一次次碰到真实的系统,慢慢知道,哪些假设不能轻信。如果这些活全交给 Agent,任务是完成了,学习,却未必发生。
IEEE Spectrum 的采访里,IBM 和 Making Sense,分别让新人更早地承担问题诊断,参与需求讨论。这些是培养思路,不是已经被证明有效的统一方案。判断力要靠反复练习,没法靠给新人换一个更高级的岗位名称得到。
我自己的感受是,可以这么练。让新人先解释一个改动为什么成立,再动手写测试,推翻自己刚才的判断。或者,让他跟一次真实的故障,看那个错误,是怎么穿过每一道检查的。资深同事的作用,是指出遗漏,控制练习的风险,让新人亲手去修,而不是直接把难题接走。
如果一个团队只招已经会判断的人,却不再提供形成判断力的机会,眼前省下的带教时间,迟早会变成经验供给上的缺口。
生成的工具越强,就越得认真设计,人怎么学会对结果负责。
聊到最后,回到开头那个11分钟。
我得说句公道话,软件行业的经验,不能直接证明,所有职业的验证成本都没有下降。文案,设计,法律,财务,风险各不相同,AI 也能帮着查证。能迁移过去的,只是一个条件判断,当生成的增长,快过有效的验证,工作就会在交接的地方堆起来。
拿报告举例。先确认问题、数据范围和论证路径,再让 AI 扩写。把影响决策的数字,逐条核到来源,把只是用来说明的假设,标出来。提交的时候,说清楚查过什么,没查过什么。接收的人,拿到的就不只是一份看起来做完了的文档,而是一份知道该从哪儿继续检查的成果。
同样,合同里的关键责任条款,不能因为版式工整,就减少专业复核,内部的活动文案,也不必用和核心合同一样的检查强度。把注意力分给哪儿,依据是错了的后果,以及发现错误有多难。
我更担心的,其实是另一件事。
「我已经用 AI 做完了」,会不会变成一句,用来结束交接的话?
生成完成,只说明产物存在,理解和验证做到了哪一步,还是得说清楚。不然,每个人都能晒一晒自己省下的时间,却没人来解释,团队为什么反而更忙了。。。
AI 让更多人变成了提交者,也让更多人,变成了接收者。
接下来值得养成的习惯,其实很朴素。先确认意图,按风险检查,小批次交付,提交的时候带上证据。
让接手的人继续验证,而不是替你,第一次理解。
11分钟的活儿,真正的工作,在那之后才开始。
参考资料
[1] The Bottleneck Isn’t Coding Anymore. It’s Verification https://devops.com/the-bottleneck-isnt-coding-anymore-its-verification/
[2] State of Code Developer Survey report: The current reality of AI coding https://www.sonarsource.com/blog/state-of-code-developer-survey-report-the-current-reality-of-ai-coding/
[3] Ten takeaways from the AI Engineering Report 2026: The Acceleration Whiplash https://www.faros.ai/blog/ai-acceleration-whiplash-takeaways
[4] Scaling Code Reviews: Adapting to a Surge in AI-Generated Code https://engineering.salesforce.com/scaling-code-reviews-adapting-to-a-surge-in-ai-generated-code/
[5] When Agentic Coding Breaks Code Review https://www.michaelagreiler.com/codereview-surrender-exploitation/
[6] Announcing the 2025 DORA Report https://cloud.google.com/blog/products/ai-machine-learning/announcing-the-2025-dora-report
[7] AI Slop Is Changing How Engineers Review Code https://spectrum.ieee.org/ai-code-review-software-engineers
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
—推荐阅读—